
완전 내포 분산분석(Fully Nested ANOVA)
완전 내포 분산분석은 변량 요인 2~4개가 내포된 계층 구조와 오차로 취급하는 반복 측정에서 각 수준이 변동에 얼마나 기여하는지 추정합니다. 하위 수준의 각 단위는 하나의 상위 수준 단위에만 속해야 합니다. 출력에는 분산분석표(F와 P는 균형 설계에만 제공), 전체 대비 % 비율이 있는 분산 성분, 기대 평균제곱, 모형 요약, 셀 평균이 포함됩니다.
최종 검토
핵심 요점
완전 내포 분산분석은 측정값의 변동을 배치, 배치 내 표본, 반복 측정처럼 계층 구조의 각 수준으로 분해하여 변동의 대부분이 어디서 오는지 보여 줍니다.
목적
완전 내포 분산분석은 측정값의 변동을 배치, 각 배치에서 채취한 표본, 각 표본의 반복 측정처럼 계층 구조의 각 수준으로 분해합니다. 하위 수준의 각 단위가 하나의 상위 수준 단위에만 속하고(배치 1의 표본 1은 배치 2의 표본 1과 같은 재료가 아님) 변동의 대부분이 어디서 오는지 알아서, 공정, 표본 추출, 측정 중 어디에 조치할지 알고자 할 때 사용합니다.
주요 기능
- 가장 바깥쪽(예: Batch)에서 가장 안쪽(예: Sample)까지 내포된 요인 2~4개를 지원하며, 가장 안쪽 요인 내의 반복 측정이 오차를 이룹니다.
- 반응 변수를 여러 개 선택하면 반응 변수마다 분석을 하나씩 수행합니다.
- 순차 제곱합이 포함된 분산분석표와, 각 수준을 그 아래 수준에 대해 검정하는 F 검정.
- 전체 대비 % 비율과 표준편차가 있는 분산 성분.
- 기대 평균제곱, 모형 요약, 모든 셀의 평균과 표준편차 표.
- 분산 성분에 대해 불균형 데이터를 처리하며, Data Options로 행의 부분집합을 지정할 수 있습니다.
통계적 방법
모든 요인은 변량 요인으로 취급하며 각 요인은 바로 앞의 요인 안에 내포됩니다. 각 요인의 제곱합은 해당 셀 평균이 상위 수준의 평균 주위에 흩어진 정도이며, 오차 제곱합은 측정값이 가장 안쪽 셀 평균 주위에 흩어진 정도입니다. 각 요인의 자유도는 (해당 요인의 셀 수 − 상위 수준의 셀 수)이고, 오차의 자유도는 N − 가장 안쪽 셀 수입니다.
각 요인은 그 안쪽의 다음 요인에 대해 검정하고, 가장 안쪽 요인은 오차에 대해 검정합니다. F = MS(요인) / MS(다음 안쪽 항)입니다. F와 P는 균형 설계(모든 셀의 측정 수가 같고 모든 단위의 하위 단위 수가 같음)에서만 제공되며, 불균형 데이터에서는 페이지에 그 사실이 표시되고 F와 P는 생략됩니다.
분산 성분은 기대 평균제곱(ANOVA 방법)으로 구합니다. 각 요인의 E(MS)는 σ²(오차)에 해당 요인과 그 안쪽 요인들의 성분의 배수를 더한 값이며, Expected Mean Squares 표에 나타나는 것과 같습니다. 표에서 (1), (2), …는 내포 순서대로 요인에 붙인 번호이고 마지막 번호는 오차입니다. 이 방정식을 가장 안쪽 항부터 바깥쪽으로 풀면 각 성분이 구해지며, 음수 추정값은 전체의 0%로 표시합니다. % of Total은 합산한 분산에서 각 성분이 차지하는 비중이고 StDev는 그 제곱근입니다. 반응 변수 값 또는 요인 값이 누락된 행은 제외합니다.
입력 항목 및 옵션
항목 | 설명 |
Responses | 하나 이상의 수치형 열입니다. 필수이며, 반응 변수마다 분석을 하나씩 수행합니다. |
Factor 1 (outermost) | 계층 구조의 최상위 수준이며, 예를 들어 Batch입니다. 필수. |
Factor 2 (nested in Factor 1) | 필수이며, 예를 들어 Batch 내의 Sample입니다. |
Factor 3 (nested in Factor 2) / Factor 4 (nested in Factor 3) | 선택 사항인 더 깊은 수준이며, Factor 4를 쓰려면 Factor 3이 필요합니다. |
Data Options: Subset (optional) | 행 번호 및/또는 조건으로 일치하는 행을 제외(기본값, Exclude matching rows)하거나 일치하는 행만 포함(Include only matching rows)합니다. |
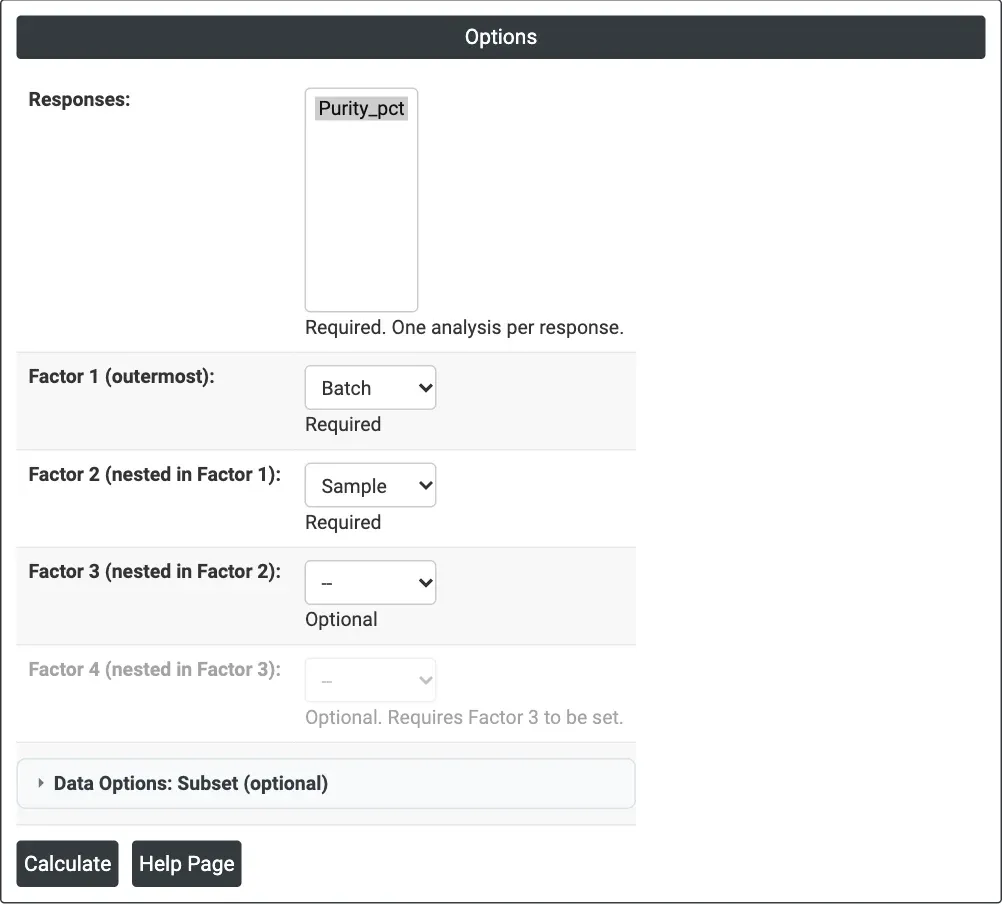
그림 1 — 순도 예제의 옵션: 반응 변수는 Purity_pct, Factor 1은 Batch, Factor 2는 Sample(Batch에 내포).
출력 설명
- Analysis of Variance — 각 요인, 오차, 전체의 DF, SS, MS, F, P.
- Variance Components — 각 요인, 오차, 전체의 Var Comp, % of Total, StDev.
- Expected Mean Squares — 각 평균제곱의 구성을 분산 성분으로 나타냅니다.
- Model Summary — 모형 요약 통계량 S, R-sq, R-sq(adj).
- Means — 가장 안쪽 모든 셀의 N, 평균, 표준편차.
- Download를 통한 PDF 내보내기.
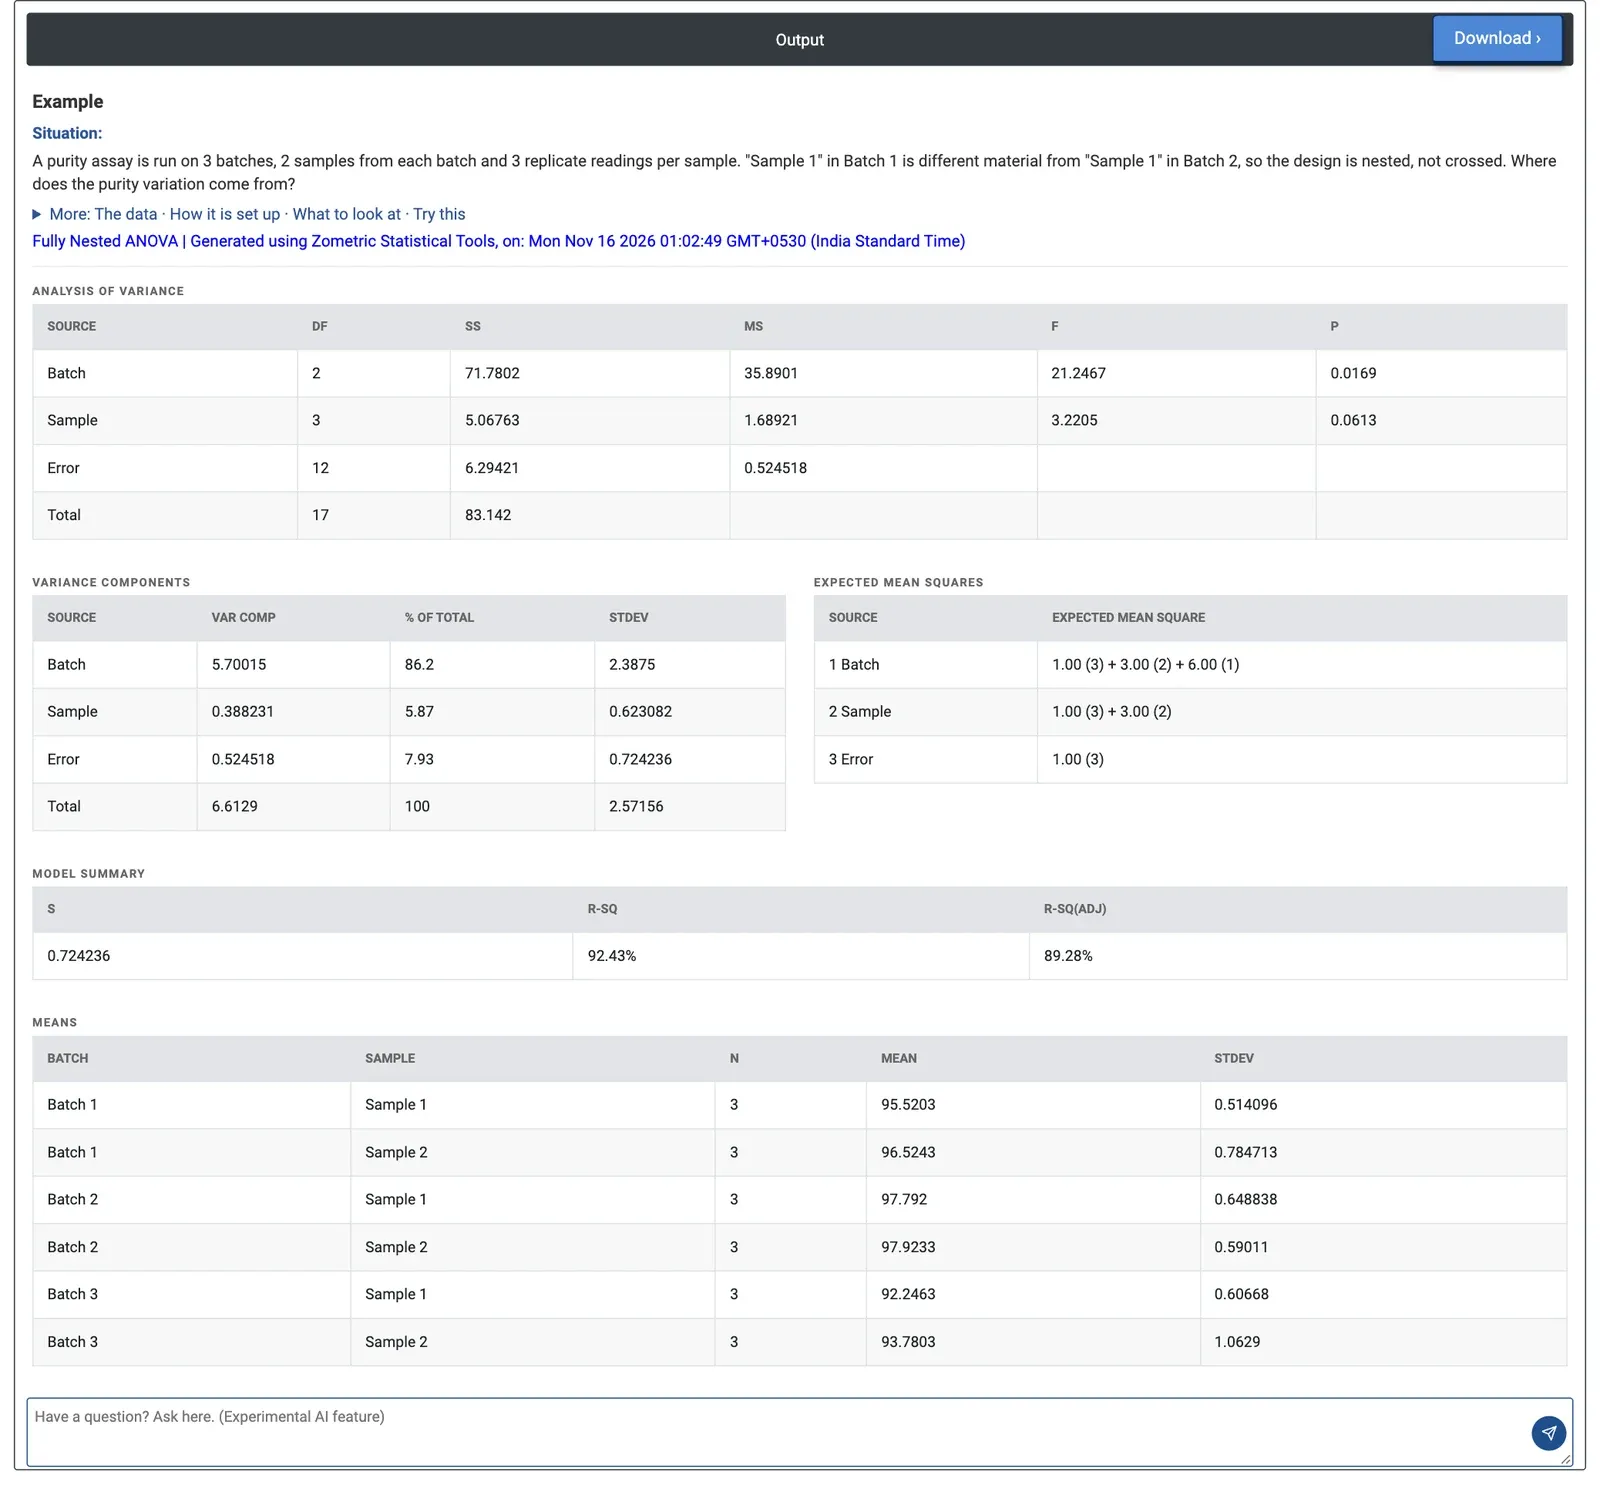
그림 2 — 순도의 내포 분산분석: 배치 간 변동이 전체의 86.2%이며, 배치 내 표본이 5.87%, 반복 측정이 7.93%를 차지합니다.
계산 예제
순도 분석을 배치 3개에 대해 수행하며, 각 배치에서 표본 2개를 채취하고 각 표본을 3회 반복 측정하여 결과가 18개입니다. 품질팀은 순도의 산포가 배치 공정, 표본 추출, 측정 중 어디에서 오는지 알고자 합니다. 반응 변수로 Purity_pct, Factor 1로 Batch, Factor 2로 Sample을 선택하며, 반복 측정이 오차를 이룹니다.
배치 간에는 차이가 있습니다. 자유도 2와 3에서 F = 21.25, p = 0.0169입니다(Batch는 Batch 내의 Sample에 대해 검정). 배치 내 표본 간에는 5% 수준에서 유의한 차이가 없습니다(F = 3.22, p = 0.0613). 배치 3이 가장 낮고(셀 평균 92.25%와 93.78%) 배치 2가 가장 높습니다(97.79%와 97.92%).
분산 성분을 보면 상황이 분명합니다. 배치 간 분산은 5.70(전체의 86.2%, 표준편차 2.39 퍼센트포인트), 표본 간 분산은 0.388(5.87%), 반복 측정은 0.525(7.93%, 표준편차 0.72)입니다. 표본 추출을 개선하거나 분석 정밀도를 높여도 거의 달라지지 않으므로, 팀은 배치 간에 무엇이 다른지 살펴봐야 합니다.
자주 묻는 질문
완전 내포 분산분석은 언제 사용합니까?
하위 수준의 각 단위가 하나의 상위 수준 단위에만 속하고(예를 들어 배치 1의 표본 1이 배치 2의 표본 1과 같은 재료가 아님) 변동의 대부분이 어디서 오는지 알고자 할 때 사용합니다. 이를 통해 공정, 표본 추출, 측정 중 어디에 조치할지 알 수 있습니다.
완전 내포 분산분석에서 요인은 어떻게 검정합니까?
모든 요인은 변량 요인으로 취급하며 각 요인은 바로 앞의 요인 안에 내포됩니다. 각 요인은 그 안쪽의 다음 요인에 대해 검정하고 가장 안쪽 요인은 오차에 대해 검정하므로 F = MS(요인) / MS(다음 안쪽 항)입니다. F와 P는 균형 설계에서만 제공되며, 불균형 데이터에서는 생략되지만 분산 성분은 여전히 추정됩니다.
내포 분산분석에서 분산 성분은 어떻게 해석합니까?
각 성분의 % of Total은 합산한 분산에서 그 성분이 차지하는 비중이고 StDev는 그 제곱근입니다. 순도 예제에서 배치 간 분산은 전체의 86.2%, 배치 내 표본은 5.87%, 반복 측정은 7.93%였으므로 표본 추출을 개선하거나 분석 정밀도를 높여도 거의 달라지지 않으며, 팀은 배치 간 차이를 살펴봐야 합니다.
완전 내포 분산분석에는 내포 요인을 몇 개까지 포함할 수 있습니까?
가장 바깥쪽(예: Batch)에서 가장 안쪽(예: Sample)까지 내포 요인 2~4개를 포함할 수 있습니다. Factor 1과 Factor 2는 필수이고 Factor 3과 Factor 4는 선택 사항이며, Factor 4를 쓰려면 Factor 3이 필요합니다. 가장 안쪽 요인 내의 반복 측정이 오차를 이루며, 선택한 반응 변수마다 분석을 하나씩 수행합니다.