
일반 선형 모형(General Linear Model)
일반 선형 모형은 고정 범주형 요인, 선택적인 2차 교호작용, 연속형 공변량을 최소제곱법으로 적합하며, 수정(Type III) 또는 순차 제곱합을 사용합니다. 일원배치 분산분석으로 부족하거나 데이터가 불균형일 때 사용합니다. 오차는 서로 독립이고 정규분포를 따르며 분산이 일정하다고 가정합니다. 출력에는 분산분석표, 최소제곱 평균, VIF가 포함된 계수, 다중 비교, 잔차 그림이 있습니다.
최종 검토
핵심 요점
일반 선형 모형(GLM)은 하나 이상의 범주형 요인, 이들의 2차 교호작용, 연속형 공변량을 하나의 모형에서 분산분석하며, 불균형 데이터와 이원배치 분산분석도 포함합니다.
목적
일반 선형 모형(GLM)은 하나 이상의 범주형 요인, 이들의 2차 교호작용, 연속형 공변량을 하나의 모형에서 분산분석합니다. 일원배치 분산분석으로 부족할 때 사용합니다. 예를 들어 수율이 기계, 작업자, 둘의 조합, 그리고 온도 같은 측정 조건에도 좌우될 수 있는 경우나 데이터가 불균형인 경우입니다. 고전적인 이원배치 분산분석도 포함합니다.
주요 기능
- 임의 개수의 고정 범주형 요인이며, 요청하면 모든 2차 요인 교호작용을 포함합니다.
- 주효과로 입력하는 연속형 공변량(공분산분석).
- 수정(Type III) 또는 순차(Type I) 제곱합. 불균형 데이터에 대해서도 올바른 검정.
- 다른 항으로 조정한 각 요인의 최소제곱 평균.
- Tukey, Fisher, Bonferroni, Sidak 또는 Dunnett(대조군 대비) 방법에 의한 한 요인의 최소제곱 평균 다중 비교이며, 그룹 문자와 차이의 구간 그림을 제공합니다.
- VIF가 포함된 계수, R-sq(pred)가 포함된 모형 요약, 특이 관측값, 네 가지 잔차 그림.
- Data Options: 분석 전에 행을 부분 집합으로 선택합니다.
통계적 방법
모형은 보통 최소제곱법으로 적합합니다. 요인은 합이 0이 되는(−1, 0, +1) 코딩을 사용하므로 각 계수는 해당 수준이 전체 평균에서 벗어난 정도이며, 주효과의 Type III 검정은 다른 요인의 수준에 대해 평균을 냅니다. 선택한 열 중 어느 하나라도 결측값이 있는 행은 제외합니다. 각 항은 F = Adj MS(항) / MS(Error)로 해당 항의 자유도와 오차 자유도를 사용하여 검정하며, 순차 제곱합에서는 각 항을 그보다 앞에 있는 항들을 반영한 뒤 검정합니다. Total 행은 평균에 대한 총 제곱합이며, 불균형 데이터에서는 수정 제곱합의 합이 이 값과 일치하지 않을 수 있습니다.
S = √MS(Error)입니다. R-sq(pred) = 1 − PRESS / SS Total이며, PRESS는 하나씩 제외한 예측 오차의 제곱합입니다. 최소제곱 평균은 다른 요인을 각 수준에 대해 평균하고 공변량을 평균값에 둔 상태에서 한 요인 수준에 대한 모형의 예측값이며, 원 평균과 달리 집단 크기 불균형이나 공변량 차이에 의해 치우치지 않습니다.
비교에는 최소제곱 평균 간의 차이와, 계수 공분산 행렬로부터 구한 그 표준오차를 사용합니다. Tukey는 모든 쌍에 스튜던트화 범위 분포를 사용하고, Fisher는 개별 t 검정을 사용하며, Bonferroni와 Sidak은 쌍의 수에 맞게 t 임계값을 조정하고, Dunnett는 다변량 t 분포를 사용하여 모든 수준을 대조군과 비교합니다. 0을 포함하지 않는 구간이나 그룹 문자를 공유하지 않는 평균은 유의한 차이를 나타냅니다. ±2를 벗어나는 표준화 잔차는 R로, 3p/n보다 큰 레버리지는 X로 표시합니다. 이 모형은 오차가 서로 독립이고 정규분포를 따르며 분산이 일정하다고 가정하므로 잔차 그림을 확인하십시오.
입력 항목 및 옵션
항목 | 설명 |
Response (Y) | 수치형 반응 열. 필수. |
Factors (categorical) | 하나 이상의 범주형 예측 변수 열. 필수. |
Covariates (continuous) | 선택 사항인 수치형 열이며 주효과로만 입력합니다(요인과의 교호작용은 없음). |
Include all 2-way factor interactions | 기본적으로 선택되어 있으며, 모든 2요인 교호작용을 추가합니다. |
Confidence level | 기본값은 95이며 비교에 사용됩니다. |
Comparison procedure | None(기본값), Tukey, Fisher, Bonferroni, Sidak 또는 Dunnett (vs. a control level). |
Comparison factor | 최소제곱 평균을 비교할 요인이며, 비교 방법을 선택하면 필수입니다. |
Control group level (Dunnett) | Dunnett의 대조 수준이며, 비워 두면 첫 번째 수준을 사용합니다. |
Grouping information / Interval plot for differences of means | 기본적으로 선택되어 있으며, 그룹 문자 표와 비교 구간 그림을 출력합니다. |
Sum of squares for tests | Adjusted (Type III, 기본값) 또는 Sequential (Type I). |
Residual versus fit graph / Residual versus order graph / Histogram / Probability plot | 잔차 그림이며, 모두 기본적으로 선택되어 있습니다. |
Data Options: Subset (optional) | Exclude matching rows(기본값) 또는 Include only matching rows를 행 번호(예: 3,7,12-15) 및/또는 조건(예: Temperature_C > 185)으로 지정합니다. |
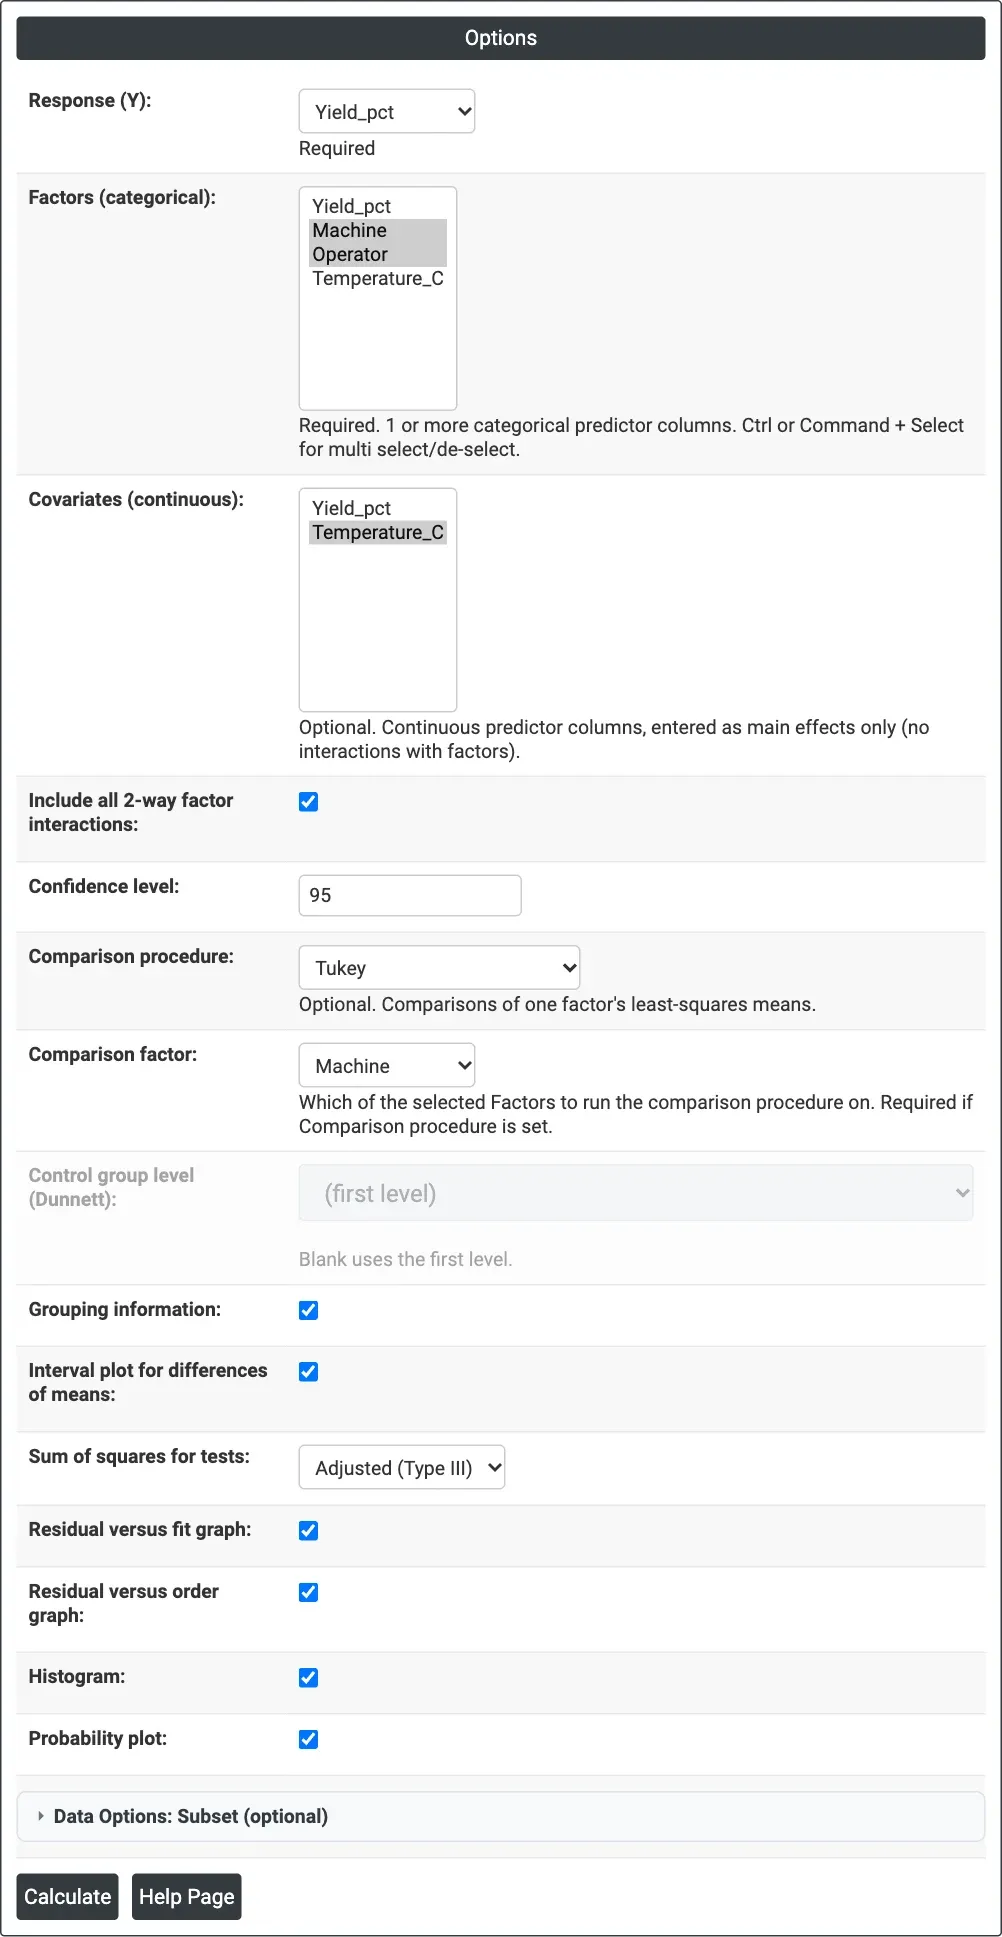
그림 1 — 수율 예제의 옵션: Yield_pct를 반응으로, Machine과 Operator를 요인으로 하고 이들의 교호작용, 공변량 Temperature_C, 기계에 대한 Tukey 비교를 지정했습니다.
출력 설명
- Method — 요인 코딩과 제곱합의 유형.
- Factor Information — 각 요인의 유형, 수준 수, 수준 값.
- Analysis of Variance — 각 항, 오차, 합계의 DF, Adj SS(또는 Seq SS), Adj MS, F-Value, P-Value.
- Model Summary — S, R-sq, R-sq(adj), R-sq(pred)를 보여 줍니다.
- Least-Squares Means — 각 요인의 수준별 N과 LS mean.
- Coefficients — Coef, SE Coef, T-Value, P-Value, VIF를 보여 줍니다.
- Fits and Diagnostics for Unusual Observations — 해당하는 관측값이 있을 때만 표시됩니다.
- Grouping Information, Simultaneous (또는 Individual) Tests for Differences of Means, 구간 그림 — 비교 방법을 선택한 경우.
- Versus Fit, Versus Order, Residuals Histogram, Probability Plot의 네 가지 잔차 그림.
- Download를 통한 PDF 내보내기.
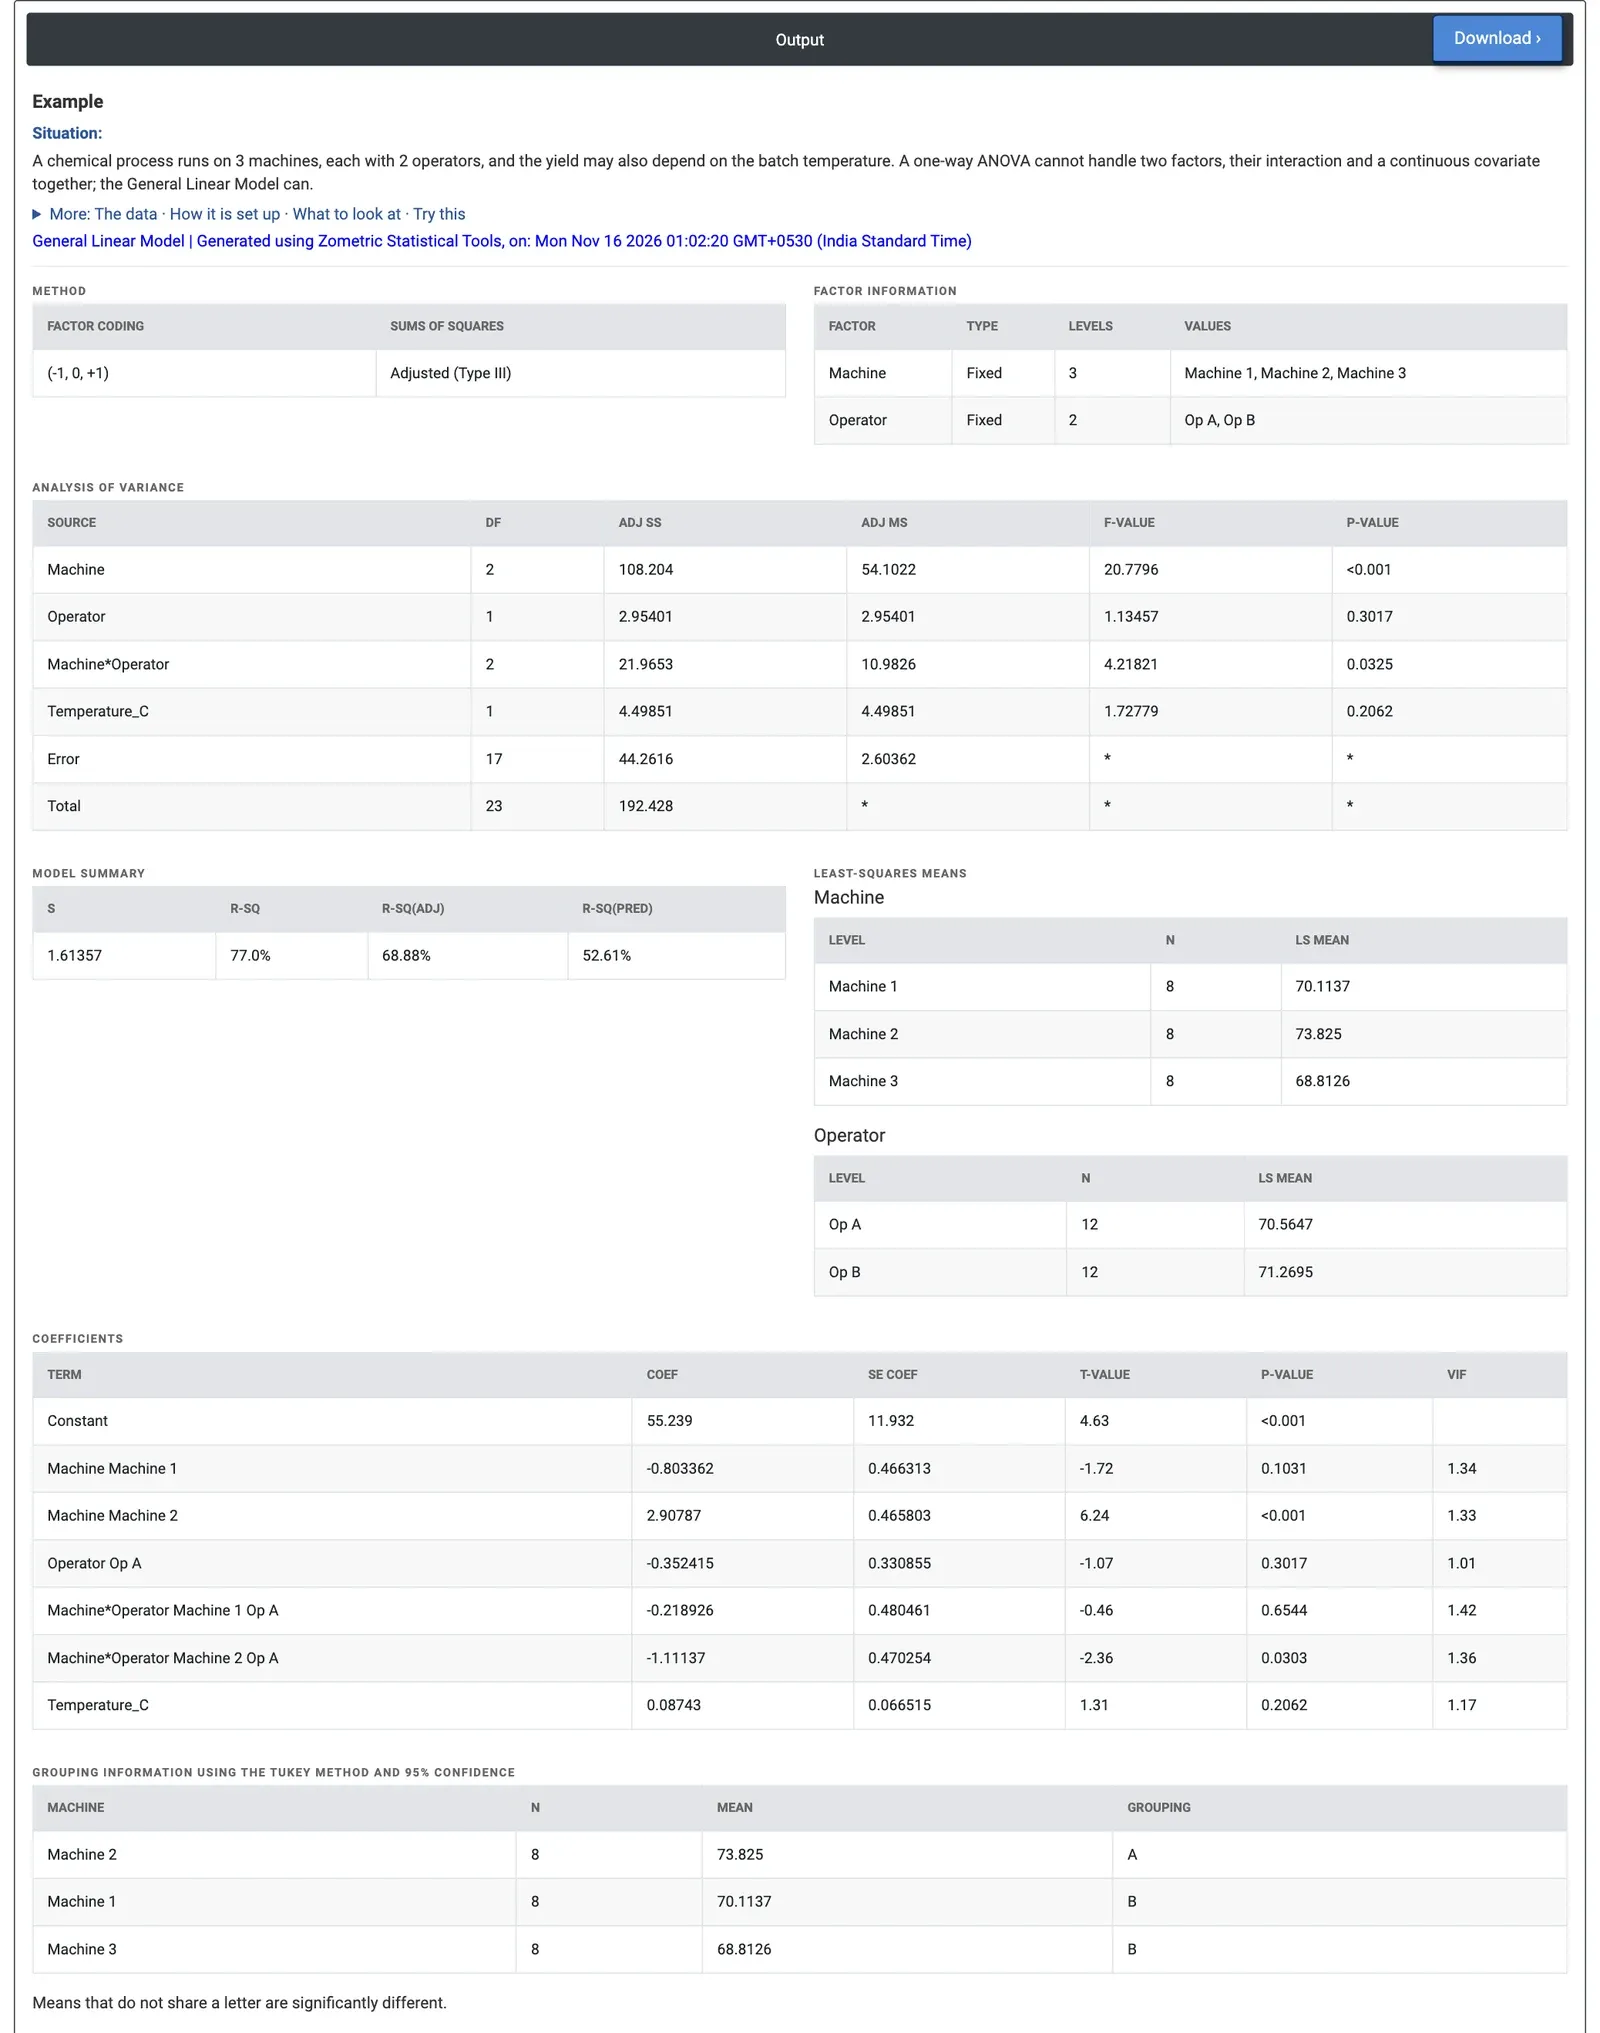
그림 2 — 수율에 대한 GLM 결과: Machine이 유의하며(p < 0.001) Machine*Operator 교호작용도 유의합니다(p = 0.0325). Machine 2의 LS mean이 73.83%로 가장 높습니다.
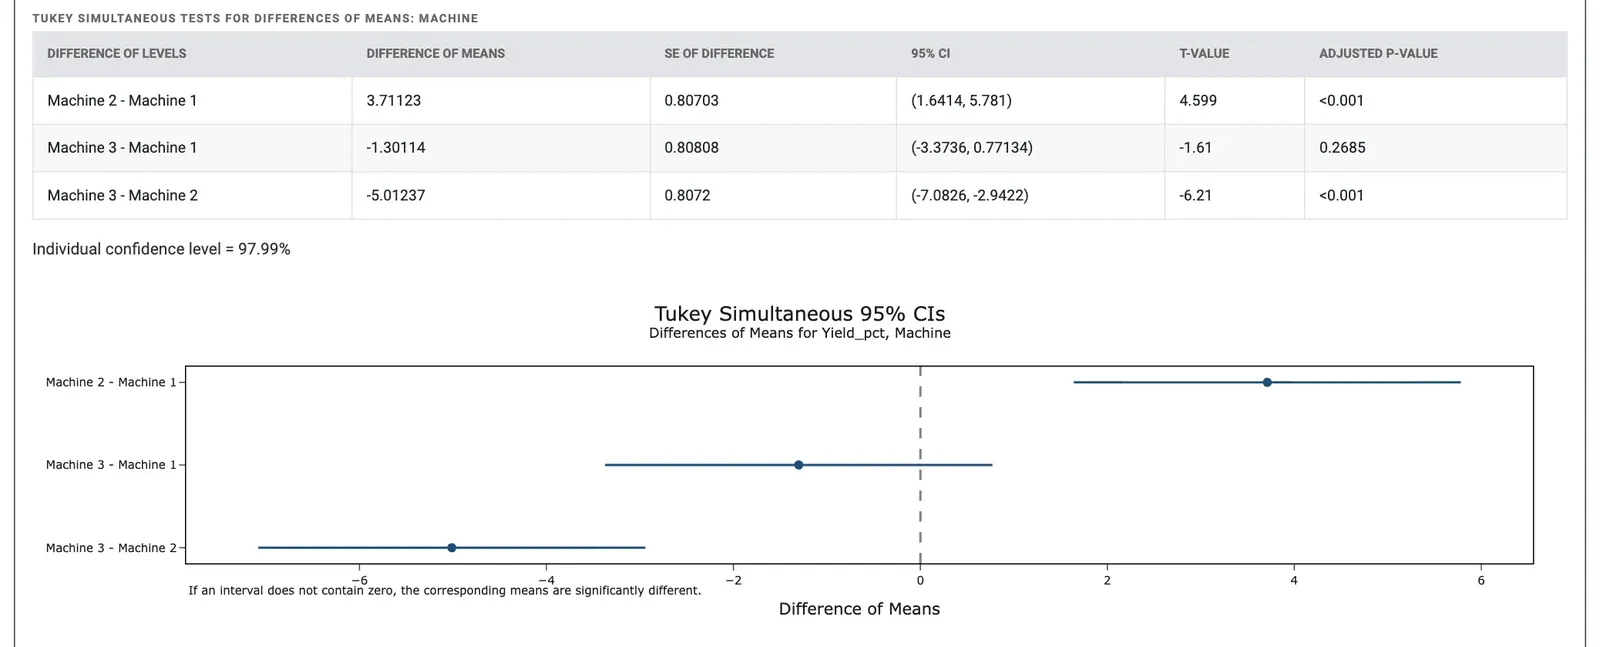
그림 3 — 기계에 대한 Tukey 비교: Machine 2는 다른 두 기계와 모두 다르며, Machine 3 − Machine 1의 구간은 0을 포함합니다.
계산 예제
한 화학 공정이 세 대의 기계에서 운영되며 각 기계에는 두 명의 작업자(Op A와 Op B)가 있고, 배치 수율은 배치 온도(170~190 °C)에도 좌우될 수 있습니다. 배치는 24개이며, 기계와 작업자 조합마다 4개입니다. 엔지니어는 Yield_pct를 반응으로, Machine과 Operator를 교호작용을 포함한 요인으로, Temperature_C를 공변량으로 선택하고 기계에 대한 Tukey 비교를 요청합니다.
기계 간에는 뚜렷한 차이가 있습니다(F = 20.78, p < 0.001). Machine*Operator 교호작용도 유의합니다(F = 4.22, p = 0.0325). Op B는 Machine 1과 2에서 더 높은 수율을 얻지만 Machine 3에서는 더 낮습니다. 작업자 단독(p = 0.3017)과 온도(p = 0.2062)는 연구한 범위에서 유의한 영향이 없습니다. 이 모형은 변동의 77.0%를 설명하며(R-sq(adj) 68.88%) S = 1.61 퍼센트포인트입니다. R-sq(pred)는 52.61%로 더 낮으므로, 새 배치에 대한 예측은 적합 결과가 시사하는 것보다 덜 정밀합니다.
최소제곱 평균은 Machine 2가 73.83%, Machine 1이 70.11%, Machine 3이 68.81%입니다. Tukey는 Machine 2를 단독으로 그룹 A에 둡니다. Machine 2는 Machine 1보다 3.71 포인트(95% CI 1.64~5.78), Machine 3보다 5.01 포인트 높은 수율을 보이며 둘 다 수정 p < 0.001이고, Machine 1과 3은 서로 다르지 않습니다(수정 p = 0.2685). 엔지니어는 Machine 2에서 무엇이 다른지 조사하고, 교호작용 때문에 방법을 표준화하기 전에 Machine 3의 작업자 조합을 살펴봅니다.
자주 묻는 질문
일원배치 분산분석 대신 일반 선형 모형은 언제 사용해야 합니까?
일원배치 분산분석으로 부족할 때 일반 선형 모형을 사용합니다. 예를 들어 수율이 기계, 작업자, 둘의 조합, 온도 같은 측정 조건에 좌우될 수 있는 경우나 데이터가 불균형인 경우입니다. 여러 범주형 요인, 2차 교호작용, 연속형 공변량을 하나의 모형에서 다루며, 고전적인 이원배치 분산분석도 포함합니다.
GLM에서 최소제곱 평균이란 무엇입니까?
최소제곱 평균은 다른 요인을 각 수준에 대해 평균하고 공변량을 평균값에 고정한 상태에서 한 요인 수준에 대한 모형의 예측값입니다. 원 평균과 달리 집단 크기 불균형이나 공변량 차이에 의해 치우치지 않습니다. GLM의 다중 비교는 한 요인의 수준 간에 이 최소제곱 평균을 비교합니다.
GLM에서는 어떤 다중 비교 방법을 사용해야 합니까?
Tukey는 스튜던트화 범위 분포로 모든 쌍을 비교하고, Fisher는 개별 t 검정을 사용하며, Bonferroni와 Sidak은 쌍의 수에 맞게 t 임계값을 조정하고, Dunnett는 모든 수준을 대조군과 비교합니다. 0을 포함하지 않는 구간이나 그룹 문자를 공유하지 않는 평균은 유의한 차이를 나타냅니다.
일반 선형 모형의 가정은 무엇입니까?
이 모형은 오차가 서로 독립이고 정규분포를 따르며 분산이 일정하다고 가정하며, 이는 적합값 대비 잔차, 순서 대비 잔차, 히스토그램, 확률도 같은 잔차 그림으로 확인합니다. ±2를 벗어나는 표준화 잔차는 R로 표시하고, 레버리지가 3p/n보다 큰 관측값은 특이 관측값으로 X로 표시합니다.