
일반화 분산 |S| 관리도(Generalized Variance |S| Chart)
일반화 분산 |S| 관리도는 평균을 감시하는 Hotelling T² 관리도와 MEWMA 관리도를 보완하여 상관된 둘 이상의 변수의 결합 산포를 추적합니다. 변수 수보다 큰 동일한 부분군 크기 n을 가진 부분군 열이 필요합니다. 부분군마다 |S|를 3 시그마에 해당하는 고정된 한계와 함께 타점으로 나타내고, Rule 1에 따라 UCL을 넘는 부분군을 표시합니다.
최종 검토
핵심 요점
일반화 분산 |S| 관리도는 각 부분군의 공분산 행렬의 행렬식을 타점으로 하여 상관된 둘 이상의 변수의 결합 산포를 감시하며, 평균 기반 관리도가 놓치는 변동성 변화를 포착합니다.
목적
일반화 분산 관리도는 상관된 둘 이상의 변수의 산포를 결합하여 감시하며, 결합 평균이 이동했는지를 감시하는 Hotelling T² 관리도와 MEWMA 관리도를 보완합니다. 공정이 목표값에 완벽하게 중심을 유지하면서도 분산/공분산 구조가 커지며 더 불안정해질 수 있고, 이때 T²나 MEWMA 관리도는 신호를 내지 않을 수 있습니다. 일반화 분산 관리도는 바로 이런 경우를 포착하기 위해 부분군 표본 공분산 행렬의 행렬식 |S|를 추적합니다.
주요 기능
- 부분군에 걸쳐 상관된 2개 이상 변수의 결합 산포(공분산 행렬의 행렬식)를 추적하여, 평균 기반 관리도가 탐지할 수 없는 다변량 변동성의 증가 또는 감소를 포착합니다.
- Subgroup indicator 열이 필요하며, 모든 부분군은 동일한 반복 횟수 n을 가져야 하고 n은 선택한 변수의 수보다 커야 합니다(부분군 공분산 행렬을 추정할 수 있도록).
- 설정할 수 있는 K 상수를 사용한 Rule 1(UCL을 넘는 점 1개)의 특수 원인 탐지.
통계적 방법
각 부분군 i(반복 행 n개, 선택한 변수 p개, n > p이며 모든 부분군의 n이 같음)에 대해 도구는 부분군 자체의 표본 공분산 행렬을 계산하고, 그 행렬식 |S_i|(“일반화 분산”)을 해당 부분군의 전체 다변량 산포를 나타내는 하나의 스칼라 요약값으로 타점합니다. |S_i|가 클수록 해당 부분군 안에서 p개 변수가 (개별적으로 그리고/또는 상관이 변한 방식에서) 더 많이 변했다는 뜻입니다.
합동 공분산 행렬 S̄(m개 모든 군내 공분산 행렬의 평균 또는 지정한 기준 부분군 집합의 평균)는 관리 상태의 일반화 분산 추정값 Σ̂ = det(S̄)을 줍니다. n과 p로부터 두 개의 치우침/분산 보정 상수를 계산합니다: b1 = [1/(n−1)^p] · Π_{i=1..p}(n−i), b2 = [1/(n−1)^(2p)] · Π_{i=1..p}(n−i) · [Π_{j=1..p}(n−j+2) − Π_{j=1..p}(n−j)]. 이는 |S|의 표집 분포에 대한 표준적인 적률 기반 상수입니다(Montgomery, Introduction to Statistical Quality Control).
이 관리도는 3 시그마에 해당하는 고정된 한계를 사용합니다(이 관리도에는 alpha 입력이 없음): CL = b1·Σ̂, UCL = Σ̂·(b1 + 3√b2), LCL = max(0, Σ̂·(b1 − 3√b2)).
Rule 1만 평가합니다. |S_i|가 UCL을 넘는 부분군은 나머지 공정에 비해 결합 변동성이 비정상적으로 크다는 신호로 표시되며, Rule 1의 기본 K는 3입니다.
입력 항목 및 옵션
항목 | 설명 |
Variables | 필수 항목입니다. 각 관측값에서 측정한 상관된 변수를 2개 이상 선택합니다. |
Subgroup indicator | 필수 항목입니다. 각 행이 어느 부분군에 속하는지 식별하는 열입니다. 모든 부분군은 반복 행의 수(n)가 같아야 하며, n은 선택한 변수의 수보다 커야 합니다. |
Check Rule 1 / K for Rule 1 | UCL을 넘는 점 1개. 기본적으로 선택되어 있으며 K = 3입니다. |
X scale | 부분군 축에 대한 선택적 사용자 지정 레이블입니다. |
Include or Exclude / Specify which rows / Row numbers | 어떤 부분군을 타점할지 제어합니다. |
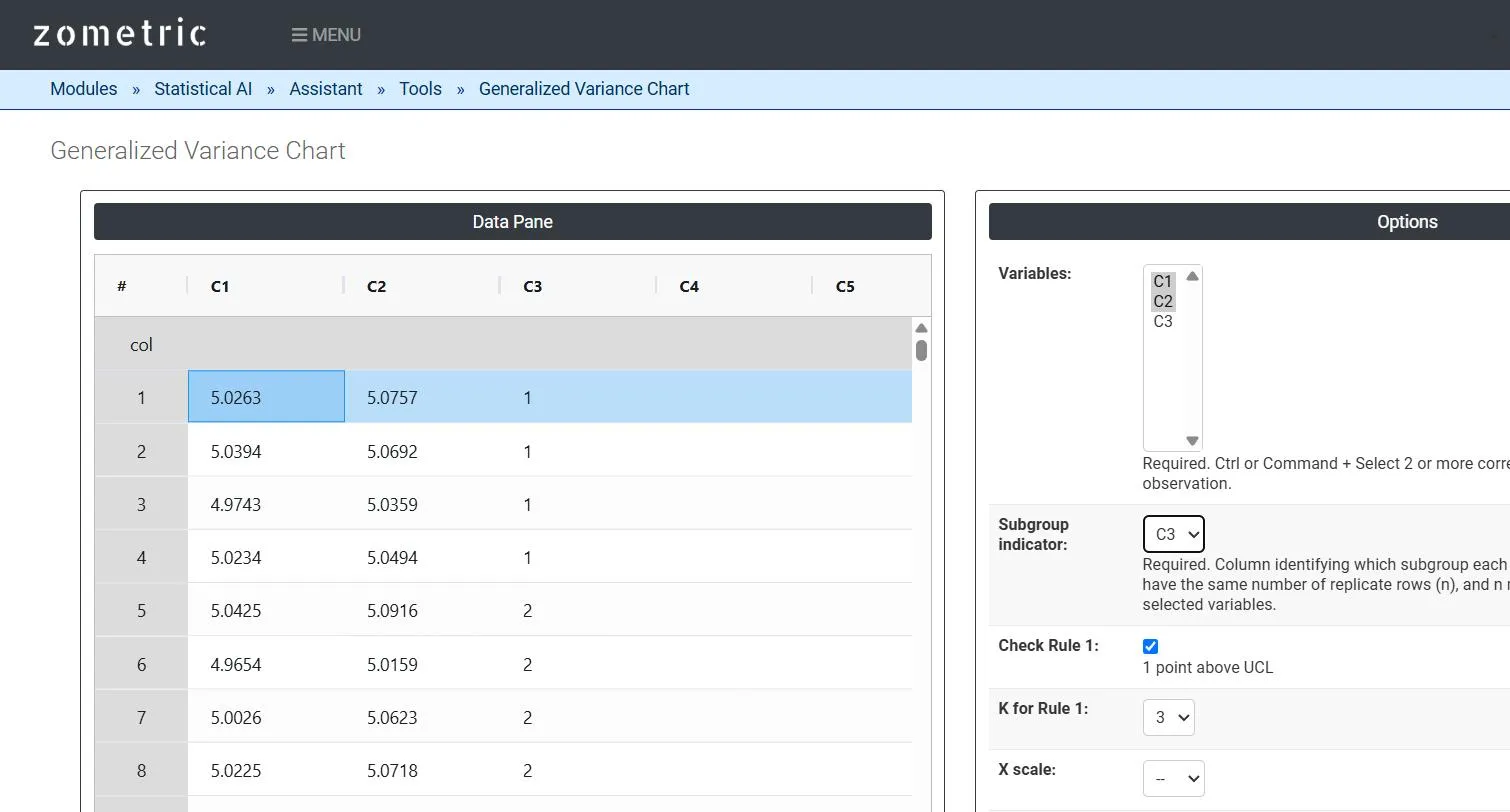
그림 1 — 부분군 15개(부분군당 4개, C3)에 걸친 핀/보어 직경 쌍 측정값 60행(C1–C2). Variables = C1, C2, Subgroup indicator = C3.
출력 설명
- Generalized Variance |S| Chart plot — 각 부분군의 표본 공분산 행렬의 행렬식을 부분군 순서대로 타점하고 UCL, 중심선, LCL을 함께 표시합니다.
- Rule 1에 따라 |S|가 UCL을 넘는 부분군은 관리도에 바로 강조 표시됩니다.
- Download as PDF를 통한 PDF 내보내기.
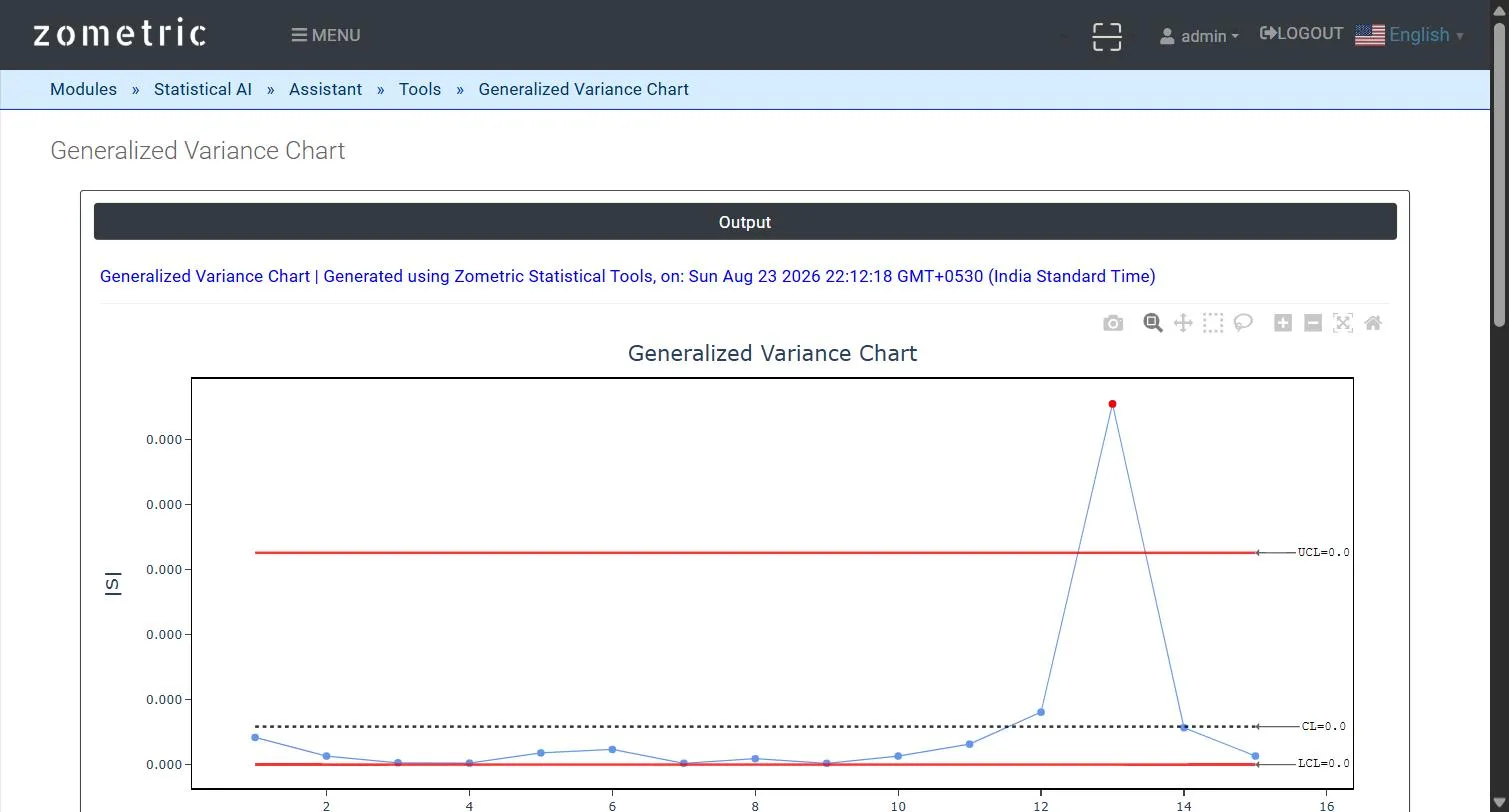
그림 2 — Generalized Variance |S| Chart 출력: 부분군별 |S|와 UCL/CL/LCL이 표시되며, 변동성이 커진 부분군은 빨간색으로 표시됩니다.
계산 예제
압입 조립품은 핀 직경(C1, mm)과 보어 직경(C2, mm)의 결합 변동성에 좌우되며, 부분군 15개(C3)에 걸쳐 부분군당 부품 4개를 측정합니다. 처음 11개 부분군은 조밀하고 안정적인 공분산 구조에서 추출되고, 마지막 4개 부분군은 데모 데이터 집합에서 분산/공분산을 의도적으로 키웠습니다(개별 평균은 내내 목표값에 머뭅니다). 그 결과 관리도는 부분군 11까지 평탄하고 관리 상태를 유지하다가, 부분군 13이 UCL 위로 급격히 치솟아 Rule 1에 따라 빨간색으로 표시됩니다. 이는 평균만 감시하는 T² 관리도나 MEWMA 관리도가 탐지하지 못했을 산포 증가를 포착한 것입니다.
자주 묻는 질문
일반화 분산 관리도는 무엇을 감시합니까?
각 부분군의 표본 공분산 행렬의 행렬식 |S|를 타점하여 상관된 둘 이상의 변수의 산포를 결합하여 감시합니다. |S|가 클수록 해당 부분군 안에서 변수들이 개별적으로 또는 상관이 변한 방식에서 더 많이 변했다는 뜻입니다. 목표값에 중심을 유지하면서도 더 불안정해지는 공정을 포착합니다.
일반화 분산 관리도는 Hotelling T² 관리도와 어떻게 다릅니까?
Hotelling T² 관리도와 MEWMA 관리도는 결합 평균이 이동했는지를 감시합니다. 공정이 중심을 유지하면서 분산과 공분산 구조가 커져도 T² 또는 MEWMA 관리도는 신호를 내지 않을 수 있습니다. 일반화 분산 관리도는 평균 대신 결합 산포를 추적하여 이들을 보완합니다.
일반화 분산 관리도에는 부분군 크기가 어느 정도 필요합니까?
모든 부분군은 반복 행의 수 n이 같아야 하고, 부분군 공분산 행렬을 추정할 수 있도록 n은 선택한 변수의 수보다 커야 합니다. 예제에서는 부분군 15개에 걸쳐 부분군당 부품 4개의 핀 직경과 보어 직경을 측정했습니다.
일반화 분산 관리도의 한계는 어떻게 설정합니까?
모든 부분군 또는 기준 집합으로부터 구한 합동 공분산 행렬이 관리 상태의 일반화 분산 추정값을 줍니다. n과 p로부터 두 보정 상수 b1과 b2를 계산합니다. 이 관리도는 alpha 입력 없이 3 시그마에 해당하는 고정된 한계를 사용하며, 기본 K가 3인 Rule 1(UCL을 넘는 점 1개)만 평가합니다.