
개별 분포 식별
개별 분포 식별은 데이터에 여러 확률분포를 동시에 적합하고 어느 분포가 통계적으로 가장 잘 맞는지 평가합니다. 이 도구는 정규성을 가정하는 대신 Weibull, Lognormal, Exponential, Logistic, Gamma 등 다양한 분포를 검정하고, 데이터의 형태와 거동을 얼마나 잘 설명하는지에 따라 순위를 매깁니다.
최종 검토
핵심 요점
개별 분포 식별은 데이터에 여러 확률분포를 동시에 적합하고 어느 분포가 통계적으로 가장 잘 맞는지 평가합니다.
이 페이지 내용
개별 분포 식별이란?
개별 분포 식별은 데이터에 여러 확률분포를 동시에 적합하고 어느 분포가 통계적으로 가장 잘 맞는지 평가합니다. 이 도구는 정규성을 가정하는 대신 Weibull, Lognormal, Exponential, Logistic, Gamma 등 다양한 분포를 검정하고, 데이터의 형태와 거동을 얼마나 잘 설명하는지에 따라 순위를 매깁니다.
이는 비정규 데이터에 대한 공정능력 분석에 필수적입니다. 잘못된 분포를 사용하면 Pp, Ppk 또는 Cp, Cpk 추정값이 부정확해지고 불량률 예측이 오해를 불러올 수 있기 때문입니다.
간단한 정의: 데이터를 여러 가지 통계 분포와 대조하여 어느 분포가 가장 잘 맞는지 알려 주는 도구로, 데이터가 정규분포를 따르지 않을 때도 정확한 공정능력 분석을 수행할 수 있게 합니다.
개별 분포 식별은 언제 사용합니까?
- 데이터가 정규성 검정을 통과하지 못하여 공정능력 분석 전에 올바른 분포를 식별해야 하는 경우에 사용합니다.
- 사이클 타임, 고장 시간, 화학 물질 농도, 입자 크기처럼 본질적으로 치우친 공정 데이터 를 다룰 때 사용합니다.
- 선택한 분포가 공정 거동을 정확하게 나타내는지 확인하기 위해 비정규 공정능력 분석 을 적용하기 전에 사용합니다.
- 데이터에 0이나 음수 값이 있는 경우처럼 Box-Cox 변환이 적절하지 않을 때 사용합니다.
개별 분포 식별의 올바른 사용 지침
- 분포 적합이 신뢰할 수 있으려면 데이터 점을 50~100개 이상 수집하십시오. 표본이 작으면 분포를 구분하기에 충분한 정보를 얻을 수 없습니다.
- 최적 분포를 선택할 때는 적합도 통계량(Anderson-Darling) 과 확률도를 함께 사용하십시오. p-값에만 의존하지 마십시오.
- 공정에 물리적으로 타당한 분포를 선택하십시오. AD 통계량이 가장 낮더라도 물리적 근거가 없는 분포는 최선의 선택이 아닐 수 있습니다.
- 분포를 적합하기 전에 데이터가 안정적이고 관리 상태인 공정 에서 나온 것인지 확인하십시오. 불안정한 공정 데이터에 분포를 적합하면 의미 없는 결과가 나옵니다.
- 표준 분포가 잘 맞지 않으면 대안으로 Johnson 또는 Box-Cox 변환 의 사용을 고려하십시오.
대안: 개별 분포 식별을 사용하지 않아야 할 때
- 데이터가 이미 정규로 확인된경우에는 분포 식별이 불필요하므로 곧바로 표준 정규분포 공정능력 분석 을 진행하십시오.
- 다른 분포를 탐색하지 않고 정규성만 확인하려는 경우에는 다음을 사용하십시오: 정규성 검정
- 데이터에 명확한 물리적 한계나 알려진 분포 유형이 있는 경우에는 모든 옵션을 검정하지 말고 공정능력 분석에서 그 분포를 직접 지정하십시오.
개별 분포 식별 예제
한 엔지니어가 캡슐을 무작위로 추출하여 칼슘 함량을 기록합니다. 가장 잘 맞는 데이터 분포를 정하기 위해 개별 분포 식별을 수행합니다. 검정 단계는 다음과 같습니다.
- 필요한 데이터를 수집했습니다.
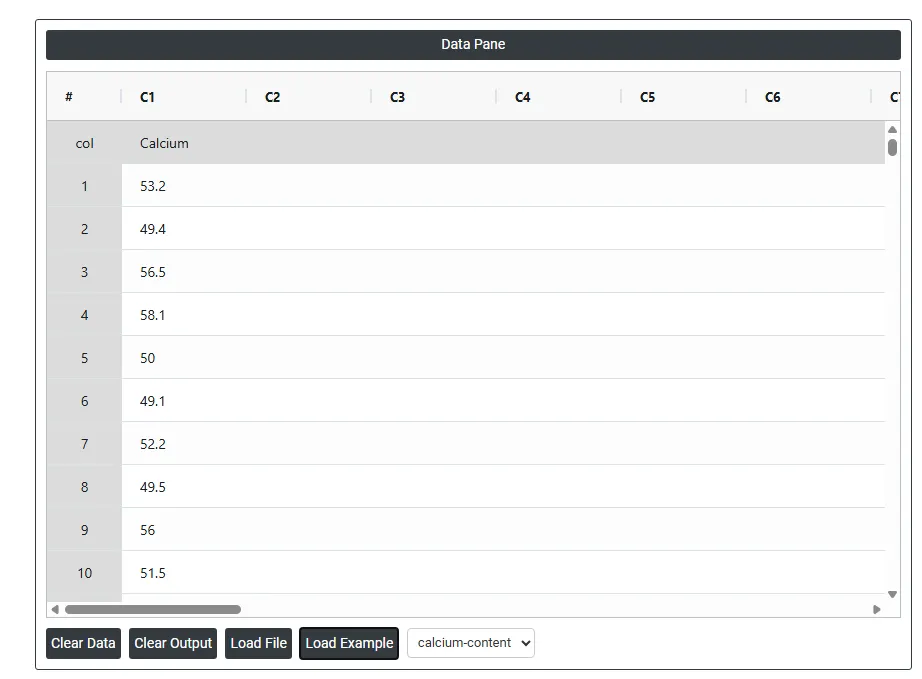
- 이제 Zometric Statistical Software에서 데이터를 분석합니다: https://statsai.zometric.com/.
- 개별 분포 식별을 찾으려면 Statistical module> Hypothesis Test> Individual Distribution Identification을 선택합니다.
- 도구 안에서 다음과 같이 데이터와 다른 입력값을 입력합니다.
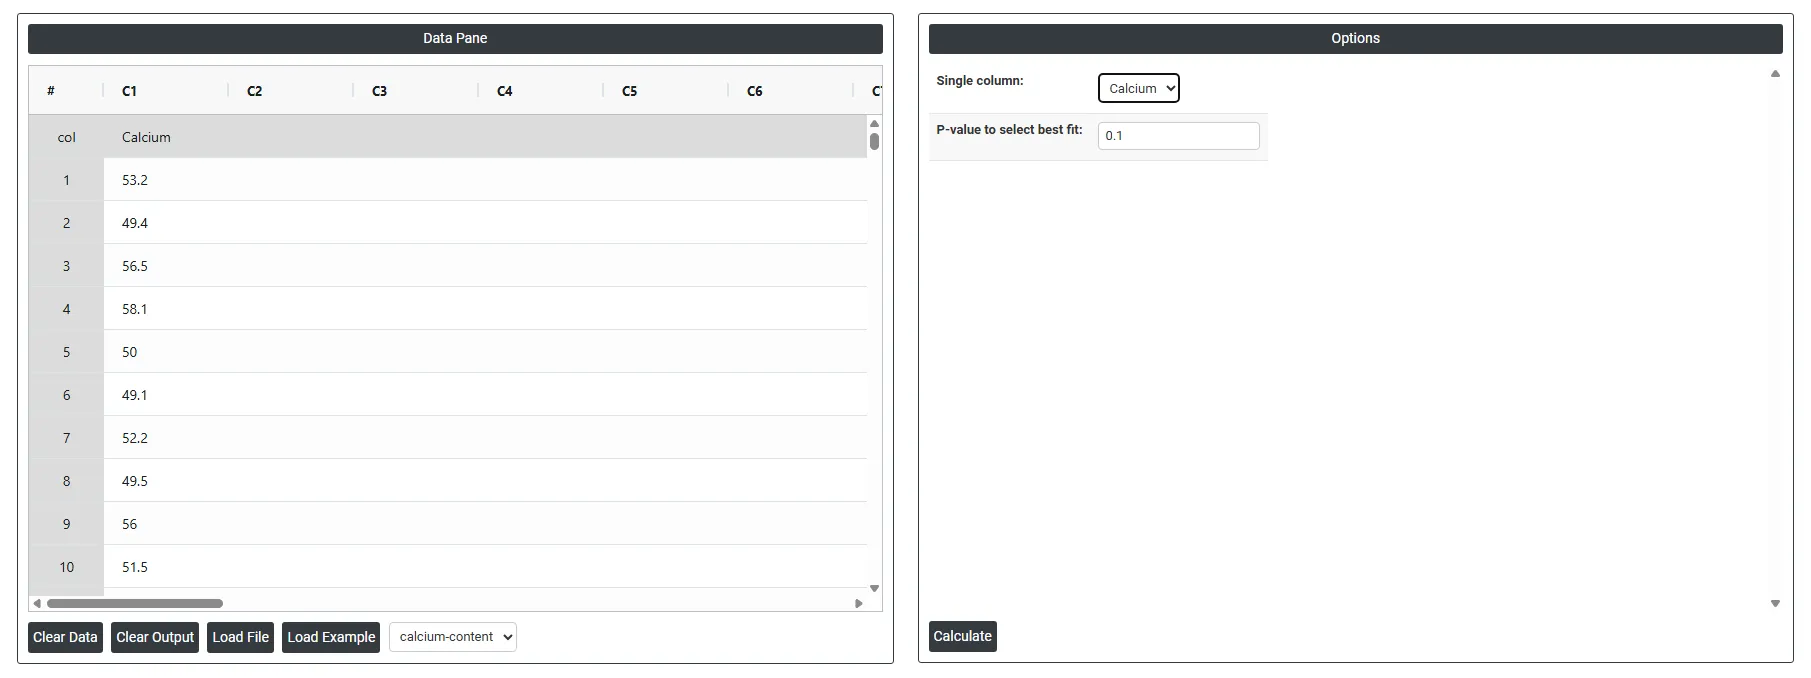
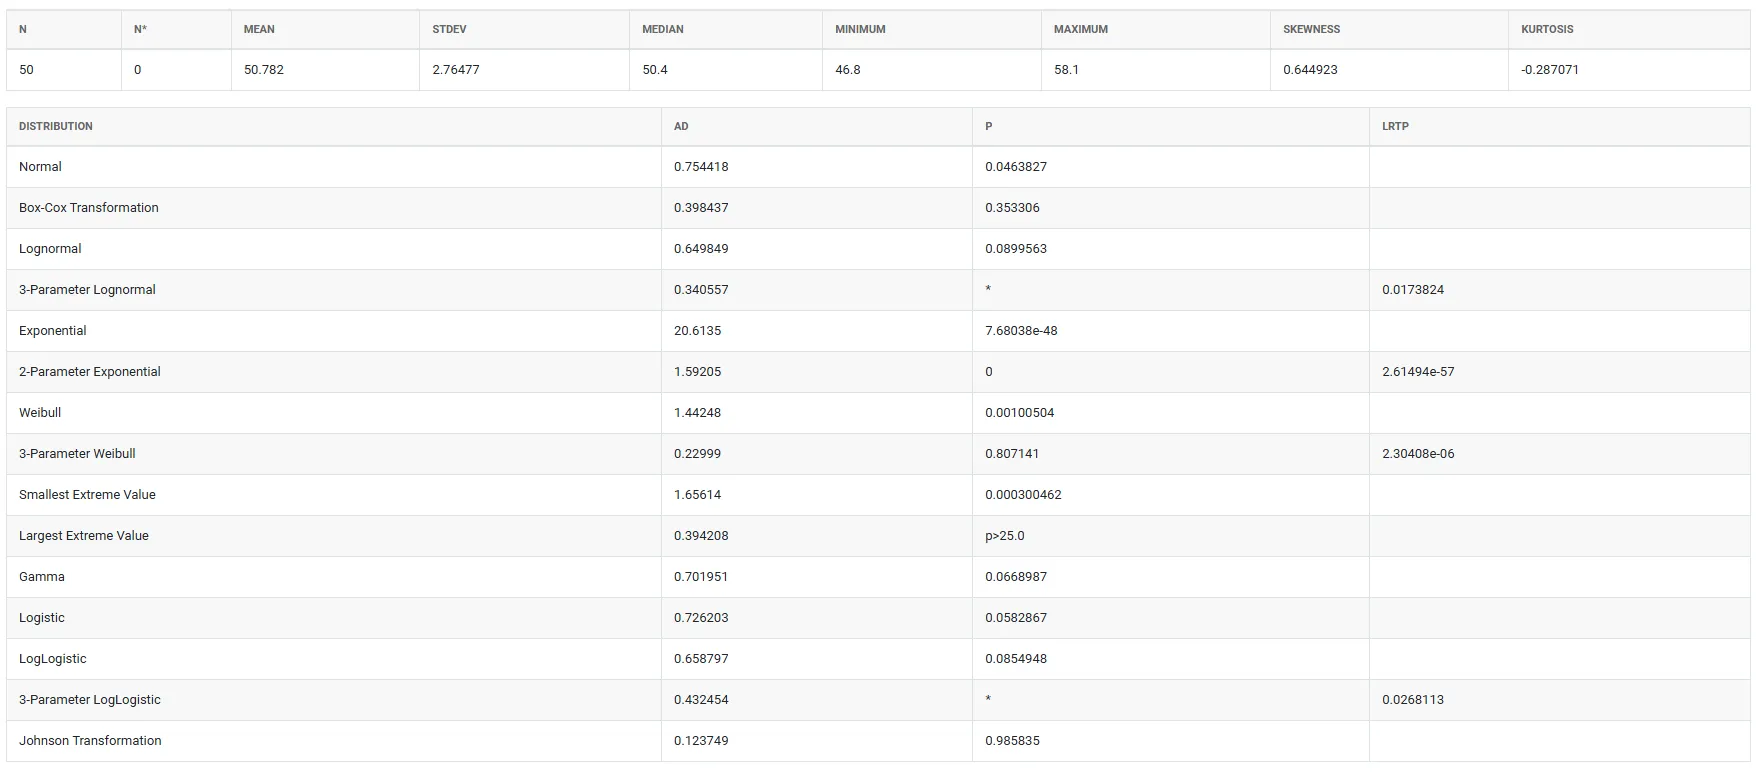
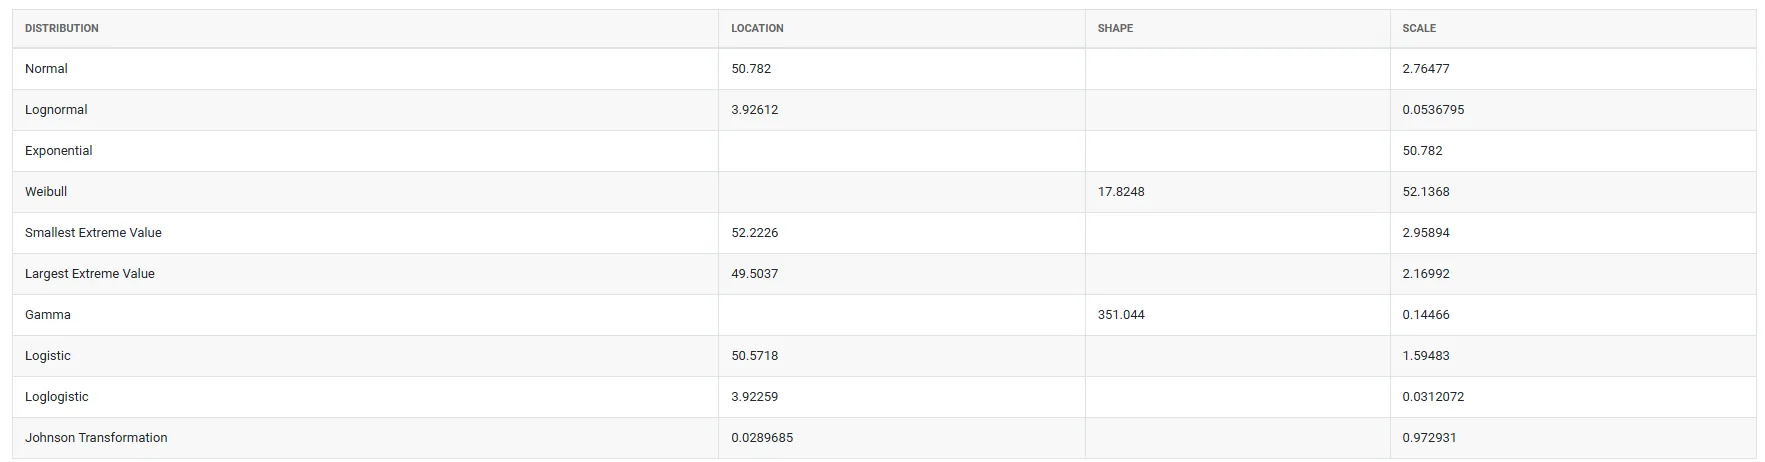
5. 위 도구를 사용하면 다음과 같은 출력이 나옵니다.
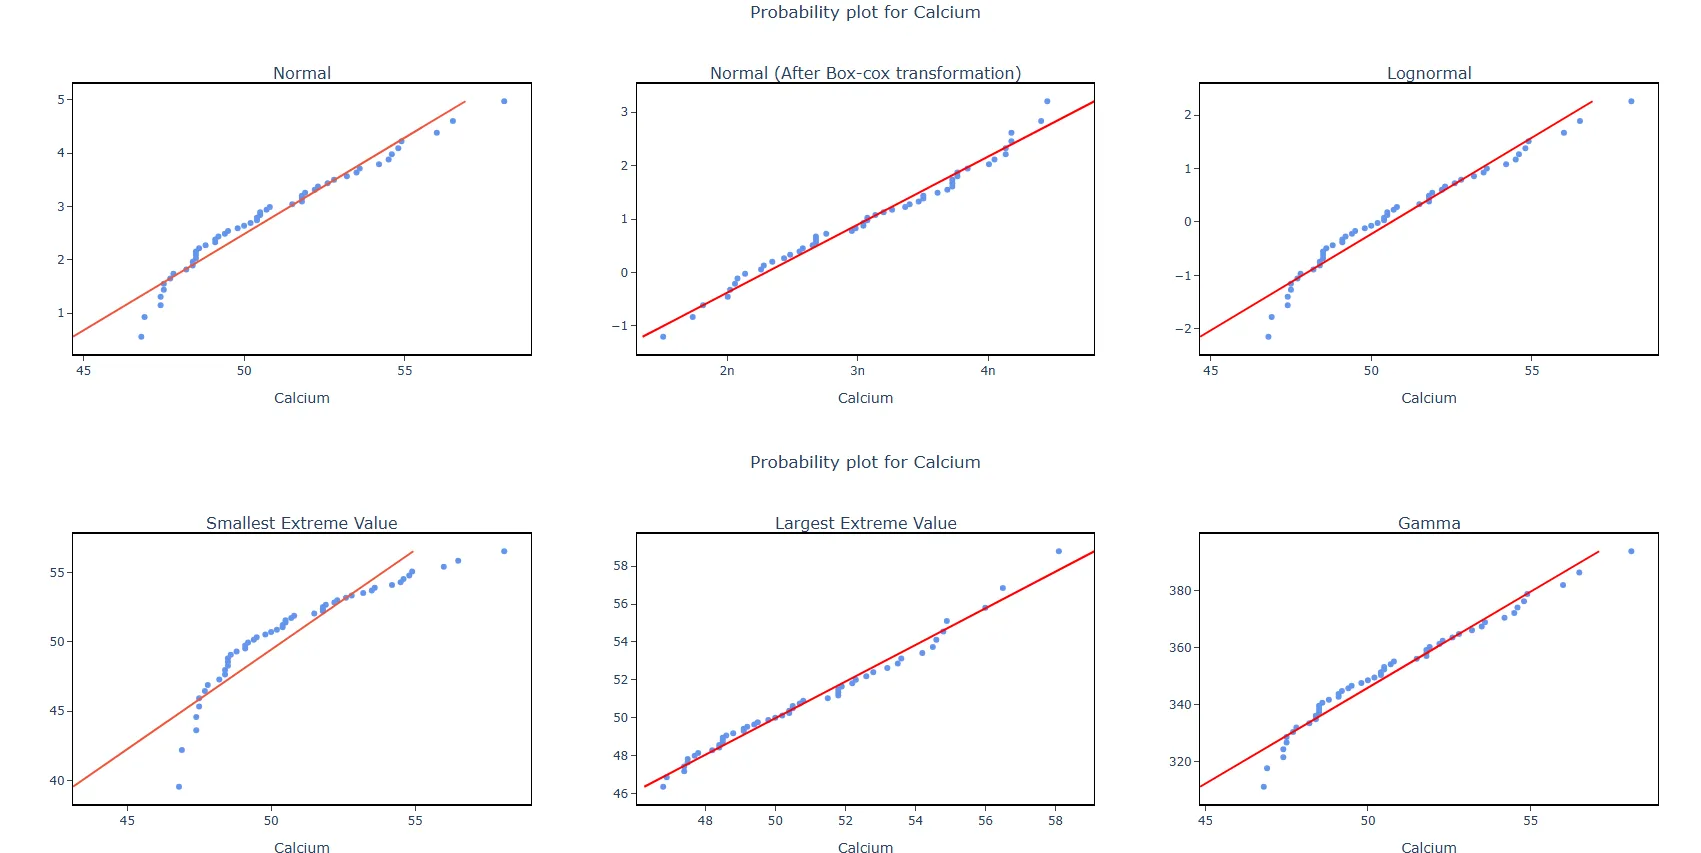
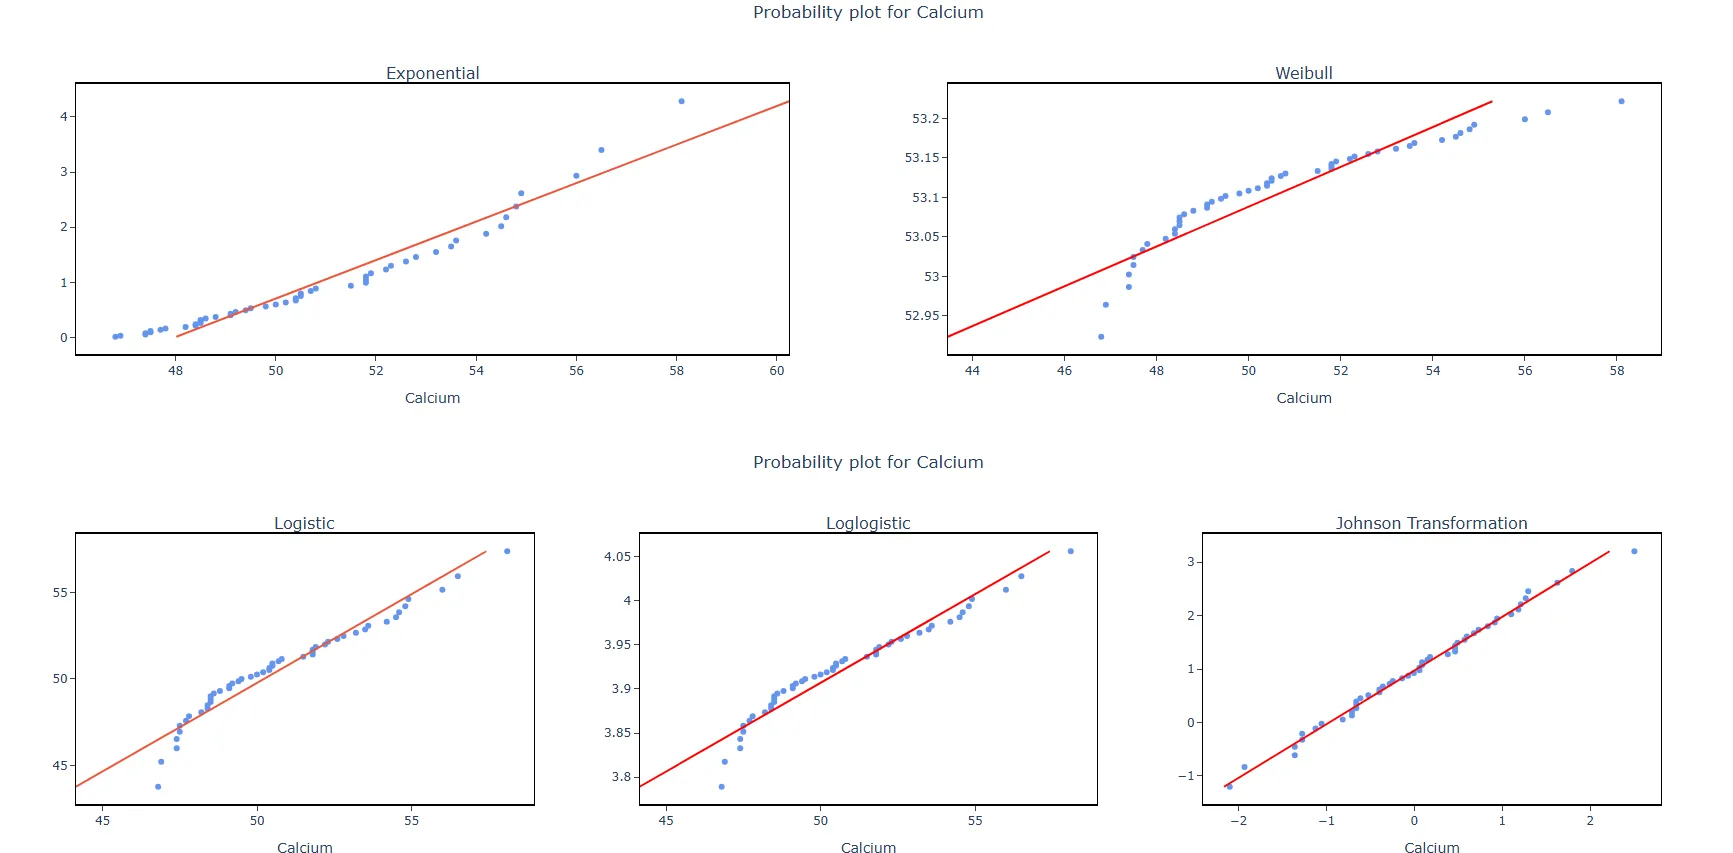
개별 분포 식별 방법
절차는 다음과 같습니다.
- Zometric Statistical Software에 로그인합니다: https://statsai.zometric.com/
- 홈 페이지에서 Statistical Tool> Hypothesis Test >Individual Distribution Identification을 선택합니다.
- 다음으로 데이터를 직접 입력하거나, 엑셀 시트의 데이터를 전체 복사(Ctrl+C)하여 여기에 붙여넣기(Ctrl+V)합니다.
- 필요한 옵션을 입력합니다.
- 마지막으로, 페이지 하단의 calculate를 클릭하면 원하는 결과를 얻을 수 있습니다.
개별 분포 식별의 도구 화면은 두 부분으로 나뉩니다.
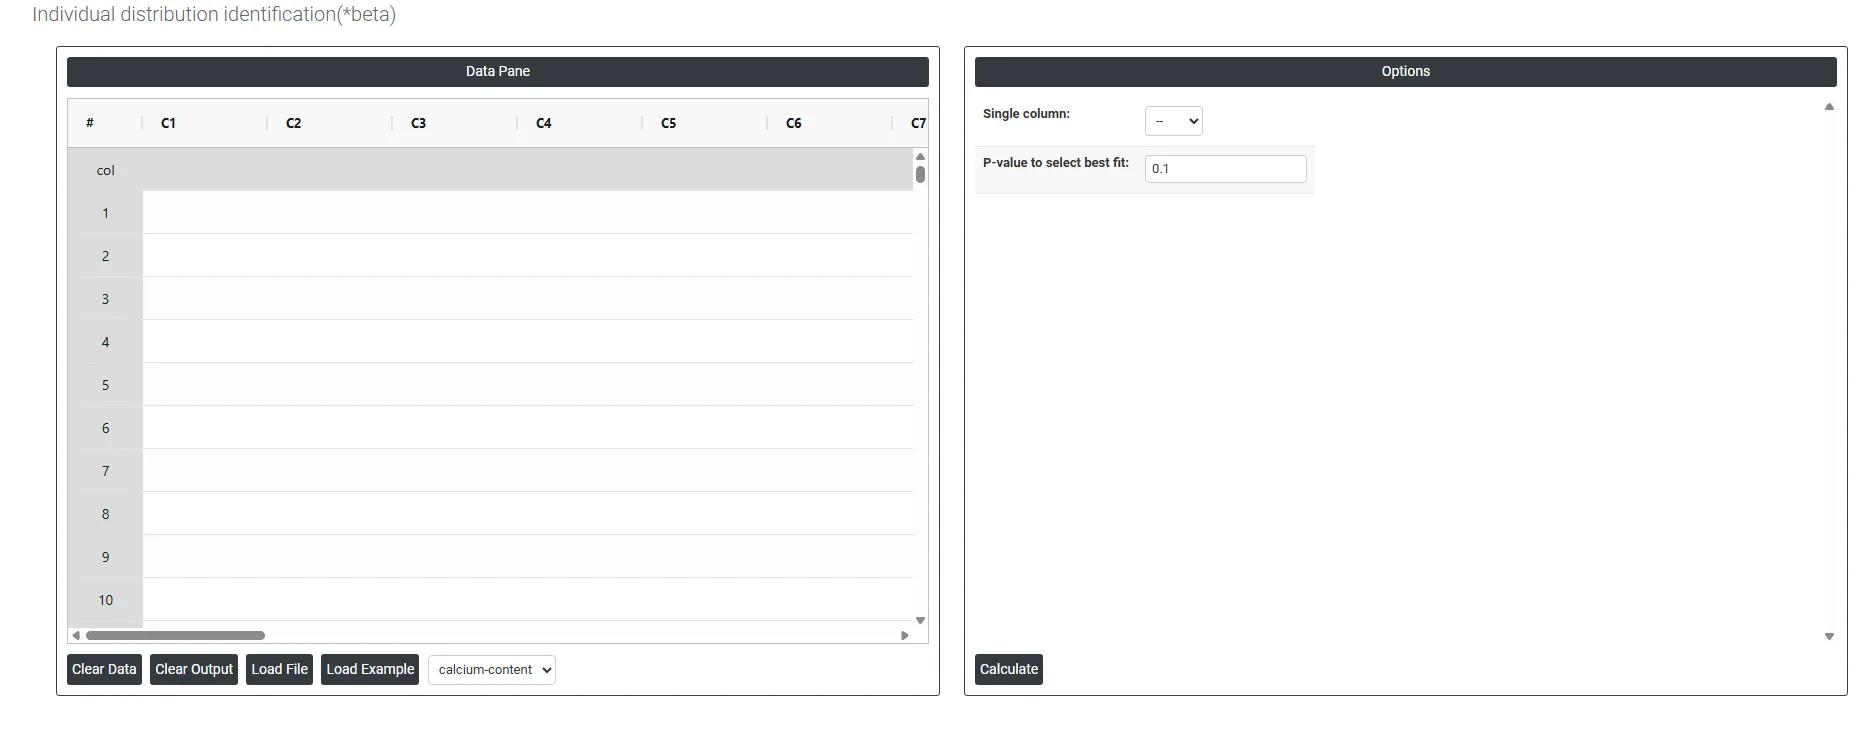
왼쪽 부분에는 데이터 창(Data Pane)이 있습니다. Data Pane에서는 각 행이 하나의 부분군을 이룹니다. 데이터는 직접 입력하거나, 엑셀 시트의 데이터를 전체 복사(Ctrl+C)하여 여기에 붙여넣기(Ctrl+V)할 수 있습니다.
Load example: 샘플 데이터가 불러와집니다.
Load File: 엑셀 데이터를 직접 불러올 때 사용합니다.
오른쪽 부분에는 다음과 같은 여러 옵션이 있습니다.
- Single Column: 분포를 적합하려는 연속형 데이터 가 들어 있는 열을 선택합니다. 예를 들어 칼슘 함량, 사이클 타임, 인장 강도, 입자 크기 같은 측정값입니다. 도구는 이 열의 모든 값을 여러 확률분포와 동시에 대조하여 어느 분포가 데이터의 형태와 거동을 가장 잘 설명하는지 판단합니다. 각 변수는 독립적으로 평가되므로 한 번에 하나의 열만 선택할 수 있습니다.
- P-Value to Select Best Fit: 어떤 분포가 데이터에 허용 가능한 적합 을 제공하는지 판단하는 유의 기준을 설정합니다. 표준 기본값은 0.05이며, Anderson-Darling 적합도 p-값이 0.05보다 큰 분포는 통계적으로 허용 가능한 적합으로 간주합니다. 즉 그 분포를 데이터의 모형으로 기각할 증거가 충분하지 않다는 뜻입니다. 이 맥락에서 p-값을 해석하는 방법은 다음과 같습니다.
- P-value > 0.05 — 분포가 데이터에 허용 가능하게 적합합니다. p-값이 높을수록 그 분포가 잘 맞는다는 증거가 강합니다.
- P-value ≤ 0.05 — 분포가 데이터에 잘 맞지 않으므로 공정능력 분석이나 이후 모형화에 사용하지 않아야 합니다.
- 허용 가능한 p-값을 보이는 분포가 여러 개이면 p-값이 가장 높은 분포를 1순위 후보로 선택하되, 항상 확률도의 시각적 검토와 함께 선택한 분포가 공정에 물리적으로 타당한지도 고려하십시오. 통계적으로는 적합하지만 데이터 유형에 대한 논리적 근거가 없는 분포는 사용 전에 의문을 가져야 합니다.
자주 묻는 질문
개별 분포 식별이란 무엇입니까?
개별 분포 식별은 Weibull, 로그정규, 지수, 로지스틱, 감마 등 여러 확률분포를 데이터에 한꺼번에 적합하고, 데이터를 얼마나 잘 설명하는지에 따라 순위를 매깁니다. 잘못된 분포를 사용하면 Pp, Ppk, Cp 또는 Cpk 추정값이 부정확해지고 불량률 예측이 오해를 불러올 수 있으므로, 비정규 데이터에 대한 공정능력 분석에 필수적입니다.
개별 분포 식별은 언제 사용합니까?
데이터가 정규성 검정을 통과하지 못하여 공정능력 분석 전에 올바른 분포가 필요한 경우, 사이클 타임, 고장 시간, 화학 물질 농도, 입자 크기처럼 공정 데이터가 본질적으로 치우친 경우, 데이터에 0이나 음수 값이 있어 Box-Cox 변환이 적절하지 않은 경우에 사용합니다.
최적으로 적합하는 분포는 어떻게 선택합니까?
Anderson-Darling p-값이 기준(기본값 0.05)보다 크면 허용 가능한 적합이고, 기준 이하이면 그 분포를 사용하지 않아야 합니다. 여러 분포가 적합하면 p-값이 가장 높은 분포를 1순위 후보로 삼되, 확률도도 검토하고 그 분포가 공정에 물리적으로 타당한지 확인하십시오.
분포 식별에는 데이터 점이 몇 개 필요합니까?
표본이 작으면 분포를 구분하기에 충분한 정보를 얻을 수 없으므로 데이터 점을 50~100개 이상 수집하십시오. 또한 불안정한 공정 데이터에 분포를 적합하면 의미 없는 결과가 나오므로, 데이터는 안정적이고 관리 상태인 공정에서 나온 것이어야 합니다.