
다중 변수 공정능력(Multiple Variables Process Capability)
다중 변수 공정능력은 캐비티, 기계, 라인 등 둘 이상의 열을 하나의 공통 LSL/USL과 선택적인 Target에 대해 평가합니다. 별도의 보고서를 비교하지 않고 성능이 가장 나쁜 공정을 찾을 때 사용합니다. 모든 변수는 정규분포로 가정하며 변수별 정규성 검정은 없습니다. 출력은 N, Mean, StDev, Pp, Ppk, Cpm, PPM이 있는 비교표 하나와 변수별 히스토그램입니다.
최종 검토
핵심 요점
다중 변수 공정능력은 금형 캐비티, 기계, 라인과 같은 여러 병렬 공정을 하나의 공통 규격에 대해 Pp, Ppk, Cpm 표 하나로 비교하여 어느 것이 최악인지 보여 줍니다.
목적
다중 변수 공정능력은 앱의 기존 공정능력 도구로는 간접적으로만 답할 수 있던 구체적이고 흔한 질문에 답합니다. 같은 특성을 여러 병렬 변수(사출 금형의 서로 다른 캐비티, 서로 다른 기계, 서로 다른 라인)에 걸쳐 하나의 공통 규격에 대해 측정할 때 어느 것이 최악인가? N개의 별도 공정능력 보고서를 실행하여 눈으로 비교하는 대신, 이 도구는 나란히 놓은 통합 비교표 하나와 히스토그램 세트 하나를 만들어, 모든 변수의 Cp/Cpk 계열 지수가 같은 표에 놓이게 합니다.
주요 기능
- 2개 이상의 열을 선택하면 N개의 보고서를 쌓아 놓는 대신 집계된 비교표 하나를 얻습니다.
- 하나의 LSL/USL 쌍이 선택한 모든 변수에 똑같이 적용되므로, 비교는 항상 같은 규격에 대한 동일 조건의 비교입니다.
- 선택 사항인 공통 Target을 지정하면 같은 비교표에 변수별 Cpm 지수가 추가됩니다.
- 집계표와 함께 공통 규격 한계를 겹쳐 놓은 변수별 히스토그램.
- 앱의 다른 공정능력 도구와 일관되게, 설정 가능한 K-시그마 공차 배수.
통계적 방법
선택한 각 변수/열은 독립적인 공정으로 취급되어, Automated Process Capability 도구의 정규분포 경로에서 사용하는 것과 같은 정규분포 공정능력 엔진으로 처리됩니다. 각 변수에 대해 σ_overall은 이동 범위법(MRbar/d2 또는 이동 범위의 중앙값)으로 추정하며, z 기반의 표준 공정성능 지수 계열을 계산합니다. Pp = (USL − LSL) / (K·σ), Ppu = (USL − x̄) / ((K/2)·σ), Ppl = (x̄ − LSL) / ((K/2)·σ), Ppk = min(Ppu, Ppl)이며 기본값은 K = 6입니다. 여기서는 모든 변수가 항상 정규분포를 가정하며, 이 도구에는 변수별 정규성 검정이나 비정규 경로 분기가 없습니다.
공통 Target을 지정하면 변수별로 Cpm도 추가로 계산합니다. Cpm = (USL − LSL) / (K·√(mean((x − Target)²)))이며, 산포만 보면 공정능력이 충분해 보이더라도 평균이 목표값에서 벗어난 변수에는 불이익을 줍니다.
모든 변수를 동일한 LSL/USL(그리고 지정된 경우 Target)에 대해 평가하므로, 결과로 나온 Ppk와 Cpm 값은 변수 간에 직접 비교할 수 있습니다. 비교표에서 Ppk(또는 Cpm)가 가장 낮은 변수가 공통 규격에 대해 성능이 가장 나쁜 변수입니다.
PPM Expected는 해당 변수에 적합한 정규분포의 각 규격 한계 바깥 꼬리 확률로 계산하고, PPM Observed는 해당 변수 자체의 표본 중 규격 한계 밖에 있는 경험적 비율입니다. 이를 통해 두 값이 일치하지 않는 경우(해당 변수에 정규분포 가정이 성립하지 않을 수 있다는 신호)를 찾을 수 있습니다.
입력 항목 및 옵션
항목 | 설명 |
Process variables | 필수. 비교할 2개 이상의 열을 선택하며, 각 열은 별도의 공정으로 취급됩니다. |
LSL / USL | 선택한 모든 변수에 적용됩니다. |
Target | 선택 사항. 비교표에 변수별 Cpm 지수를 추가합니다. |
Tolerance (K) | 공정능력 공차 범위를 만들 때 시그마에 곱하는 배수이며, 기본값은 6입니다. |
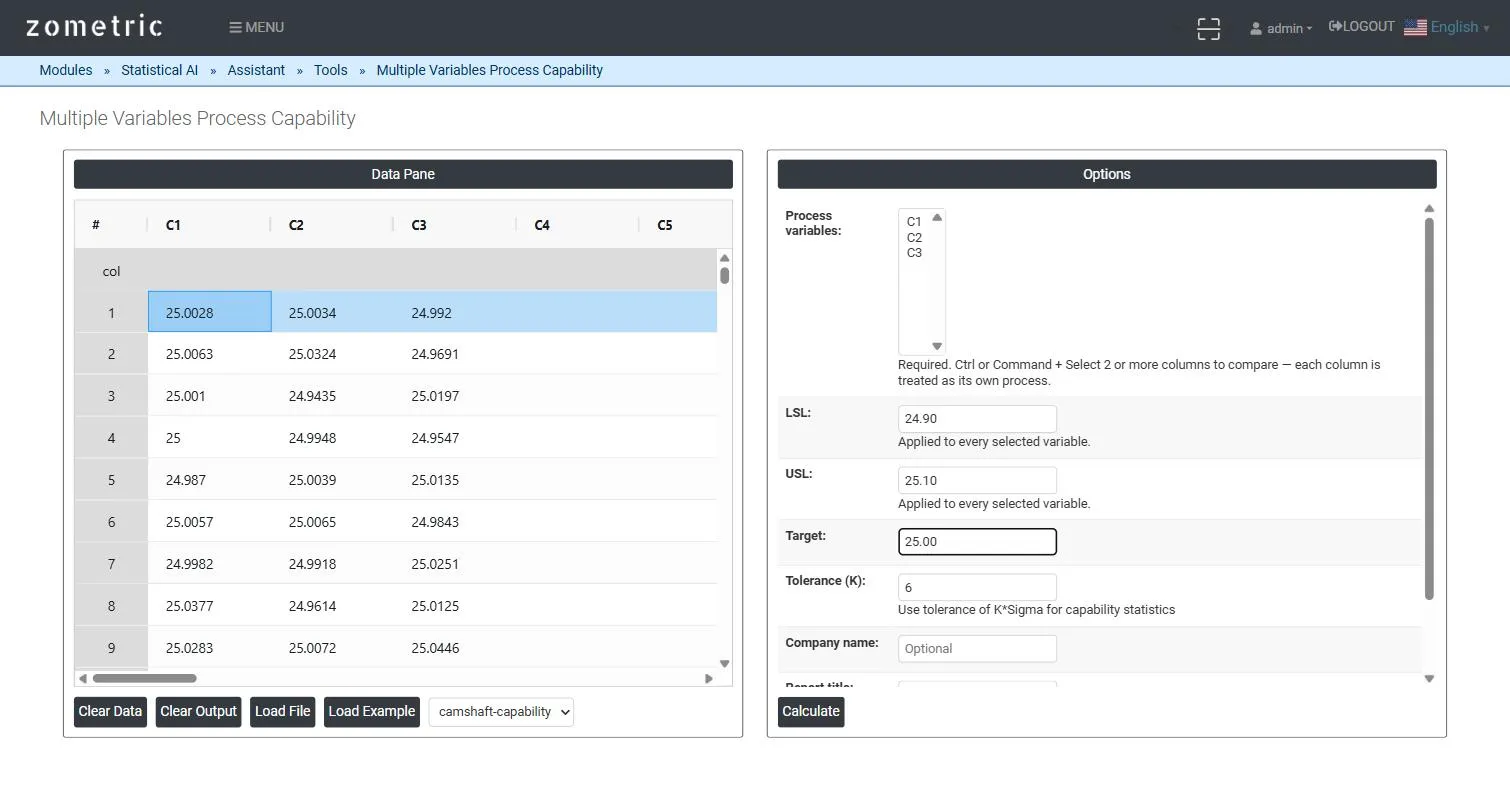
그림 1 — C1–C3에 있는 캐비티 3개의 보어 직경 측정값이 입력된 Data Pane이며, 세 열을 모두 Process variables로 선택하고 공통 LSL/USL/Target을 지정했습니다.
출력 설명
- Comparison table — 선택한 변수마다 한 행이며 N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm(Target을 지정한 경우), PPM Expected, PPM Observed가 모두 같은 공통 규격 한계에 대해 표시됩니다.
- Per-variable histogram — 각 변수 고유의 분포이며 공통 LSL/Target/USL 기준선과 적합한 정규분포 곡선이 함께 표시됩니다.
- Download as PDF를 통한 전체 비교 보고서의 PDF 내보내기.
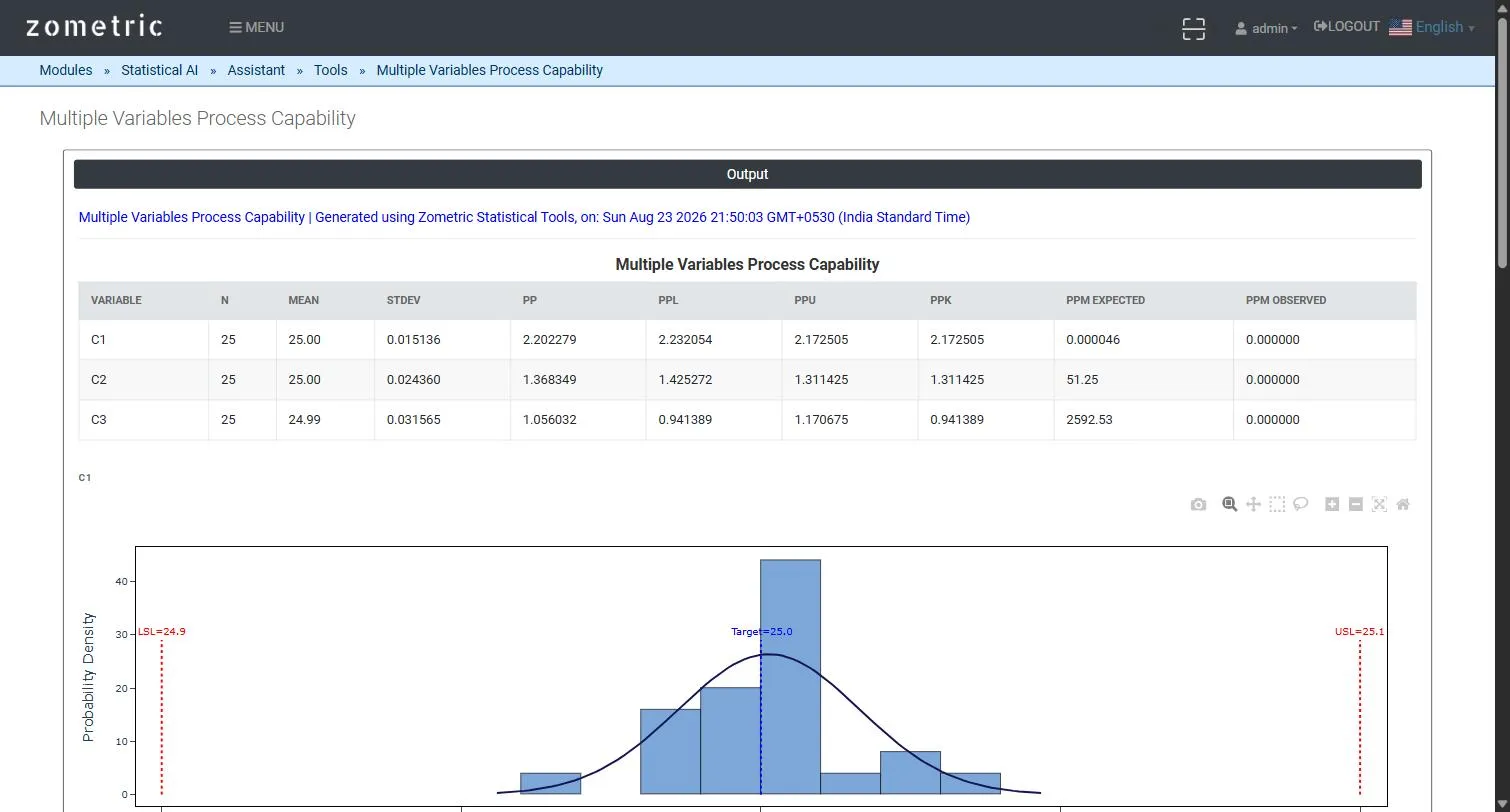
그림 2 — 통합 비교표(변수별 N, Mean, StDev, Pp, Ppl, Ppu, Ppk, Cpm, PPM Expected, PPM Observed)와 첫 번째 변수의 히스토그램.
계산 예제
사출 성형 금형에는 같은 부품을 생산하는 캐비티가 3개 있으며, 각 캐비티에서 부품 25개의 보어 직경(mm)을 측정하여(C1 = 캐비티 1, C2 = 캐비티 2, C3 = 캐비티 3) 공통 LSL = 24.90, USL = 25.10, Target = 25.00에 대해 평가합니다. 비교표에서 캐비티 1은 산포가 가장 작고(Ppk ≈ 2.17, Cpm ≈ 2.24) 캐비티 3은 눈에 띄게 나쁩니다(Ppk ≈ 0.94). 따라서 세 개의 별도 보고서를 실행하여 직접 비교하지 않고도 캐비티 3이 주의가 필요한 대상임을 즉시 알 수 있습니다.
자주 묻는 질문
다중 변수 공정능력이란 무엇입니까?
같은 특성을 여러 병렬 변수(서로 다른 금형 캐비티, 기계, 라인 등)에 걸쳐 측정하여 하나의 공통 규격에 대해 비교하는 공정능력 분석입니다. 별도의 보고서 대신 Pp, Ppl, Ppu, Ppk, Cpm, PPM 값을 나란히 놓은 비교표 하나를 만들어 성능이 가장 나쁜 변수를 쉽게 찾을 수 있습니다.
다중 변수 공정능력 연구에서 최악의 공정은 어떻게 찾습니까?
모든 변수를 동일한 LSL, USL, Target에 대해 평가하므로 Ppk와 Cpm 값을 직접 비교할 수 있습니다. Ppk가 가장 낮은 변수(Target을 지정한 경우에는 Cpm이 가장 낮은 변수)가 공통 규격에 대해 성능이 가장 나쁜 변수이며, 가장 먼저 조사해야 합니다.
다중 변수 공정능력은 정규성을 가정합니까?
예. 모든 변수는 정규분포 공정능력 계산으로 분석되며 변수별 정규성 검정이나 비정규 경로 분기는 없습니다. 적합한 정규분포 꼬리에서 구한 PPM Expected와 규격 밖의 실제 비율인 PPM Observed를 비교하면 두 값이 일치하지 않는 변수를 찾는 데 도움이 되며, 이는 정규분포 가정이 성립하지 않을 수 있다는 신호입니다.
Cpm은 비교에 무엇을 더해 줍니까?
공통 Target을 지정하면 각 변수에 대해 Cpm을 (USL - LSL)을 K와 Target으로부터의 제곱평균제곱근 편차의 곱으로 나눈 값으로 계산합니다. 산포만 보면 공정능력이 충분해 보이더라도 평균이 목표값에서 벗어난 변수에는 불이익을 줍니다.