
다중 대응 분석(Multiple Correspondence Analysis)
다중 대응 분석은 설문 응답이나 결점 기록처럼 셋 이상의 범주형 변수의 모든 범주를 지도에 나타내어, 서로 관련된 범주가 가까이 나타나게 합니다. 변수가 정확히 둘이면 단순 대응 분석을 사용합니다. 결측값이 있는 행은 제외됩니다. 출력에는 차원별 관성 표, 질량, 좌표, 품질, 기여도를 포함한 범주 표, 처음 두 차원의 지도가 포함됩니다.
최종 검토
핵심 요점
다중 대응 분석(MCA)은 셋 이상의 범주형 변수의 모든 범주를 하나의 지도에 배치하여, 고객 유형, 채널, 요금제처럼 자주 함께 나타나는 범주가 서로 가까이 위치하게 합니다.
목적
다중 대응 분석(MCA)은 셋 이상의 범주형 변수의 모든 범주를 하나의 지도에 배치합니다. 같은 응답자가 선택했거나 같은 항목에서 발견되는 범주는 서로 가까이 위치합니다. 범주형 항목이 여러 개인 설문 응답, 결점 기록 또는 심사 결과를 탐색하는 데 사용하며, 예를 들어 어떤 고객 유형이 어떤 채널 및 서비스 요금제와 함께 나타나는지, 또는 어떤 교대조, 라인, 결점 유형이 함께 발생하는 경향이 있는지 볼 수 있습니다. 변수가 정확히 둘이면 단순 대응 분석을 사용합니다.
주요 기능
- 셋 이상의 범주형 열을 한 번에 분석하며, 각 범주는 지도의 한 점이 됩니다.
- 모든 차원에 대한 관성 표이며, 백분율과 누적 백분율을 포함합니다.
- 선택한 차원 수에 대한 질량, 관성, 좌표, 품질, 제곱 상관, 기여도를 포함한 범주 표.
- 처음 두 차원에서 모든 범주를 변수별로 색을 구분하여 나타낸 열 그림.
- 결과의 PDF 내보내기.
통계적 방법
선택한 변수 중 하나라도 결측값이 있는 행은 제외되며, 모든 값은 범주 레이블로 취급됩니다. 데이터는 각 변수의 범주마다 0/1 열 하나를 갖는 지시 행렬 Z로 변환됩니다(J개 변수에 대해 전체 K개 열). MCA는 이 행렬에 대한 대응 분석입니다. Z를 총합으로 나누어 비율 P를 구하고, 행 질량 r과 열(범주) 질량 c를 계산하며, 표준화 잔차 S = Dr^−½ (P − r cᵀ) Dc^−½를 특이값 분해로 분해합니다. 각 특이값 d는 관성이 d²인 하나의 차원을 줍니다. 차원은 K − J개이며 총 관성은 항상 (K − J) / J이므로, 데이터가 아니라 범주의 수에만 의존합니다.
범주 좌표는 주좌표 Dc^−½ V D입니다. Mass는 지시 행렬 총합에서 범주가 차지하는 비중이며, 이는 상대도수를 J로 나눈 값입니다. Inert는 총 관성에서 범주가 차지하는 비중입니다. Quality는 중심으로부터의 범주의 제곱 거리 중 보고된 차원이 보여 주는 비중입니다(0~1). Corr는 한 차원에 대한 그 비중이고, Contr는 한 차원의 관성 중 범주가 차지하는 비중입니다. 지시 행렬 코딩은 관성을 많은 차원에 분산시키므로, MCA에서 처음 두 차원이 설명하는 백분율은 보통 단순 대응 분석보다 훨씬 작습니다. 지도는 여전히 유용할 수 있지만 품질이 낮은 범주는 잘 표현되지 않습니다.
입력 항목 및 옵션
항목 | 설명 |
Categorical variables | 셋 이상의 범주형 열입니다. 여러 개를 선택하려면 Ctrl 또는 Command를 누릅니다. 변수가 정확히 2개이면 대신 단순 대응 분석을 사용합니다. |
Number of components | 범주 표에서 Quality, Corr, Contr를 보고할 차원의 수입니다. 기본값은 2이며 범위는 1~20이고, 사용 가능한 수로 제한됩니다. 그림에는 항상 처음 2개가 표시됩니다. |
Title | 그림에 표시되는 제목입니다. 기본값은 Multiple Correspondence Analysis입니다. |
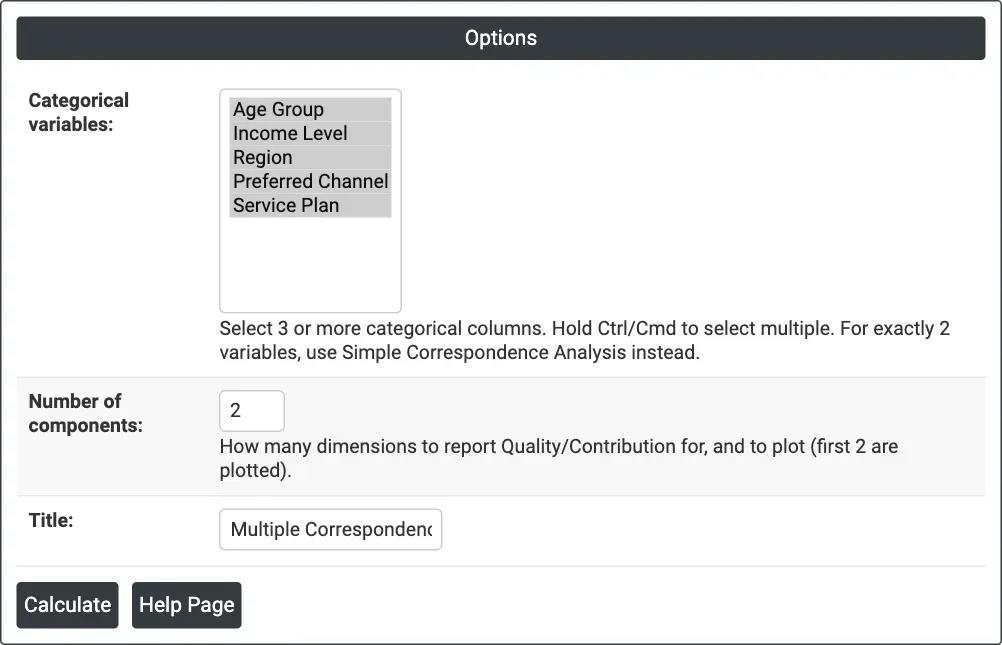
그림 1 — 예제의 옵션: 범주형 변수로 다섯 개의 설문 문항, 성분 2개.
출력 설명
- Multiple Correspondence Analysis plot — Dimension 1 대 Dimension 2에 모든 범주를 변수별로 색을 구분하여 나타냅니다(축 제목에 관성의 백분율 표시). 각 점에는 범주가 표시되며, 색상과 범례가 변수를 나타내고 마우스를 올리면 둘 다 표시됩니다. 레이블은 겹치지 않도록 배치됩니다.
- Total inertia — 총 관성과 차원의 수입니다.
- Analysis of Indicator Matrix — 모든 차원의 Component (Dim1, Dim2, ...), Inertia, Percent, Cumulative Percent입니다.
- Column Contributions — Category, Variable, Mass, Inert, 보고된 각 차원의 좌표, Quality, 보고된 각 차원의 Corr와 Contr입니다.
- Download를 통한 PDF 내보내기.
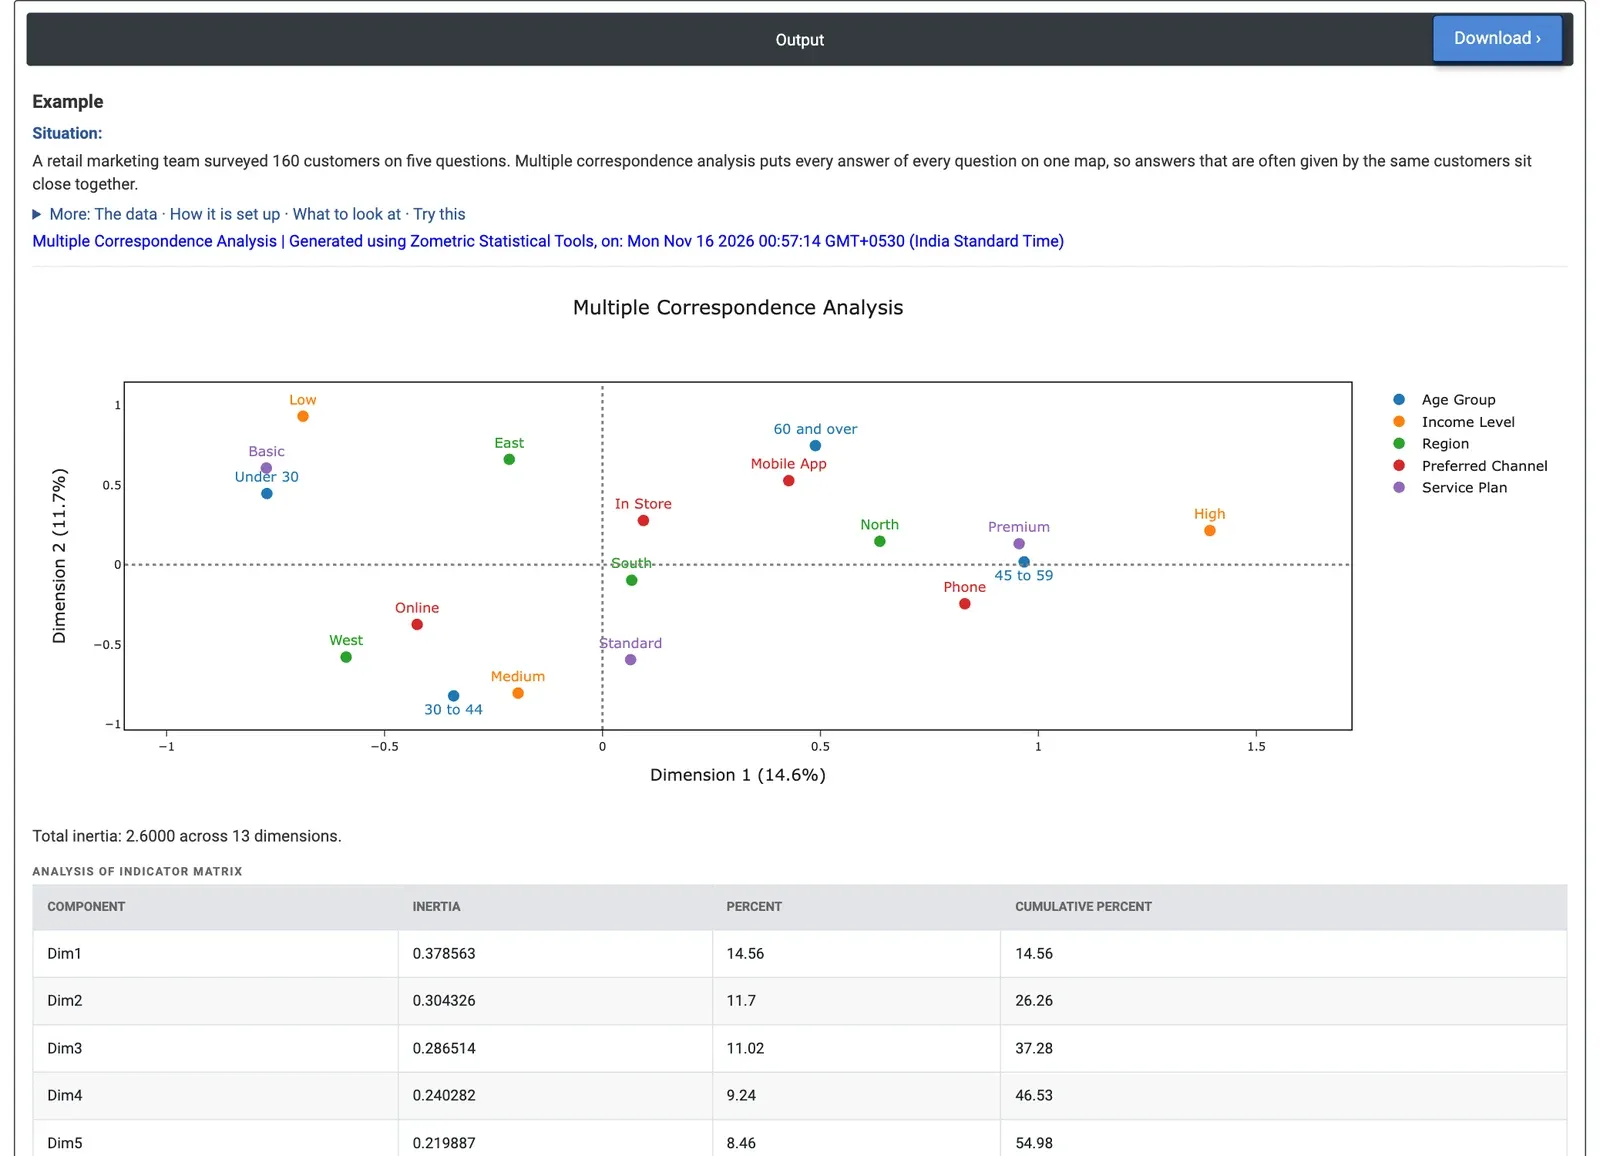
그림 2 — 고객 160명의 다섯 개 설문 문항에 대한 범주 지도: Dimension 1(14.6%)은 저소득, Basic 요금제, 30세 미만에서 고소득, Premium 요금제, 45~59세로 이어집니다.
계산 예제
한 소매업 마케팅 팀이 고객 160명에게 연령대(4개 집단), 소득 수준(Low, Medium, High), 지역(North, South, East, West), 선호 채널(Online, In Store, Mobile App, Phone), 서비스 요금제(Basic, Standard, Premium)의 다섯 문항을 조사했습니다. 팀은 맞춤형 제안을 계획하기 위해 어떤 응답이 함께 나타나는지 보려고 합니다. 다섯 개 열을 모두 Categorical variables로 선택하고 Number of components = 2를 유지합니다.
범주 18개는 차원 13개와 총 관성 2.6을 줍니다. Dimension 1은 14.56%, Dimension 2는 11.7%를 설명하여 합계 26.26%인데, 이 정도로 많은 범주가 있는 MCA에서는 정상적인 수준이지만 지도는 대략적인 요약으로 읽어야 합니다. Dimension 1은 왼쪽의 Income Level: Low (−0.687), Service Plan: Basic (−0.771), Age Group: Under 30 (−0.770)에서 오른쪽의 Income Level: High (1.393), Service Plan: Premium (0.956), Age Group: 45 to 59 (0.967)로 이어집니다. Income Level: High는 Dimension 1 관성의 23.1%를 차지하여 모든 범주 중 가장 큽니다. Dimension 2에서는 Income Level: Medium (−0.804), Age Group: 30 to 44 (−0.821), Service Plan: Standard (−0.595)가 아래쪽에 함께 위치합니다.
Region: South(품질 0.0054)와 Preferred Channel: In Store(0.0475)는 품질이 매우 낮은 채 중심 근처에 있어, 이 지도에서 잘 표현되지 않으며 어떤 집단에도 속하지 않습니다. 팀의 입장에서는 소득 수준과 서비스 요금제가 주요 패턴을 이루고 연령이 그 뒤를 따르며, 지역과 채널은 거의 기여하지 않습니다. 원자료에서 저소득 고객의 60.4%가 Basic을, 고소득 고객의 52.8%가 Premium을 선택했습니다. 분석에서 Region을 제거하면 처음 두 차원의 비중이 32.57%로 올라갑니다.
자주 묻는 질문
다중 대응 분석이란 무엇입니까?
다중 대응 분석(MCA)은 셋 이상의 범주형 변수의 모든 범주를 하나의 지도에 배치하며, 같은 응답자가 선택했거나 같은 항목에서 발견되는 범주는 서로 가까이 위치합니다. 설문 응답, 결점 기록 또는 심사 결과를 탐색하는 데 사용하며, 예를 들어 어떤 교대조, 라인, 결점 유형이 함께 발생하는 경향이 있는지 볼 수 있습니다.
MCA와 단순 대응 분석의 차이는 무엇입니까?
단순 대응 분석은 범주형 변수가 정확히 둘일 때 사용하고, MCA는 셋 이상을 다룹니다. MCA는 범주마다 0/1 열 하나를 갖는 지시 행렬을 분석합니다. 이 코딩이 관성을 많은 차원에 분산시키므로, MCA에서 처음 두 차원이 설명하는 백분율은 보통 단순 대응 분석보다 훨씬 작습니다.
MCA 그림은 어떻게 해석합니까?
지도에서 가까이 있는 범주는 함께 나타나는 경향이 있습니다. 축의 백분율은 각 차원이 설명하는 관성의 비중으로 읽습니다. 각 범주의 Quality(0~1)를 확인하십시오. 품질이 낮고 흔히 중심 근처에 있는 범주는 지도에 잘 표현되지 않으므로 어떤 집단에 속한다고 해석하지 않아야 합니다. Contr는 각 차원을 규정하는 범주를 보여 줍니다.
MCA에서 설명되는 관성이 왜 그렇게 낮습니까?
MCA의 총 관성은 항상 (K - J) / J이며, 여기서 K는 범주의 수, J는 변수의 수이므로 범주의 수에만 의존합니다. 지시 행렬 코딩이 이 관성을 많은 차원에 분산시키므로 처음 두 차원의 백분율이 낮은 것은 정상입니다. 지도는 대략적인 요약으로 읽어야 합니다.