
다중 변수 공정능력(비정규)
이 도구는 입자 크기, 평탄도, 불순물처럼 데이터가 치우친 경우에 둘 이상의 열의 공정능력을 하나의 규격에 대해 비교합니다. Weibull, Lognormal, Box-Cox, Johnson을 포함한 15가지 모형 중 선택한 하나를 Z-Score 또는 ISO 방법으로 각 열에 적합합니다. 각 열에는 값이 4개 이상 필요합니다. 출력은 Pp, PPL, PPU, Ppk, PPM 표와 히스토그램입니다.
최종 검토
핵심 요점
다중 변수 공정능력(비정규)은 데이터가 정규분포를 따르지 않을 때 여러 공정을 하나의 규격에 대해 비교하며, 각 공정에 같은 분포를 적합하고 Pp, Ppk, PPM을 나란히 나열합니다.
목적
다중 변수 공정능력(비정규)은 데이터가 정규분포를 따르지 않을 때 여러 공정, 라인, 기계 또는 캐비티의 공정능력을 하나의 규격에 대해 비교합니다. 각 열에 같은 분포를 따로 적합하고, Pp, PPL, PPU, Ppk와 규격을 벗어날 것으로 예상되는 100만 개당 부품 수(기대값과 관측값)를 하나의 표에 나란히 제시하며 각 열의 히스토그램도 제공합니다. 입자 크기, 평탄도, 런아웃, 불순물처럼 치우친 특성에서 정규분포 기반 Ppk가 꼬리를 잘못 판단하는 경우와 공정의 순위를 매기려는 경우에 사용합니다.
주요 기능
- 둘 이상의 열을 각각 하나의 공정으로 취급하여 독립적으로 적합합니다.
- 15가지 모형: Weibull, Exponential, Logistic, Loglogistic, Largest and Smallest Extreme Value, 2-Parameter Exponential, 3-Parameter Weibull, Gamma, Lognormal, 3-Parameter Lognormal, 3-Parameter LogLogistic, Box-Cox 및 Johnson 변환, Mixed Distribution (ISO 22514-2).
- 지수를 구하는 Z-Score 또는 ISO 백분위수 방법.
- 모든 열에 적용되는 단측 또는 양측 규격.
- Pp, PPL, PPU, Ppk, PPM Expected, PPM Observed를 담은 비교 표와, 규격 한계 및 적합 곡선이 표시된 각 열의 히스토그램.
통계적 방법
각 열에 대해 선택한 분포를 최대우도법으로 적합합니다(Weibull, Gamma, Exponential은 임계값을 0으로 고정하고, 3-모수 모형은 임계값을 추정합니다). Lognormal은 로그 데이터의 평균과 표준편차를 사용합니다. Box-Cox와 Johnson은 데이터를 정규분포로 변환하여 변환된 척도에서 계산하며, Mixed Distribution은 정규분포의 혼합을 적합하고 성분 수는 고정하지 않으면 BIC로 선택합니다. 각 열에는 값이 4개 이상 필요합니다.
Z-Score 방법(기본값): 각 한계 밖의 적합 확률을 정규 점수로 바꿉니다. Z_USL = Φ⁻¹(F(USL)), Z_LSL = Φ⁻¹(F(LSL))이며 F는 적합된 누적분포입니다. 그러면 PPU = Z_USL / 3, PPL = −Z_LSL / 3, Pp = (Z_USL − Z_LSL) / 6, Ppk = min(PPL, PPU)입니다. ISO 방법: 지수는 적합된 백분위수 X₀.₁₃₅, X₅₀, X₉₉.₈₆₅(정규분포의 ±3σ와 같은 비율을 포함하는 점)를 사용합니다. Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅), PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅), PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀). 한계가 하나뿐이면 Pp는 제공되지 않으며 Ppk는 단측 지수입니다.
PPM Expected는 모집단 중 한계를 벗어나는 적합 비율에 1,000,000을 곱한 값이고, PPM Observed는 표본 값 중 한계를 벗어난 비율입니다. 이는 모든 데이터로 구한 전체(장기) 지수입니다. 이 값은 분포가 얼마나 적합한가에 좌우되며, 같은 모형이 모든 열에 적용되므로 열을 비교하기 전에 각 열의 적합도를 확인하십시오(예: Individual Distribution Identification 사용).
입력 항목 및 옵션
항목 | 설명 |
Process variables | 필수 항목입니다. 비교할 수치형 열 2개 이상이며 각각 따로 적합됩니다. |
Fit distribution | 필수 항목입니다. 위에 나열한 15가지 모형 중 하나(기본값 Weibull)이며 모든 열에 적용됩니다. |
Mixture components | Mixed Distribution (ISO 22514-2)에만 해당하며, Auto(BIC로 선택, 기본값) 또는 성분 2~6개입니다. |
Method of analysis | Z-Score(기본값) 또는 ISO. |
LSL / USL | 모든 열에 적용되는 규격 한계입니다. 적어도 하나는 필요하며 LSL은 USL보다 작아야 합니다. |
Company name / Report title | 보고서에 넣는 선택적 텍스트입니다. 기본 제목은 Multiple Variables Process Capability (Nonnormal)입니다. |
Data Options: Subset (optional) | Exclude matching rows(기본값) 또는 Include only matching rows이며 행 번호(예: 3,7,12-15) 및/또는 조건으로 지정합니다. |
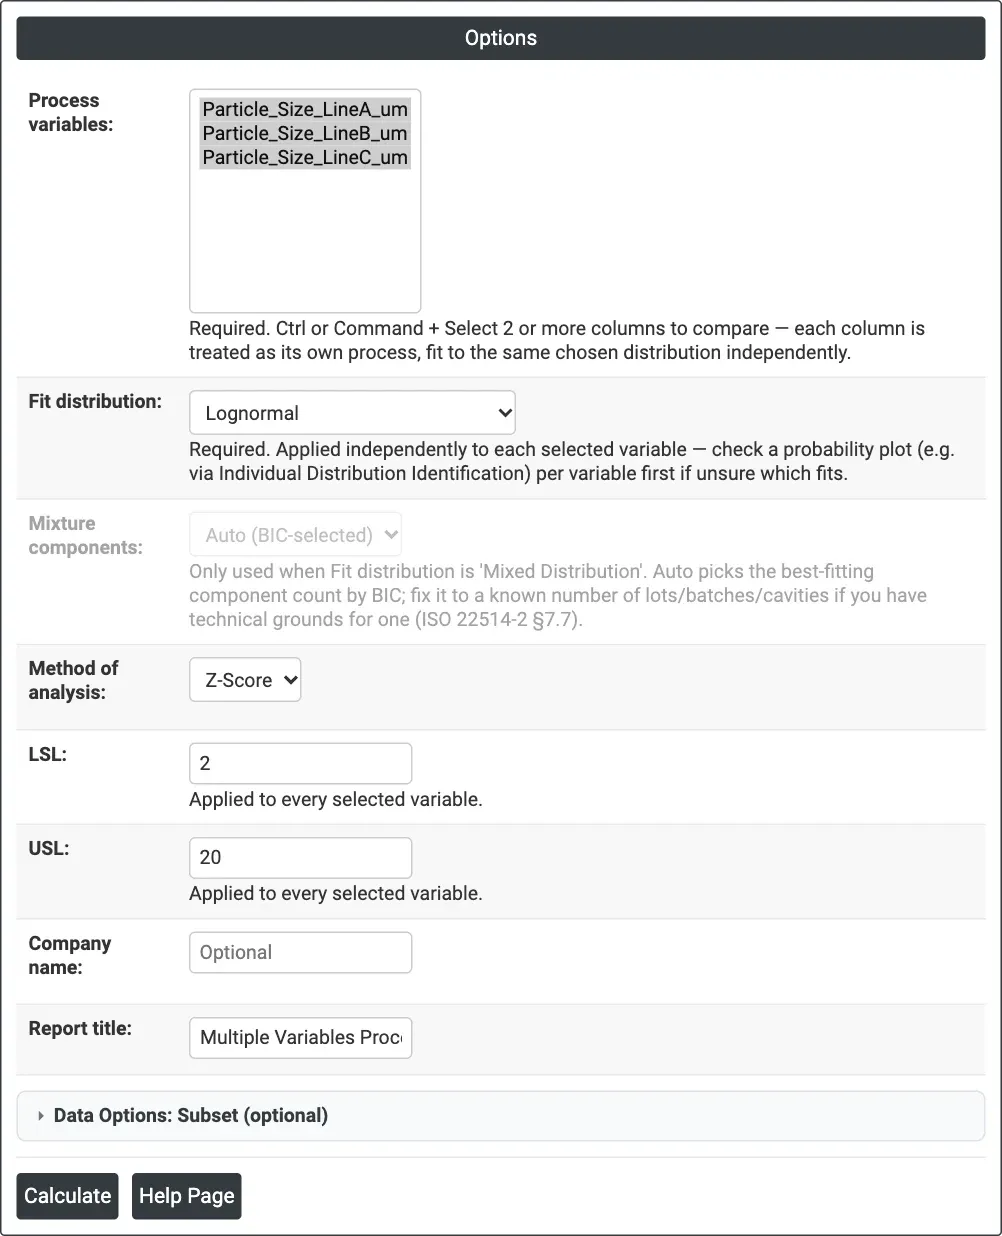
그림 1 — 예제의 옵션: 라인 3개의 입자 크기, Lognormal, Z-Score 방법, LSL 2 µm, USL 20 µm.
출력 설명
- Multiple Variables Process Capability (Nonnormal) — 열당 한 행: Variable, N, Distribution, Pp, PPL, PPU, Ppk, PPM Expected, PPM Observed.
- Histogram of <distribution> Distribution — 열마다 하나씩 열 이름 아래에 표시되며 LSL, USL과 적합된 밀도 곡선이 함께 나타납니다.
- Download를 통한 PDF 내보내기.
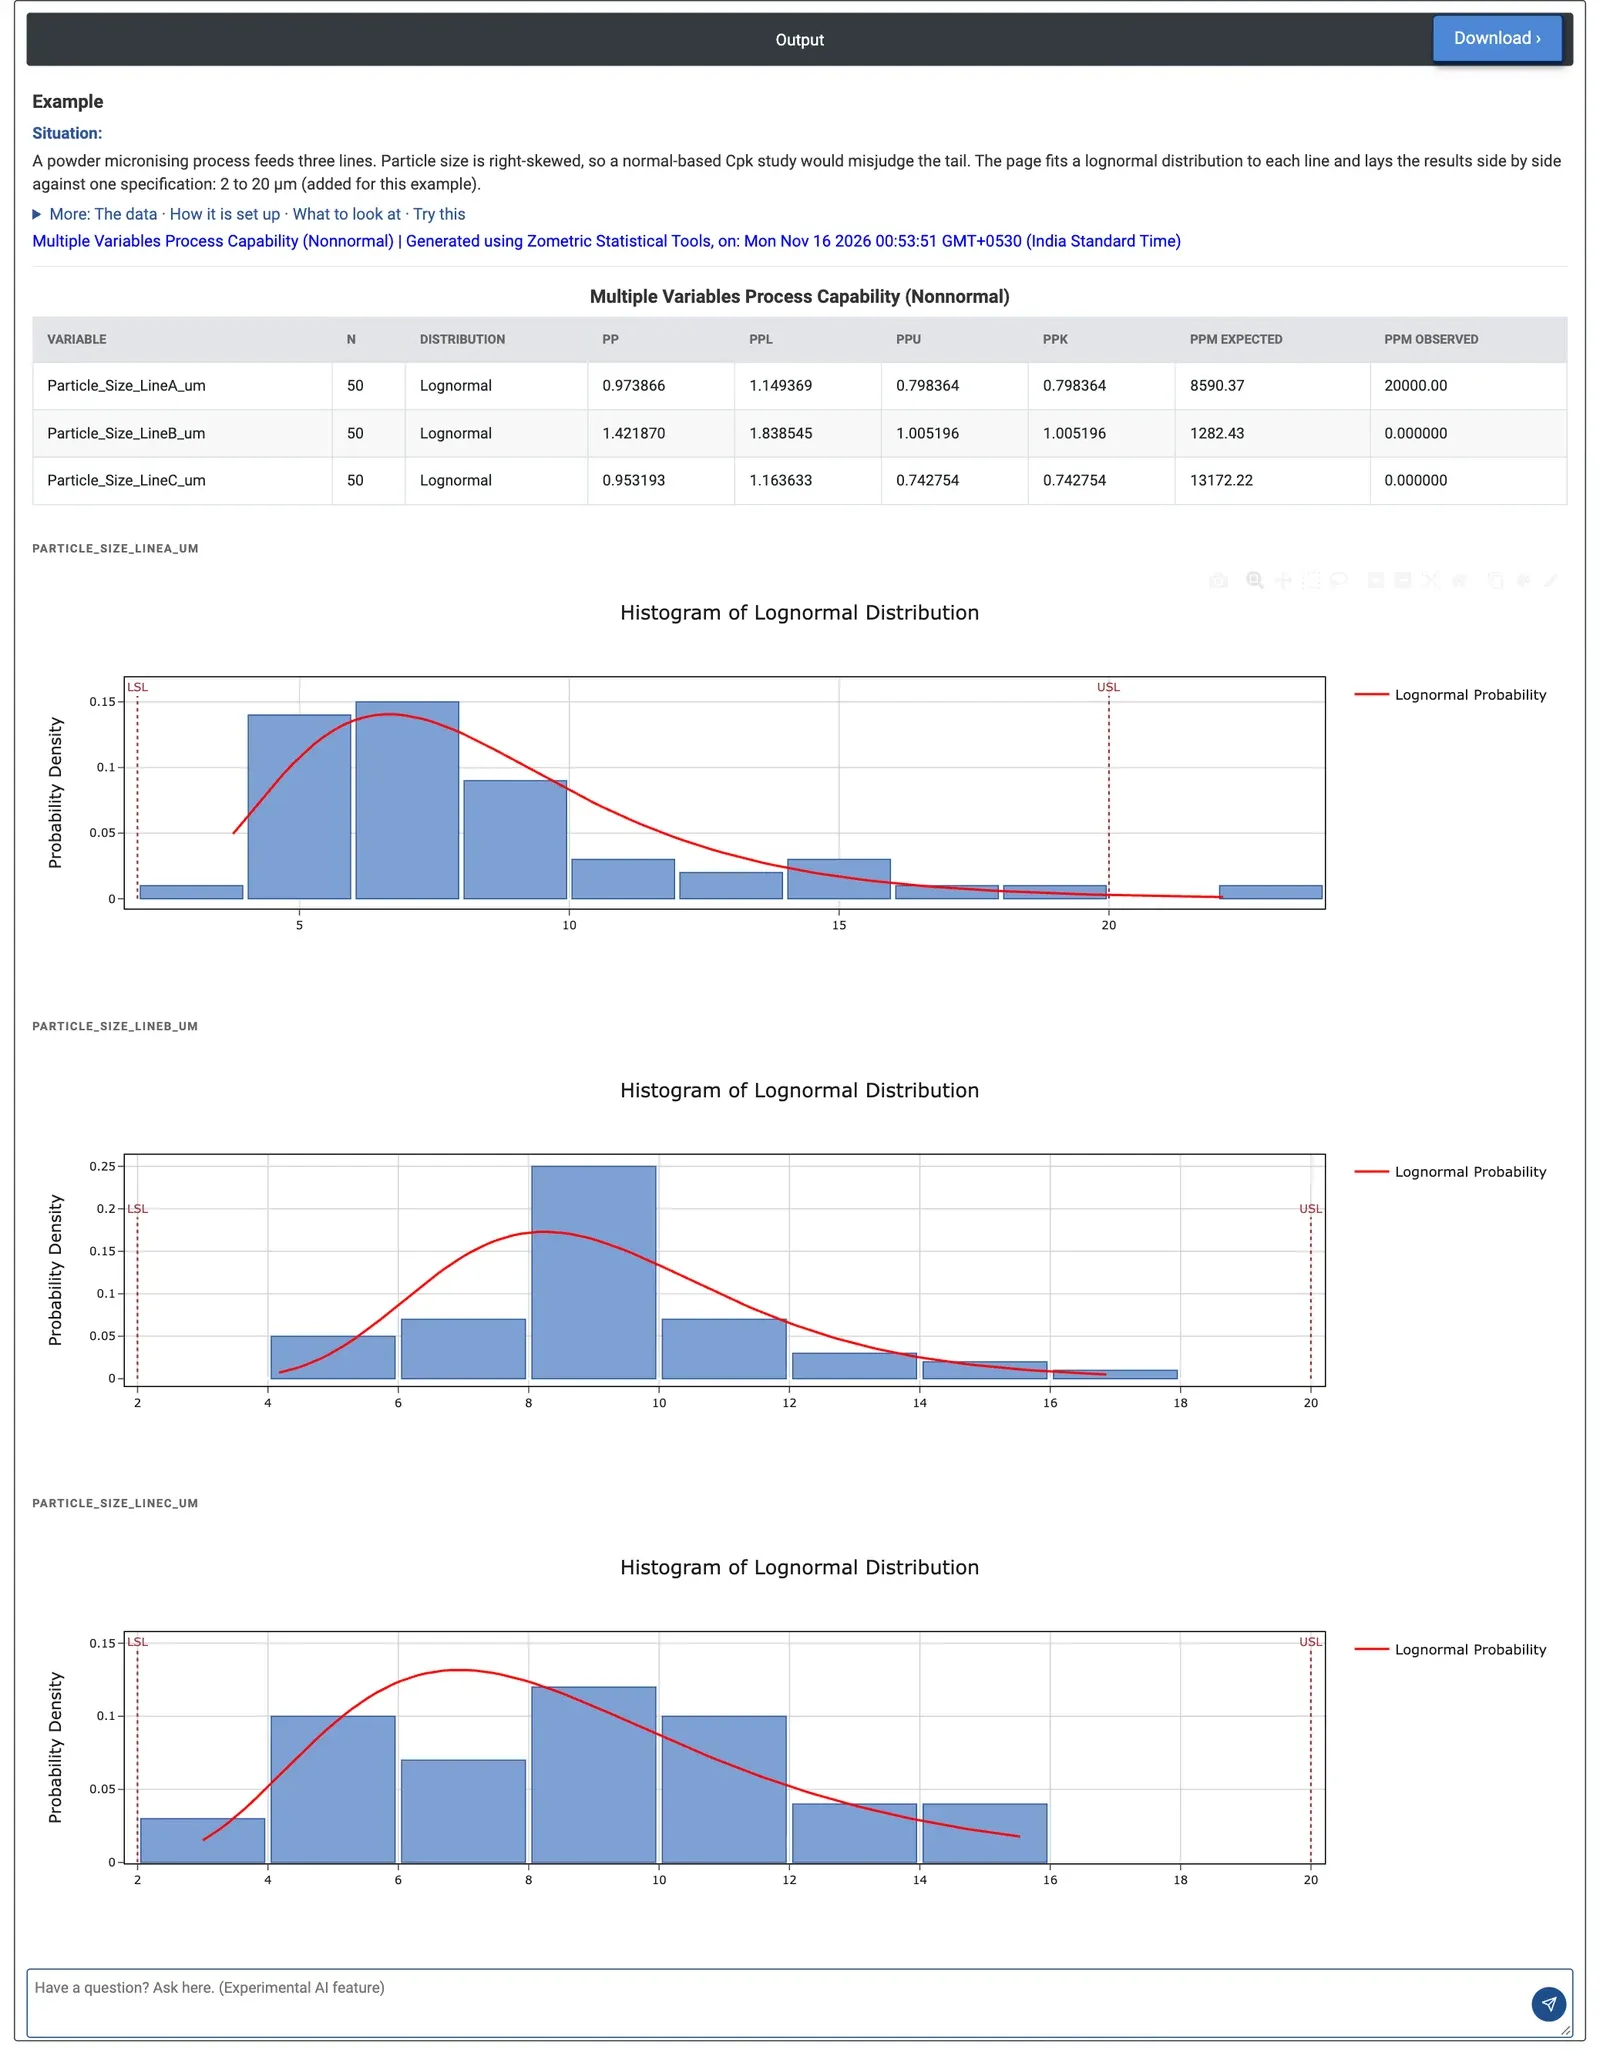
그림 2 — 라인 3개의 비교 표와 로그정규 히스토그램: Ppk는 라인 A 0.798, 라인 B 1.005, 라인 C 0.743이며 모든 라인에서 PPU가 PPL보다 낮고, 라인 A만 USL을 넘는 표본이 있습니다.
계산 예제
분말 미분쇄 공정이 라인 3개에 공급되며 입자 크기는 오른쪽으로 치우쳐 있습니다(중앙값 약 7~9 µm, 거친 입자 쪽으로 긴 꼬리). 공정 엔지니어는 라인별 표본 50개를 사용하여 2~20 µm 규격에 대해 라인을 비교하려고 합니다. Process variables = Particle_Size_LineA_um, Particle_Size_LineB_um, Particle_Size_LineC_um, Fit distribution = Lognormal, Method of analysis = Z-Score, LSL = 2, USL = 20.
라인 A는 Ppk 0.798, 규격 이탈 PPM 기대값 8,590이며, 표본 하나(22.11 µm)가 이미 20 µm를 넘으므로 관측 PPM은 20,000입니다. 라인 B가 가장 좋아 Ppk 1.005, PPM 기대값 1,282이지만 그래도 통상적인 목표 1.33에는 못 미칩니다. 라인 C가 가장 위험하여 Ppk 0.743, PPM 기대값 13,172입니다. 모든 라인에서 PPU가 PPL보다 낮습니다. 위험은 2 µm 미만의 미세 입자가 아니라 20 µm를 넘는 거친 입자이므로, 개선 활동은 라인 C부터 시작하여 거친 쪽 꼬리를 목표로 해야 합니다. 히스토그램도 같은 그림을 보여 줍니다. 각 적합 곡선은 긴 꼬리가 USL 쪽으로 향하며, 라인 A에서는 막대 하나가 USL 너머에 있습니다.
모형이 중요합니다. ISO 방법에서는 Ppk가 0.694, 1.008, 0.619로 떨어지며 순위는 같습니다. Weibull 적합에서는 모든 라인에서 PPL이 더 낮은 지수가 되고 순위가 바뀝니다(Ppk 0.641, 0.948, 0.798이며 이제 라인 A가 최악). 이 페이지와 별도로 계산한 Anderson-Darling 통계량은 라인 A와 B에는 로그정규(0.79 대 2.17, 0.63 대 1.34)를 지지하지만 라인 C에는 Weibull(0.20 대 0.55)을 지지하므로, 순위를 의사결정에 사용하기 전에 라인을 하나씩 확인해야 합니다.
자주 묻는 질문
다중 변수의 비정규 공정능력 분석은 언제 사용합니까?
데이터가 정규분포를 따르지 않을 때 여러 공정, 라인, 기계 또는 캐비티의 공정능력을 하나의 규격에 대해 비교하고 순위를 매기는 데 사용합니다. 입자 크기, 평탄도, 런아웃, 불순물처럼 정규분포 기반 Ppk가 분포의 꼬리를 잘못 판단하는 치우친 특성이 전형적인 예입니다.
Z-Score 방법과 ISO 방법의 차이는 무엇입니까?
Z-Score 방법은 각 한계 밖의 적합 확률을 정규 점수로 변환하고 3으로 나누어 PPU와 PPL을 구합니다. ISO 방법은 정규분포의 ±3 시그마 산포 대신 적합된 0.135, 50, 99.865 백분위수를 사용합니다. 계산 예제에서 보듯 두 방법의 Ppk 값은 다를 수 있지만 순위는 같을 수 있습니다.
비정규 공정능력에서 분포 선택이 중요한 이유는 무엇입니까?
지수는 적합된 분포의 품질에 좌우되며, 같은 모형이 모든 열에 적용됩니다. 계산 예제에서는 Lognormal을 Weibull로 바꾸자 어느 지수가 더 낮은지와 라인의 순위가 바뀌었습니다. 열을 비교하기 전에 예를 들어 Individual Distribution Identification으로 각 열의 적합도를 확인하십시오.
PPM Expected와 PPM Observed의 차이는 무엇입니까?
PPM Expected는 적합된 분포에서 모집단 중 규격 한계를 벗어나는 비율에 1,000,000을 곱한 값입니다. PPM Observed는 실제 표본 값 중 한계를 벗어난 비율입니다. 둘 다 각 열의 모든 데이터로 계산한 전체(장기) 측도입니다.