
명목 로지스틱 회귀(Nominal Logistic Regression)
명목 로지스틱 회귀는 하나 이상의 예측 변수와, 긁힘, 찍힘, 찢어짐처럼 순서가 없는 세 개 이상의 범주를 갖는 범주형 반응 변수 간의 관계를 분석하는 통계 도구입니다. 예측 변수 값에 따라 각 범주가 나타날 확률을 예측합니다.
최종 검토
핵심 요점
명목 로지스틱 회귀는 하나 이상의 예측 변수와, 순서가 없는 세 개 이상의 범주를 갖는 범주형 반응 변수 간의 관계를 분석하는 통계 도구입니다.
이 페이지 내용
명목 로지스틱 회귀란?
명목 로지스틱 회귀는 하나 이상의 예측 변수와 순서가 없는 세 개 이상의 범주를 갖는 범주형 반응 변수 간의 관계를 분석하는 통계 도구이며, 반응 범주의 예로는 긁힘, 찍힘, 찢어짐이 있습니다. 예측 변수 값에 따라 각 범주가 나타날 확률을 예측합니다.
명목 로지스틱 회귀는 언제 사용합니까?
예측 변수
- 예측 변수는 연속형, 범주형 또는 둘의 혼합일 수 있습니다
- 이산 변수는 수준의 수와 분석 목적에 따라 연속형 또는 범주형으로 처리할 수 있습니다
- 연속형 예측 변수가 하나뿐이고 반응이 연속형 → 다음을 사용: 적합선 그림
- 예측 변수가 여러 개이고 반응이 연속형 → 다음을 사용: 회귀 모형 적합
반응 변수
- 반응은 자연스러운 순서가 없는 세 개 이상의 범주 를 가져야 합니다(예: 색상, 재질 유형, 결점 유형)
- 반응이 연속형 인 경우 → 다음을 사용: 회귀 모형 적합
- 반응이 두 개의 범주 (합격/불합격)인 경우 → 다음을 사용: 이항 로지스틱 회귀
- 반응이 순서가 있는 범주 (낮음/중간/높음)인 경우 → 다음을 사용: 순서 로지스틱 회귀
명목 로지스틱 회귀의 올바른 사용 지침
- 반응 변수는 순서가 없는 세 개 이상의 범주를 가져야 합니다. 범주에 자연스러운 순서가 있으면 대신 순서 로지스틱 회귀를 사용하십시오.
- 예측 변수는 연속형 또는 범주형일 수 있으며, 분석을 실행하기 전에 각 변수가 올바르게 분류되었는지 확인하십시오.
- 데이터가 대상 모집단을 정확하게 대표하는지확인하십시오. 치우치거나 불완전한 데이터는 신뢰할 수 없는 예측을 만듭니다.
- 범주마다 충분한 수의 데이터 점 을 수집하십시오. 어느 한 범주라도 관측값이 너무 적으면 모형이 불안정해지고 예측을 신뢰할 수 없습니다.
- 모든 변수를 가능한 한 정확하게측정하십시오. 입력 데이터의 오류는 예측 확률의 정확도를 직접적으로 떨어뜨립니다.
- 결과에 영향을 줄 수 있는 시간 기반 패턴을 식별하는 데 도움이 되도록 데이터를 수집한 순서대로 기록하십시오.
- 적합 후에는 적합도 통계량과 잔차 진단으로 모형을 검증하십시오. 적합이 좋지 않은 모형은 오해를 부르는 범주 예측을 만듭니다.
- 드문 범주는 모형의 신뢰성을 떨어뜨리고 추정 문제를 일으킬 수 있으므로 관측값이 지나치게 적은 범주가 없는지 확인하십시오.
대안: 명목 로지스틱 회귀를 사용하지 않아야 할 때
- 반응 변수가 연속형이면 대신 회귀 모형 적합 을 사용하십시오.
- 반응이 연속형이고 연속형 예측 변수가 하나뿐 이면 대신 적합선 그림 을 사용하십시오.
- 반응이 두 개의 범주 (예: 합격/불합격)이면 대신 이항 로지스틱 회귀 를 사용하십시오.
- 반응 범주에 자연스러운 순서 가 있으면(예: 낮음/중간/높음) 대신 순서 로지스틱 회귀 를 사용하십시오.
- 반응이 연속형이고 범주형 예측 변수가 하나 이면 대신 일원배치 분산분석 을 사용하십시오.
명목 로지스틱 회귀 예제
서로 다른 교수법의 효과를 평가하기 위해 한 학교 관리자가 학생 30명의 데이터를 수집하여 각 학생이 가장 좋아하는 과목과 해당 학급에서 사용한 교수법을 기록합니다. 반응 변수인 선호 과목(수학, 과학, 국어)은 고유한 순서가 없는 범주형이므로, 관리자는 명목 로지스틱 회귀를 적용합니다. 이 분석은 학생의 나이(10세~13세)와 교수법의 유형(시범 또는 설명)이 선호 과목과 어떻게 연관되어 있는지 알아보는 데 도움이 됩니다. 단계는 다음과 같습니다.
- 필요한 데이터를 수집했습니다.
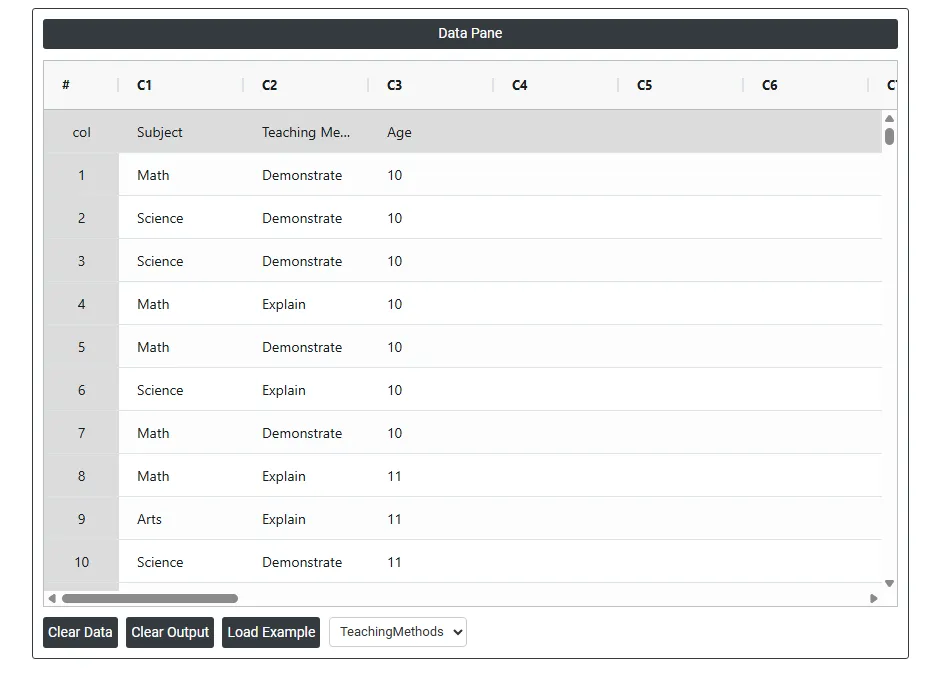
- 이제 Zometric Statistical Software에서 데이터를 분석합니다: https://statsai.zometric.com/.
- 명목 로지스틱 회귀를 찾으려면 다음을 선택합니다: Statistical module> Regression>Nominal Logistic Regression.
- 도구 안에서 데이터와 기타 입력값을 다음과 같이 입력합니다.
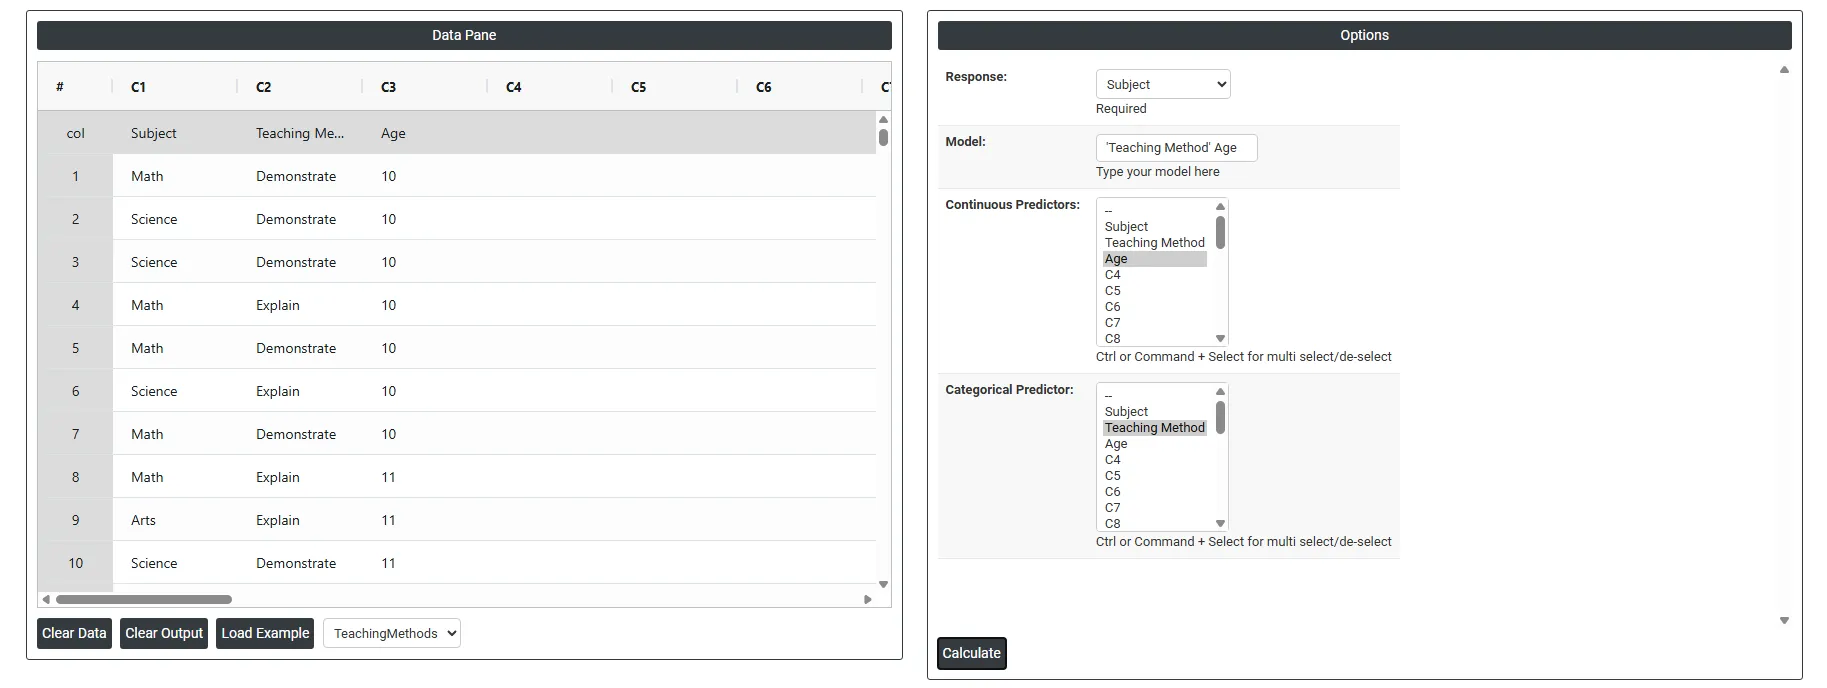
5. 위 도구를 사용하면 다음과 같은 출력을 얻습니다
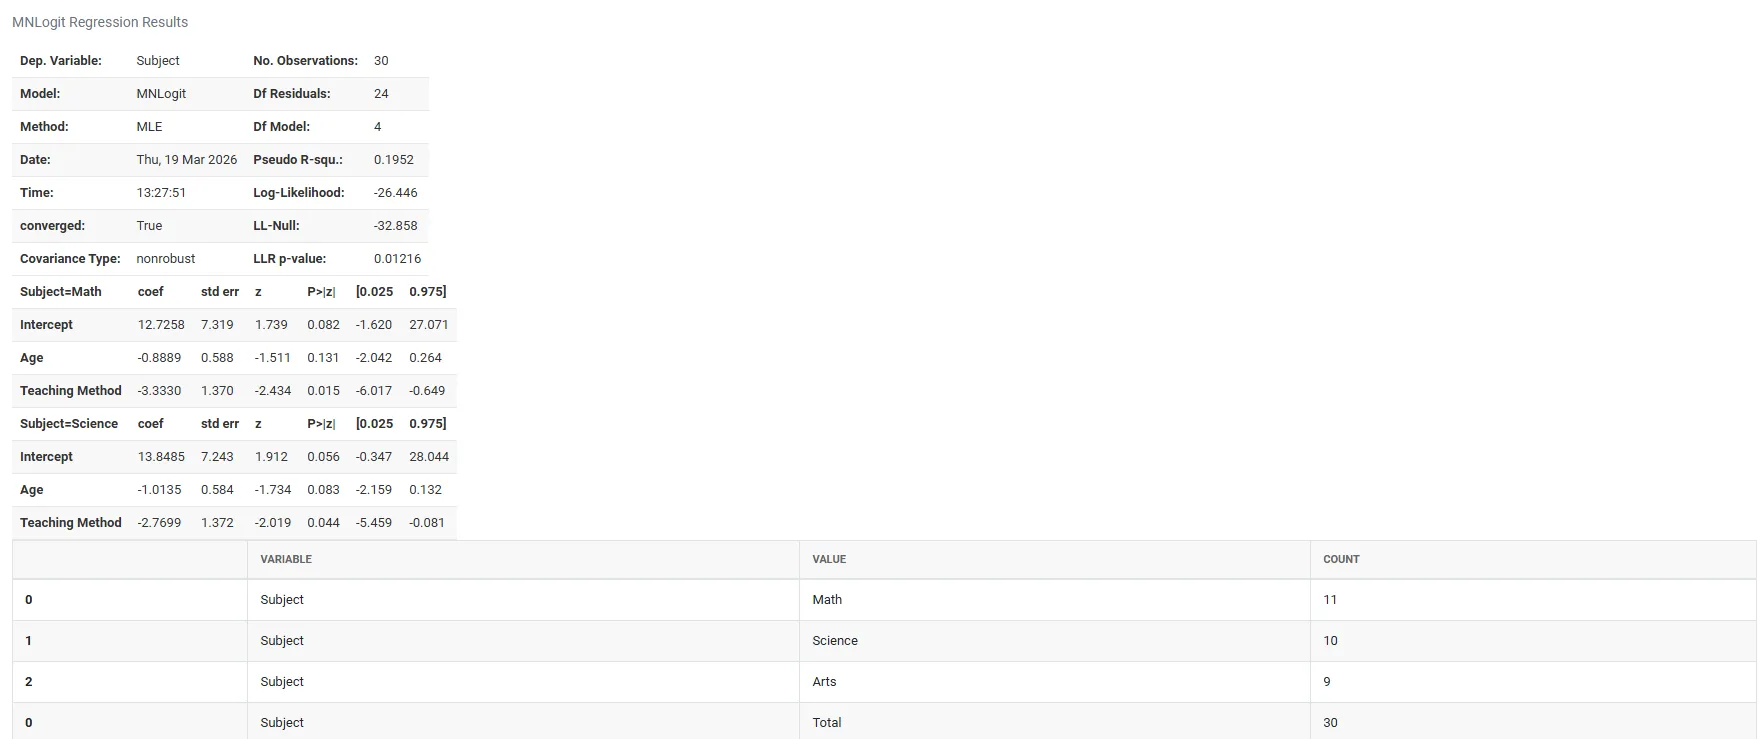
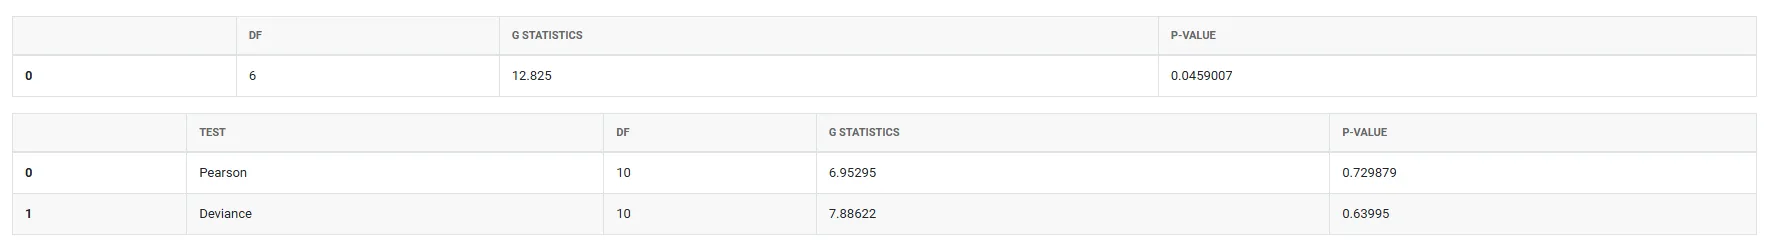
명목 로지스틱 회귀 방법
절차는 다음과 같습니다.
- Zometric Statistical Software에 로그인합니다: https://statsai.zometric.com/
- 홈 페이지에서 Statistical Tool> Regression > Nominal Logistic Regression을 선택합니다.
- 다음으로, 데이터를 직접 입력하거나 Excel 시트에서 데이터 전체를 복사(Ctrl+C)하여 붙여넣습니다(Ctrl+V). 또는 Load Example 옵션을 사용하면 예제 데이터가 로드됩니다.
- 다음으로, 필요한 옵션을 입력합니다.
- 마지막으로, 페이지 하단의 calculate를 클릭하면 원하는 결과를 얻을 수 있습니다.
명목 로지스틱 회귀 도구 화면은 두 부분으로 나뉩니다.
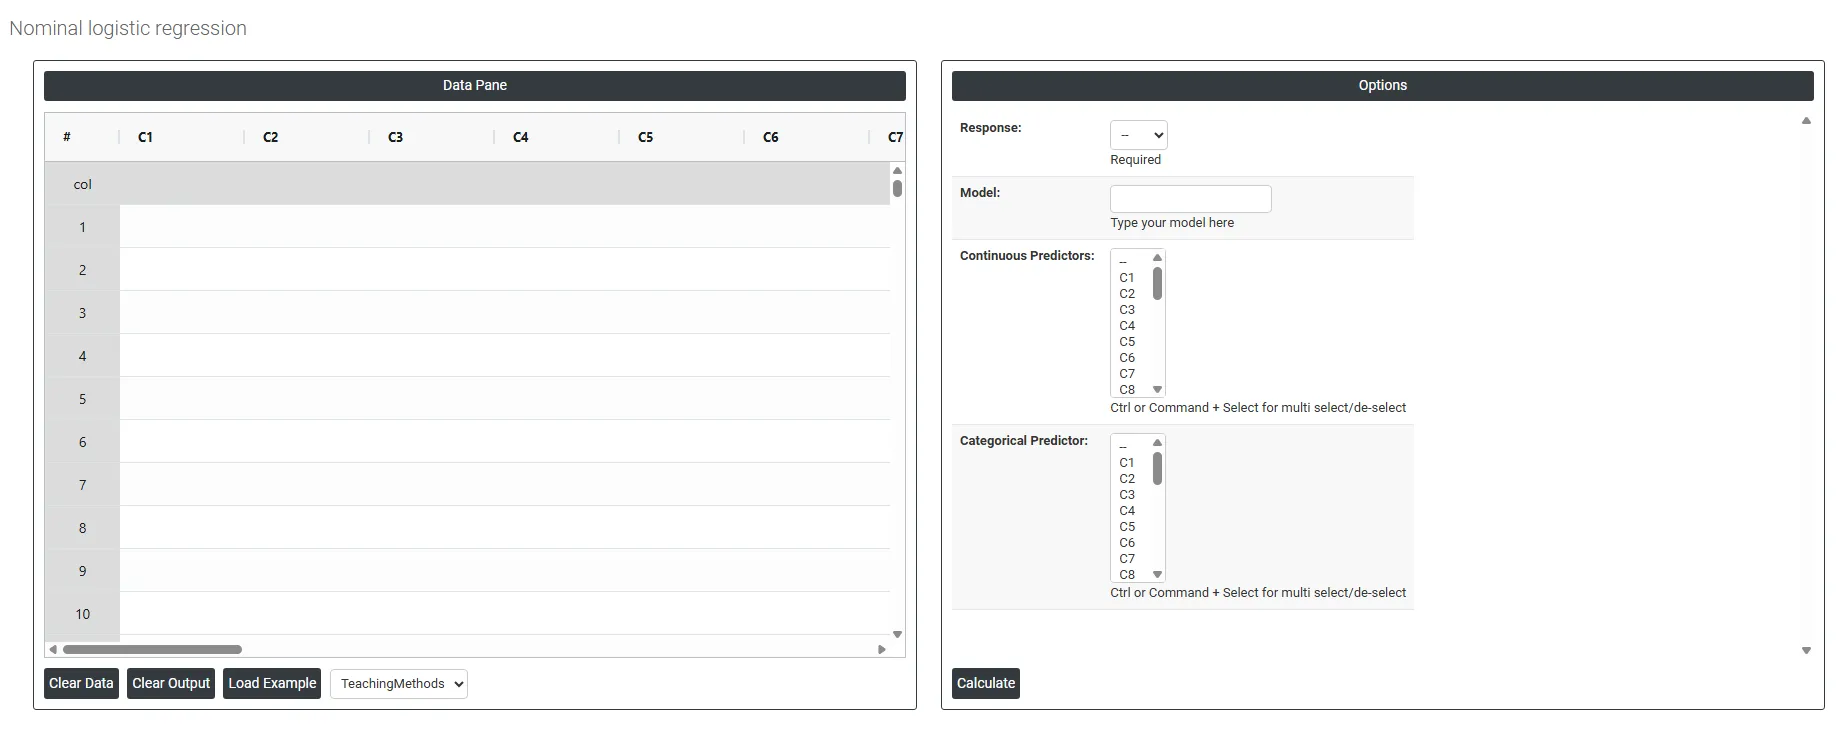
왼쪽 부분에는 데이터 창(Data Pane)이 있습니다. Data Pane에서는 각 행이 하나의 부분군이 됩니다. 데이터를 직접 입력하거나 Excel 시트에서 데이터 전체를 복사(Ctrl+C)하여 여기에 붙여넣을(Ctrl+V) 수 있습니다.
Load example:예제 데이터가 로드됩니다.
Load File: Excel 데이터를 직접 로드하는 데 사용합니다.
오른쪽 부분에는 다음과 같은 여러 옵션이 있습니다.
- Response: 예측하거나 분류하려는 결과 변수로, 자연스러운 순서가 없는 세 개 이상의 범주를 포함해야 합니다. 예를 들어 결점 유형(긁힘, 찍힘, 찢어짐)이나 결제 방법(현금, 카드, 온라인)이 있습니다. 모델은 제공된 예측 변수 값에 따라 각 범주가 나타날 확률을 추정합니다.
- Categorical Predictor: 기계 유형, 교대조, 재료처럼 고정된 개수의 구별되는 집단 또는 레이블을 갖는 예측 변수입니다. 이러한 집단 사이에는 측정 가능한 거리가 없습니다. 각 범주는 별도의 수준으로 처리되며, 모델은 각 집단이 각 반응 범주의 확률에 어떻게 영향을 주는지 추정합니다.
- Continuous Predictor: 온도, 압력, 시간처럼 일정 범위 안에서 측정 가능한 임의의 수치 값을 가질 수 있는 예측 변수입니다. 모델은 이 값들을 사용하여 예측 변수가 한 단위 증가할 때 반응이 각 범주에 속할 확률이 어떻게 이동하는지 추정합니다.
- Model: 분석에 포함할 예측 변수와 교호작용 항을 정의합니다. 기본적으로 선택한 모든 예측 변수를 사용하여 주효과 모형 을 구성합니다. 두 예측 변수가 반응에 함께 영향을 준다고 생각되면 교호작용 항 (예: A*B)을 포함하도록 사용자 지정할 수 있습니다. 올바른 모형 구조를 선택하는 것이 중요합니다. 불필요한 항을 포함하면 잡음이 더해지고, 핵심 항이 빠지면 부정확한 예측으로 이어집니다.
자주 묻는 질문
명목 로지스틱 회귀란 무엇입니까?
명목 로지스틱 회귀는 하나 이상의 예측 변수와, 긁힘, 찍힘, 찢어짐처럼 순서가 없는 세 개 이상의 범주를 갖는 범주형 반응 간의 관계를 분석합니다. 예측 변수 값에 따라 각 반응 범주가 나타날 확률을 예측합니다. 예측 변수는 연속형, 범주형 또는 둘의 혼합일 수 있습니다.
명목 로지스틱 회귀와 순서 로지스틱 회귀의 차이는 무엇입니까?
명목 로지스틱 회귀는 색상, 재질 유형, 결점 유형처럼 자연스러운 순서가 없는 세 개 이상의 범주를 갖는 반응에 사용합니다. 낮음, 중간, 높음처럼 범주에 자연스러운 순서가 있으면 대신 순서 로지스틱 회귀를 사용하십시오. 합격/불합격처럼 두 개의 범주를 갖는 반응에는 이항 로지스틱 회귀를 사용하십시오.
명목 로지스틱 회귀의 요구 사항은 무엇입니까?
반응은 순서가 없는 세 개 이상의 범주를 가져야 하며, 드문 범주는 모형을 불안정하게 하고 추정 문제를 일으킬 수 있으므로 각 범주에 충분한 관측값이 필요합니다. 데이터는 대상 모집단을 대표해야 하고, 정확하게 측정되어야 하며, 수집한 순서대로 기록되어야 합니다. 적합 후에는 적합도 통계량과 잔차 진단으로 모형을 검증하십시오.
Zometric Statistical Software에서 명목 로지스틱 회귀는 어떻게 실행합니까?
Statistical Tool > Regression > Nominal Logistic Regression을 선택하고 데이터를 입력하거나 붙여넣습니다. Response, 필요한 Categorical Predictor 및 Continuous Predictor를 선택하고 Model을 정의합니다. Model의 기본값은 주효과 모형이며 A*B와 같은 교호작용 항을 포함할 수 있습니다. 그런 다음 Calculate를 클릭하면 결과를 얻습니다.