
비선형 회귀(Nonlinear Regression)
비선형 회귀는 모수가 선형으로 들어가지 않는 곡선을 하나의 반응과 하나의 예측변수에 적합시킵니다. 공정의 물리 또는 화학이 곡선의 형태를 결정할 때 사용합니다. 내장 함수 7개 또는 사용자 정의 함수 중에서 선택하고 적절한 초깃값을 제공합니다. 출력에는 표준오차와 신뢰구간이 포함된 모수 추정값, 적합선 그림, 상관 행렬, 적합성 결여 검정이 포함됩니다.
최종 검토
핵심 요점
비선형 회귀는 한계값을 향한 지수적 접근처럼 모수가 비선형으로 들어가는 곡선을 적합시켜, 한계값이나 속도 상수와 같은 모수를 신뢰구간과 함께 추정합니다.
목적
비선형 회귀는 한계값을 향한 지수적 접근, 포화 곡선 또는 S자형 성장 곡선처럼 모수가 선형으로 들어가지 않는 곡선을 하나의 반응과 하나의 예측변수에 적합시킵니다. 공정의 물리 또는 화학이 곡선의 형태를 알려 주고, 한계값이나 속도 상수와 같은 모수의 추정값을 신뢰구간과 함께 얻고자 할 때 사용합니다.
주요 기능
- 내장 기대 함수 7개: 지수 감소, 지수 증가, 거듭제곱, 3-모수 로지스틱, Michaelis-Menten, Gompertz, 이차.
- 모수 b1, b2, …를 가진 X에 대한 사용자 정의 기대 함수이며, + − * / ^ 와 exp, log, ln, log10, sqrt, abs, sin, cos, tan, arctan을 사용할 수 있습니다.
- 사용자가 정한 초깃값, 반복 횟수 한계, 허용 오차를 사용하는 Gauss-Newton, Levenberg-Marquardt 또는 Trust Region Reflective 적합.
- 표준오차와 신뢰구간이 포함된 모수 추정값과 그 상관 행렬.
- 선택적인 신뢰대와 예측대가 포함된 적합선 그림.
- 예측변수에 반복된 값이 있을 때의 적합성 결여 검정.
- 선택적인 가중치 열과 잔차 그림.
통계적 방법
도구는 오차 제곱합 SSE = Σ (yᵢ − f(xᵢ, θ))²(가중치 열이 있으면 Σ wᵢ (yᵢ − f(xᵢ, θ))²)를 최소화하는 모수 값 θ를 찾습니다. Levenberg-Marquardt(기본값)와 Trust Region Reflective는 SciPy의 최소제곱 해법을 사용하고, Gauss-Newton은 스텝을 절반으로 줄이는 방식을 사용하며 반복 횟수를 보고합니다. SSE와 모수의 상대 변화가 수렴 허용 오차 아래로 내려가면 반복을 멈춥니다. 반응, 예측변수 또는 가중치에 값이 없는 행은 제외됩니다.
표준오차는 해에서의 선형 근사로 구합니다: Cov(θ) = MSE·(JᵀJ)⁻¹. 여기서 J는 모수에 대한 f의 도함수 행렬이고, 모수가 p개일 때 MSE = SSE / (n − p)이며 S = √MSE입니다. 신뢰구간은 θ ± t(1−α/2, n−p)·SE입니다. 곡선의 신뢰대는 같은 근사를 사용하며, 예측대는 새로운 측정값 하나에 대해 MSE를 더합니다. 이 구간은 근사값이며 모수가 제대로 결정되지 않으면 신뢰할 수 없게 되는데, 이는 상관 행렬에서 상관이 ±1에 가깝게 나타나는 것으로 확인할 수 있습니다.
일부 예측변수 값이 반복되면 오차 제곱합이 순수 오차(반복 간 산포)와 적합성 결여로 나뉘고, F = MS lack-of-fit / MS pure error로 선택한 곡선이 적합한지 검정합니다. 초깃값이 중요합니다. 내장 함수는 고정된 기본값에서 시작하며(예: Michaelis-Menten은 a = 1, b = 1), 로지스틱과 Gompertz 곡선에서는 c를 X의 중앙값으로 둡니다. 사용자 정의 함수는 모수마다 초깃값 하나가 필요합니다. 예상하는 값에 가까운 값을 제공하지 않으면 적합이 실패하거나 좋지 않은 국소 최솟값을 찾을 수 있습니다.
입력 항목 및 옵션
항목 | 설명 |
Response (Y) / Predictor (X) | 수치 열이며 서로 달라야 합니다. 필수 항목입니다. |
Expectation function | Exponential decay y = a·exp(−b·x)(기본값), Exponential growth, Power y = a·x^b, Logistic (3-param), Michaelis-Menten y = a·x/(b + x), Gompertz, Quadratic 또는 User-defined expectation function. |
Expectation function (user-defined) | 사용자 정의 선택 시 표시됩니다. 모수 b1, b2, …를 가진 X에 대한 수식입니다. 예: b1 * exp(-b2 * X). |
Weights (optional) | 가중 최소제곱을 위한 가중치 열입니다. |
Starting values (space-separated) | 모수마다 순서대로 하나씩의 값입니다. 내장 함수에서는 선택 사항이며(비워 두면 기본값 사용), 사용자 정의 함수에서는 필수입니다. |
Confidence level | 기본값은 95입니다. |
Fitting algorithm | Gauss-Newton, Levenberg-Marquardt(기본값) 또는 Trust Region Reflective. |
Maximum number of iterations / Convergence tolerance | 기본값은 200과 1e-05입니다. |
Display confidence interval on fitted curve / Display prediction interval on fitted curve | 적합선 그림에 신뢰대와 예측대를 추가합니다. 기본적으로 해제되어 있습니다. |
Histogram of residuals / Normal plot of residuals / Residuals versus fits / Residuals versus order / Four in one | 잔차 그림이며, Four in one은 네 가지를 함께 그립니다. |
Residuals versus the variables | 잔차를 선택한 열에 대해 그립니다. |
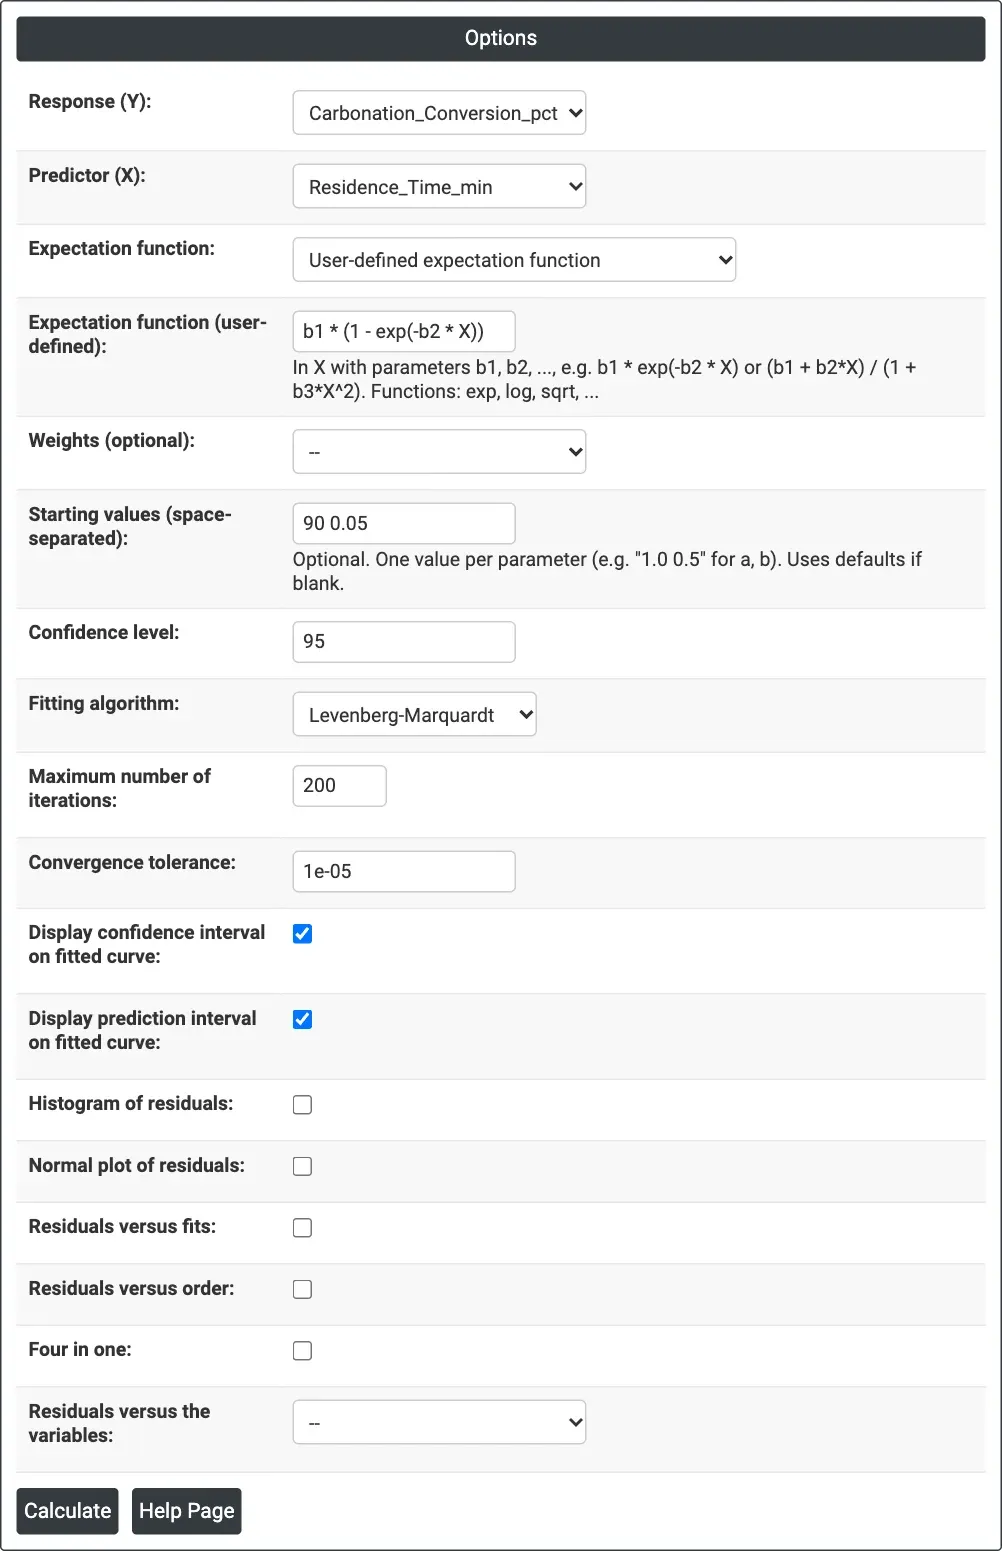
그림 1 — 탄산화 예제의 옵션: 사용자 정의 함수 b1 * (1 - exp(-b2 * X)), 초깃값 90과 0.05, 신뢰대와 예측대 선택.
출력 설명
- Method — 알고리즘, 최대 반복 횟수, 허용 오차, 그리고 Gauss-Newton의 경우 사용된 반복 횟수.
- Starting Values for Parameters — 적합이 시작된 값.
- Regression Equation — 열 이름이 포함된 적합 곡선.
- Parameter Estimates — 각 모수의 Estimate, SE Estimate, 신뢰 한계.
- Summary of Fit — Final SSE, DFE, MSE, S 값.
- Fitted Line Plot — 데이터, 적합 곡선, 선택적인 CI 및 PI 대.
- Correlation Matrix for Parameter Estimates — 모수 추정값의 상관 행렬.
- Lack-of-Fit — 예측변수에 반복된 값이 있을 때 F와 P가 포함된 오차, 적합성 결여, 순수 오차 행.
- 선택한 경우 잔차 그림.
- Download를 통한 PDF 내보내기.
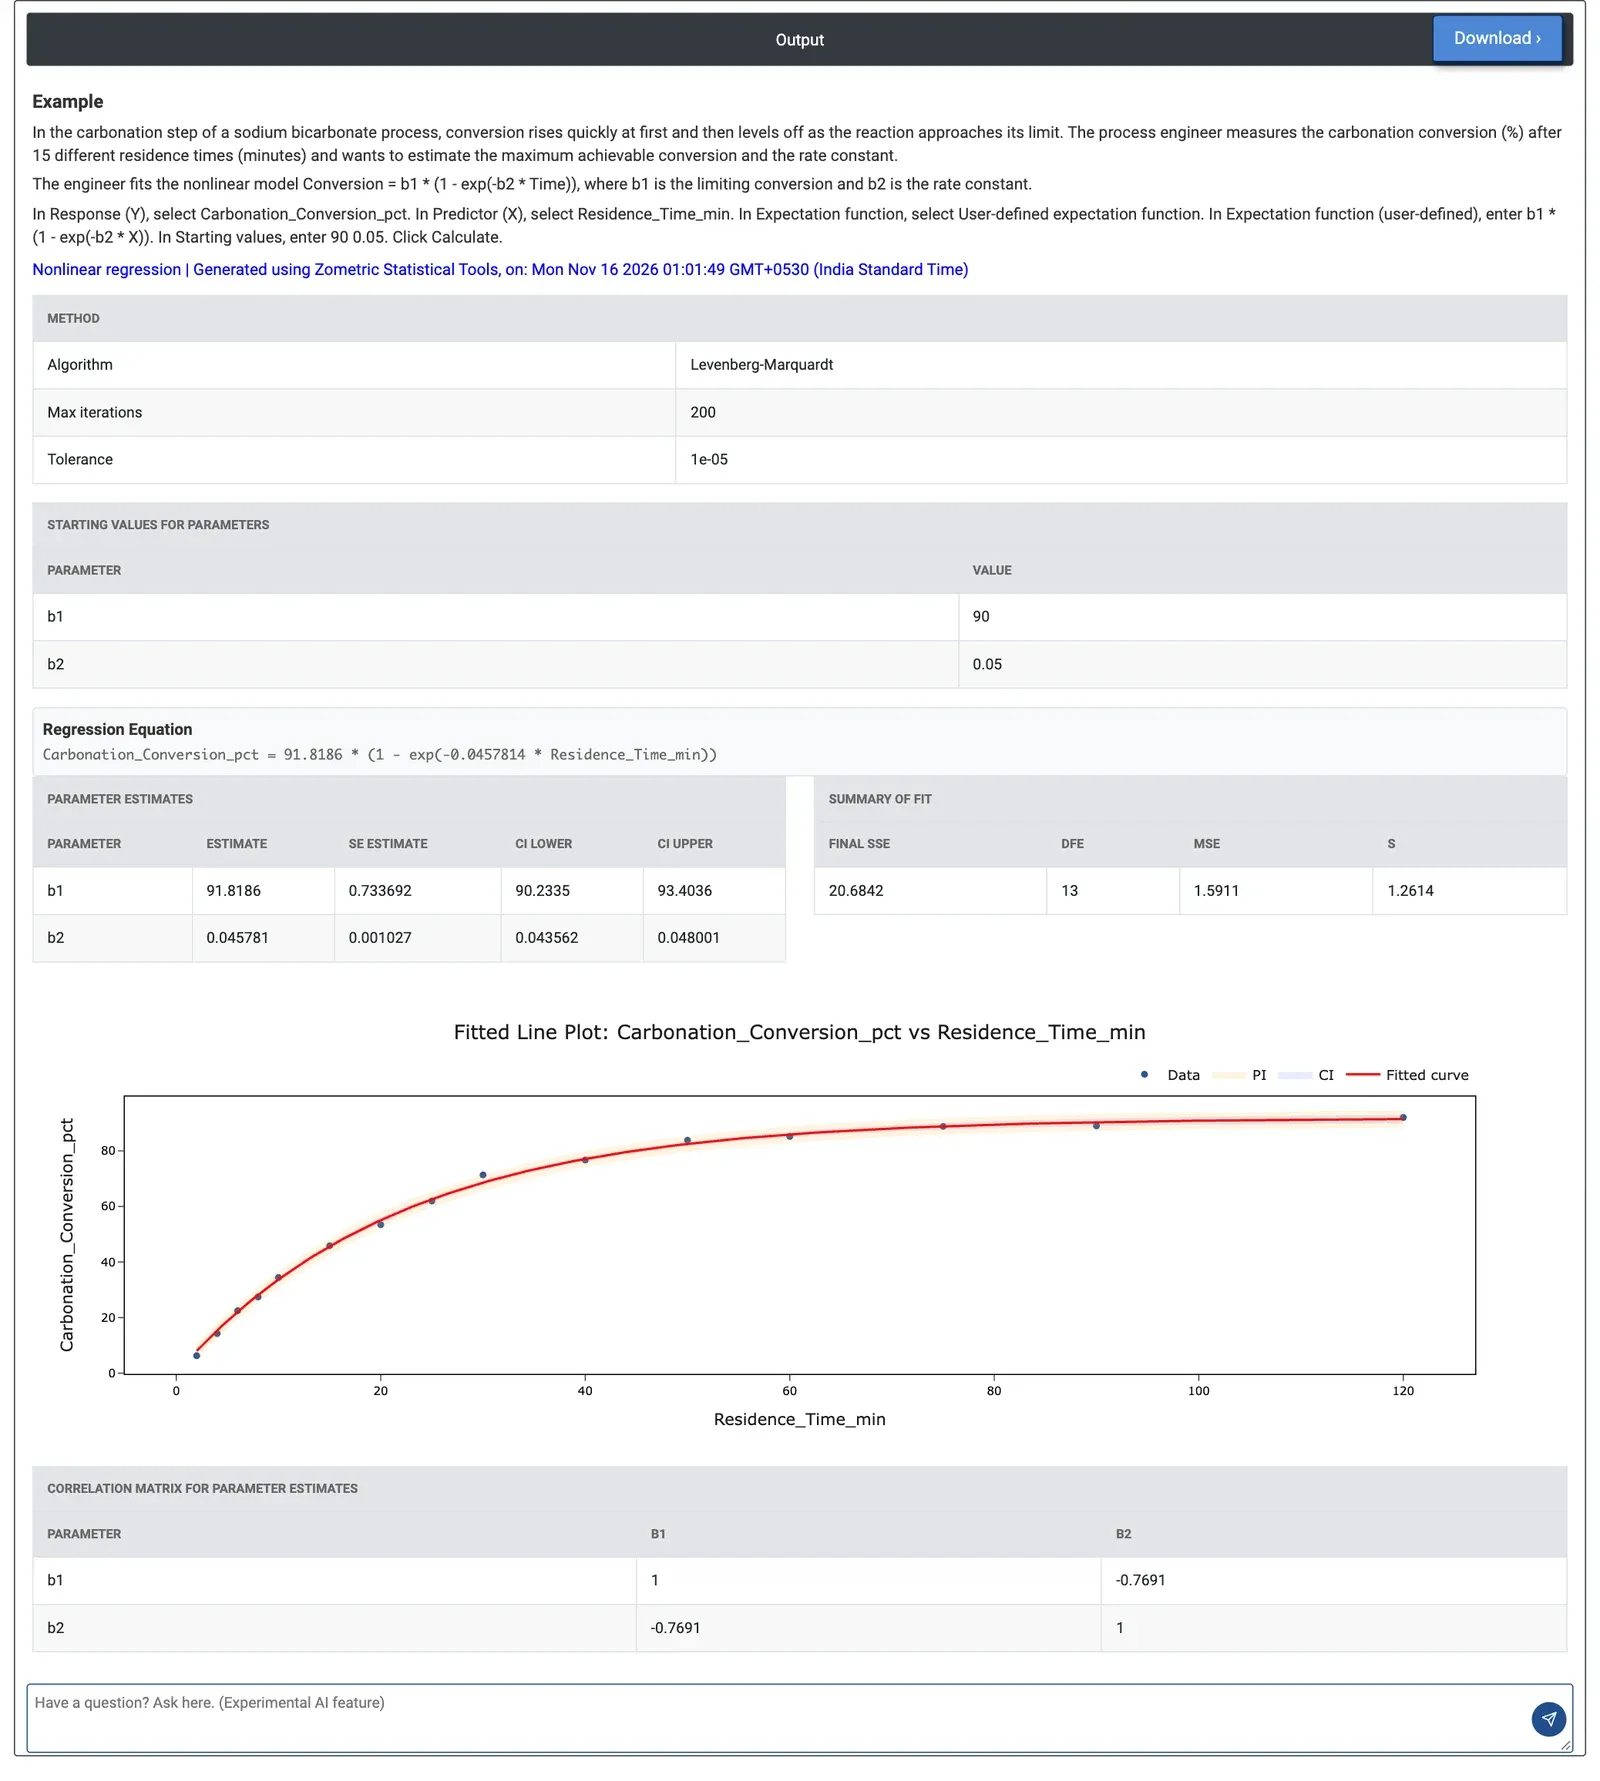
그림 2 — 체류 시간에 대한 탄산화 전환율: 한계 전환율 b1 = 91.82%, 속도 상수 b2 = 분당 0.0458, S = 1.26.
계산 예제
탄산수소나트륨 공정의 탄산화 단계에서 전환율은 빠르게 상승하다가 일정해집니다. 한 공정 엔지니어가 2분에서 120분까지 15개의 체류 시간에서 전환율(%)을 측정하고 한계 전환율과 속도 상수를 구하려고 합니다. 엔지니어는 1차 모형 Conversion = b1·(1 − exp(−b2·Time))을 사용자 정의 함수로 입력하고, 초깃값 90과 0.05를 지정하며, 신뢰대와 예측대를 모두 선택합니다.
적합은 b1 = 91.82%(95% 신뢰구간 90.23~93.40), b2 = 분당 0.0458(95% 신뢰구간 0.0436~0.0480)로 수렴합니다. S는 1.26 퍼센트포인트로 6~92% 범위에 비해 작으며, 점들은 곡선 전체 길이에 걸쳐 곡선 위에 놓여 있습니다. b1과 b2 사이의 상관은 −0.77로 중간 수준이므로 두 모수 모두 잘 결정됩니다. Gauss-Newton은 3번의 반복으로 같은 추정값을 줍니다. 반복된 체류 시간이 없으므로 적합성 결여 검정은 표시되지 않습니다.
적합 곡선에서 한계 전환율의 90%는 ln(10)/b2 ≈ 50분에, 95%는 약 65분에 도달하며, 30분에서는 전환율이 약 69%에 불과합니다. 체류 시간을 한 시간보다 훨씬 길게 해도 추가 전환율은 거의 늘지 않으므로, 엔지니어가 탑 처리량을 정하는 데 도움이 됩니다.
자주 묻는 질문
비선형 회귀란 무엇입니까?
비선형 회귀는 한계값을 향한 지수적 접근, 포화 곡선 또는 S자형 성장 곡선처럼 모수가 선형으로 들어가지 않는 곡선을 하나의 반응과 하나의 예측변수에 적합시킵니다. 오차 제곱합을 최소화하는 모수 값을 찾아 표준오차와 신뢰구간과 함께 보고합니다.
비선형 회귀는 언제 사용해야 합니까?
공정의 물리 또는 화학이 곡선의 형태를 알려 주고, 한계값이나 속도 상수와 같은 모수의 추정값을 얻고자 할 때 비선형 회귀를 사용합니다. 내장 형태에는 지수 감소 및 증가, 거듭제곱, 3-모수 로지스틱, Michaelis-Menten, Gompertz, 이차가 있으며, 직접 함수를 정의할 수도 있습니다.
비선형 회귀에서 초깃값이 중요한 이유는 무엇입니까?
적합은 반복적으로 이루어지므로 초깃값에서 시작합니다. 내장 함수는 고정된 기본값을 사용하고, 사용자 정의 함수는 모수마다 초깃값 하나가 필요합니다. 예상하는 값에 가까운 값을 사용하면 적합이 수렴하는 데 도움이 되며, 초깃값이 좋지 않으면 적합이 실패하거나 좋지 않은 국소 최솟값에 머물 수 있습니다.
비선형 회귀 적합이 신뢰할 만한지 어떻게 알 수 있습니까?
S와 점들이 곡선을 얼마나 가깝게 따르는지를 확인하고 잔차 그림을 검토하십시오. 신뢰구간은 근사값이며 모수가 제대로 결정되지 않으면 신뢰할 수 없게 되는데, 이는 모수 상관 행렬에서 상관이 ±1에 가깝게 나타나는 것으로 확인할 수 있습니다. 예측변수 값이 반복되면 적합성 결여 F 검정으로 선택한 곡선이 적합한지 확인합니다.