
1-표본 동등성 검정(1-Sample Equivalence Test)
1-표본 동등성 검정은 라벨 표시량의 ±5% 이내 역가처럼, 사전에 정한 한계 안에서 평균이 목표값에 충분히 가까운지 확인합니다. 두 개의 단측 t 검정을 수행하며, 두 p-값이 모두 alpha보다 작으면 동등하다고 판정합니다. 데이터는 독립이며 대략 정규분포를 따른다고 가정합니다. 출력에는 기술 통계량, 동등성 신뢰구간, 검정 표, 동등성 그림이 포함됩니다.
최종 검토
핵심 요점
1-표본 동등성 검정은 두 개의 단측 t 검정(TOST)으로 표본 평균이 목표값의 사전 설정 한계 안에 있는지 보여 주며, 차이가 문제가 되지 않을 만큼 작다는 긍정적 증거를 제공합니다.
목적
1-표본 동등성 검정은 표본 평균이 사전에 정한 한계 안에서 목표값에 충분히 가까운지 보여 줍니다. 1-표본 t 검정은 평균이 목표값과 다른지만 말해 줄 수 있으며, 유의하지 않은 t 검정이 목표값에 맞는다는 것을 증명하지는 않습니다. 동등성 검정은 질문을 뒤집습니다. 귀무가설은 평균이 한계 밖에 있다는 것이므로, 유의한 결과는 차이가 문제가 되지 않을 만큼 작다는 긍정적 증거입니다. 배치의 평균 역가가 라벨 표시량의 ±5% 이내인지, 또는 공정 평균이 공칭값 주위의 합의된 범위 안에 있는지와 같은 질문에 사용합니다.
주요 기능
- 동등성 신뢰구간과 함께, 하한 < 시험 평균 − 목표값 < 상한을 검정하는 두 개의 단측 검정(TOST).
- 단측 대립가설: 차이가 하한보다 크다, 차이가 상한보다 작다, 또는 시험 평균이 목표값보다 크거나 작다.
- 한계를 데이터 단위로, 또는 목표값의 비율(Multiply by target)로 지정합니다.
- 한계의 중간점을 포함하는 구간과 일반적인 100(1 − 2α)% 구간 중에서 선택합니다.
- 구간 표와 검정 표 아래에 쉬운 말로 된 결론을 제공합니다.
- 동등성 그림, 히스토그램, 상자 그림(특이치 목록 포함), 개별 값 그림.
통계적 방법
도구는 n개 값으로부터 평균 x̄, 표준편차 s, 표준오차 SE = s / √n을 계산합니다. 차이는 D = x̄ − target입니다. 기본 대립가설에 대해 자유도 n − 1의 두 단측 t 검정을 수행합니다. t₁ = (D − lower limit) / SE는 귀무가설 D ≤ lower limit를 검정하고(p-값은 상측 꼬리에서), t₂ = (D − upper limit) / SE는 D ≥ upper limit를 검정합니다(p-값은 하측 꼬리에서). 두 p-값이 모두 α보다 작으면 동등하다고 판정하며, 이는 둘 중 큰 값이 α보다 작은 것과 같습니다.
동등성 신뢰구간은 D ± t(1 − α; n − 1)·SE에서 시작하여, 필요하면 두 한계의 중간점(대칭 한계인 경우 0)을 포함하도록 확장합니다. 신뢰수준은 Minitab과 같이 100(1 − α)%입니다. 이 구간이 동등성 구간 안에 있으면 동등하다고 판정합니다. Use 100(1 − 2α)% CI를 선택하면 대신 일반 구간 D ± t(1 − α; n − 1)·SE가 100(1 − 2α)% 구간으로 표시됩니다. 단측 대립가설은 t 검정 하나와 단측 신뢰 한계를 사용합니다. 시험 평균 − 목표값 > 하한, 시험 평균 − 목표값 < 상한이며, Test mean > target과 Test mean < target의 경우 한계는 0입니다(우월성 또는 열등성 검정). Multiply by target을 선택하면 입력한 한계에 목표값이 곱해지므로 0.05는 목표값의 5%를 의미합니다.
이 검정은 대략 정규분포를 따르는 모집단에서 추출한 독립된 값을 가정하며, 값이 20개 이상이면 적당한 왜도는 거의 영향을 주지 않습니다. 한계는 데이터를 보기 전에 공학적 또는 규제상의 필요에 따라 선택하십시오. 동등성은 평균에 관한 것이며, 모든 단위가 한계 안에 있다는 뜻은 아닙니다.
입력 항목 및 옵션
항목 | 설명 |
Sample | 필수. 측정값이 들어 있는 숫자형 열이며, 빈 셀은 무시합니다. |
Target | 표본 평균과 비교하는 값으로, 예를 들어 공칭값이나 라벨 표시량입니다. 기본값 0. |
Alpha | 유의수준이며 기본값은 0.05입니다. |
Alternative hypothesis | 하한 < 시험 평균 − 목표값 < 상한(기본값, 동등성), 시험 평균 − 목표값 > 하한, 시험 평균 − 목표값 < 상한, Test mean > target, 또는 Test mean < target. |
Lower Limit / Upper Limit | 필수. 시험 평균 − 목표값에 대한 동등성 한계이며, 하한은 상한보다 작아야 합니다. |
Boxplot of Sample / Histogram of Sample / Equivalence plot / Individual value plot | 그릴 그래프입니다. 기본값으로는 Equivalence plot만 선택되어 있습니다. 상자 그림은 1.5 × IQR을 벗어난 특이치 목록도 추가합니다. |
Multiply by target | 기본값은 꺼짐입니다. 한계가 목표값의 비율이 되며, 예를 들어 ±5%는 −0.05와 0.05입니다. |
Use 100(1 − 2α)% CI | 기본값은 꺼짐입니다. 한계의 중간점을 포함하는 구간 대신 일반 100(1 − 2α)% 구간을 표시합니다. |
Data Options: Subset (optional) | 행 번호(예: 3,7,12-15) 및/또는 조건으로 일치하는 행을 제외(Exclude matching rows, 기본값)하거나 일치하는 행만 포함(Include only matching rows)합니다. |
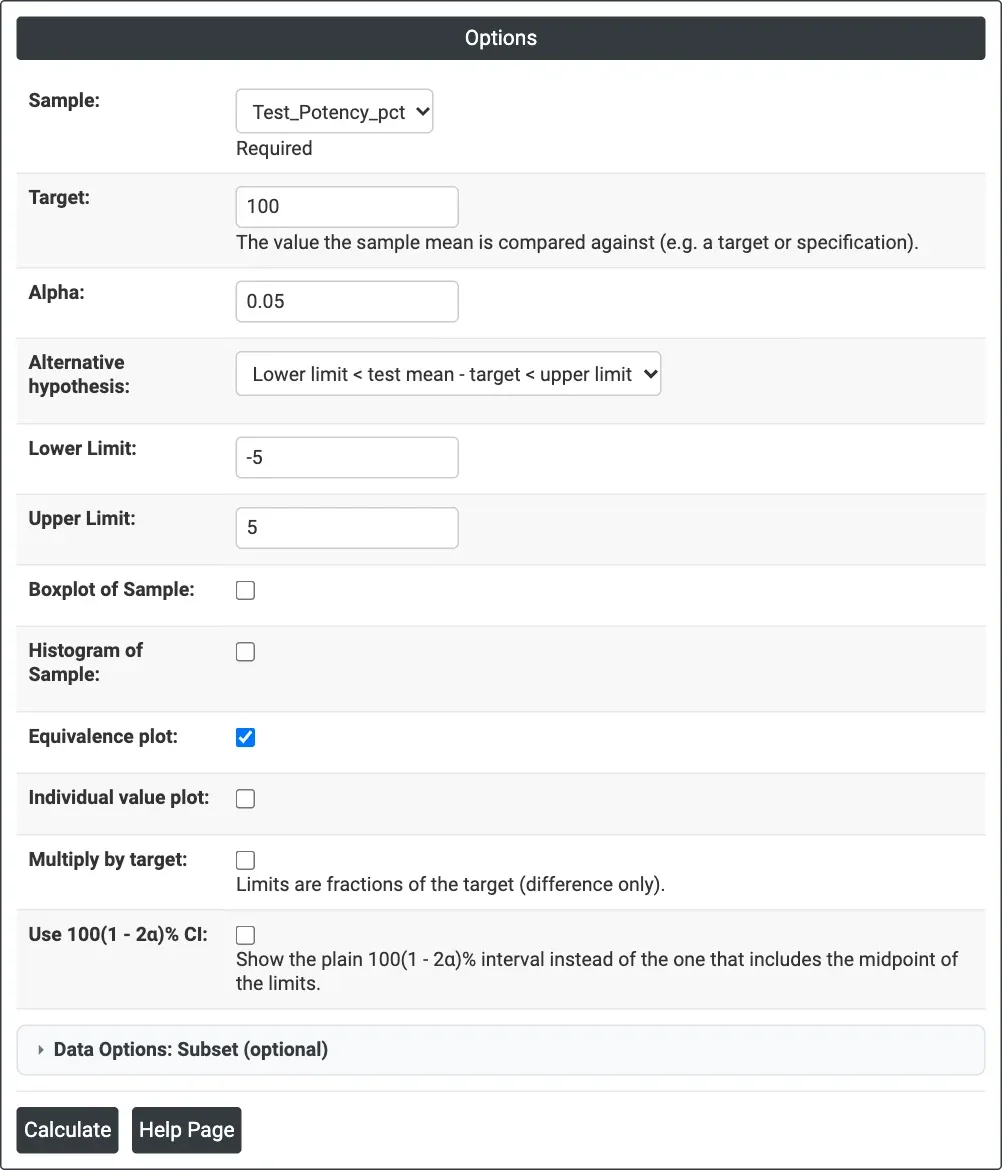
그림 1 — 예제의 옵션: 목표값 100에 대한 Test_Potency_pct, 동등성 한계 −5와 5.
출력 설명
- Method — 검정하는 차이: Sample mean − Reference value (target).
- Descriptive statistics — N, Mean, StDev, SE Mean 값.
- Difference table — Difference, StDev, SE, 95% CI for Equivalence, Equivalence Interval이며, CI가 동등성 구간 안에 있는지 알려 주는 주석이 함께 표시됩니다.
- Hypotheses — 귀무가설과 대립가설, 유의수준.
- Test table — 각 단측 검정의 DF, T-Value, P-Value이며, 더 큰 p-값과 동등성을 판정할 수 있는지 알려 주는 주석이 함께 표시됩니다.
- Equivalence Test: Mean − <target> — 하한(LEL)과 상한(UEL) 동등성 한계에 대한 신뢰구간.
- 선택한 경우 Histogram of Sample, Boxplot of Sample, Individual Value Plot of Sample.
- Download를 통한 PDF 내보내기.
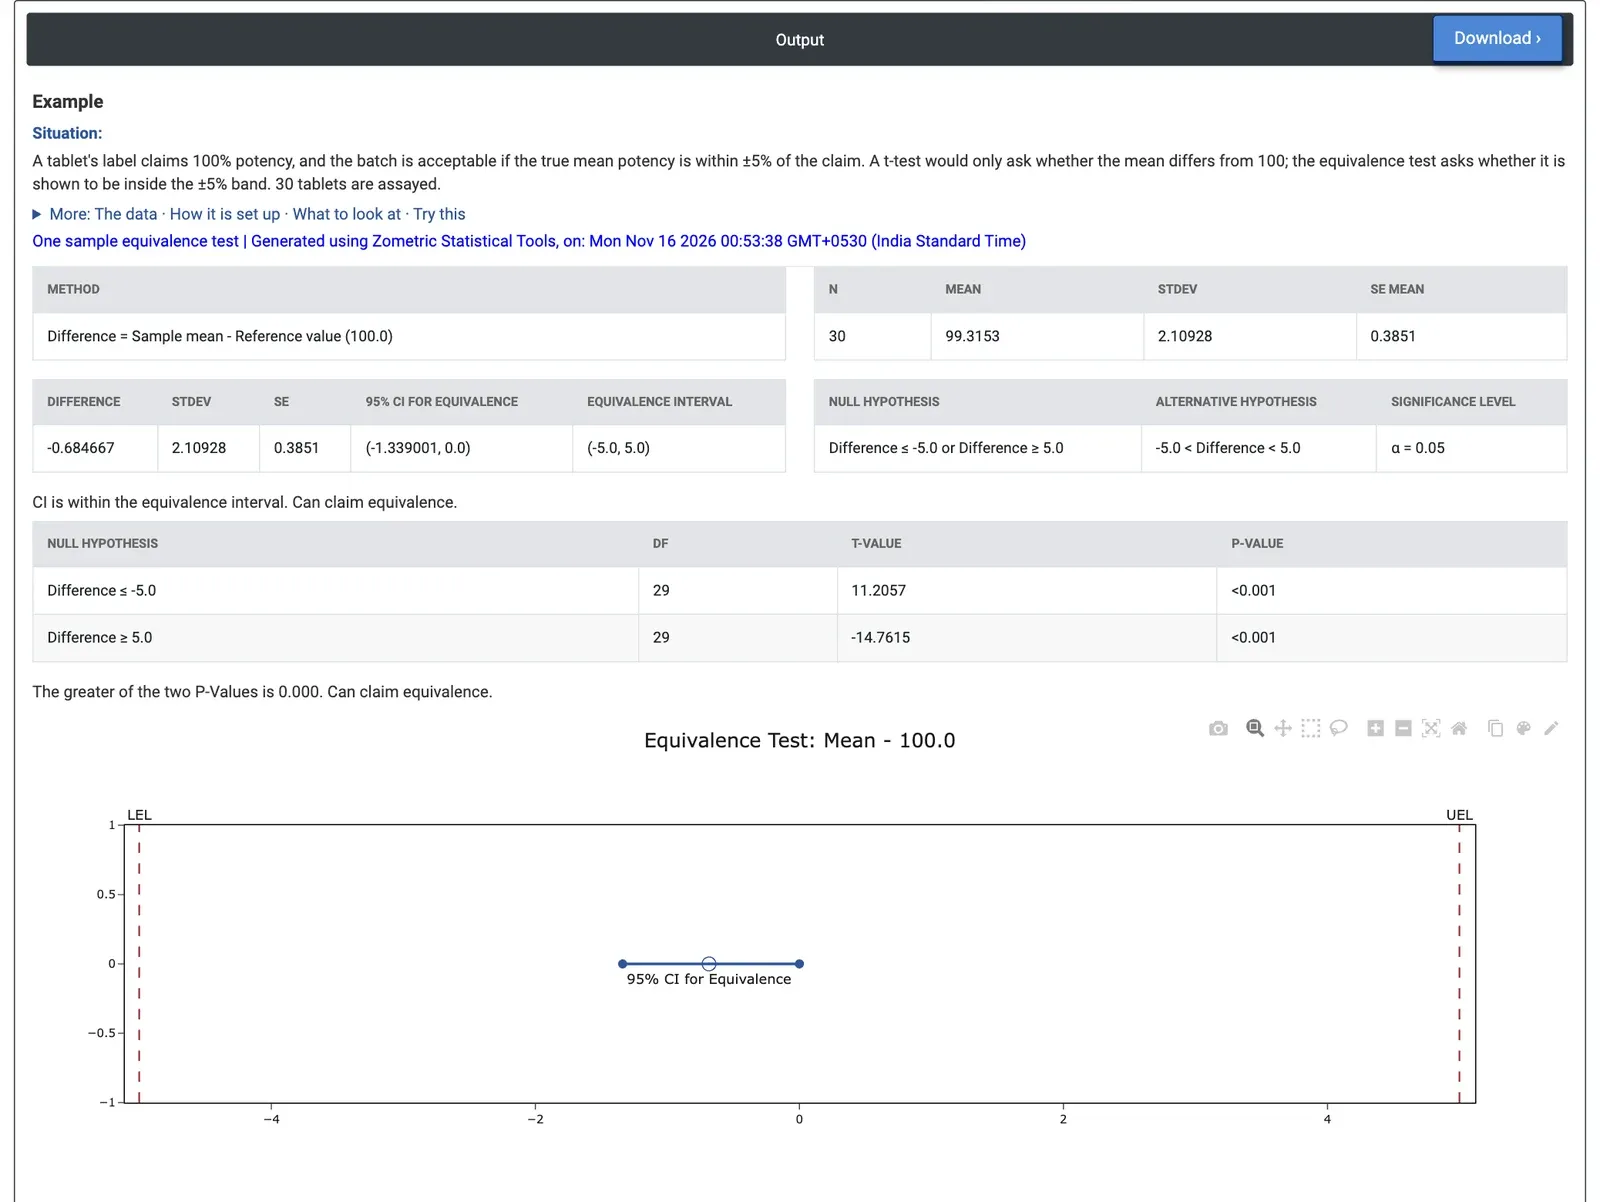
그림 2 — 동등성에 대한 95% CI인 −1.339~0은 한계 −5~5 안에 충분히 들어 있으며, 두 단측 검정 모두 p < 0.001입니다.
계산 예제
정제의 라벨에 역가 100%가 표시되어 있고, 참 평균 역가가 표시량의 ±5% 이내이면 배치가 합격입니다. 품질 시험실이 정제 30개를 분석합니다. Sample = Test_Potency_pct, Target = 100, Alpha = 0.05, 기본 동등성 대립가설, Lower Limit = −5, Upper Limit = 5입니다.
평균 역가는 99.3153%, 표준편차는 2.109, 표준오차는 0.3851이며, 정제는 95.19에서 103.86% 범위에 있습니다. 목표값과의 차이는 −0.6847입니다. 하한에 대한 검정은 t = 11.21, 상한에 대한 검정은 t = −14.76이며 둘 다 자유도 29, p < 0.001입니다. 동등성에 대한 95% CI는 −1.339~0(0을 포함하도록 확장)이며 −5~5 안에 충분히 들어 있으므로, 화면은 동등성을 판정할 수 있다고 보고합니다. 즉 배치 평균이 라벨 표시량의 ±5% 이내임이 입증되었습니다.
한계의 폭이 중요합니다. 더 좁은 한계 −1과 1에서는 하한에 대한 검정이 t = 0.82, p = 0.21이므로, 평균이 목표값보다 0.68만 낮은데도 동등성을 판정할 수 없습니다. 이 표본 크기와 산포에서는 데이터로 평균이 1% 낮을 가능성을 배제할 수 없기 때문입니다. 낮은 역가만 문제라면, 하한 −5의 대립가설 시험 평균 − 목표값 > 하한은 p < 0.001인 단일 검정과 −1.339의 95% 하한을 제공합니다.
자주 묻는 질문
1-표본 동등성 검정이란 무엇입니까?
1-표본 동등성 검정은 표본 평균이 사전에 정한 한계 안에서 목표값에 충분히 가까운지 보여 줍니다. 귀무가설은 평균이 한계 밖에 있다는 것이므로, 유의한 결과는 차이가 문제가 되지 않을 만큼 작다는 긍정적 증거입니다. TOST라고 하는 두 개의 단측 t 검정을 사용합니다.
동등성 검정과 1-표본 t 검정은 어떻게 다릅니까?
1-표본 t 검정은 평균이 목표값과 다른지만 말해 줄 수 있으며, 유의하지 않은 t 검정이 평균이 목표값에 맞는다는 것을 증명하지는 않습니다. 동등성 검정은 질문을 뒤집어 차이가 동등성 한계 안에 있는지 검정하므로, 유의한 결과는 평균이 목표값에 맞는다는 주장을 뒷받침합니다.
1-표본 동등성 검정은 어떻게 해석합니까?
두 단측 p-값이 모두 alpha보다 작으면(더 큰 p-값이 alpha보다 작은 것과 같음) 그리고 동등성 신뢰구간이 동등성 구간 안에 있으면 동등하다고 판정합니다. 동등성은 평균에 관한 것일 뿐이며, 모든 단위가 한계 안에 있다는 것을 보여 주지는 않습니다.
1-표본 동등성 검정의 가정은 무엇입니까?
이 검정은 대략 정규분포를 따르는 모집단에서 추출한 독립된 값을 가정하며, 값이 20개 이상이면 적당한 왜도는 거의 영향을 주지 않습니다. 한계의 폭이 동등성을 판정할 수 있는지에 크게 영향을 주므로, 동등성 한계는 데이터를 보기 전에 공학적 또는 규제상의 필요에 따라 선택해야 합니다.