
1-표본 포아송 비율 검정(1-Sample Poisson Rate Test)
1-표본 포아송 비율 검정은 노출 단위당 사건 발생률을 추정하고 가설 비율과 비교합니다. 합격/불합격 데이터가 아니라 고정된 노출에서 독립적으로 발생하는 사건의 개수에 사용합니다. 데이터는 개수 열이거나 표본 크기와 합계일 수 있습니다. 정확 방법 또는 정규 근사를 제공하며, 표본 비율, 신뢰구간, p-값을 출력합니다.
최종 검토
핵심 요점
1-표본 포아송 비율 검정은 패널당 결점 수나 월간 고장 횟수와 같은 사건 발생률을 신뢰구간으로 추정하고, 이 비율이 목표 비율이나 과거 비율과 다른지 검정합니다.
목적
1-표본 포아송 비율 검정은 패널당 결점 수, 월간 고장 횟수, 시간당 통화 수와 같은 사건 발생률을 추정하고 목표 비율이나 과거 비율과 비교합니다. 비율을 신뢰구간과 함께 제시하며, 원하는 경우 비율이 가설 값과 다른지, 또는 가설 값보다 큰지 작은지를 검정합니다. 합격/불합격 결과에는 1-비율 검정을 사용해야 하며, 이 검정은 각 사건이 독립적인, 고정된 노출량(단위, 면적, 시간)에서의 사건 개수에 사용합니다.
주요 기능
- 개수 열(단위당 개수 하나) 또는 요약값(표본 크기와 총 발생 횟수)으로 입력하는 데이터.
- 정확 방법(정확 포아송 검정과 정확 신뢰구간) 또는 정규 근사(z 검정).
- 양측 또는 단측 대립가설과, 이에 맞는 양측 구간 또는 단측 한계.
- 패널당, 100 m²당, 교대당 등 임의의 관측 길이 단위당 비율.
- Perform hypothesis test를 해제하면 검정 없이 신뢰구간만 제공합니다.
통계적 방법
N개의 단위를 각각 길이 t(Length of observation, 기본값 1)만큼 관측하면 총 노출량은 T = N·t입니다. 전체에서 X개의 사건을 센 경우 표본 비율은 λ̂ = X / T입니다. 귀무가설 하에서 개수 X는 평균 μ₀ = λ₀·T인 포아송 분포를 따르며, λ₀는 가설 비율입니다.
정확 방법: Rate > hypothesized rate의 경우 p-값은 P(X ≥ x | μ₀), Rate < hypothesized rate의 경우 P(X ≤ x | μ₀)이며, 양측 검정에서는 우도비 규칙에 따라 같은 정도로 일어나기 어려운 개수를 넘어서는 반대쪽 꼬리의 확률을 p-값에 더합니다. 신뢰구간은 카이제곱 분포에서 구하는 정확(Garwood) 구간이며, 하한 = χ²(α/2; 2x) / (2T), 상한 = χ²(1 − α/2; 2x + 2) / (2T)입니다. 단측 한계에서는 α / 2를 α로 바꿉니다.
정규 근사: z = (λ̂ − λ₀) / √(λ₀ / T)이며 p-값은 표준정규분포에서 구하고, 구간은 λ̂ ± z·√(λ̂ / T)에서 0 미만을 잘라 낸 것입니다. 기대 개수가 클 때는 정확 방법에 가깝습니다. 두 방법 모두 사건이 일정한 비율로 독립적으로 발생한다고 가정하므로 개수의 분산이 평균과 같습니다. 개수가 평균보다 훨씬 크게 변동하면(결점이 군집으로 발생하는 경우) p-값이 지나치게 작아집니다.
입력 항목 및 옵션
항목 | 설명 |
Data | Summarized data(기본값) 또는 Counts in a column입니다. |
Sample | Counts in a column인 경우: 단위당 하나씩의 개수가 들어 있는 열입니다. 개수는 0 이상의 정수여야 하며 빈 셀은 무시됩니다. |
Sample size / Total occurrences | Summarized data인 경우: 단위의 수와 센 사건의 총 개수입니다. |
Perform hypothesis test | 기본적으로 선택되어 있습니다. 해제하면 비율과 그 신뢰구간만 얻습니다. |
Hypothesized rate | 검정에 필수입니다. 관측 길이당 목표 비율 또는 과거 비율이며, 0보다 커야 합니다. |
Confidence level | 기본값은 95이며, 75~100입니다. |
Alternative hypothesis | Rate ≠ hypothesized rate(기본값), Rate < hypothesized rate 또는 Rate > hypothesized rate입니다. |
Method | Exact(기본값) 또는 Normal approximation입니다. |
Length of observation | 기본값은 1입니다. 각 단위의 노출량이며, 비율을 표현하는 단위로 나타냅니다. |
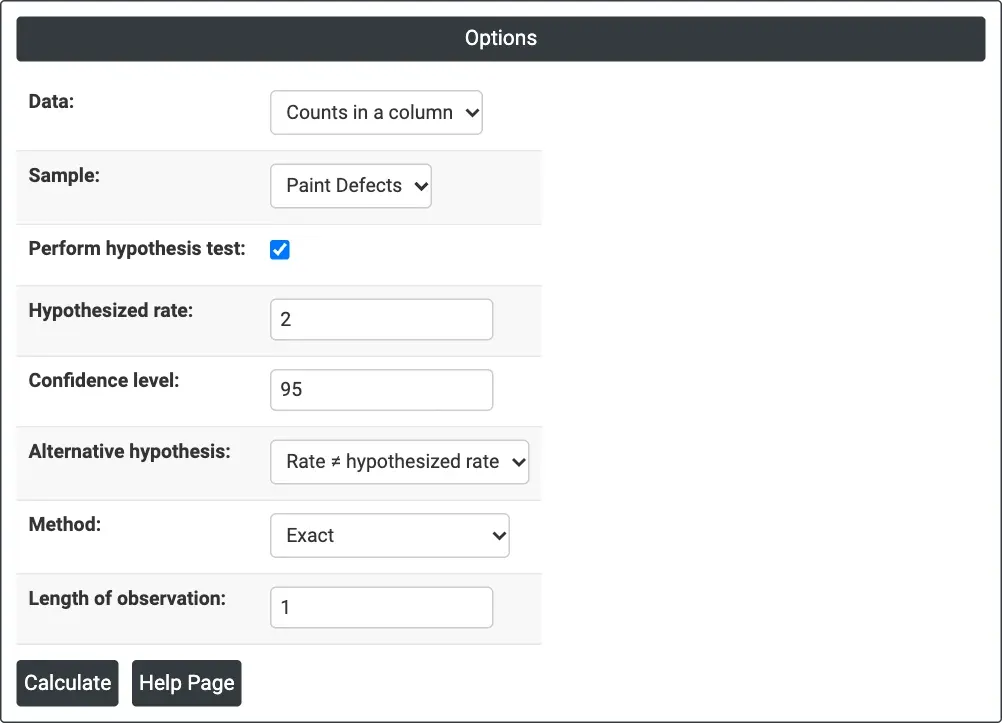
그림 1 — 예제의 옵션: 각 패널에서 센 페인트 결점, 가설 비율 2, 양측, 정확 방법.
출력 설명
- Descriptive Statistics — N, Total Occurrences, Sample Rate와 λ의 신뢰구간(단측 검정에서는 하한 또는 상한)이며, 열 이름, 방법, 1이 아닌 관측 길이를 알려 주는 주석이 포함됩니다.
- Test — 귀무가설과 대립가설, P-Value(정규 근사에서는 Z-Value 포함)입니다.
- Download를 통한 PDF 내보내기.
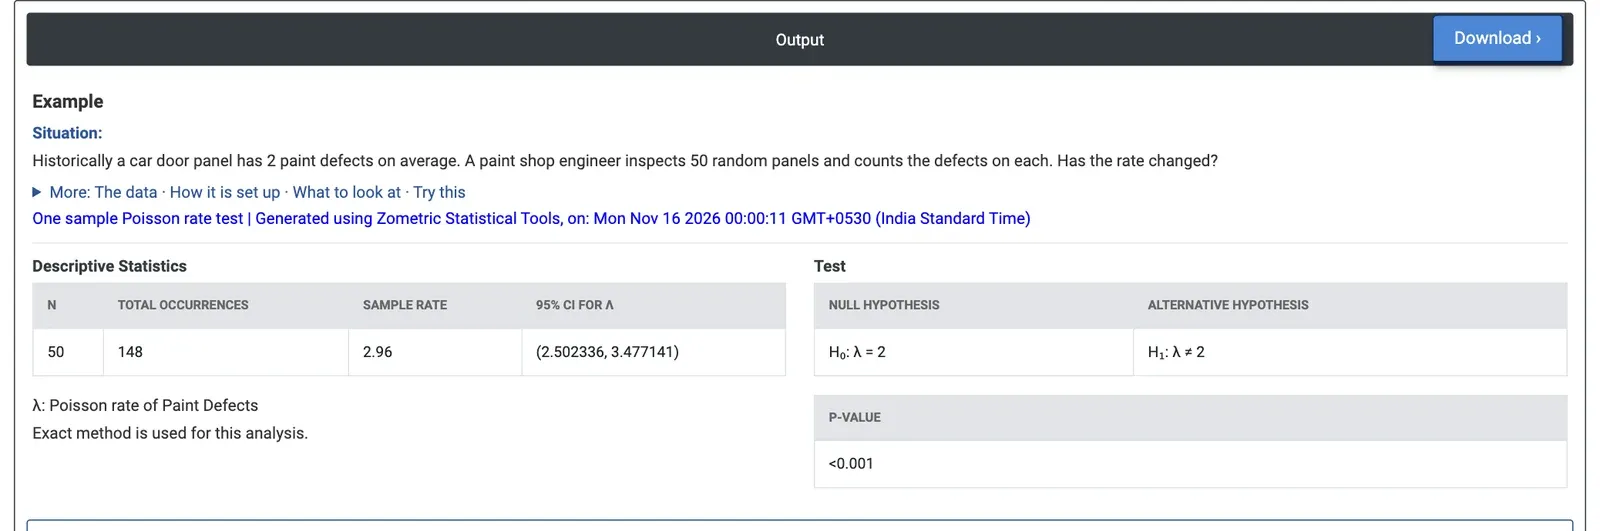
그림 2 — 패널 50개의 결점 148개: 패널당 비율 2.96, 95% 신뢰구간 2.502~3.477, 과거 비율 2에 대한 p < 0.001.
계산 예제
자동차 도어 패널에는 과거에 평균 2개의 페인트 결점이 있었습니다. 도장 공장 엔지니어가 패널 50개를 무작위로 검사하여 각 패널의 결점 수를 셉니다. 비율이 변했습니까? Data = Counts in a column, Sample = Paint Defects, Hypothesized rate = 2, Confidence level = 95, Alternative hypothesis = Rate ≠ hypothesized rate, Method = Exact, Length of observation = 1로 설정합니다.
패널 50개에는 전체 결점이 148개 있으며 표본 비율은 패널당 결점 2.96개입니다. λ의 95% 신뢰구간은 2.502~3.477로, 구간 전체가 2보다 큽니다. 정확 p-값이 0.001 미만이므로 결점률이 변했으며, 이전보다 약 1.5배 수준입니다. 개수는 포아송을 따르는 것으로 보입니다. 분산(2.37)이 평균에 가까우므로 결점이 군집으로 발생하여 검정이 지나치게 낙관적이 될 징후는 없습니다.
정규 근사도 같은 결론을 줍니다(z = 4.8, p < 0.001, 구간 2.483~3.437). 비율이 증가했는지만 알고 싶다면 Rate > hypothesized rate에서 95% 하한은 패널당 결점 2.571개이며, 결점률이 과거 수준보다 적어도 약 29% 높으므로 엔지니어는 도장 공정에서 무엇이 바뀌었는지 살펴봐야 합니다. Data = Summarized data, Sample size = 50, Total occurrences = 148로 해도 같은 결과를 얻습니다.
자주 묻는 질문
1-표본 포아송 비율 검정이란 무엇입니까?
1-표본 포아송 비율 검정은 패널당 결점 수, 월간 고장 횟수, 시간당 통화 수와 같은 사건 발생률을 추정하고 목표 비율이나 과거 비율과 비교합니다. 비율을 신뢰구간과 함께 제시하며, 비율이 가설 값과 다른지, 또는 가설 값보다 큰지 작은지를 검정할 수 있습니다.
1-비율 검정 대신 포아송 비율 검정은 언제 사용해야 합니까?
단위, 면적, 시간과 같은 고정된 노출량에서 각 사건이 독립적이며 한 단위에 여러 사건이 있을 수 있는 사건 개수에는 포아송 비율 검정을 사용합니다. 각 항목이 단순히 적합 또는 부적합인 합격/불합격 결과에는 대신 1-비율 검정을 사용합니다.
포아송 비율 검정의 가정은 무엇입니까?
정확 방법과 정규 근사 방법 모두 사건이 일정한 비율로 독립적으로 발생한다고 가정하므로 개수의 분산이 평균과 같습니다. 예를 들어 결점이 군집으로 발생하여 개수가 평균보다 훨씬 크게 변동하면 p-값이 지나치게 작아집니다.
정확 방법과 정규 근사 방법의 차이는 무엇입니까?
정확 방법은 p-값에 포아송 분포를, 신뢰구간에 카이제곱 분포에서 구하는 정확 Garwood 구간을 사용합니다. 정규 근사는 z 검정을 사용하며 구간은 비율 ± z × √(비율 / 노출량)입니다. 기대 개수가 클 때는 정확 방법에 가깝습니다.