
포아송 회귀(Poisson Regression)
포아송 회귀는 일정한 시간, 면적 또는 제품당 사건 횟수를 연속형 및 범주형 예측 변수에 대해 모형화합니다. 횟수는 음수가 될 수 없고 산포가 평균과 함께 커지므로 일반 회귀 대신 사용합니다. 반응 변수는 로그, 제곱근 또는 항등 연결 함수를 갖는 포아송 분포를 따른다고 가정합니다. 출력에는 계수, 이탈도 분석, 적합도 검정, 잔차 그림이 포함됩니다.
최종 검토
핵심 요점
포아송 회귀는 교대당 결점 수나 월별 고장 횟수 같은 계수형 반응 변수를 연속형 및 범주형 예측 변수와 연결하는 일반화 선형 모형이며, 최대우도법으로 적합합니다.
목적
포아송 회귀는 교대당 결점 수, 월별 고장 횟수, 패널당 흠집 수 같은 계수형 반응 변수를 연속형 및 범주형 예측 변수와 연결합니다. 반응 변수가 일정한 시간, 면적 또는 제품당 사건 횟수일 때 일반 회귀 대신 사용합니다. 횟수는 음수가 될 수 없고 산포가 평균과 함께 커지는데, 최소제곱법은 이를 반영하지 못하기 때문입니다.
주요 기능
- 연속형 및 범주형 예측 변수를 지원하며, 항 목록에서 교호작용과 제곱항을 선택할 수 있습니다.
- 로그(기본값), 제곱근 또는 항등 연결 함수.
- 항의 단계적 선택, 전진 선택 또는 후진 제거를 지원하며, 모든 모형에 항을 강제로 포함할 수 있습니다.
- 신뢰구간과 VIF가 포함된 계수, 범주형 예측 변수의 각 수준별 회귀 방정식, 모형 요약, 적합도 검정.
- Wald 검정 또는 우도비 검정(조정 또는 순차)에 의한 이탈도 분석.
- 특이 관측값, 잔차 그림, 주효과도와 교호작용도, 적합 횟수의 등고선도와 표면도.
- 입력한 설정에서의 예측과 반응 최적화 도구.
통계적 방법
반응 변수는 평균 μ를 갖는 포아송 분포를 따른다고 가정하며, μ는 연결 함수를 통해 예측 변수에 의존합니다. 로그 연결 함수에서는 ln μ = b₀ + b₁x₁ + …이므로, 각 계수는 해당 예측 변수가 한 단위 증가할 때 기대 횟수에 exp(b)를 곱합니다. 모형은 최대우도법(반복 재가중 최소제곱법)으로 적합하는 일반화 선형 모형입니다. 범주형 예측 변수는 기준 수준에 대한 (1, 0) 코딩을 사용하며, 기본 기준 수준은 정렬 순서의 첫 번째 수준입니다. 결측값이 있는 행은 제외하며, 빈도 열은 행을 반복하고 가중치 열은 분산 가중치를 부여합니다.
계수 표는 Wald z-값(Coef / SE Coef)과 신뢰구간을 제공합니다. 이탈도 분석은 각 항을 검정합니다. 기본적으로 Wald 카이제곱(연속형 항은 z², 범주형 항은 더미 열에 대한 결합 검정)을 사용하며, LR 검정에서는 전체 모형에서 해당 항을 제외했을 때(조정, Type III) 또는 순서대로 추가했을 때(순차, Type I)의 이탈도 변화를 사용합니다. 이탈도 R-Sq = 1 − 잔차 이탈도 / 영 이탈도입니다.
적합도 검정은 이탈도와 Pearson 카이제곱을 오차 자유도의 카이제곱 분포와 비교합니다. p-값이 작거나 Mean(이탈도 / DF)이 1보다 훨씬 크면 횟수가 포아송 모형이 허용하는 것보다 더 크게 변동한다는 뜻이며(과대산포), 이때 항의 p-값은 지나치게 작습니다. 표준화 잔차가 ±2를 넘는 관측값은 R로, 레버리지가 3p/n을 넘는 관측값은 X로 표시합니다.
입력 항목 및 옵션
항목 | 설명 |
Response | 횟수의 열입니다. 필수. |
Continuous Predictors / Categorical Predictor | 수치형 및 텍스트(또는 코딩된) 예측 변수 열이며 하나 이상 필요합니다. 여러 개를 선택하려면 Ctrl 또는 Command + 클릭을 사용합니다. |
Model terms (optional) | 항 목록: 항을 선택하거나, Terms through order(2 또는 3)에서 선택한 차수까지 Add all, Interactions, Powers를 사용합니다. In model의 선택을 해제하면 교호작용은 유지한 채 선형 항을 제거합니다. |
Reference level (optional) | 범주형 예측 변수에 대해 “Predictor Level” 형식으로 쉼표로 구분하여 지정합니다. 기본값은 정렬 순서의 첫 번째 수준입니다. |
Stepwise method | None(기본값), Stepwise, Forward selection 또는 Backward elimination이며, Alpha to enter와 Alpha to remove(0.15), 계층 규칙, Terms in every model (E), Initial model terms (I), Model selection details가 함께 제공됩니다. |
Frequency (optional) / Weights (optional) | 행 빈도와 가중치의 열입니다. |
Link function | Log(기본값), Square root 또는 Identity. |
Confidence level / Type of confidence interval | 기본값은 95, Two-sided이며, Lower bound 또는 Upper bound도 선택할 수 있습니다. |
Fits and diagnostics for all observations | 특이 관측값만이 아니라 모든 행의 적합값과 잔차를 나열합니다. |
Test for ANOVA table / Type of deviance (LR test only) | Wald test(기본값) 또는 LR test이며, LR의 경우 Adjusted (Type III, 기본값) 또는 Sequential (Type I)입니다. |
Residuals for diagnostics/plots | Deviance(기본값) 또는 Pearson. |
Histogram of residuals / Normal probability plot of residuals / Residuals versus fits / Residuals versus order / Four in one / Residuals versus the variables | 잔차 그림. |
Main effects plot / Interaction plot | 다른 예측 변수를 평균 또는 기준 수준에 고정한 채 각 예측 변수에 대한 적합 횟수를 표시합니다. |
Contour plot / Surface plot / Overlaid contour plot of fitted values | X1과 X2 축 변수가 필요하며, 겹침 등고선도에는 Response low와 Response high도 필요합니다. |
Prediction / Response Optimizer | 입력한 설정에서 평균 횟수(SE와 신뢰구간 포함)를 예측하거나 횟수 목표를 충족하는 설정을 찾는 패널을 추가합니다. |
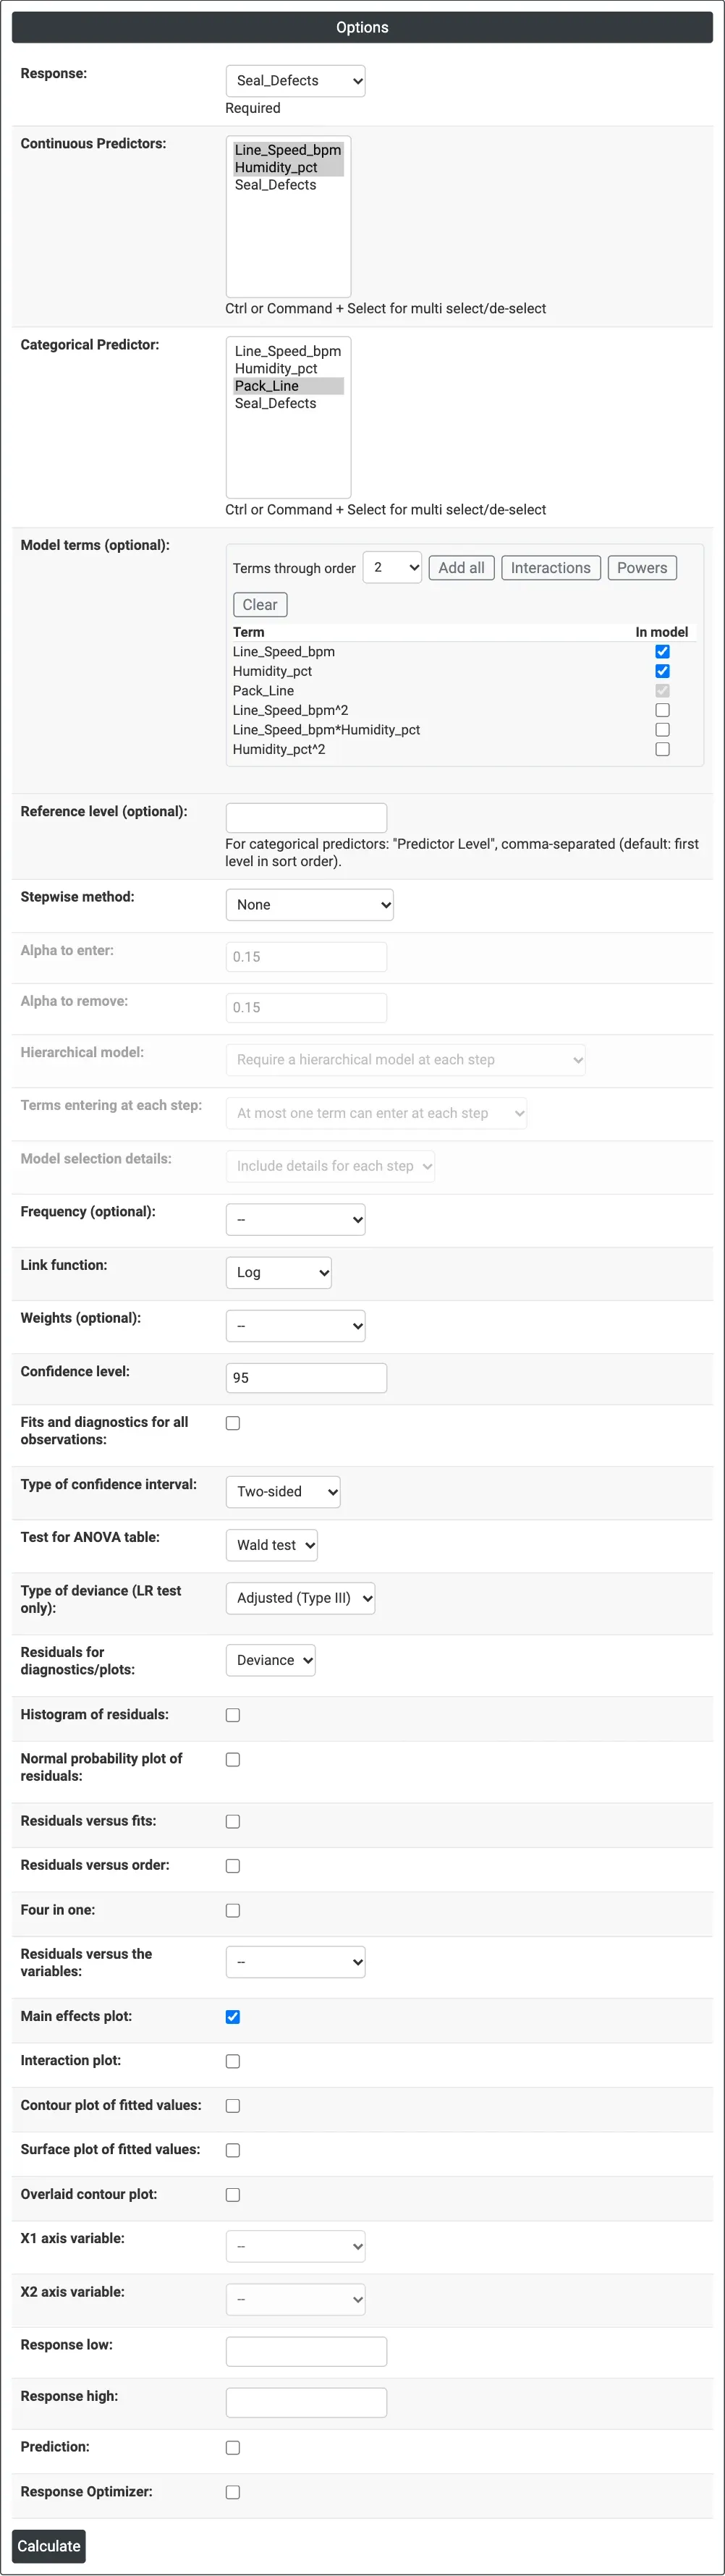
그림 1 — 포장 밀봉 예제의 옵션: 반응 변수는 Seal_Defects, 연속형 예측 변수는 라인 속도와 습도, 범주형 예측 변수는 포장 라인이며 주효과도를 선택했습니다.
출력 설명
- Method — 연결 함수, 범주형 코딩, 사용된 행.
- Response Information — 횟수의 N, 평균, 표준편차, 최솟값, 최댓값.
- Coefficients — Coef, SE Coef, Z-Value, P-Value, 신뢰 한계, VIF.
- Regression Equation — 범주형 예측 변수의 각 수준별 선형 예측값 Y'(로그 연결 함수에서는 기대 횟수의 ln).
- Model Summary — 이탈도 R-Sq, Adj R-Sq, AIC, AICc, BIC.
- Goodness-of-Fit Tests — 이탈도 및 Pearson 카이제곱 검정.
- Fits and Diagnostics for Unusual Observations.
- Analysis of Deviance — 회귀와 각 항의 카이제곱 및 p-값.
- 선택한 경우 단계적 선택 표, 잔차, 요인, 등고선, 표면 그림, 예측 및 최적화 패널.
- Download를 통한 PDF 내보내기.
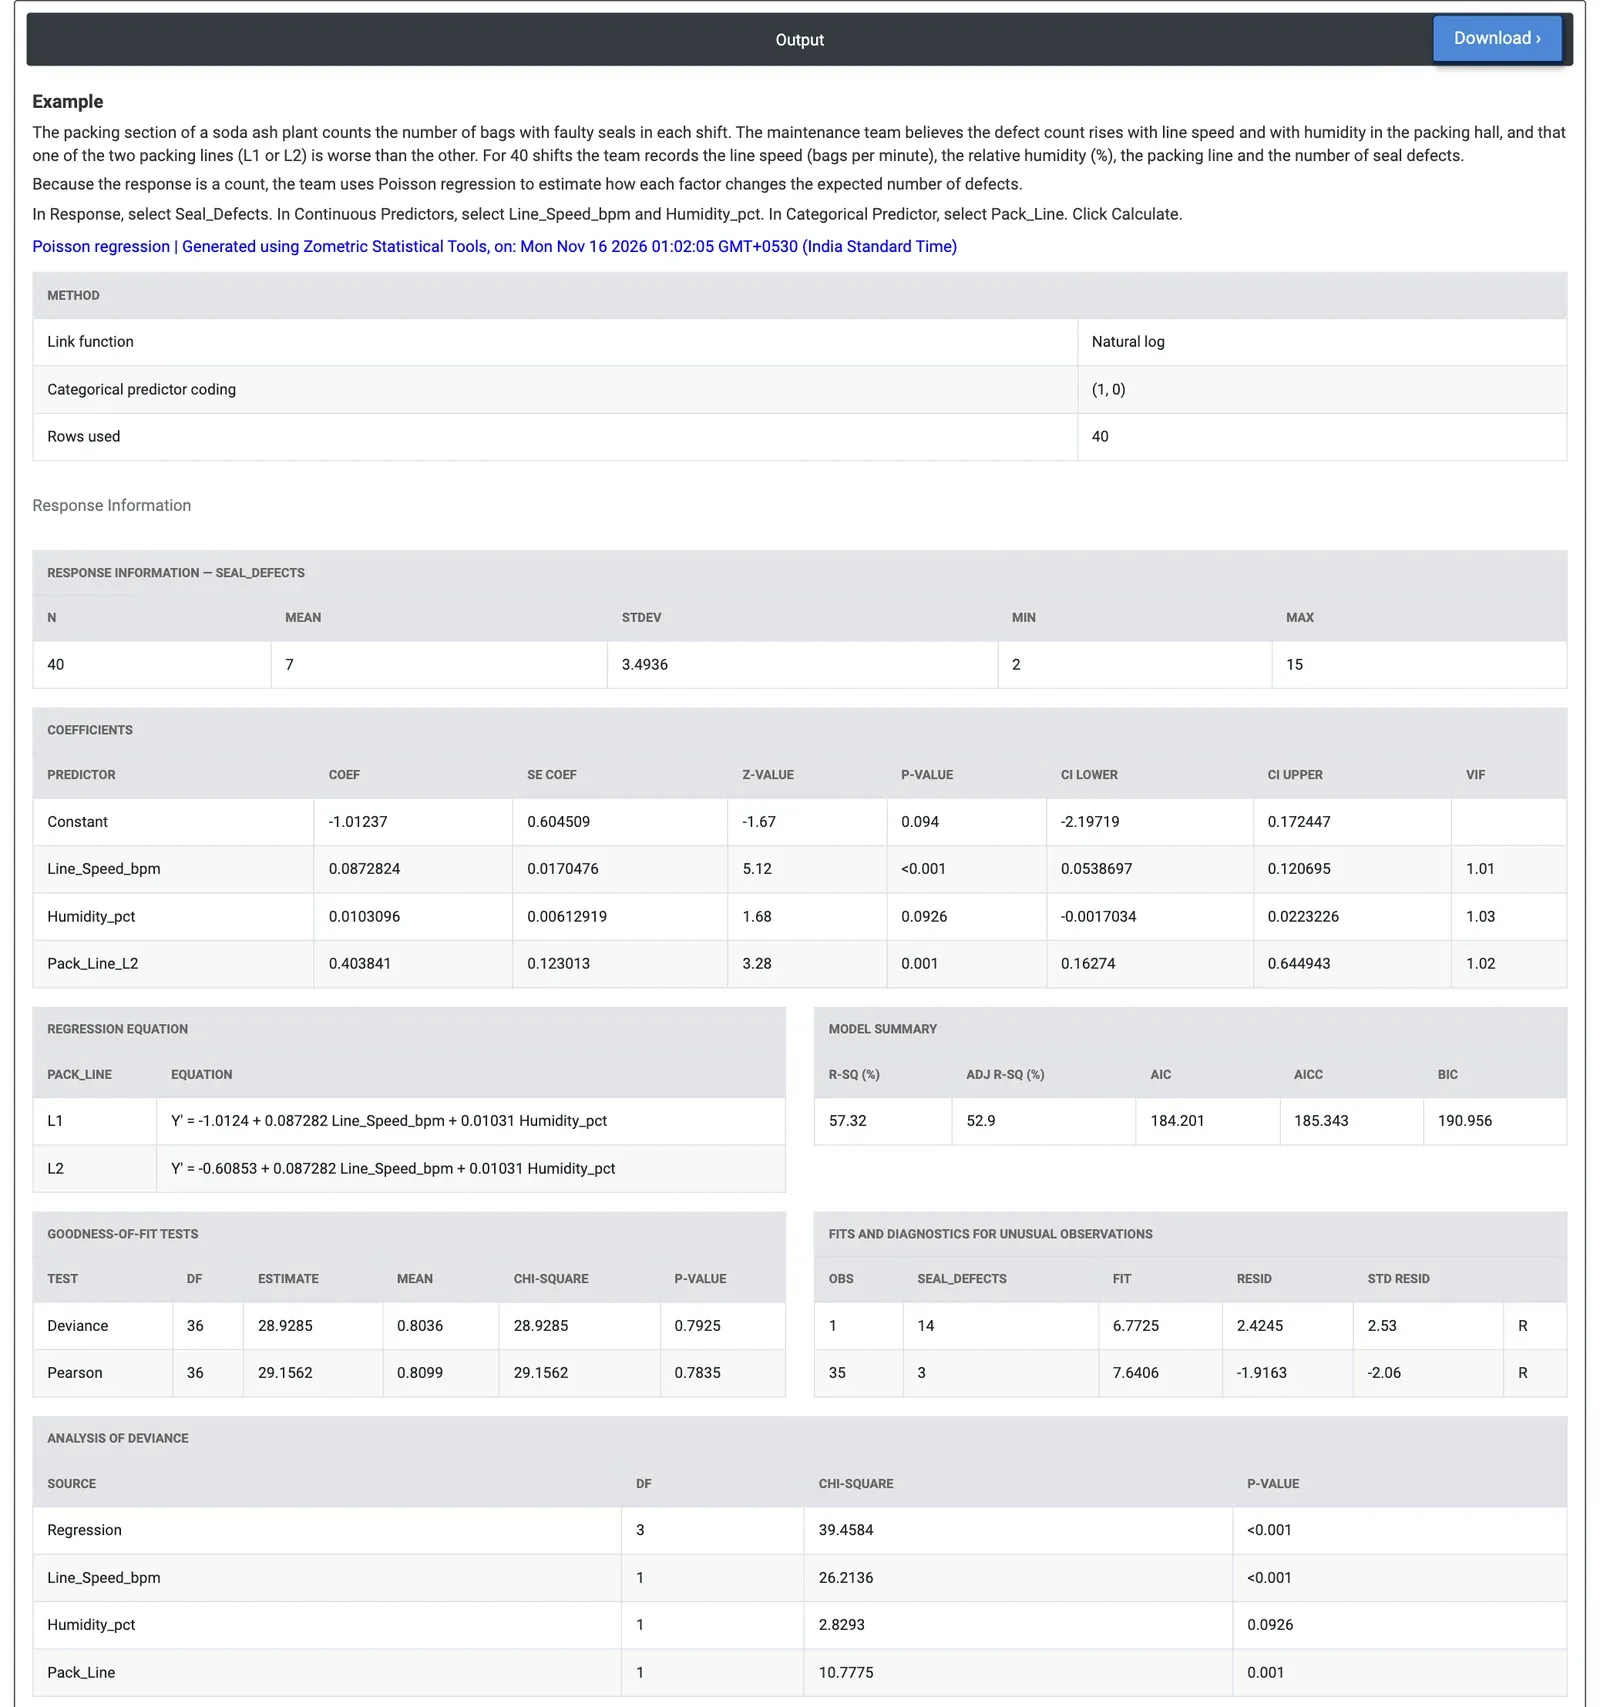
그림 2 — 교대당 밀봉 결점의 포아송 회귀: 라인 속도(p < 0.001)와 포장 라인(p = 0.001)은 유의하고, 습도는 5% 수준에서 유의하지 않습니다(p = 0.0926).
계산 예제
소다회 공장의 포장 부서는 교대마다 밀봉 불량 포대를 셉니다. 팀은 40개 교대에 대해 라인 속도(분당 포대 수), 포장실 습도(%), 포장 라인(L1 또는 L2), 밀봉 결점 수(2~15, 평균 7)를 기록합니다. 반응 변수로 Seal_Defects, 연속형 예측 변수로 라인 속도와 습도, 범주형 예측 변수로 Pack_Line을 선택하고 로그 연결 함수를 유지합니다.
라인 속도의 효과가 가장 강합니다(Wald 카이제곱 26.21, p < 0.001). 계수 0.0873은 분당 포대 수가 1 증가할 때마다 기대 결점이 exp(0.0873) = 1.09배가 되고, 분당 5포대 빨라지면 약 1.55배가 됨을 뜻합니다. 라인 L2의 계수는 0.404(p = 0.001)이므로, 같은 속도와 습도에서 L1보다 밀봉 결점이 약 1.50배 많이 발생합니다. 습도도 같은 방향이지만(상대습도 10%당 결점 약 11% 증가) 5% 수준에서는 유의하지 않습니다(p = 0.0926).
모형은 횟수에 잘 적합합니다. 이탈도 카이제곱은 자유도 36에서 28.93(p = 0.7925), Pearson은 29.16(p = 0.7835)이며 Mean이 1보다 작으므로 과대산포의 징후는 없습니다. 교대 두 개가 표시되었습니다. 교대 1은 적합값 6.8에 비해 결점이 14개이고, 교대 35는 적합값 7.6에 비해 3개입니다. 팀은 먼저 L2의 밀봉 조와 속도 설정값을 살펴보고, 제습 여부를 결정하기 전에 습도 데이터를 계속 수집합니다.
자주 묻는 질문
일반 최소제곱 회귀 대신 포아송 회귀는 언제 사용합니까?
반응 변수가 교대당 결점 수나 월별 고장 횟수처럼 일정한 시간, 면적 또는 제품당 사건 횟수일 때 포아송 회귀를 사용합니다. 횟수는 음수가 될 수 없고 산포가 평균과 함께 커지는데, 최소제곱 회귀는 이를 반영하지 못합니다. 포아송 회귀는 최대우도법으로 적합하는 일반화 선형 모형으로 이를 처리합니다.
포아송 회귀 계수는 어떻게 해석합니까?
기본 로그 연결 함수에서는 기대 횟수의 ln이 b0 + b1x1 + ...와 같으므로, 각 계수는 해당 예측 변수가 한 단위 증가할 때 기대 횟수에 exp(b)를 곱합니다. 예를 들어 라인 속도 계수 0.0873은 분당 포대 수가 1 증가할 때마다 기대 결점이 exp(0.0873) = 1.09배가 됨을 뜻합니다. 범주형 예측 변수는 기준 수준과 비교합니다.
포아송 회귀에서 과대산포는 어떻게 확인합니까?
적합도 검정은 이탈도와 Pearson 카이제곱을 오차 자유도의 카이제곱 분포와 비교합니다. p-값이 작거나 Mean(이탈도를 DF로 나눈 값)이 1보다 훨씬 크면 횟수가 포아송 모형이 허용하는 것보다 더 크게 변동한다는 뜻입니다. 이 경우 모형 항의 p-값은 지나치게 작아 신뢰해서는 안 됩니다.
포아송 회귀에서 특이 관측값은 어떻게 표시합니까?
표준화 잔차가 ±2를 넘는 관측값은 R로, 레버리지가 3p/n을 넘는 관측값은 X로 표시합니다. 이들은 Fits and Diagnostics for Unusual Observations 표에 나열되며, 적합값 대비 잔차와 잔차의 정규 확률도 같은 잔차 그림을 추가하여 더 자세히 살펴볼 수 있습니다.