
2-분산 검정력 및 표본 크기
두 대의 기계나 두 게이지처럼 두 집단의 산포를 비교하는 2-분산 검정을 계획합니다. 집단당 표본 크기, 표준편차 비, 검정력 중 두 가지를 입력하면 도구가 집단 크기가 같다는 가정 아래 정확한 F 분포 계산으로 나머지 하나를 구합니다. 데이터가 정규분포를 따른다고 가정하며 비정규성에 민감합니다. 실제 검정력이 포함된 결과 표와 검정력 곡선을 출력합니다.
최종 검토
핵심 요점
2-분산의 검정력 및 표본 크기는 서로 독립인 두 집단의 산포를 비교하는 F 검정을 계획하며, 집단당 표본 크기, 검정력 또는 탐지 가능한 표준편차 비를 구합니다.
목적
2-분산의 검정력 및 표본 크기는 두 대의 기계, 두 게이지, 두 공급업체의 반복성처럼 서로 독립인 두 집단의 산포 비교를 계획합니다. 산포의 차이는 두 표준편차의 비(σ₁/σ₂)로 입력하므로 표준편차 자체를 입력할 필요가 없습니다. 표본 크기, 비, 검정력 중 두 가지를 입력하면 도구가 나머지 하나를 구합니다. 즉 각 집단에 필요한 단위 수, 계획한 표본의 검정력, 주어진 표본이 탐지할 수 있는 최소 비입니다. 2-분산 검정 전에 사용합니다.
주요 기능
- 표본 크기, 검정력 또는 비를 구합니다. 구하려는 항목은 비워 둡니다.
- 비 “1.5 2”와 검정력 값 “0.8 0.9”처럼 여러 값을 한 번에 입력하면 조합마다 한 행이 만들어집니다.
- 선택한 신뢰수준에서 양측 또는 단측 대립가설을 지원합니다.
- 두 집단의 표본 크기가 같다는 가정 아래 정확한 F 분포 계산을 사용합니다.
- 각 비에 대한 표본 크기별 검정력 곡선이며, 구한 점이 표시됩니다.
통계적 방법
계산의 기반은 2-분산 F 검정입니다. 정규 모집단에서 각 집단에 단위가 n개씩 있고 표준편차가 같을 때 F = S₁²/S₂²는 자유도 (n − 1, n − 1)인 F 분포를 따릅니다. 참 비가 r = σ₁/σ₂이면 F는 그러한 변수의 r²배입니다. 유의수준은 α = 1 − 신뢰수준 / 100입니다.
“greater than” 대립가설(σ₁ > σ₂)에서 검정력 = P(F > f₁₋α / r²)이고, “less than”에서는 검정력 = P(F < f_α / r²)이며, 양측 검정에서는 양쪽 꼬리를 모두 고려하여 자유도 (n − 1, n − 1)인 F의 분위수 f_α/2와 f₁₋α/2를 사용합니다. 목표 검정력에 대한 표본 크기는 수치적으로 구하여 올림하며, 그 정수에서의 검정력을 실제 검정력으로 보고합니다. 비를 구할 때 도구는 “less than” 대립가설에서는 1보다 작은 쪽을, 그 외에는 1보다 큰 쪽을 탐색합니다.
두 집단의 크기가 같으므로 비 r과 비 1/r은 같은 양측 결과를 줍니다(1.5와 0.667 모두 검정력 80%에 집단당 50개가 필요). F 검정은 데이터가 정규분포를 따른다고 가정하며 정규성에서 벗어나면 민감합니다.
입력 항목 및 옵션
항목 | 설명 |
Sample sizes | 집단당 값입니다. 공백 또는 쉼표로 구분하며, 예를 들어 “10 20 30”입니다. 표본 크기를 구하려면 비워 둡니다. |
Ratio(s) | 공백 또는 쉼표로 구분하며, 예를 들어 “1.5 2”입니다. 탐지하려는 두 참 표준편차의 비(σ₁/σ₂)입니다. 이를 구하려면 비워 둡니다. |
Power values | 공백 또는 쉼표로 구분하며, 예를 들어 “0.8 0.9”입니다. 검정력을 구하려면 비워 둡니다. |
Confidence level | 기본값은 95(α = 0.05)이며 범위는 75~100입니다. |
Alternative hypothesis | σ1/σ2 ≠ 1(기본값), σ1/σ2 < 1(σ₁ < σ₂) 또는 σ1/σ2 > 1(σ₁ > σ₂). |
Power curve | 기본적으로 선택되어 있으며, 표본 크기에 대한 검정력을 그립니다. |
Title | 출력과 검정력 곡선에 표시되는 제목입니다. |
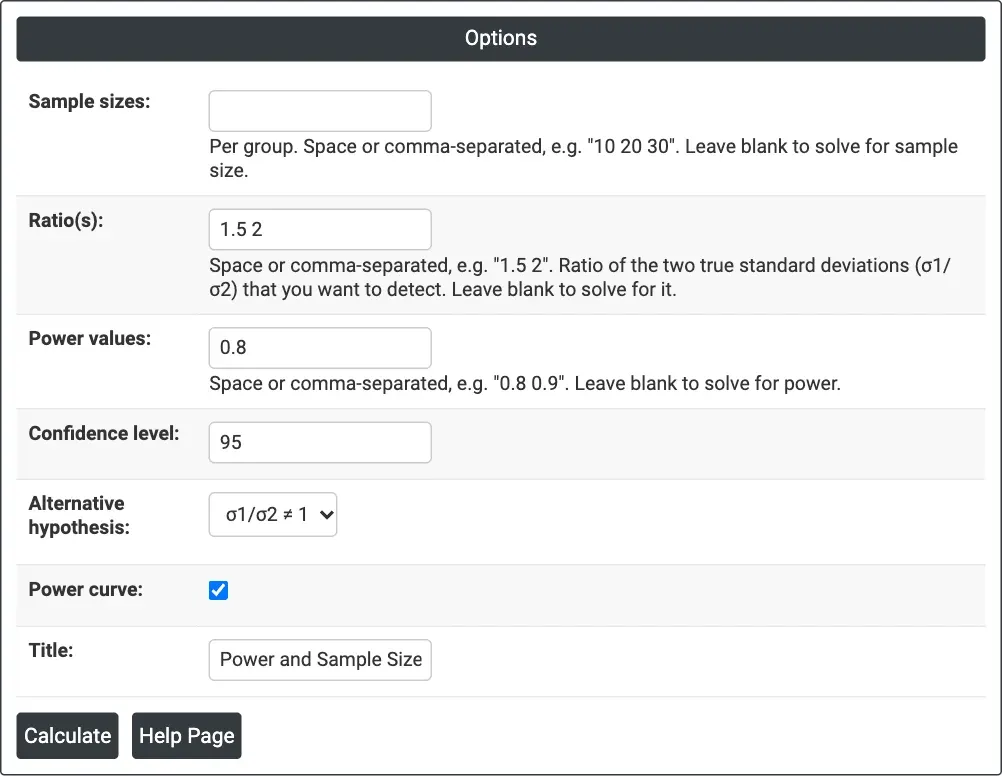
그림 1 — 표본 크기 구하기: Ratio(s) = 1.5 2, Power values = 0.8, 신뢰수준 95%의 양측.
출력 설명
- Settings — 구한 항목, 신뢰수준, 대립가설.
- Results — 조합마다 한 행이며, 표본 크기를 구할 때는 비, 집단당 표본 크기, 목표 검정력과 실제 검정력, 검정력을 구할 때는 검정력, 비를 구할 때는 비를 표시합니다.
- Power Curve — 각 비에 대한 표본 크기별 검정력이며, 계산한 점이 표시됩니다.
- Download를 통한 PDF 내보내기.
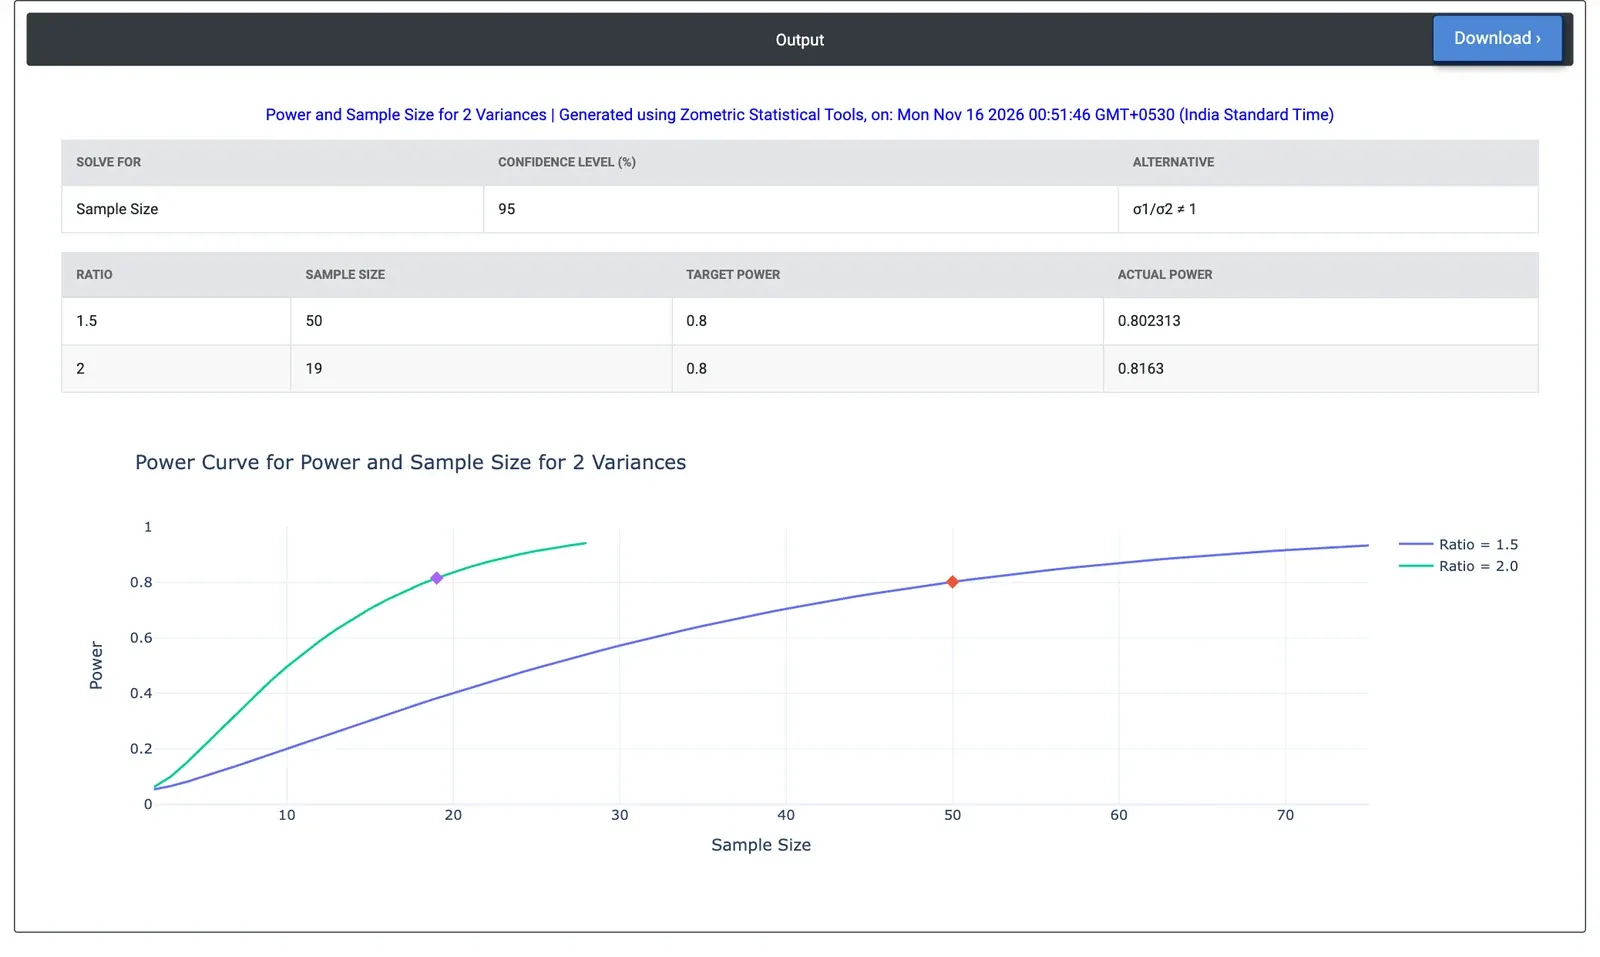
그림 2 — 예제 결과: 검정력 80%에서 비 1.5를 탐지하려면 기계당 부품 50개, 비 2를 탐지하려면 기계당 19개가 필요합니다.
계산 예제
한 기계 가공 업체가 기존 CNC 기계와 새 CNC 기계의 보어 직경 변동을 비교하려고 합니다. 표준편차 비가 1.5이면 중요한 작업을 더 나은 기계로 옮길 만하고, 비가 2이면 심각한 수준입니다. 엔지니어는 Sample sizes를 비워 두고 Ratio(s) = 1.5 2, Power values = 0.8을 입력하며, 신뢰수준 95%의 양측 대립가설을 유지합니다.
도구는 검정력 80%로 비 1.5를 탐지하려면 기계마다 부품 50개(실제 검정력 0.802)가, 비 2를 탐지하려면 각각 19개(실제 검정력 0.816)가 필요하다고 계산합니다. 검정력 90%에서는 기계당 66개와 24개로 늘어납니다. 기계당 부품 20개로 시험하면 비 1.5에 대한 검정력은 0.402에 불과하므로, 그러한 시험에서 유의하지 않은 결과가 나와도 알 수 있는 것이 거의 없습니다. 기존 기계가 더 나쁜지만 알고 싶다면(대립가설 σ1/σ2 > 1) 비 1.5에서 검정력 80%에 기계당 부품 40개가 필요합니다.
자주 묻는 질문
산포의 차이를 표준편차의 비로 입력하는 이유는 무엇입니까?
2-분산 F 검정은 F = S1의 제곱을 S2의 제곱으로 나눈 값을 사용합니다. 표준편차의 참 비가 r이면 F는 자유도 (n - 1, n - 1)인 F 변수의 r 제곱배이므로 비만 중요합니다. 비 sigma1/sigma2를 입력하면 되고 표준편차 자체는 필요하지 않습니다.
두 분산을 비교하려면 표본이 몇 개 필요합니까?
신뢰수준 95% 양측인 계산 예제에서 표준편차 비 1.5를 탐지하려면 검정력 80%에 기계당 부품 50개, 90%에 66개가 필요하고, 비 2는 각각 19개와 24개가 필요합니다. 기계당 부품 20개의 시험은 비 1.5에서 검정력이 0.402에 불과하므로 유의하지 않은 결과가 나와도 알 수 있는 것이 거의 없습니다.
비와 그 역수는 똑같이 취급합니까?
양측 검정에서는 그렇습니다. 두 집단의 크기가 같으므로 비 r과 비 1/r은 같은 결과를 줍니다. 1.5와 0.667 모두 검정력 80%에 집단당 50개가 필요합니다. 단측 대립가설에서는 도구가 less-than 대립가설에서는 1보다 작은 쪽을, 그 외에는 1보다 큰 쪽을 탐색합니다.
2-분산 검정력 계산의 가정은 무엇입니까?
두 집단이 정규 모집단에서 나왔고 표본 크기가 같다고 가정합니다. F 검정은 정규성에서 벗어나면 민감하므로 검정을 실행할 때 데이터의 형태를 확인하십시오. 한 방향만 중요하다면 단측 대립가설은 더 적은 단위가 필요합니다. 계산 예제에서 비 1.5에서 검정력 80%에 기계당 부품 40개가 필요합니다.