
일원배치 분산분석 검정력 및 표본 크기(Power and Sample Size for One-Way ANOVA)
여러 집단의 평균을 비교하는 일원배치 분산분석을 계획합니다. 수준의 수, 공통 표준편차, 그리고 수준당 표본 크기, 평균 간 최대 차이, 검정력 중 두 가지를 입력하면 도구가 나머지 하나를 구합니다. 집단이 정규분포를 따르고 표준편차가 같으며 균형 설계라고 가정하고, 평균의 가장 불리한 배열을 사용하므로 결과는 보수적입니다.
최종 검토
핵심 요점
일원배치 분산분석 검정력 및 표본 크기는 세 개 이상의 집단 평균 간 주어진 최대 차이를 탐지하는 데 집단마다 몇 개의 단위가 필요한지, 계획한 설계의 검정력, 또는 탐지 가능한 차이를 계산합니다.
목적
일원배치 분산분석 검정력 및 표본 크기는 여러 가열로, 공급업체, 작업자, 배합처럼 세 개 이상 집단의 평균 비교를 계획합니다. 효과의 크기는 탐지하려는 임의의 두 집단 평균 간 최대 차이로 입력합니다. 수준당 표본 크기, 최대 차이, 검정력 중 두 가지를 입력하면 도구가 나머지 하나를 구합니다. 즉 집단마다 몇 개의 단위가 필요한지, 계획한 설계가 어느 정도의 검정력을 주는지, 또는 주어진 설계가 탐지할 수 있는 최대와 최소 간의 가장 큰 차이가 얼마인지를 구합니다. 일원배치 분산분석에 앞서 사용합니다.
주요 기능
- 표본 크기, 검정력 또는 최대 차이를 구합니다. 구하려는 항목을 비워 두십시오.
- 최대 차이 “1.5 2”와 검정력 값 “0.8 0.9”처럼 여러 값을 한 번에 입력하면 조합마다 한 행이 생성됩니다.
- 수준은 2개 이상 임의의 수를 사용할 수 있으며, 균형 설계(모든 수준에서 표본 크기가 같음)를 사용합니다.
- 표본 크기를 구할 때 수준당 정수 값과 그것이 주는 실제 검정력을 보고합니다.
- 각 최대 차이에 대한 수준당 표본 크기 대비 검정력 곡선이며, 구한 점이 표시됩니다.
통계적 방법
계산은 공통 표준편차 σ를 갖는 정규 모집단에서 나온 k개의 독립 집단과 수준당 단위 n개(총 N = n·k)를 가정합니다. 유의수준은 α = 1 − 신뢰수준 / 100입니다. 최대 차이 Δ를 효과 크기로 바꾸기 위해, 도구는 Minitab과 마찬가지로 해당 Δ에서 검정력이 가장 낮아지는 평균의 배열을 사용합니다. 두 수준은 −Δ/2와 +Δ/2에, 나머지 k − 2개 수준은 총평균에 둡니다. 효과 크기는 f = σₘ/σ이며, σₘ은 이 k개 평균의 표준편차이므로 σₘ² = Δ²/(2k)입니다.
검정력은 분산분석 F 검정이 평균이 모두 같다는 가설을 기각할 확률입니다. 자유도 k − 1과 N − k, 비중심 모수 λ = f²·N인 비중심 F 분포로 계산합니다. 표본 크기는 목표 검정력을 주는 전체 N을 구한 뒤 k로 나누어 수준당 올림하며, 그 크기에서의 검정력이 실제 검정력으로 보고됩니다. 최대 차이는 목표 검정력에 도달하는 효과 크기를 구한 뒤 다시 Δ로 변환합니다.
이것은 가장 불리한 배열이므로 답은 보수적입니다. 평균이 더 넓게 퍼져 있으면(예: 양 극단에 각각 두 수준) 실제 검정력은 보고된 값보다 높아 더 적은 단위로도 충분합니다(계산 예제 참조). 수준이 두 개이면 배열은 하나뿐입니다.
입력 항목 및 옵션
항목 | 설명 |
Sample sizes | 수준당(균형 설계)입니다. 공백 또는 쉼표로 구분하며, 예: “10 20 30”. 표본 크기를 구하려면 비워 두십시오. |
Maximum difference between means | 공백 또는 쉼표로 구분하며, 예: “1 2 3”. 탐지하려는 가장 큰 평균과 가장 작은 평균 간의 차이입니다. 차이를 구하려면 비워 두십시오. |
Power values | 공백 또는 쉼표로 구분하며, 예: “0.8 0.9”. 검정력을 구하려면 비워 두십시오. |
Standard deviation | 필수. 모든 수준에 동일한, 가정했거나 과거의 공통 표준편차입니다. |
Number of levels | 필수이며 2 이상입니다. 비교하는 집단의 수입니다. |
Confidence level | 기본값 95(α = 0.05), 범위 75~100. |
Power curve | 기본으로 선택되어 있으며, 수준당 표본 크기 대비 검정력을 그립니다. |
Title | 출력과 검정력 곡선에 표시되는 제목입니다. |
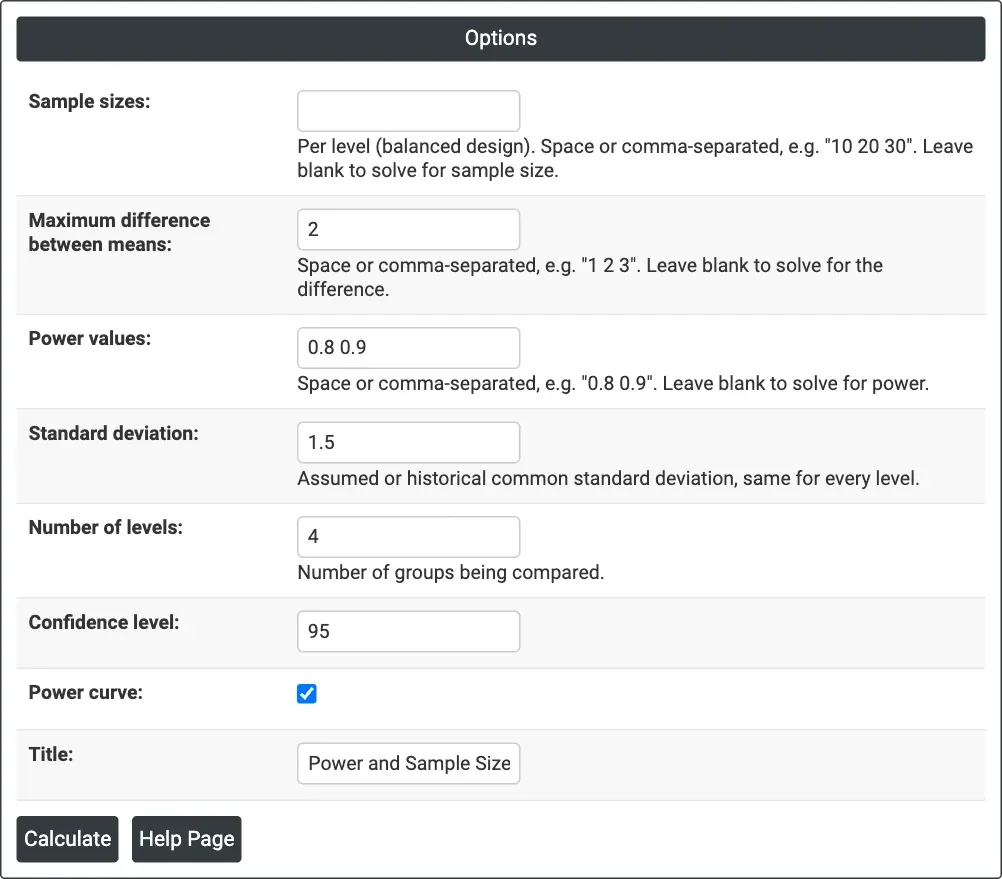
그림 1 — 표본 크기 구하기: Maximum difference between means = 2, Power values = 0.8 0.9, Standard deviation = 1.5, Number of levels = 4, 신뢰수준 95%.
출력 설명
- Settings — 구한 항목, 수준의 수, 표준편차, 신뢰수준.
- Results — 조합마다 한 행: 최대 차이, 수준당 표본 크기, 그리고 표본 크기를 구할 때는 목표 검정력과 실제 검정력, 검정력을 구할 때는 검정력, 최대 차이를 구할 때는 최대 차이.
- Power Curve — 각 최대 차이에 대한 수준당 표본 크기 대비 검정력이며, 계산된 점이 표시됩니다.
- Download를 통한 PDF 내보내기.
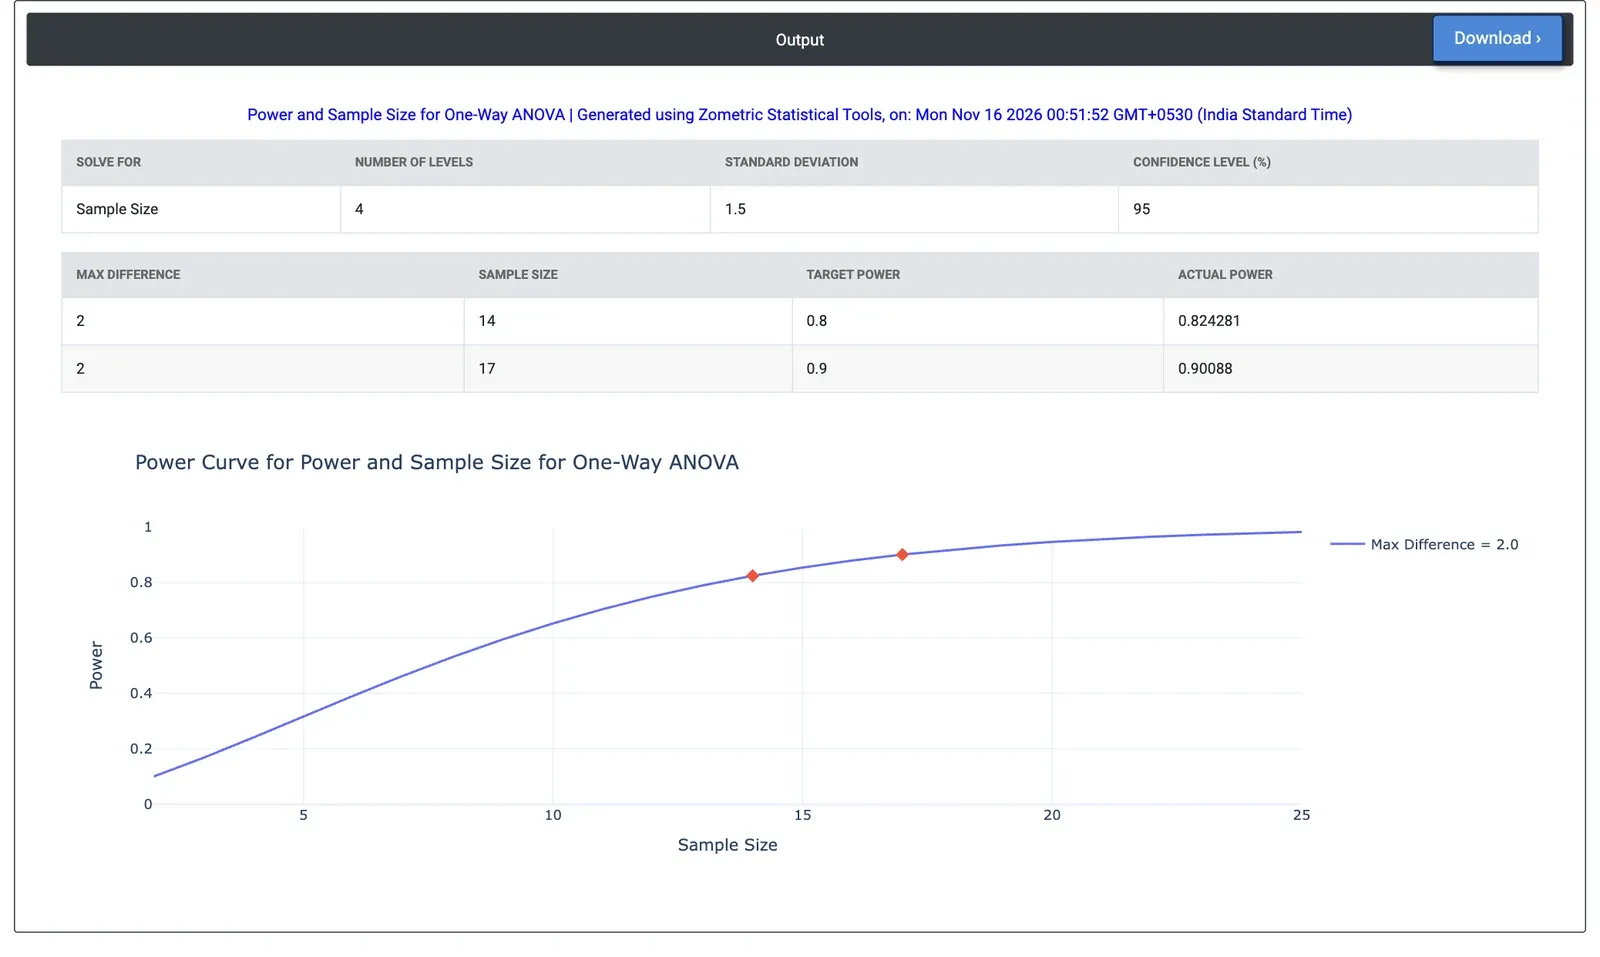
그림 2 — 예제의 결과: 검정력 80%(실제 0.824)에 가열로당 부품 14개, 검정력 90%(실제 0.901)에 17개.
계산 예제
한 열처리 공장이 가열로 4기를 운영하며 가열로들이 평균 표면 경도가 같은지 확인하고자 합니다. 가장 좋은 가열로와 가장 나쁜 가열로 간 2 HRC의 차이는 중요하며, 가열로 내 경도의 표준편차는 약 1.5 HRC입니다. 금속 공학자는 Sample sizes를 비워 두고 Maximum difference between means = 2, Power values = 0.8 0.9, Standard deviation = 1.5, Number of levels = 4를 신뢰수준 95%에서 입력합니다.
도구는 검정력 80%(실제 검정력 0.824)에 가열로당 부품 14개, 검정력 90%(실제 검정력 0.901)에 가열로당 17개가 필요하다고 알려 주며, 총 56개와 68개입니다. 가열로당 부품이 8개이면 검정력은 0.532에 불과하고, 5개이면 0.317입니다. 가열로당 부품 14개와 검정력 80%에서 연구가 탐지할 수 있는 최소 최대 차이는 1.94 HRC입니다. 이 수치는 가장 불리한 패턴, 즉 한 가열로는 높고 한 가열로는 낮고 나머지 두 가열로는 중간인 경우를 가정합니다. 대신 각 극단에 가열로가 두 기씩 있다면 가열로당 부품 8개만으로도 검정력이 이미 0.852가 되므로, 이 계획은 안전한 쪽으로 치우칩니다.
자주 묻는 질문
일원배치 분산분석의 검정력은 어떻게 계산합니까?
검정력은 분산분석 F 검정이 평균이 모두 같다는 가설을 기각할 확률입니다. 자유도 k - 1과 N - k의 비중심 F 분포로 계산합니다. 최대 차이는 평균의 가장 불리한 배열, 즉 두 수준은 차이의 절반만큼 아래와 위에, 나머지 수준은 총평균에 두는 배열을 사용하여 효과 크기로 변환합니다.
일원배치 분산분석의 표본 크기가 보수적인 이유는 무엇입니까?
도구는 입력한 최대 차이에서 검정력이 가장 낮아지는 집단 평균의 배열을 가정합니다. 평균이 더 넓게 퍼져 있으면(예: 양 극단에 각각 두 수준) 실제 검정력은 보고된 값보다 높아 더 적은 단위로도 충분합니다. 계산 예제에서는 이 더 유리한 패턴에서 가열로당 부품 8개로 검정력 0.852가 됩니다.
일원배치 분산분석에는 집단당 표본이 몇 개 필요합니까?
가열로 4기, 표준편차 1.5 HRC, 최대 차이 2 HRC, 신뢰수준 95%인 계산 예제에서는 가열로당 부품 14개가 검정력 80%를, 17개가 90%를 주며, 총 56개와 68개입니다. 가열로당 부품이 8개이면 검정력은 0.532이고, 5개이면 0.317입니다.
일원배치 분산분석 검정력 계산의 가정은 무엇입니까?
공통 표준편차를 갖는 정규 모집단에서 나온 k개의 독립 집단과, 모든 수준에서 표본 크기가 같은 균형 설계를 가정합니다. 수준의 수는 2 이상이어야 하고 표준편차는 필수이며, 일반적으로 과거 데이터에서 얻습니다. 수준이 두 개이면 평균의 가능한 배열은 하나뿐입니다.