
확률 분포 그림(Probability Distribution Plot)
확률 분포 그림은 데이터 없이 입력한 모수로 이론적 분포의 밀도, 질량 또는 누적 곡선을 그립니다. 정규, t, 카이제곱, F, Weibull, 로그정규, 이항, 포아송을 포함한 12개 분포를 지원합니다. 분포의 형태를 확인하거나, 샘플링 계획이나 검정 통계량을 설명하거나, 확률을 읽어 낼 때 사용합니다. 연속형 분포는 곡선으로, 이항과 포아송은 막대로 표시됩니다.
최종 검토
핵심 요점
확률 분포 그림은 데이터 없이 입력한 모수만으로 정규, Weibull, 이항 등 이론적 분포의 확률 밀도(또는 질량) 곡선이나 누적 분포 곡선을 그립니다.
목적
확률 분포 그림은 입력한 모수에 대해 이론적 분포의 곡선, 즉 확률 밀도(개수의 경우 확률 질량) 또는 누적 분포를 그립니다. 데이터는 필요하지 않습니다. 분포를 사용하기 전에 어떤 모양인지 확인하거나, 샘플링 계획이나 검정 통계량을 설명하거나, 가정한 모형에서 어떤 개수나 측정값이 얼마나 일어날 가능성이 있는지 읽어 낼 때 사용합니다. 예를 들어 공정의 불량률이 4%일 때 표본 50개에 포함된 불량품의 수를 볼 수 있습니다.
주요 기능
- 12개 분포: 정규, Student의 t, 카이제곱, F, 지수, Weibull, 로그정규, 균일, 감마, 베타, 이항, 포아송.
- 확률 밀도/질량 함수 또는 누적 분포 함수.
- 연속형 분포는 매끄러운 곡선으로 그리고(밀도 아래는 음영 처리), 이항과 포아송은 정수마다 막대로 그립니다.
- 가로 범위는 분포의 0.05번째 백분위수부터 99.95번째 백분위수까지를 포함하도록 자동으로 선택됩니다.
- 분포와 곡선으로부터 생성되는 제목 또는 사용자가 지정한 제목.
통계적 방법
도구는 모수로부터 선택한 분포를 구성하고 표준 공식으로 계산합니다. 모수는 다음과 같습니다. 정규 — Parameter 1 = 평균, Parameter 2 = 표준편차; Student의 t와 카이제곱 — 자유도; F — 분자와 분모 자유도; 지수 — 척도(평균); Weibull과 감마 — 형상과 척도; 로그정규 — 위치와 형상, 즉 ln(X)의 평균과 표준편차; 균일 — 하한과 상한; 베타 — 두 형상 모수 α와 β; 이항 — 시행 횟수 n과 사건 확률 p; 포아송 — 평균 λ. 모수가 하나인 분포는 Parameter 1만 사용합니다.
연속형 분포의 경우 곡선은 0.05번째와 99.95번째 백분위수 사이의 500개 등간격 점에서 계산됩니다. 이항과 포아송의 경우 해당 범위의 모든 정수에서 계산되며, 확률 질량 P(X = k)는 각 막대의 높이를, 누적 함수 P(X ≤ k)는 CDF 그림에서 각 막대의 높이를 나타냅니다. 밀도의 경우 구간 위의 곡선 아래 면적이 그 구간에 속할 확률이며, CDF는 이 확률을 두 높이의 차이로 직접 보여 줍니다.
입력 항목 및 옵션
항목 | 설명 |
Distribution | 필수 항목입니다. Normal, Student's t, Chi-Square, F, Exponential, Weibull, Lognormal, Uniform, Gamma, Beta, Binomial 또는 Poisson. |
Parameter 1 | 의미는 분포에 따라 달라집니다. 예: Normal은 평균, t와 Chi-Square는 자유도, Weibull과 Gamma는 형상, Binomial은 시행 횟수, Poisson은 평균. |
Parameter 2 | 모수가 두 개인 분포에서만 사용합니다. 예: Normal은 표준편차, Weibull과 Gamma는 척도, Binomial은 사건 확률. |
Plot | Probability density/mass function(기본값) 또는 Cumulative distribution function. |
Title | 선택 사항입니다. 기본값은 선택한 분포와 곡선으로부터 생성된 제목입니다. |
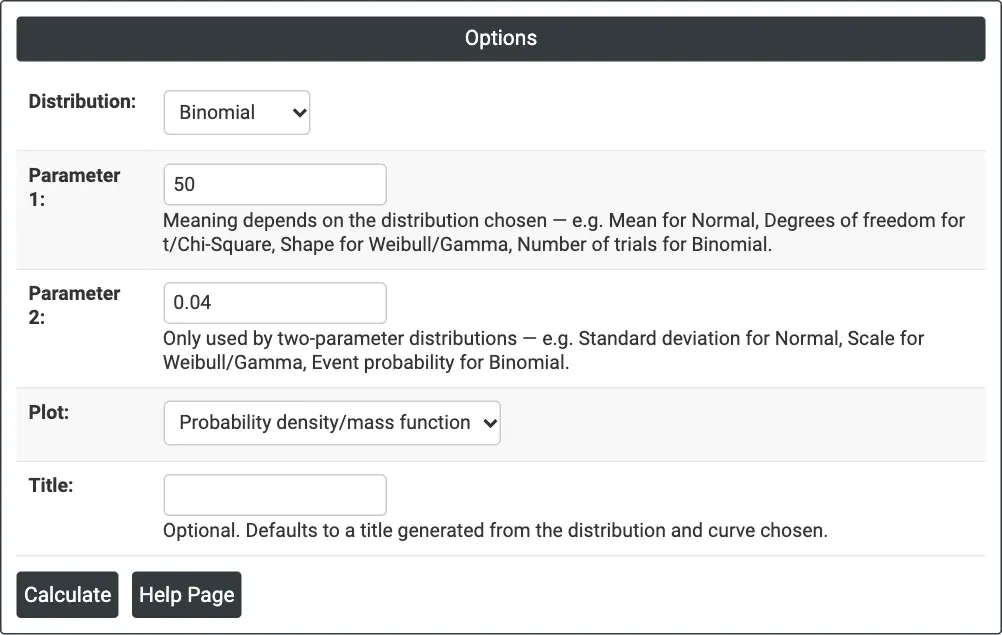
그림 1 — 예제의 옵션: 시행 50회, 사건 확률 0.04인 이항 분포.
출력 설명
- <Distribution> Distribution — Probability Density: 밀도 곡선(축 레이블은 Probability density). 이항과 포아송은 <Distribution> Distribution — Probability Mass이며, 각 개수의 확률을 막대로 나타냅니다(축 레이블은 Probability).
- <Distribution> Distribution — Cumulative Distribution: 누적 확률 P(X ≤ x).
- Download를 통한 PDF 내보내기.
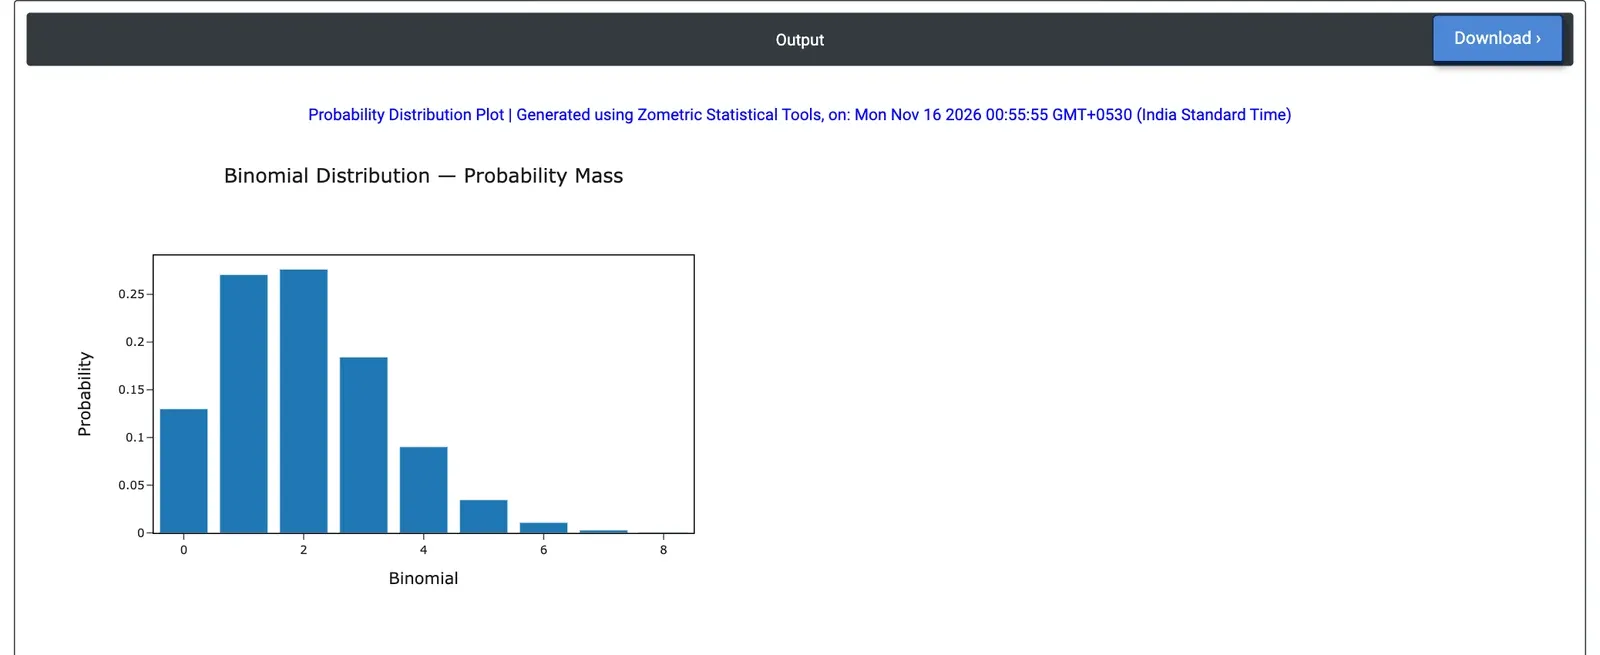
그림 2 — 공정의 불량률이 4%일 때 표본 50개에서 불량품이 0~8개일 확률(이항, n = 50, p = 0.04).
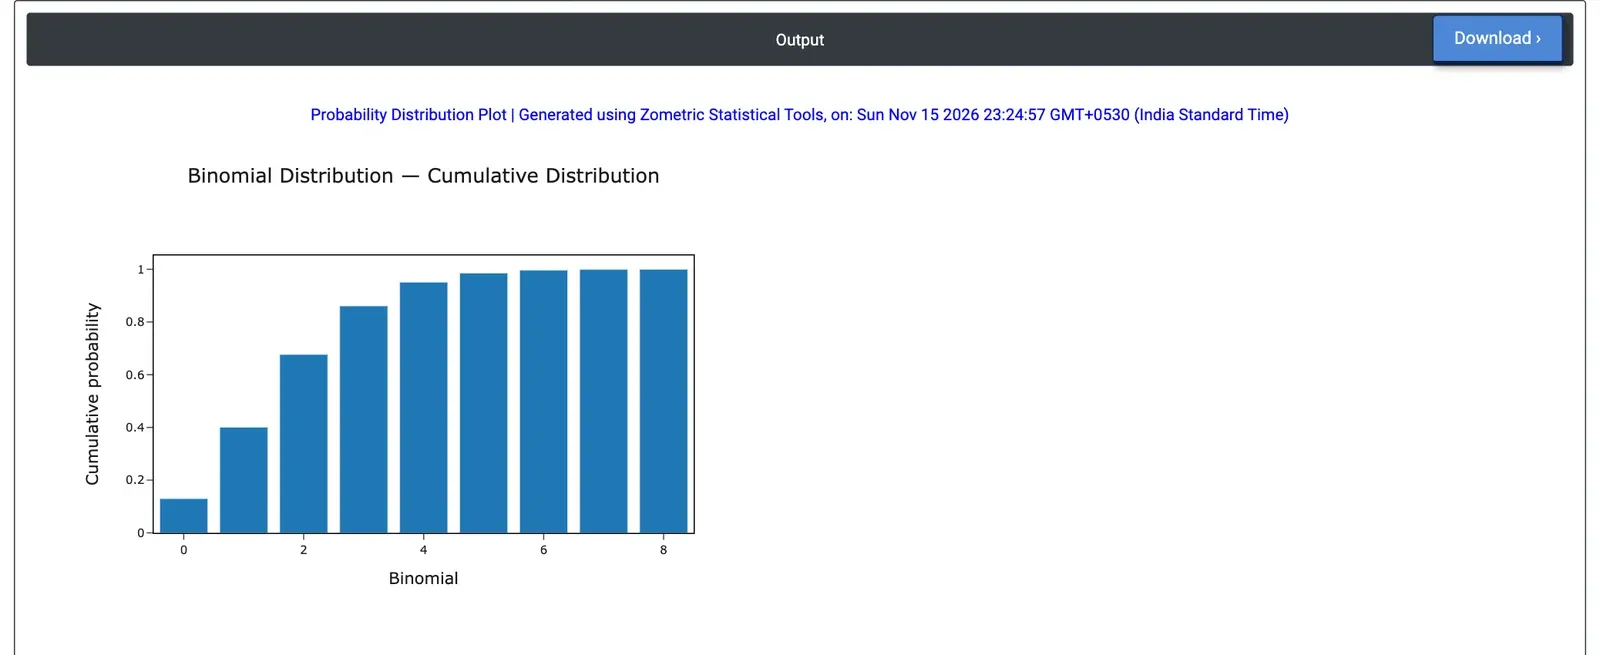
그림 3 — 같은 분포에 Plot = Cumulative distribution function을 적용: k = 0~8에 대한 P(X ≤ k).
계산 예제
한 공급업체의 공정은 불량률이 약 4%입니다. 수입 검사에서는 로트마다 부품 50개를 표본 추출하며, 품질 엔지니어는 불량품이 몇 개 나올 것으로 예상되는지, 그리고 이 공정의 로트에서 3개 이상이 나오는 빈도가 어느 정도인지 알고자 합니다. Distribution = Binomial, Parameter 1 = 50(시행 횟수), Parameter 2 = 0.04(사건 확률), Plot = Probability density/mass function으로 설정합니다.
막대는 불량품 0개에서 8개까지 이어집니다. 가장 가능성이 높은 개수는 1개(확률 0.271)와 2개(0.276)로, n·p = 2인 평균과 일치합니다. 불량품이 없는 표본은 13.0%의 비율로 나타나므로, 불량품이 없는 표본은 공정이 개선되었는지에 대해 알려 주는 바가 거의 없습니다. Plot을 Cumulative distribution function으로 바꾸면 P(X ≤ 2) = 0.677이므로, 이 공정에서 추출한 표본의 32.3%에는 불량품이 3개 이상, 13.9%에는 4개 이상 들어 있을 것입니다.
검사 계획 측면에서 이는 합격 판정 개수 2가 공급업체가 평소의 4%로 가동 중일 때도 로트 3개 중 약 1개를 불합격시킨다는 뜻입니다. 이런 로트가 대체로 합격해야 한다면 합격 판정 개수를 높이거나 샘플링 계획을 다시 설계해야 합니다. 합격 표본 추출과 AQL 도구가 합의된 품질 수준에 맞추어 이를 계산합니다.
자주 묻는 질문
확률 분포 그림은 무엇에 사용합니까?
데이터 없이 주어진 모수에서 이론적 분포가 어떤 모양인지 보여 줍니다. 분포를 사용하기 전에 형태를 확인하거나, 샘플링 계획이나 검정 통계량을 설명하거나, 불량률이 4%인 공정에서 표본 50개에 포함된 불량품 수처럼 가정한 모형에서 어떤 개수나 측정값이 얼마나 일어날 가능성이 있는지 읽어 낼 때 사용합니다.
확률 분포 그림은 어떤 분포를 보여 줄 수 있습니까?
12개입니다: 정규, Student의 t, 카이제곱, F, 지수, Weibull, 로그정규, 균일, 감마, 베타, 이항, 포아송. Parameter 1과 Parameter 2는 분포에 따라 달라집니다. 예를 들어 정규는 평균과 표준편차, Weibull과 감마는 형상과 척도, 이항은 시행 횟수와 사건 확률입니다. 모수가 하나인 분포는 Parameter 1만 사용합니다.
PDF 그림과 CDF 그림은 어떻게 다릅니까?
확률 밀도(또는 질량) 함수는 각 값에서 분포의 높이를 보여 줍니다. 밀도의 경우 구간 위의 곡선 아래 면적이 그 구간에 속할 확률이고, 이항이나 포아송의 경우 각 막대는 P(X = k)입니다. 누적 분포 함수는 P(X ≤ x)를 보여 주므로 확률은 두 높이의 차이가 됩니다.
이항 확률 분포 그림은 어떻게 읽습니까?
시행 50회, 사건 확률 0.04인 계산 예제에서 가장 가능성이 높은 개수는 1개(0.271)와 2개(0.276)로 n × p = 2인 평균과 일치하며, 불량품이 0개인 경우는 13.0%의 비율로 나타납니다. 누적 그림은 P(X ≤ 2) = 0.677을 보여 주므로 표본의 32.3%에는 불량품이 3개 이상 들어 있을 것입니다.