
확률도(Probability Plot)
확률도는 정렬된 값을 분포가 직선으로 나타나는 척도에 신뢰 한계와 함께 타점하여 데이터가 분포에 적합한지 검정합니다. 정규, 로그정규, Weibull, 지수를 포함한 아홉 가지 분포를 지원하며, 각각에 대해 Anderson-Darling 통계량과 p-값을 보고합니다. 정규성을 가정하는 공정능력 분석, 관리 한계, t 검정 전에 사용하고, 신뢰성 분포를 선택하는 데도 사용합니다.
최종 검토
핵심 요점
확률도는 정렬된 데이터를 선택한 분포가 직선으로 나타나는 척도에 타점하여, 데이터가 선택한 분포(가장 흔히 정규분포)를 따르는지 Anderson-Darling 통계량 및 p-값과 함께 확인합니다.
목적
확률도는 데이터가 선택한 분포, 가장 흔히 정규분포를 따르는지 확인합니다. 정렬된 데이터를 선택한 분포가 직선으로 나타나는 척도에 타점하며, 점이 직선을 따르면 그 분포가 적합합니다. 정규성을 가정하는 공정능력 분석, 관리 한계, 허용 구간, t 검정 전에 사용하고, 신뢰성이나 비정규 공정능력 작업을 위한 분포(Weibull, 로그정규, 지수)를 선택하는 데도 사용합니다.
주요 기능
- 아홉 가지 분포: 정규, 로그정규, Weibull, 지수, 2모수 지수, 최소 극값, 최대 극값, 로지스틱, 로그 로지스틱.
- 선택한 수준(기본값 95%)의 점별 신뢰 한계가 있는 적합 기준선.
- 모든 분포에 대해 범례에 Anderson-Darling(AD) 통계량과 그 p-값이 표시되므로 적합도를 비교할 수 있습니다.
- 여러 변수를 하나의 그림에 겹쳐 표시하거나, 하나의 변수를 By 열로 집단별로 나누어 각각 고유한 적합선을 표시합니다.
- 표준 확률 용지와 같이 로그정규, Weibull, 로그 로지스틱에는 로그 데이터 축을 사용합니다.
통계적 방법
각 변수 또는 집단(값 3개 이상)마다 데이터를 x₍₁₎ ≤ … ≤ x₍ₙ₎로 정렬하고, 각 값에 Benard의 중앙 순위 근사인 타점 위치 pᵢ = (i − 0.3) / (n + 0.4)를 부여합니다. 세로축은 선택한 분포의 역누적분포함수이며 백분율로 표시되므로, 그 분포에서 나온 표본은 직선에 가깝게 놓입니다. 기준선은 적합된 누적분포함수입니다. 정규분포에서는 표본 평균과 표준편차(n − 1로 나눔)를, 그 밖의 분포에서는 최대우도법을 사용하며, 로그정규, Weibull, 지수, 로그 로지스틱에서는 문턱값을 0으로 고정합니다(이들은 양수 값이 필요합니다).
신뢰 한계는 각 점을 지나도록 그려집니다. 수준 C에서 하한은 Beta(i, n − i + 1) 분포의 α/2 분위수이고 상한은 Beta(i + 1, n − i) 분포의 1 − α/2 분위수이며, α = 1 − C/100입니다. 한계를 벗어난 점은 그 분포에 불리한 증거입니다.
Anderson-Darling 통계량 AD = −n − (1/n) Σ (2i − 1)[ln F(x₍ᵢ₎) + ln(1 − F(x₍ₙ₊₁₋ᵢ₎))]는 꼬리에 추가 가중치를 두어 점이 적합된 누적분포함수 F에서 얼마나 떨어져 있는지 측정하며, 작을수록 좋습니다. 범례에는 Minitab과 마찬가지로 모든 분포에 대해 이 조정되지 않은 AD를 표시합니다. p-값은 D'Agostino와 Stephens의 방식에 따라 수정된 통계량에서 구합니다. 정규와 로그정규(로그 변환값 기준)는 AD·(1 + 0.75/n + 2.25/n²)을 Stephens의 근사로 변환하고, Weibull과 두 극값 분포는 AD·(1 + 0.2/√n), 지수는 AD·(1 + 0.6/n), 로지스틱과 로그 로지스틱은 AD·(1 + 0.25/n)을 사용합니다. 마지막 세 가지는 Stephens의 임계값 표에서 찾아 보간하므로, 표를 벗어나는 p-값은 >0.250 또는 <0.010과 같이 한계로 표시됩니다. 2모수 지수에서는 n − 1개의 간격 x₍ᵢ₎ − x₍₁₎를 지수분포로 검정합니다. p-값이 0.05 미만이면 데이터가 그 분포를 따르지 않는다는 증거이며, 분포 간에는 p-값이 클수록 보통 더 잘 적합한 것입니다.
입력 항목 및 옵션
항목 | 설명 |
Variables | 필수입니다. 숫자 열 하나, 또는 겹쳐 표시할 여러 열(“Multiple” 확률도)입니다. |
By (grouping) column | 선택 사항입니다. 집단마다 하나의 적합선을 표시합니다. 변수를 하나만 선택했을 때만 사용합니다. |
Distribution | Normal(기본값), Lognormal, Weibull, Exponential, 2-Parameter Exponential, Smallest Extreme Value, Largest Extreme Value, Logistic 또는 Loglogistic입니다. |
Confidence level (%) | 기본값은 95이며, 1~99.99입니다. 신뢰 한계의 수준입니다. |
Display confidence interval bounds | 기본적으로 선택되어 있습니다. 한계를 점선으로 그립니다. |
Title | 그림의 제목입니다. 기본값은 “Probability Plot”입니다. |
Data Options: Subset (optional) | Exclude matching rows(기본값) 또는 Include only matching rows입니다. Row numbers(예: 3,7,12-15)와 Condition(예: Tensile_Strength_MPa > 205) 중 하나 또는 둘 다로 행을 선택합니다. |
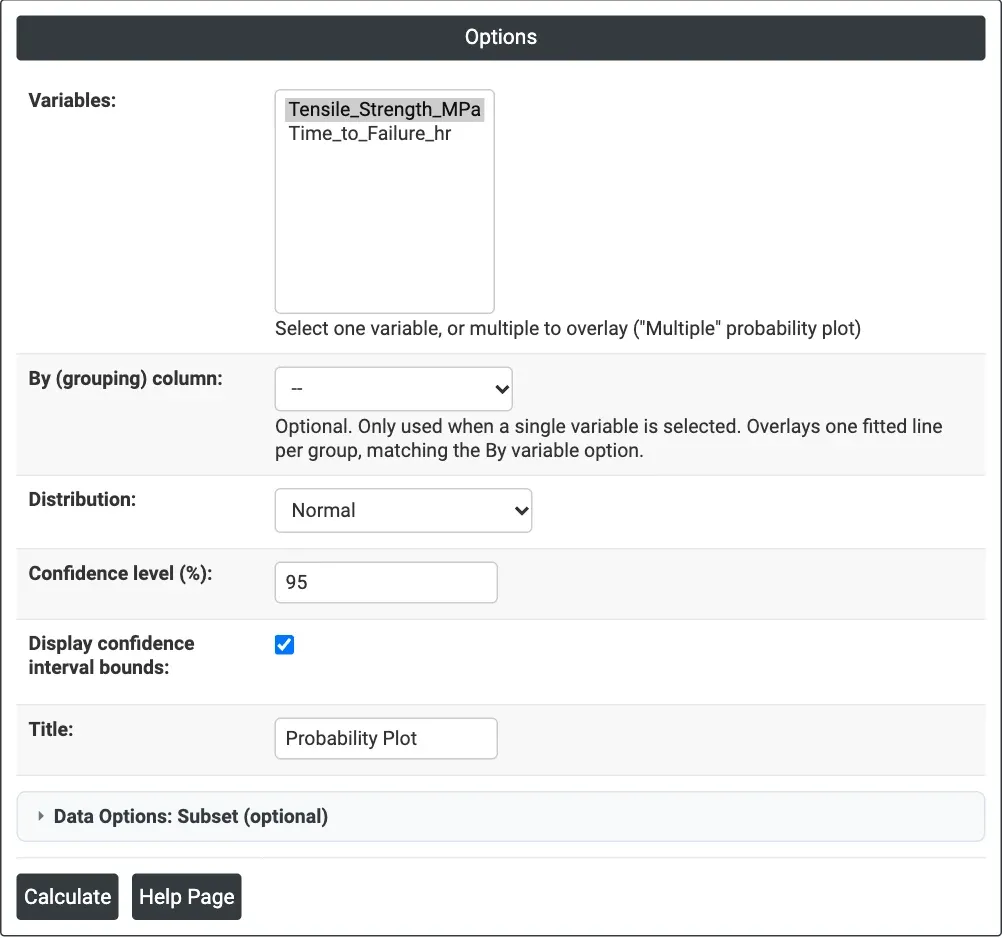
그림 1 — 예제의 옵션: 95% 한계가 있는 Normal 확률도의 Tensile_Strength_MPa.
출력 설명
- Probability Plot — 분포의 확률 척도에서 데이터(가로축)와 백분율의 관계이며, 적합선과 점선 신뢰 한계가 표시됩니다. 범례에는 각 계열의 AD 통계량과 p-값이 표시됩니다.
- Download를 통한 PDF 내보내기.
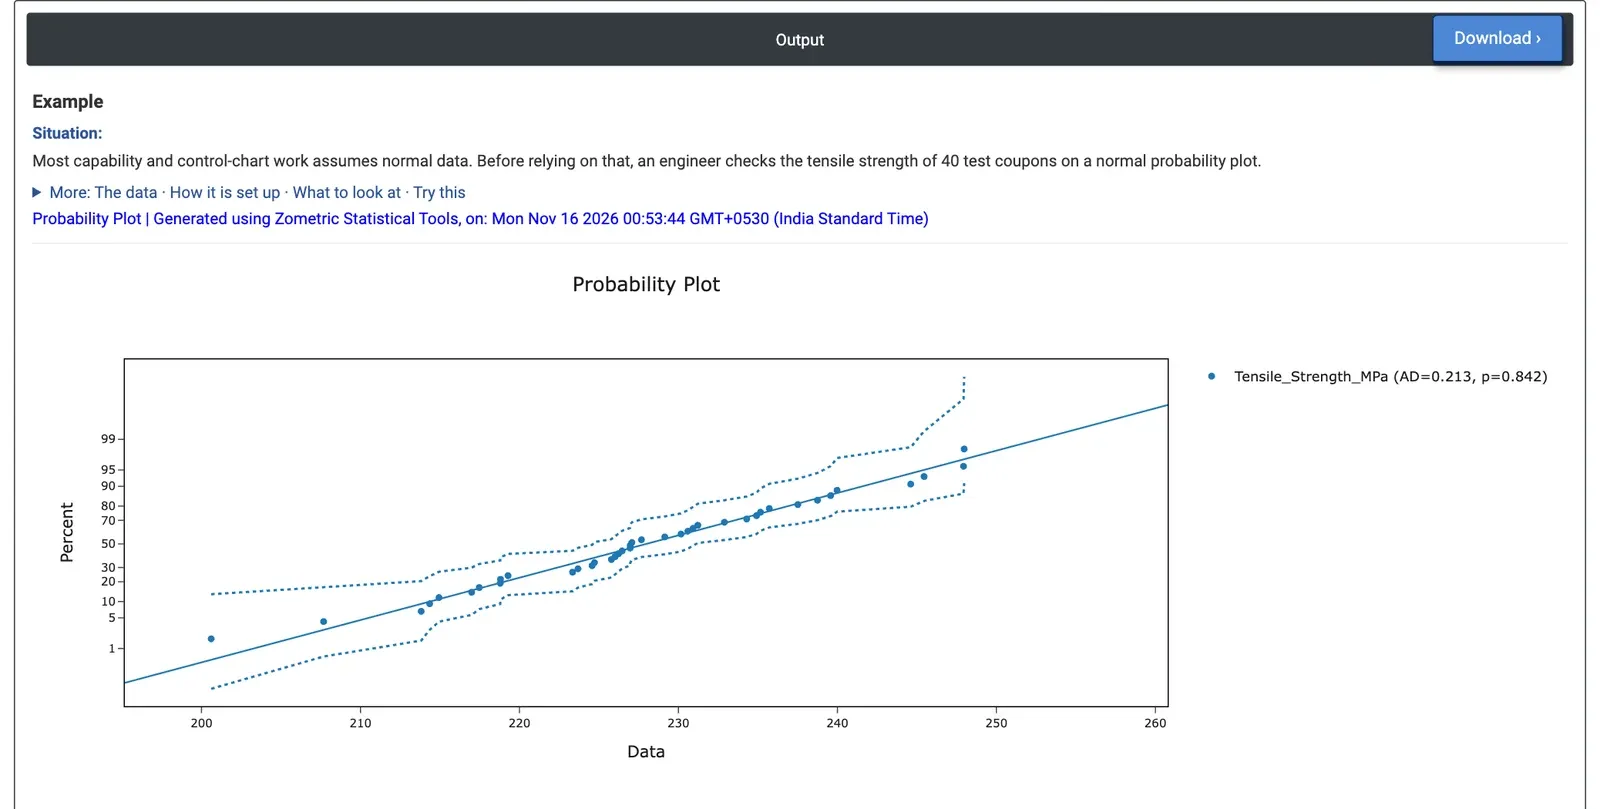
그림 2 — 시험편 40개의 인장 강도 정규 확률도: AD = 0.213, p = 0.842.
계산 예제
관리 한계를 설정하고 공정능력을 계산하기 전에, 엔지니어는 시험편 40개의 인장 강도를 정규분포로 볼 수 있는지 확인합니다. Variables = Tensile_Strength_MPa, Distribution = Normal, Confidence level 95로 하고 한계를 표시합니다.
점들이 200.61에서 247.97 MPa까지 전 범위에서 직선을 따르며 점선 한계 안에 머뭅니다. 범례에는 AD = 0.213, p = 0.842로 0.05를 훨씬 웃돌아, 정규성에 불리한 증거가 없습니다. 적합선의 평균은 227.97 MPa, 표준편차는 10.61 MPa이므로 정규분포 기반의 공정능력 및 관리도 방법을 사용할 수 있습니다. 어느 한쪽 끝에서 점이 선에서 휘어졌다면 치우치거나 꼬리가 두꺼운 분포를 시사했을 것입니다.
같은 워크시트에는 고장까지의 시간(시간 단위) 40개가 있습니다. Time_to_Failure_hr를 여러 분포에 대해 타점하면 Weibull은 AD = 0.210, p > 0.250(형상 3.23, 척도 192.96시간), 정규는 AD = 0.158, p = 0.947, 로그정규는 AD = 1.228, p < 0.005, 지수는 AD = 7.628, p < 0.010입니다. 일정한 고장률을 가정하는 지수분포는 분명히 적합하지 않으며 로그정규도 마찬가지입니다. Weibull과 정규는 모두 잘 적합하며, 고장 시간에는 보통 Weibull을 선택합니다. 1을 넘는 형상 모수가 마모를 설명하고 음의 수명을 예측할 수 없기 때문입니다.
자주 묻는 질문
확률도는 어떻게 해석합니까?
점이 적합된 직선을 따르고 신뢰 한계 안에 머무르면 그 분포가 적합합니다. 한계를 벗어난 점은 그 분포에 불리한 증거이며, 어느 한쪽 끝에서 점이 선에서 휘어지면 치우치거나 꼬리가 두꺼운 분포를 시사합니다. 범례에는 Anderson-Darling 통계량과 p-값이 표시되며, p-값이 0.05 미만이면 데이터가 그 분포를 따르지 않는다는 증거입니다.
확률도는 언제 사용합니까?
정규 데이터를 가정하는 공정능력 분석, 관리 한계, 허용 구간, t 검정 전에 정규성을 확인하는 데 사용합니다. 신뢰성이나 비정규 공정능력 작업을 위한 Weibull, 로그정규, 지수와 같은 분포를 선택하는 데도 사용합니다. 각 변수 또는 집단에는 값이 3개 이상 필요하며, 여러 변수나 집단을 겹쳐 표시할 수 있습니다.
확률도에서 분포들을 어떻게 비교합니까?
같은 데이터를 여러 분포에 대해 타점하여 Anderson-Darling 통계량과 p-값을 비교하며, AD가 작고 p-값이 클수록 보통 더 잘 적합한 것입니다. 고장 시간 40개에 대한 계산 예제에서 Weibull(p > 0.250)과 정규(p = 0.947)는 잘 적합하지만, 로그정규와 지수(p < 0.010)는 적합하지 않습니다.
확률도로 어떤 분포를 검정할 수 있습니까?
아홉 가지입니다. 정규, 로그정규, Weibull, 지수, 2모수 지수, 최소 극값, 최대 극값, 로지스틱, 로그 로지스틱. 로그정규, Weibull, 지수, 로그 로지스틱은 양수 값이 필요하며, 로그정규, Weibull, 로그 로지스틱은 표준 확률 용지와 같이 로그 데이터 축을 사용합니다.