
난수 데이터(Random Data)
Random Data는 Normal, Lognormal, Weibull, Triangular, Binomial, Poisson, Multivariate Normal 등 26가지 분포 중 하나에서 최대 10개의 독립 열에 10~10,000개 행을 생성합니다. 값은 고정 시드 없이 추출되므로 실행할 때마다 새로운 숫자가 나옵니다. 선택 사항인 반올림과 히스토그램, Anderson-Darling 정규성 검정, 신뢰구간, 확률도를 포함한 그래픽 요약이 생성된 데이터를 설명합니다.
최종 검토
핵심 요점
Random Data는 26가지 연속형, 이산형 또는 다변량 정규분포 중 하나에서 난수를 생성해 데이터 창에 넣으며, 교육용 데이터, 시뮬레이션, 가정 분석, 표본 변동 확인에 사용합니다.
목적
Random Data는 26가지 분포 중 하나에서 난수를 생성하여 데이터 창에 넣으며, 복사하거나 다른 도구에서 바로 사용할 수 있습니다. 교육용 연습 데이터를 만들거나, 알려진 공정에서 추출한 표본이 얼마나 변동하는지 확인하거나(완벽한 정규 공정에서 추출한 30개 값의 히스토그램은 좀처럼 종 모양이 되지 않습니다), 실제 데이터가 도착하기 전에 분석을 시험해 보거나, 삼각 추정치에서 얻은 사이클 타임이나 Weibull 모형에서 얻은 고장 시간처럼 가정 분석을 위해 공정을 시뮬레이션할 때 사용합니다. 선택 사항인 그래픽 요약은 생성한 숫자를 설명합니다.
주요 기능
- 하나의 Distribution 목록에 26가지 분포가 있습니다. 연속형(Normal, Lognormal, Weibull, Exponential, Gamma, Uniform, Triangular 등), 이산형(Binomial, Poisson, Geometric, Hypergeometric, Integer, Discrete 등), Multivariate Normal입니다.
- 선택한 분포의 모수 입력란만 표시됩니다.
- 10~10,000개 행과 1~10개의 독립 열(data_1, data_2, …).
- 지정한 소수 자릿수로 선택적 반올림.
- 생성된 모든 값에 대한 선택적 그래픽 요약: 히스토그램, 요약 통계량, Anderson-Darling 정규성 검정, 신뢰구간, 확률도.
- Multivariate Normal: 평균 벡터와 공분산 행렬로부터 상관된 열을 생성하며, 확인용으로 표본 상관 행렬과 공분산 행렬을 제공합니다.
통계적 방법
값은 NumPy와 SciPy 난수 생성기로 고정 시드 없이 독립적으로 추출되므로 Calculate를 누를 때마다 새로운 숫자가 나옵니다. 각 열은 동일한 분포에서 선택한 크기만큼 추출한 별도의 표본입니다. 모수는 일반적인 정의를 따릅니다. 예를 들어 Normal(평균 μ, 표준편차 σ), Weibull(형상 β, 척도 η, 모든 값에 더해지는 선택적 임계값), Exponential(척도 = 평균, 선택적 임계값), Integer(Minimum부터 Maximum까지의 정수, 양 끝 포함), Geometric(첫 사건까지 포함한 시행 횟수), Negative Binomial(필요한 사건 수에 도달하기 전의 비사건 수)입니다. Lognormal에서는 데이터 자체의 평균과 표준편차를 입력하며, 도구가 이를 로그 척도 모수 σ = √ln(1 + (s/m)²)와 μ = ln(m) − σ²/2로 변환합니다. Discrete에서는 확률의 합이 1이 되도록 재조정됩니다.
Graphical Summary를 선택하면 모든 열이 하나의 표본으로 합쳐져 설명됩니다. 평균, 표준편차, 분산, 왜도, 첨도, N, 최솟값, 사분위수, 중앙값, 최댓값, 변동계수(%), Anderson-Darling 정규성 검정(A-제곱과 p-값), 평균(t), 중앙값(Hettmansperger-Sheather), 표준편차(카이제곱)에 대한 95% 신뢰구간이 포함됩니다. Exclude outliers를 선택하면 Q1 − 1.5×IQR 또는 Q3 + 1.5×IQR 밖의 값은 요약에서만 제외되며, 생성된 데이터에는 그대로 남습니다. Multivariate Normal에서는 공분산 행렬이 정방 행렬이고 대칭이며 양의 준정부호여야 하고 평균의 개수와 일치해야 합니다.
입력 항목 및 옵션
항목 | 설명 |
Distribution | 필수. 26가지 분포 중 하나이며, 아래의 모수 입력란은 이에 따라 바뀝니다. |
Number of rows of data to generate | 필수, 10~10,000. |
Number of columns | 기본값 1, 최대 10. 각 열은 독립적인 표본입니다. Multivariate Normal에서는 사용되지 않습니다(평균마다 한 열). |
Graphical Summary | 기본적으로 선택되어 있지 않습니다. 생성된 값에 대한 그래픽 요약을 출력에 추가합니다. |
Exclude outliers (1.5×IQR rule) | 선택 사항. Graphical Summary를 선택하지 않으면 효과가 없으며, 선택한 경우 요약에서만 특이치를 제거합니다. |
Decimals | 선택 사항, 0~10. 연속형 분포(Normal, Lognormal, Weibull, Exponential, T, F, Beta, Cauchy, Chi-Square, Gamma, Laplace, 극값 분포, Logistic, Loglogistic, Triangular, Uniform)에서 생성된 값을 반올림합니다. Normal에서는 표준편차를 표시하는 데 필요한 만큼 이상의 소수 자릿수가 유지됩니다. 정수 또는 나열된 값을 생성하는 분포(Binomial, Poisson, Bernoulli, Discrete, Geometric, Hypergeometric, Integer, Negative Binomial)와 Multivariate Normal에서는 표시되지 않습니다. |
Mean / Standard Deviation | Normal, Lognormal(데이터의 평균과 표준편차), Poisson은 Mean만 사용합니다. |
Number of trials / Event probability | Binomial. Event probability만 사용하는 경우: Bernoulli와 Geometric, Number of events(필요한 성공 횟수)와 함께 사용하는 경우: Negative Binomial. |
Shape parameter / Scale parameter / Threshold parameter | Weibull(Threshold는 선택 사항), Gamma와 Loglogistic은 형상과 척도를 사용합니다. |
Scale parameter / Threshold parameter | Exponential(Threshold는 선택 사항). |
Location parameter / Scale parameter | 적용 분포: Cauchy, Laplace, Largest Extreme Value, Smallest Extreme Value, Logistic. |
Degrees of freedom / Numerator and Denominator degrees of freedom | T와 Chi-Square, F. |
First shape parameter / Second shape parameter | Beta. |
Values / Probabilities | Discrete. 쉼표 또는 공백으로 구분하며 개수가 같아야 합니다. 예: “1 2 3”과 “0.2 0.3 0.5”(합이 1이 아니면 재정규화됨). |
Population size (N) / Event count in population / Sample size (n) | Hypergeometric. 사건 수와 표본 크기는 모집단 크기를 넘을 수 없습니다. |
Minimum / Maximum / Mode (most likely value) | Integer(최솟값과 최댓값), Triangular(세 값 모두, 최빈값은 그 사이에 있어야 함). |
Lower endpoint / Upper endpoint | Uniform. |
Means / Covariance matrix | Multivariate Normal. Means는 변수마다 하나씩이며 예: “10 20 30”, 공분산 행은 세미콜론으로 구분하며 예: “4,2,0; 2,9,1; 0,1,1”. |
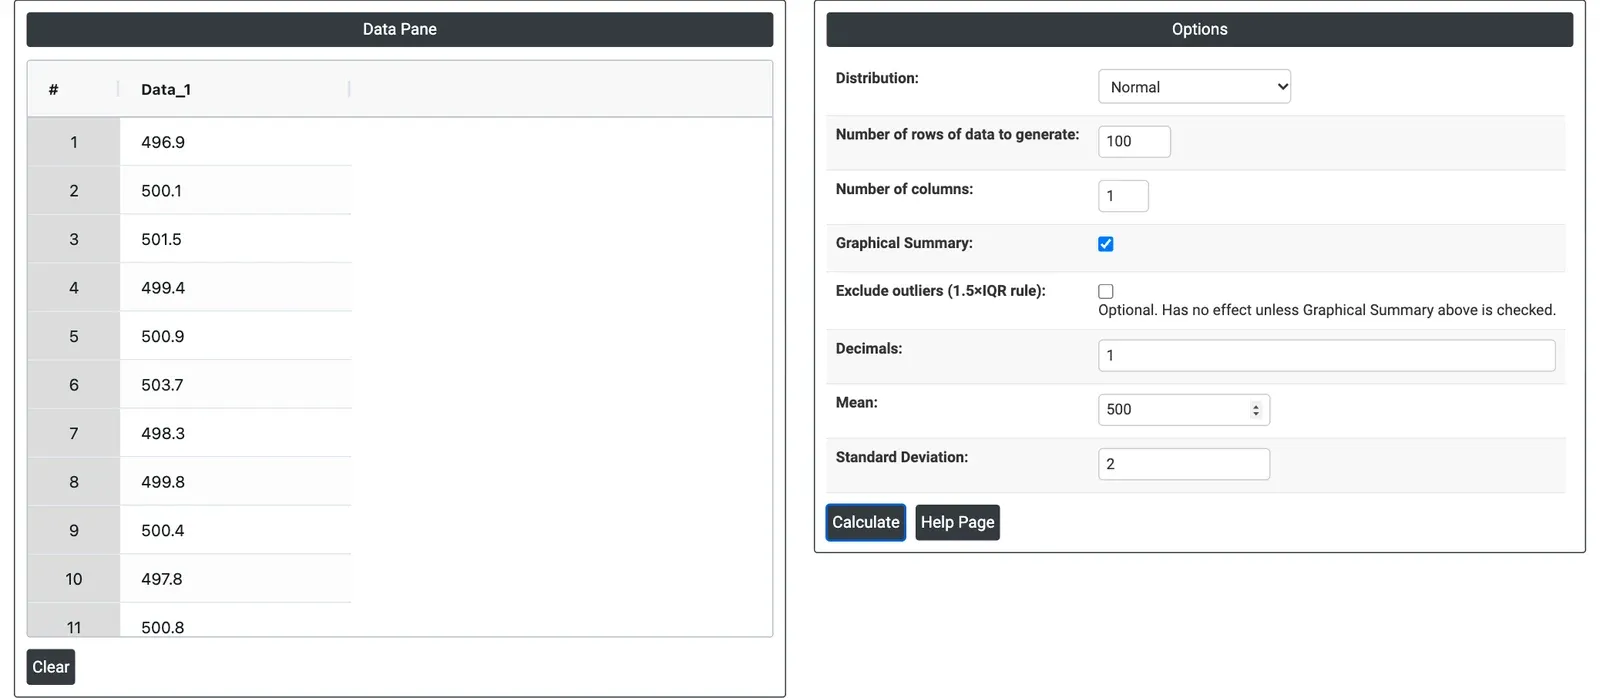
그림 1 — 평균 500, 표준편차 2인 Normal 분포에서 생성한 100개 값을 소수 첫째 자리로 반올림하여 데이터 창(왼쪽)에 표시하고 Options(오른쪽)를 함께 나타낸 것.
출력 설명
- Data Pane — 생성된 값이며, 표본마다 한 열(data_1, data_2, …)로 표시되고 기존 내용을 대체합니다.
- Graphical summary(선택한 경우) — 적합된 정규 곡선과 상자 그림이 있는 히스토그램, A-Squared, p-value, Mean, StDev, Variance, Skewness, Kurtosis, N, Minimum, 1st Quartile, Median, 3rd Quartile, Maximum, Coeff Var가 있는 요약 표, 평균과 중앙값에 대한 95% Confidence Intervals 그림, Anderson-Darling 결과가 있는 Probability Plot, 평균, 중앙값, 표준편차의 95% 하한과 상한 및 각 구간의 반폭을 나타낸 표.
- Multivariate Normal — 생성된 열의 표본 상관 행렬과 공분산 행렬.
- Download as PDF를 통한 PDF 내보내기.
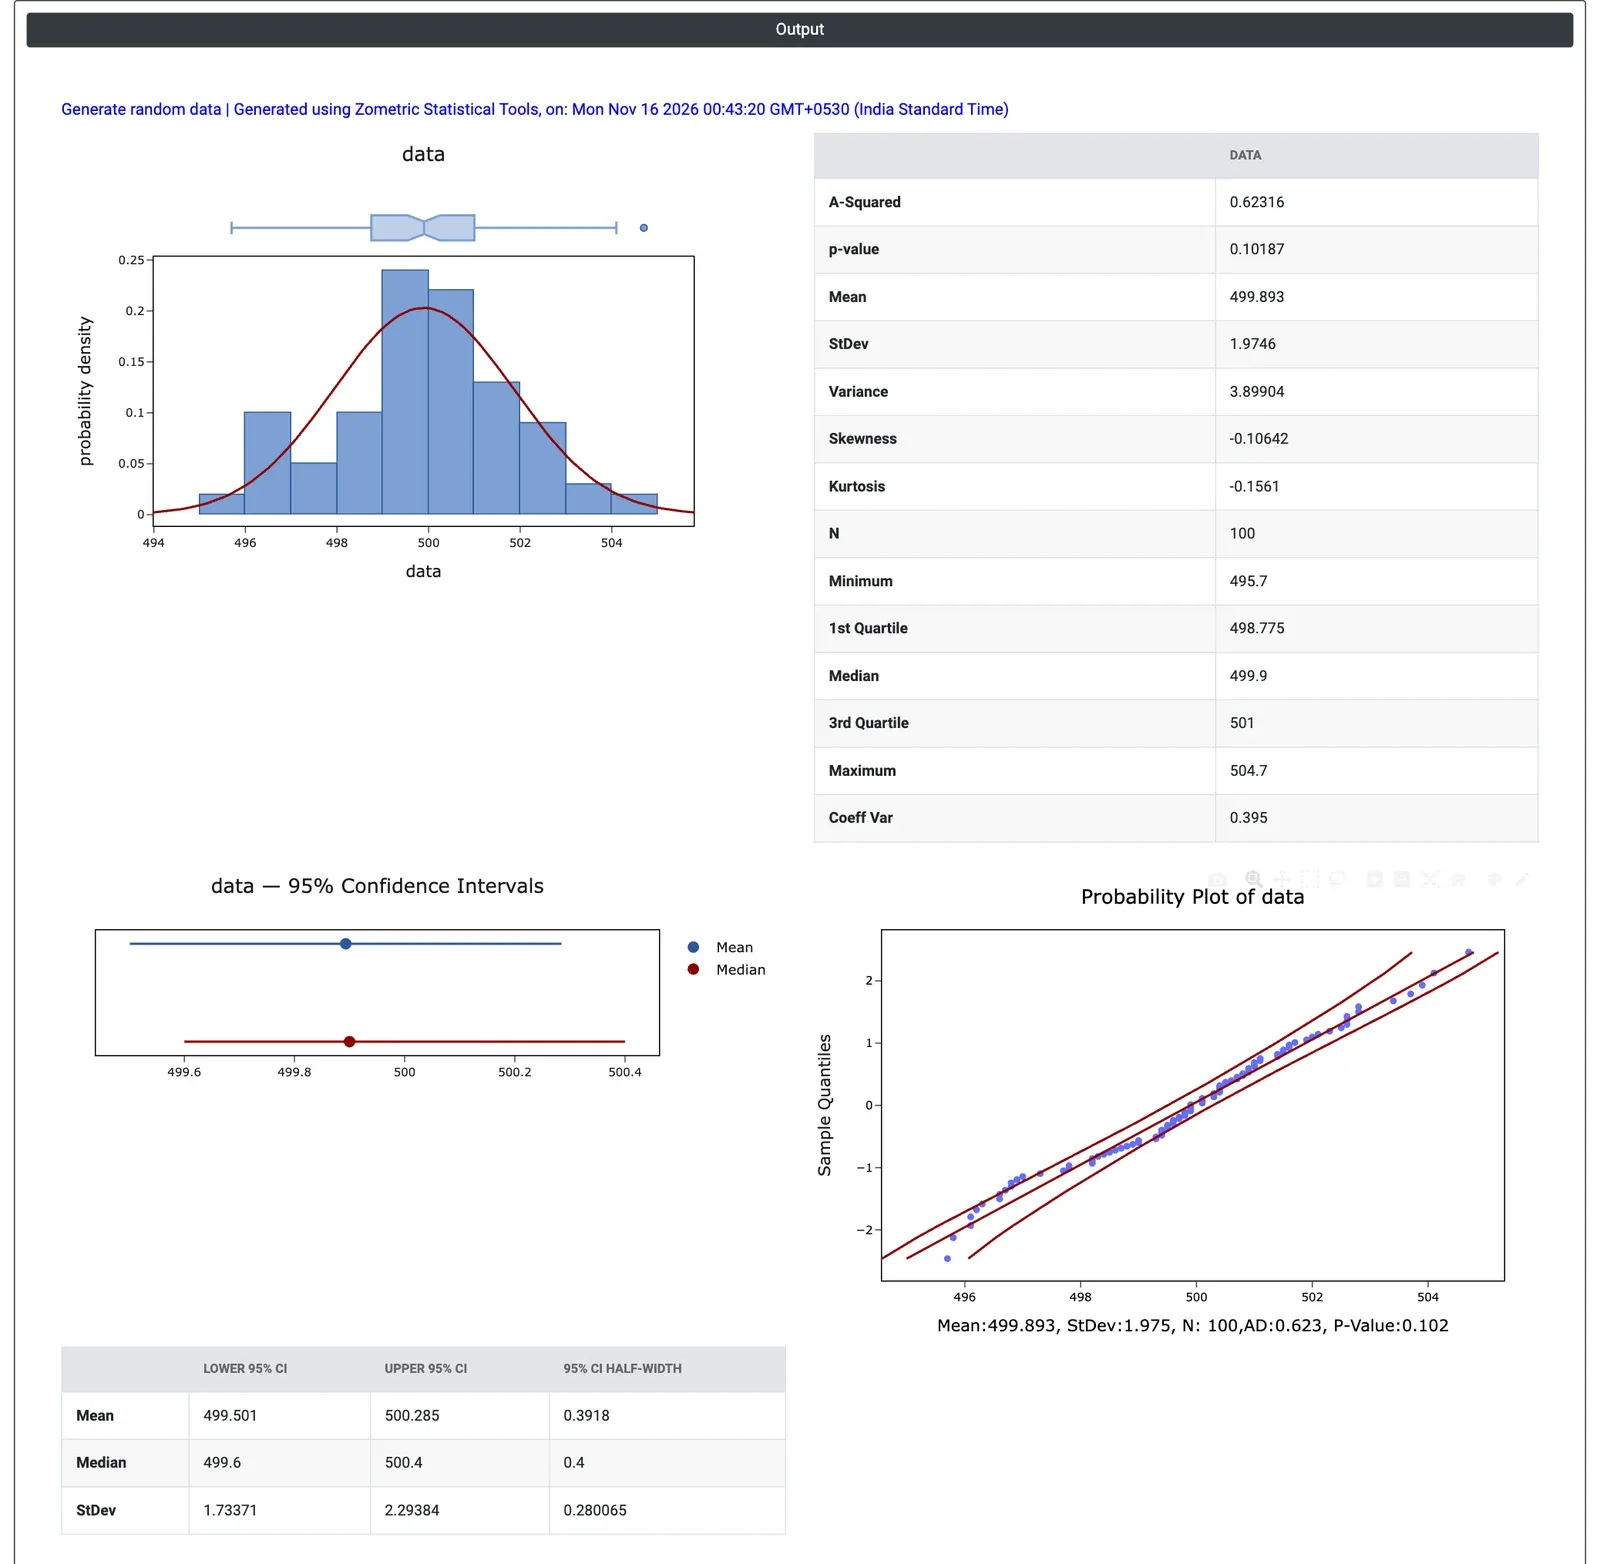
그림 2 — 생성된 100개 값의 그래픽 요약: 평균 499.89, StDev 1.97, Anderson-Darling p-값 0.102.
계산 예제
한 품질 교육 담당자가 충전 라인 작업자를 위한 공정 변동 교육을 준비합니다. 이 라인은 표준편차 약 2 g으로 500 g 병을 충전합니다. 정규 변동만으로 어떤 모습이 나타나는지 보여 주기 위해 교육 담당자는 Distribution = Normal, Number of rows = 100, Number of columns = 1, Mean = 500, Standard Deviation = 2, Decimals = 1을 선택하고 Graphical Summary를 선택합니다.
시뮬레이션한 100개의 충전 중량은 495.7~504.7 g이며 평균은 499.89 g, 표준편차는 1.97 g입니다. 공정을 정확히 설정했는데도 500과 2에 정확히 일치하지 않습니다. 히스토그램은 깔끔한 종 모양이 아니라 울퉁불퉁하지만, Anderson-Darling 검정은 p = 0.102를 주므로 정규성에 반하는 증거는 없습니다. 평균의 95% 신뢰구간 499.50~500.29 g(반폭 0.39 g)에는 참값 500이 포함되고, 표준편차의 구간 1.73~2.29 g에는 참값 2가 포함됩니다.
작업자에게 전달할 요점은 안정적이고 중심이 맞는 공정이라도 목표에서 4 g 벗어난 병이 나오고 표본 통계량이 참값과 다를 수 있다는 것입니다. Calculate를 누를 때마다 약간씩 다른 숫자로 새 표본이 생성되며, 교육 담당자는 이를 표본 간 변동을 보여 주는 데 사용할 수 있습니다. 20개 행의 5개 열을 생성하면 비교할 작은 표본 5개가 생기며, 연습을 위해 데이터를 공정능력 또는 관리도 도구에 복사할 수도 있습니다.
자주 묻는 질문
품질 업무에서 난수 데이터 생성은 어떤 용도로 사용합니까?
교육용 연습 데이터를 만들거나, 알려진 공정에서 추출한 표본이 얼마나 변동하는지 확인하거나, 실제 데이터가 도착하기 전에 분석을 시험하거나, 삼각 추정치에서 얻은 사이클 타임이나 Weibull 모형에서 얻은 고장 시간처럼 가정 분석을 위해 공정을 시뮬레이션하는 데 사용합니다. 생성된 데이터는 공정능력이나 관리도 같은 다른 도구에 복사할 수 있습니다.
어떤 분포에서 난수 데이터를 생성할 수 있습니까?
26가지가 있습니다. Normal, Lognormal, Weibull, Exponential, Gamma, Uniform, Triangular 같은 연속형 분포, Binomial, Poisson, Geometric, Hypergeometric, Integer, Discrete 같은 이산형 분포, 평균 벡터와 공분산 행렬로부터 상관된 열을 생성하는 Multivariate Normal입니다. 선택한 분포의 모수 입력란만 표시됩니다.
무작위 표본이 모평균과 표준편차에 정확히 일치하지 않는 이유는 무엇입니까?
각 표본은 우연에 따라 달라집니다. 계산 예제에서 평균 500, 표준편차 2인 정규 공정에서 추출한 100개 값의 표본 평균은 499.89, 표준편차는 1.97이었고 히스토그램은 종 모양이 아니라 울퉁불퉁했지만, Anderson-Darling 검정은 p = 0.102를 주어 정규성에 반하는 증거가 없음을 보여 주었습니다.
난수 데이터를 생성할 때 Lognormal 모수는 어떻게 입력합니까?
Lognormal 분포에서는 로그 값이 아니라 데이터 자체의 평균과 표준편차를 입력합니다. 도구가 이를 로그 척도 모수로 변환합니다. 시그마는 ln(1 + (s/m)²)의 제곱근과 같고 뮤는 ln(m) 빼기 시그마 제곱을 2로 나눈 값과 같습니다.