
지수 난수 데이터(Random Exponential Data)
지수 난수 데이터는 일정한 고장률(무기억성)을 가정하여 기계 고장이나 고객 도착과 같은 독립적인 사건 사이의 대기 시간을 시뮬레이션합니다. 행과 열의 수, 사건 사이의 평균 시간(1/비율)인 척도, 값을 위로 이동시키는 선택적 임계값을 설정합니다. 고장률이 시간에 따라 변한다면 대신 Weibull 난수 데이터를 사용하십시오.
최종 검토
핵심 요점
지수 난수 데이터는 사건 간 평균 시간이 주어진 지수분포에서 엄밀하게 양수인 값을 생성하여, 일정한 비율로 일어나는 고장 간격, 도착 간격 또는 서비스 완료 간격을 시뮬레이션합니다.
이 페이지 내용
지수 난수 데이터란?
지수 난수 데이터는 기계 고장 간격, 고객 도착 간격, 서비스 완료 간격과 같이 연속된 독립 사건 사이의 시간을 모형화하는 지수분포에서 값을 생성합니다. 평균(사건 사이의 평균 시간)을 지정하면 도구가 무작위 사건 간 지속 시간을 생성합니다.
간단한 정의: 사건 사이의 무작위 대기 시간을 생성하며, 다음 고장이나 도착이 일어나기까지 얼마나 걸리는지 시뮬레이션하기 위해 신뢰성 공학과 대기행렬 분석에서 널리 사용됩니다.
지수 난수 데이터는 언제 사용합니까?
- 다음의 시뮬레이션에 사용합니다: 고장, 도착 또는 서비스 완료 사이의 시간.
- 일정한 고장률(지수 고장 모형)을 가정하는 신뢰성 분석 테스트 에 사용합니다.
지수 난수 데이터의 올바른 사용 지침
- 지수분포는 일정한 고장률(무기억성) 을 가정합니다. 고장률이 시간에 따라 변하면 대신 Weibull을 사용하십시오.
- 생성되는 모든 값은 엄밀하게 양수입니다.
- 평균은 과거 데이터에서 알려진 사건 사이의 평균 시간 과 같게 설정하십시오.
대안: 지수 난수 데이터를 사용하지 않아야 할 때
- 고장률이 시간에 따라 변하는 경우에는 다음을 사용하십시오: Weibull 난수 데이터
- 시간 기반이 아닌 치우친 양의 연속형 측정값 에는 다음을 사용하십시오: 로그정규 난수 데이터
지수 난수 데이터 예제
지수 난수 데이터를 생성하는 단계는 다음과 같습니다.
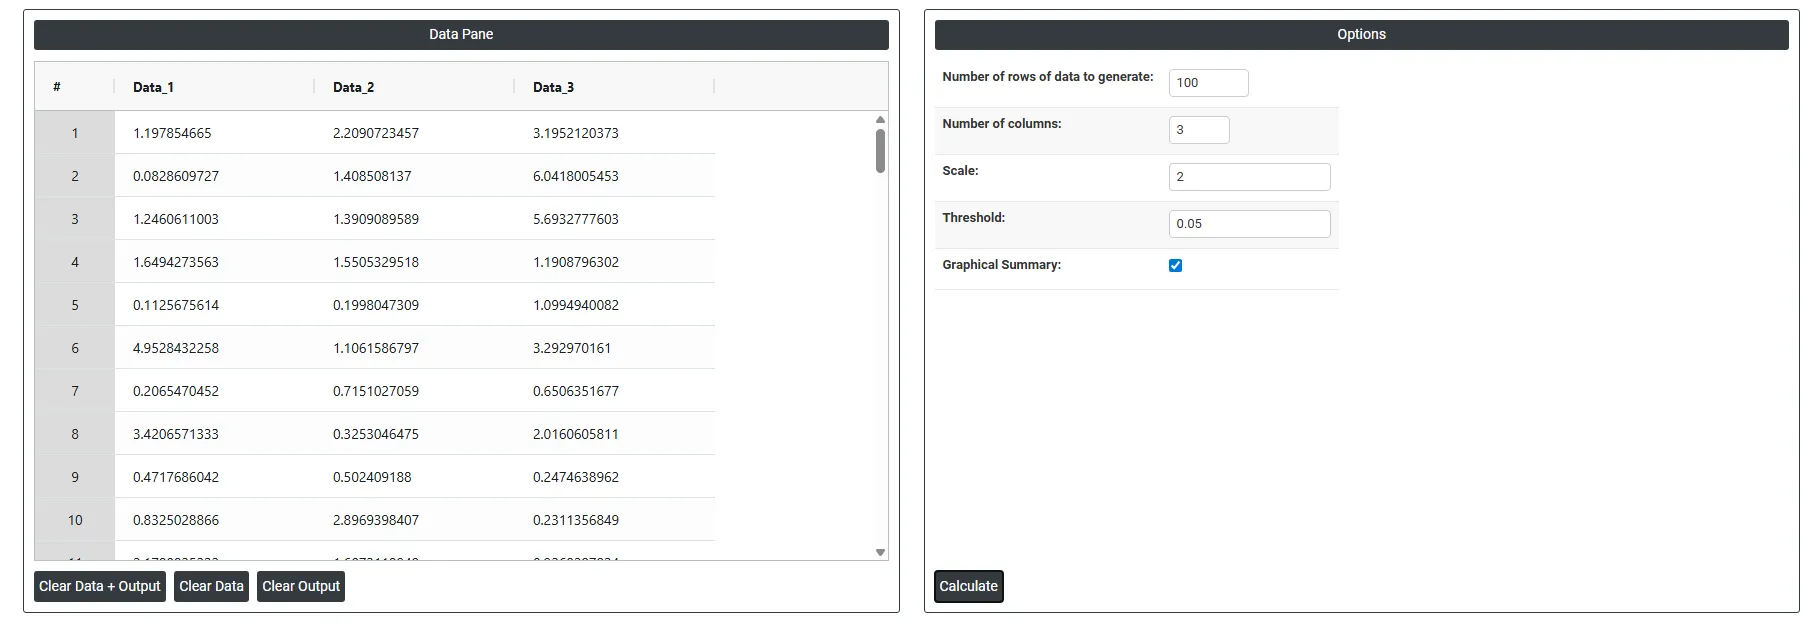
- 지수 난수 데이터를 생성하려면 필요한 옵션을 입력해야 합니다.
- 이제 Zometric Statistical Software에서 데이터를 분석합니다: https://statsai.zometric.com/.
- 지수 난수 데이터를 찾으려면 다음을 선택합니다: Statistical module> Random Data > Random Exponential Data
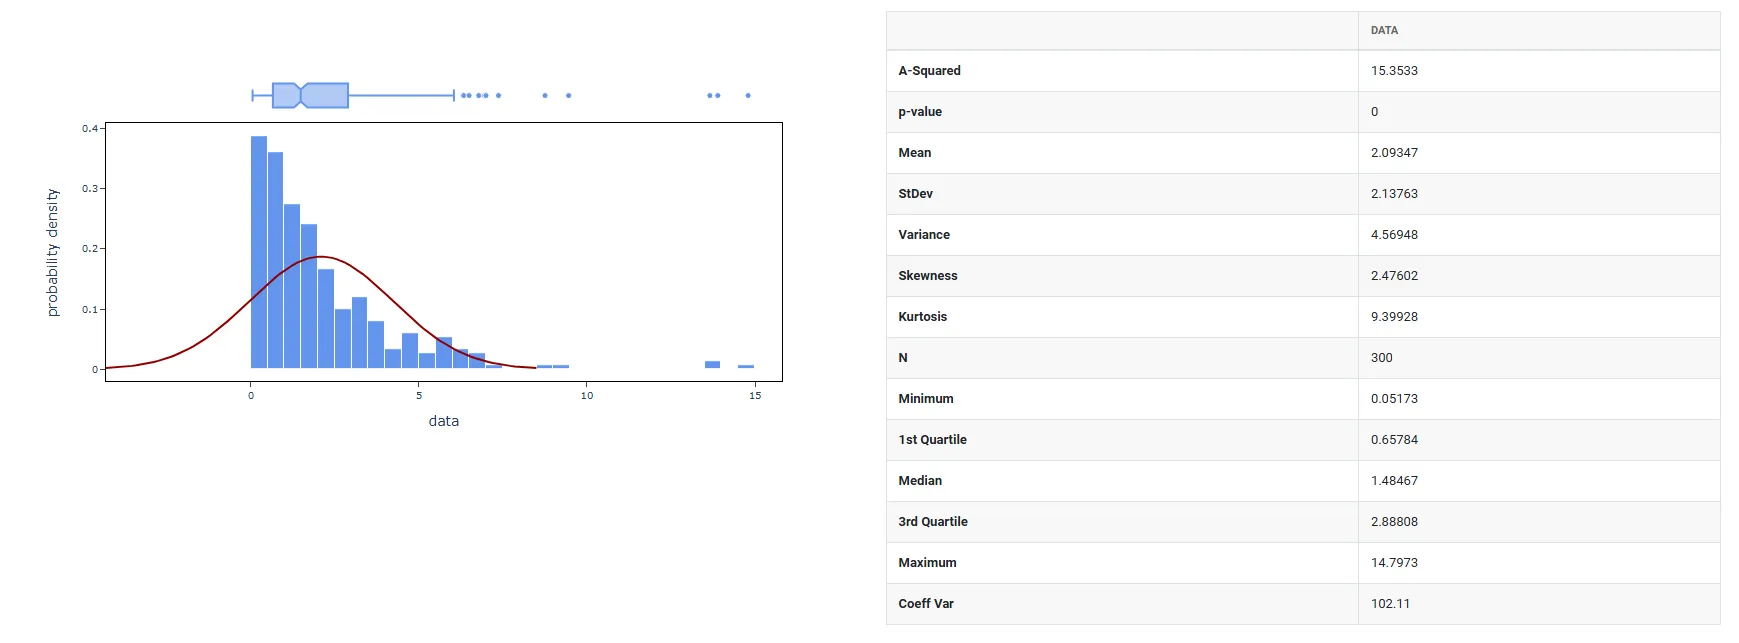
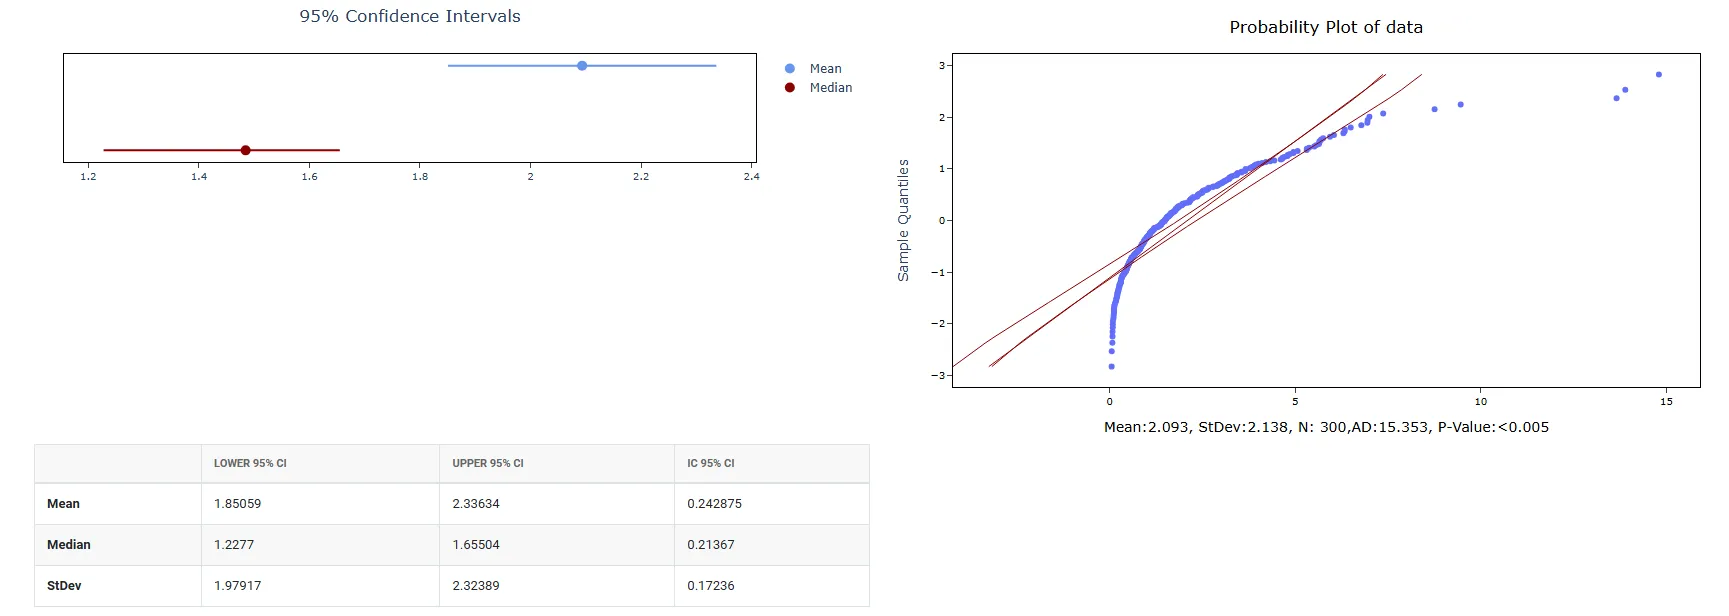
4. 위 도구를 사용하면 다음과 같은 출력을 얻습니다.
지수 난수 데이터 방법
절차는 다음과 같습니다.
- Zometric Statistical Software에 로그인합니다: https://statsai.zometric.com/
- 홈 페이지에서 Statistical Tool> Random Data>Random Exponential Data를 선택합니다.
- 다음으로, 필요한 옵션을 입력합니다.
- 마지막으로, 페이지 하단의 calculate를 클릭하면 원하는 결과를 얻을 수 있습니다.
지수 난수 데이터 도구 화면은 두 부분으로 나뉩니다.
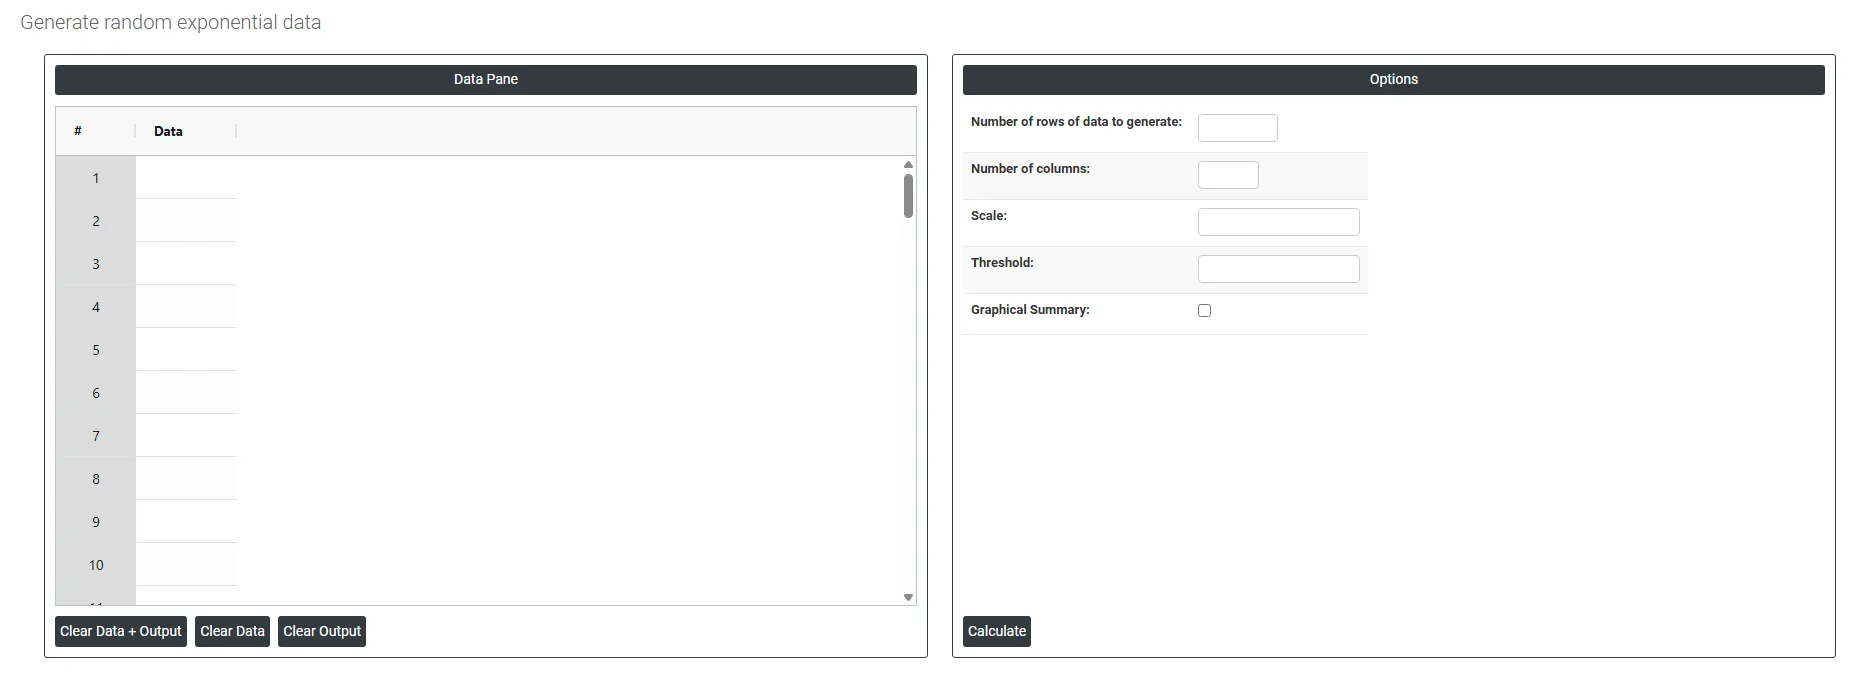
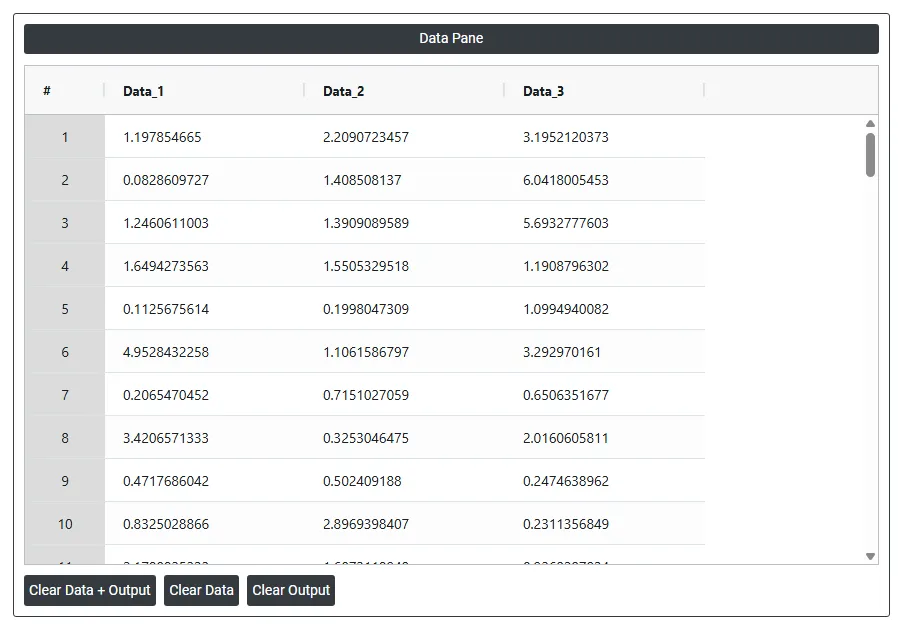
왼쪽 부분에는 데이터 창(Data Pane)이 있습니다. Data Pane에는 생성된 난수 데이터가 행 단위로 표시됩니다. 필요한 옵션을 입력하면 데이터가 생성됩니다.
오른쪽 부분에는 다음과 같은 여러 옵션이 있습니다.
- Number of rows of data to generate: 생성할 난수 데이터 점의 개수를 지정합니다. 예를 들어 10을 입력하면 정확히 10개 행의 난수 값이 생성되며 모두 데이터 창에 표시됩니다.
- Number of columns: 각 행이 가질 변수(열)의 수를 지정합니다. 예를 들어 3을 입력하면 무작위로 생성된 데이터가 데이터 창에 3개 열로 나란히 표시됩니다.
- Scale: 지수분포의 평균, 즉 사건 사이의 평균 시간(1/비율과 같음)입니다. 척도 값이 클수록 더 크고 더 넓게 퍼진 숫자가 생성되고, 척도 값이 작을수록 0에 더 가깝게 모이는 값이 생성됩니다. 데이터 창에 생성된 모든 데이터 점에 이러한 산포가 반영됩니다.
- Threshold: 생성되는 데이터의 최소 시작점을 설정합니다. 값이 0에서 시작하는 대신 생성된 숫자가 이 값만큼 위로 이동합니다. 예를 들어 임계값을 10으로 설정하면 생성된 모든 값이 0이 아니라 10부터 위로 시작합니다.
- Graphical summary: 선택하면 생성된 모든 값을 합쳐 요약합니다. 적합된 정규 곡선이 있는 히스토그램과 상자 그림, 요약 통계량, Anderson-Darling 정규성 검정, 확률도, 평균, 중앙값, 표준편차에 대한 95% 신뢰구간이 표시됩니다. 방금 생성한 데이터를 기반으로 한 시각적 결과입니다.
자주 묻는 질문
지수 난수 데이터는 무엇을 시뮬레이션합니까?
지수 난수 데이터는 기계 고장 간격, 고객 도착 간격, 서비스 완료 간격과 같이 연속된 독립 사건 사이의 시간을 시뮬레이션합니다. 다음 고장이나 도착이 일어나기까지 얼마나 걸리는지 모형화하고 일정한 고장률을 가정하는 신뢰성 분석을 테스트하기 위해 신뢰성 공학과 대기행렬 분석에서 널리 사용됩니다.
지수분포 대신 Weibull은 언제 사용해야 합니까?
지수분포는 일정한 고장률, 즉 무기억성을 가정합니다. 고장률이 증가하거나 감소하는 등 시간에 따라 변한다면 대신 Weibull 난수 데이터를 사용하십시오. 시간 기반이 아닌 치우친 양의 측정값에는 로그정규 난수 데이터가 더 나은 선택입니다.
지수 난수 데이터에서 척도와 임계값 설정은 어떤 역할을 합니까?
척도는 지수분포의 평균으로, 1/비율과 같은 사건 사이의 평균 시간입니다. 척도가 클수록 더 크고 더 넓게 퍼진 숫자가 생성되고, 척도가 작을수록 0에 더 가깝게 모이는 값이 생성됩니다. 과거 데이터에서 알려진 사건 사이의 평균 시간으로 설정하십시오. 임계값은 모든 값을 위로 이동시키므로, 임계값이 10이면 값이 0이 아니라 10부터 시작합니다.