
T 난수 데이터(Random T Data)
T 난수 데이터는 t 검정과 신뢰구간의 검증, 검정력 분석, 교육을 위해 t-분포의 값을 모사합니다. 행 수와 열 수, 일반적으로 n - 1인 자유도, 소수 자릿수를 설정합니다. 자유도가 낮으면 꼬리가 두꺼워져 극단값이 더 많이 나오고, 30을 넘으면 t-분포는 정규분포와 거의 같아집니다. 선택 사항으로 그래프 요약을 제공합니다.
최종 검토
핵심 요점
T 난수 데이터는 정규분포보다 꼬리가 두꺼운 좌우 대칭의 종 모양 분포로 자유도에 따라 정해지는 t-분포에서 값을 생성하며, t 통계량과 소표본 연구를 모사하는 데 사용합니다.
이 페이지 내용
T 난수 데이터란?
T 난수 데이터는 t-분포에서 값을 생성합니다. t-분포는 정규분포와 비슷한 좌우 대칭의 종 모양 분포이지만 꼬리가 더 두꺼우며, 자유도 모수로 조절됩니다. 자유도가 커지면 t-분포는 표준정규분포로 수렴합니다. t 검정 통계량을 모사하고 소표본 연구의 불확실성을 모형화하는 데 널리 사용됩니다.
간단한 정의:t-분포, 즉 정규분포보다 꼬리가 두꺼운 종 곡선에서 난수를 생성하며, 소표본 모사와 t 검정 검증에 이상적입니다.
T 난수 데이터는 언제 사용합니까?
- 분포 특성을 아는 데이터로 t 검정과 신뢰구간 계산을 검증 할 때 사용합니다.
- t 검정 연구에 적절한 표본 크기를 정하기 위한 검정력 분석 시뮬레이션 에 사용합니다.
- 표본 크기가 커질수록 t-분포가 정규분포에 가까워지는 모습을 보여 주는 교육용 시연 에 사용합니다.
T 난수 데이터의 올바른 사용 지침
- 연구의 표본 크기(일반적으로 n − 1)를 바탕으로 자유도 를 설정하십시오.
- 다만 자유도가 크면(> 30)t-분포는 정규분포와 거의 같습니다.
대안: T 난수 데이터를 사용하지 않아야 할 때
- 정규성이 적절한 대표본 시뮬레이션 의 경우에는 다음을 사용하십시오: 정규 난수 데이터 생성
- 목적이 분산 비교 시뮬레이션의 경우에는 다음을 사용하십시오: F 난수 데이터
T 난수 데이터 예제
T 난수 데이터를 생성하는 단계는 다음과 같습니다.
- T 난수 데이터를 생성하려면 필요한 옵션을 입력해야 합니다.
- 이제 Zometric Statistical Software에서 데이터를 분석합니다: https://statsai.zometric.com/.
- T 난수 데이터를 찾으려면 다음을 선택합니다: Statistical module> Random Data > Random T Data
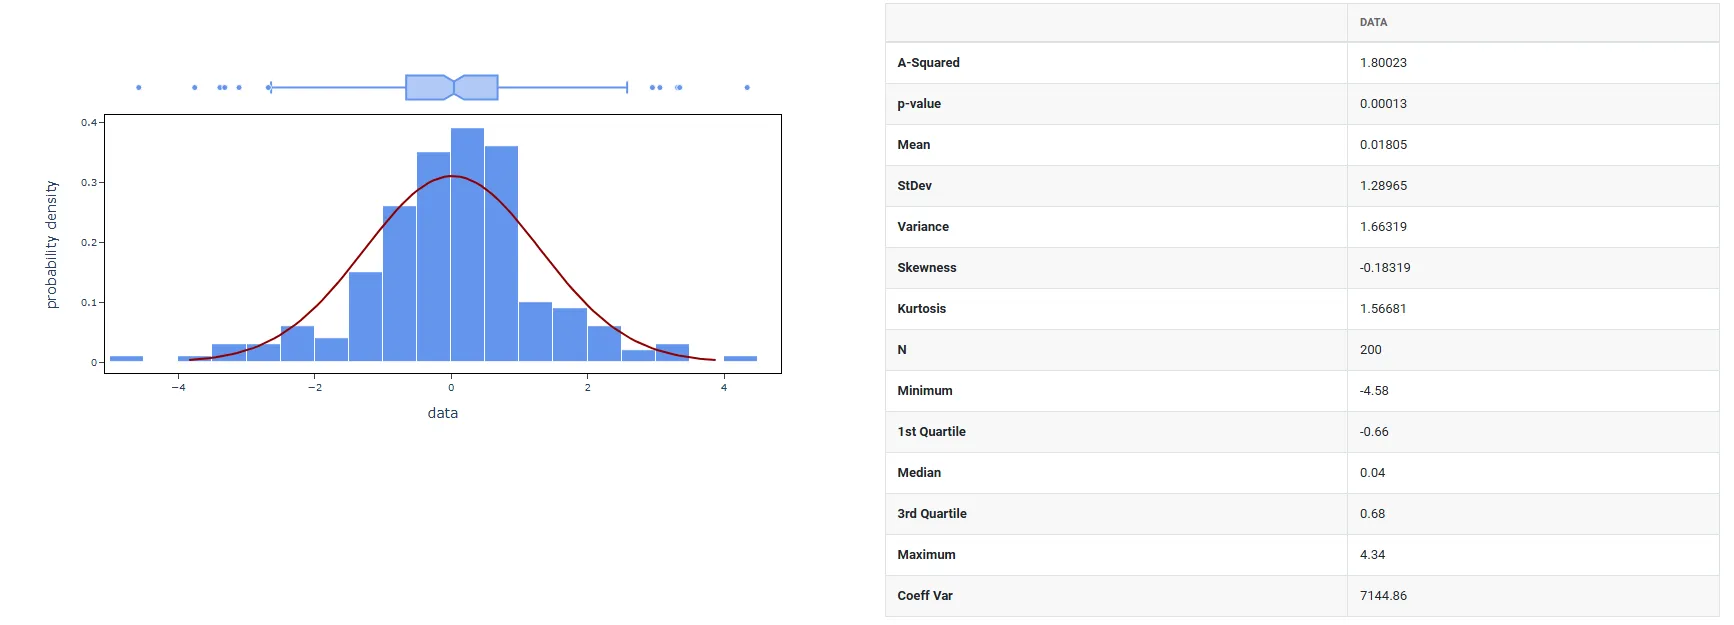
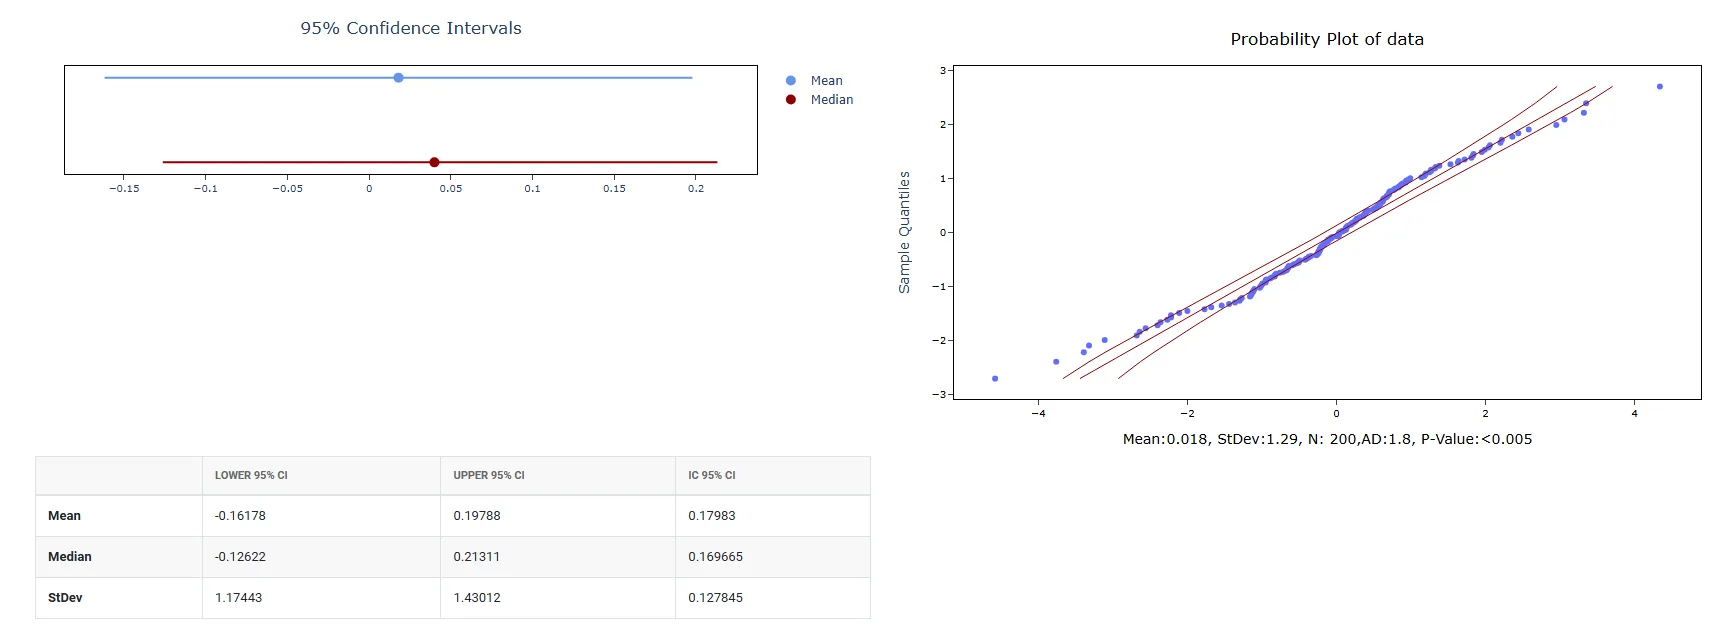
4. 위 도구를 사용하면 다음과 같은 출력을 얻습니다.
T 난수 데이터 생성 방법
절차는 다음과 같습니다.
- Zometric Statistical Software에 로그인합니다: https://statsai.zometric.com/
- 홈 페이지에서 Statistical Tool> Random Data>Random T Data를 선택합니다.
- 다음으로, 필요한 옵션을 입력해야 합니다.
- 마지막으로, 페이지 하단의 calculate를 클릭하면 원하는 결과를 얻을 수 있습니다.
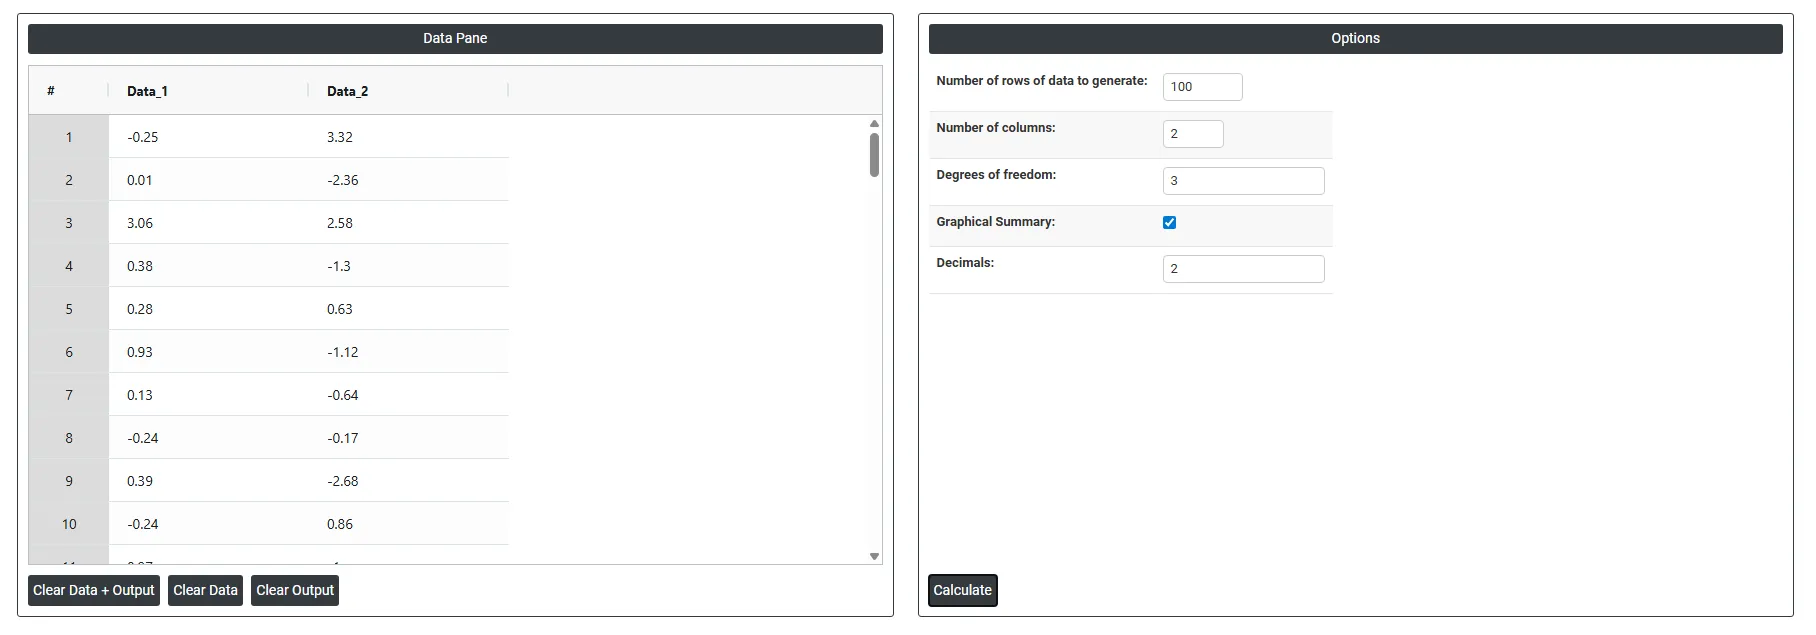
T 난수 데이터 도구 화면은 두 부분으로 나뉩니다.
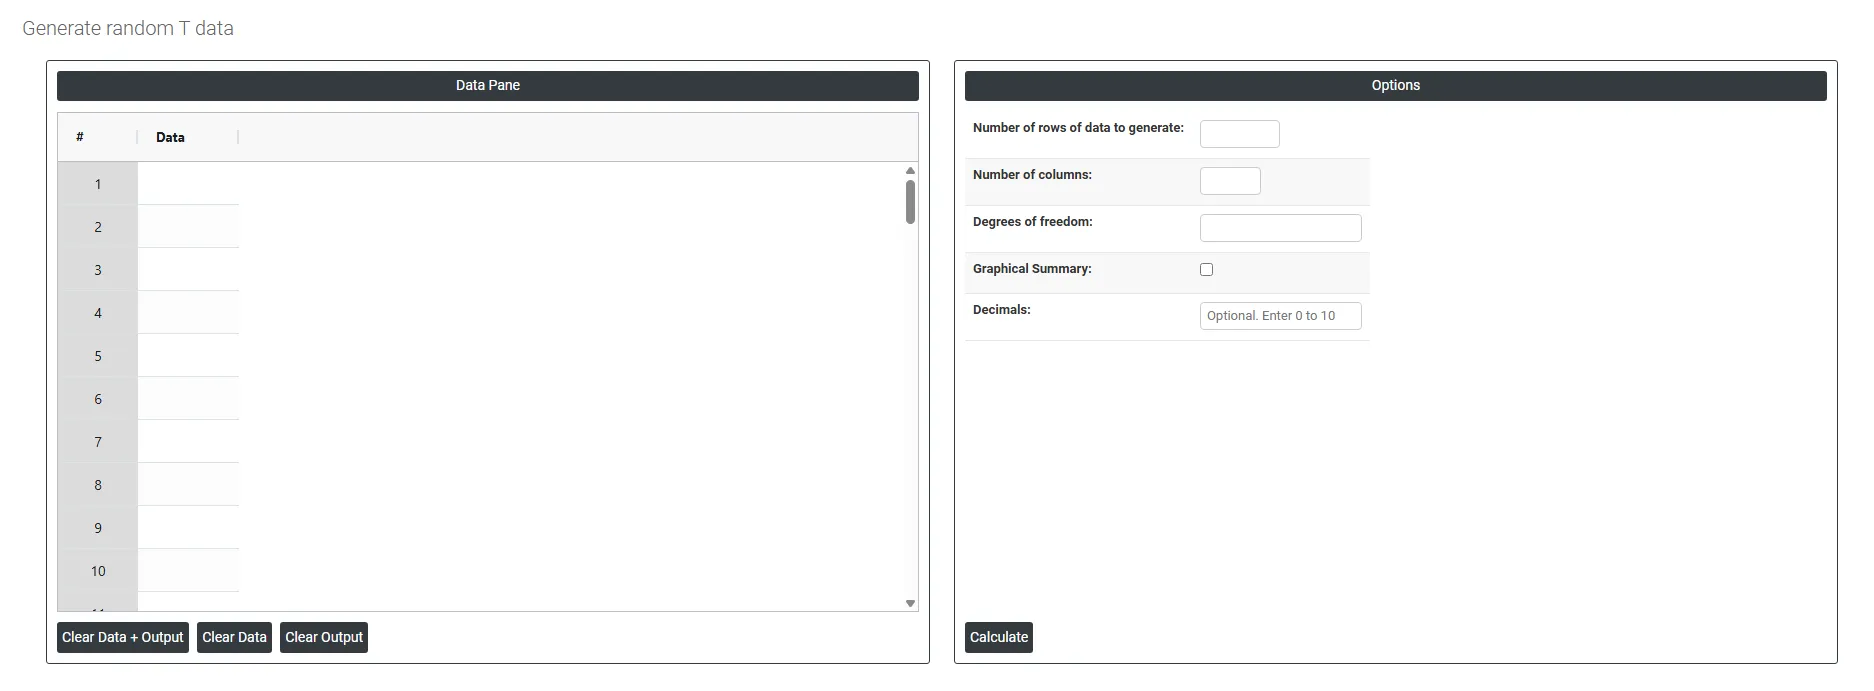
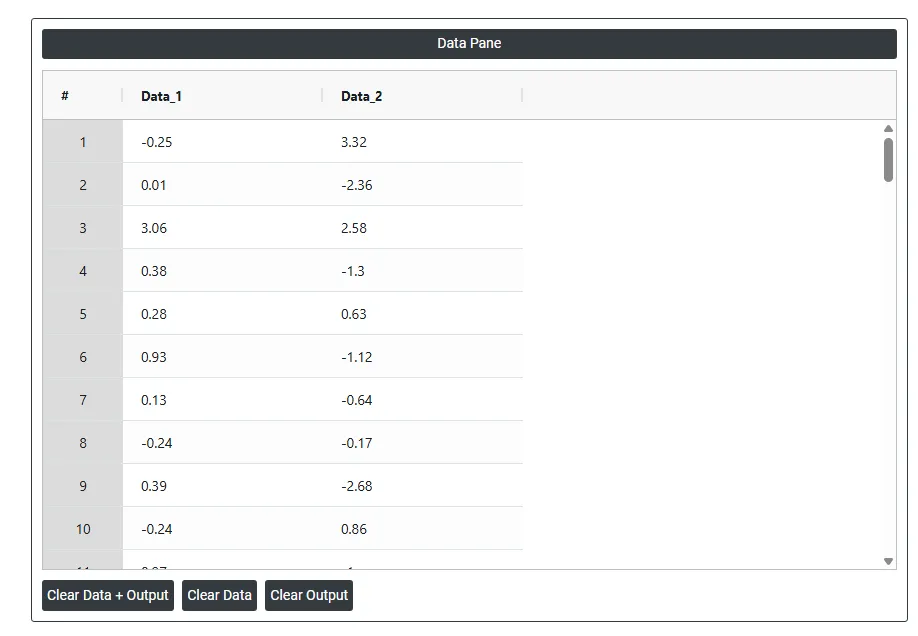
왼쪽 부분에는 데이터 창(Data Pane)이 있습니다. Data Pane에서는 각 행이 생성된 난수 데이터 한 행이 됩니다. 필요한 옵션을 입력하면 데이터가 생성됩니다.
오른쪽 부분에는 다음과 같은 여러 옵션이 있습니다.
- Number of rows of data to generate: 생성할 난수 데이터 점의 개수를 지정합니다. 예를 들어 10을 입력하면 정확히 10개 행의 난수 값이 만들어지며, 모두 Data Pane에 표시됩니다.
- Number of columns: 각 행이 가질 변수(열)의 개수를 지정합니다. 예를 들어 3을 입력하면 무작위로 생성된 데이터 3개 열이 Data Pane에 나란히 만들어집니다.
- Degrees of freedom: 난수 데이터를 생성하는 데 사용하는 t-분포의 모양을 결정합니다. 자유도가 낮으면(예: 1 또는 2) 분포의 꼬리가 두꺼워져 생성된 데이터에 극단값이 더 많이 나타납니다. 자유도가 커지면 t-분포는 점차 정규분포의 모양에 가까워집니다. 예를 들어 30을 입력하면 자유도 30의 t-분포에서 난수 데이터를 생성하며, 정규분포를 따르는 데이터와 매우 비슷한 값이 만들어집니다.
- Graphical summary: 선택하면 생성된 모든 값을 합쳐 요약합니다. 적합된 정규 곡선이 있는 히스토그램과 상자 그림, 요약 통계량, Anderson-Darling 정규성 검정, 확률도, 평균, 중앙값, 표준편차에 대한 95% 신뢰구간이 제공됩니다. 방금 만든 데이터에 기반한 시각적 결과입니다.
- Decimals: 생성되는 난수 값 자체의 소수 자릿수를 조절합니다. 예를 들어 2로 설정하면 생성된 모든 숫자가 47.83이나 52.16처럼 소수 둘째 자리로 반올림됩니다. 0으로 설정하면 정수만 생성됩니다.
자주 묻는 질문
t-분포란 무엇입니까?
t-분포는 정규분포와 비슷한 좌우 대칭의 종 모양 분포이지만 꼬리가 더 두꺼우며, 자유도 모수로 조절됩니다. 자유도가 커지면 표준정규분포로 수렴합니다. t 검정 통계량을 모사하고 소표본 연구의 불확실성을 모형화하는 데 널리 사용됩니다.
t 난수 데이터에는 어떤 자유도를 사용해야 합니까?
연구의 표본 크기를 바탕으로, 일반적으로 n - 1로 자유도를 설정하십시오. 1이나 2와 같이 낮은 값은 꼬리를 두껍게 하여 극단값이 더 많이 나오게 합니다. 자유도가 30을 넘는 큰 값이면 t-분포는 정규분포와 거의 같으므로, 대표본 시뮬레이션에는 대신 정규 난수 데이터를 사용할 수 있습니다.
t 난수 데이터는 언제 생성해야 합니까?
분포 특성을 아는 데이터로 t 검정과 신뢰구간 계산을 검증할 때, t 검정 연구에 적절한 표본 크기를 찾는 검정력 분석 시뮬레이션에, 그리고 표본 크기가 커질수록 t-분포가 정규분포에 가까워지는 모습을 가르칠 때 사용합니다. 분산 비교 시뮬레이션에는 대신 F 난수 데이터를 사용하십시오.