
단일 지수 평활(Single Exponential Smoothing)
단일 지수 평활은 St = alpha·yt + (1 - alpha)·St-1로 시계열을 평활하고, 마지막 평활 수준을 모든 미래 기간의 예측값으로 사용합니다. 추세나 계절성 없이 일정한 값 주위를 오가는 시계열에 사용합니다. 시계열에 결측이 없어야 하며 값이 최소 4개 필요합니다. 출력은 적합값, 예측 한계가 있는 예측값, MAPE, MAD, MSD입니다.
최종 검토
핵심 요점
단일 지수 평활은 매 기간 최신 오차의 일정 비율(alpha)만큼 갱신되는 하나의 수준으로 시계열을 평활하고 그 수준을 미래 기간의 예측값으로 사용하며, 추세나 계절성이 없는 시계열에 적합합니다.
목적
단일 지수 평활은 매 기간 최신 오차의 일정 비율만큼 갱신되는 하나의 이동 수준으로 시계열을 평활하고, 그 수준을 모든 미래 기간의 예측값으로 사용합니다. 성숙 단계 예비 부품의 주간 수요, 일일 폐기율, 안정된 라인의 충전 중량처럼 뚜렷한 추세나 계절성 없이 비교적 일정한 값 주위를 오가는 시계열에 적합합니다. 추세가 있는 데이터에는 이중 지수 평활을, 계절성이 있는 데이터에는 Winters 방법 또는 분해를 사용하십시오.
주요 기능
- 사용자가 지정하는 평활 가중치(alpha)이며, 비워 두면 ARIMA(0,1,1) 적합에서 얻은 최적 가중치를 사용합니다.
- 데이터에서 구하거나 사용자가 입력하는 초기값.
- 선택한 신뢰수준에서의 예측 한계가 있는 예측값이며, 시계열의 끝에서 시작하거나, 알려진 데이터로 방법을 검증하기 위해 이전 행에서 시작할 수 있습니다.
- 정확도 척도인 MAPE, MAD, MSD와, 데이터, 적합값, 예측값의 그림.
- 선택적 결과 표(매 기간의 평활값, 예측값, 오차)와 4-in-1 잔차 그림.
통계적 방법
평활값은 Sₜ = α·yₜ + (1 − α)·Sₜ₋₁입니다. 기간 t의 적합값(한 단계 앞선 예측)은 직전 기간 끝의 평활값인 Sₜ₋₁이고, 오차는 yₜ에서 그 적합값을 뺀 값입니다. 작은 α(예: 0.1~0.3)는 천천히 반응하는 매끄러운 선을 만들고, 큰 α는 최신 값을 가깝게 따라갑니다.
가중치를 지정하면 초기값 S₀는 처음 K개 관측값의 평균입니다(K의 기본값은 6). 가중치를 비워 두면 도구는 1차 차분에 ARIMA(0,1,1) 모형을 최소제곱법으로 적합시키고 α = 1 − θ로 설정합니다(θ는 MA 계수). 이때 초기값은 그 적합에서 얻습니다. 이 최적 α는 1을 넘을 수 있으며, 이는 수준이 새 값마다 과잉 반응한다는 뜻이므로 시계열에 추세가 있다는 신호로 보십시오. Starting values = User-specified이면 입력한 Initial level이 S₀로 사용됩니다.
모든 예측값은 예측 기준 시점의 마지막 평활값과 같습니다. 예측 한계는 예측값 ± z × 1.25 × MAD이며, z는 신뢰수준에 대한 정규 분위수, MAD는 적합값의 평균 절대 오차이고, 앞선 모든 기간에서 폭이 같습니다. 정확도: MAPE = 평균 |오차 / 데이터| × 100, MAD = 평균 |오차|, MSD = 평균 오차²입니다. 시계열에는 결측이 없어야 하며 값이 최소 4개 필요합니다.
입력 항목 및 옵션
항목 | 설명 |
Variable (Y) | 필수. 시간 순서대로 정렬된 수치 시계열입니다. |
Weight to use in smoothing (alpha) | 0.0001~1. 최적 ARIMA(0,1,1) 가중치를 사용하려면 비워 두십시오. |
Starting values | From the data(기본값): 최적 가중치는 ARIMA 적합에서, 지정한 가중치는 처음 K개 관측값의 평균에서 시작합니다. 또는 User-specified. |
Initial level | Starting values가 User-specified일 때 사용합니다(이때 필수). |
Initial smoothed value: average of first K observations, K = | 기본값 6. 가중치를 입력하면 활성화됩니다. |
Number of forecasts | 기본값 0(없음), 최대 1000. |
Confidence level (%) for forecast interval | 기본값 95. 예측을 요청하면 활성화됩니다. |
Forecast origin (row) | 선택 사항이며, 예측을 요청하면 활성화됩니다. 예측은 이 행 이후부터 시작하며 이 행까지의 데이터를 사용합니다. 비어 있으면 시계열의 끝입니다. |
Results to display | Summary table(기본값) 또는 Summary table and results table. |
Residual plots (four in one) | 기본값은 선택 해제입니다. 정규 확률도, 잔차 대 적합값, 히스토그램, 잔차 대 순서. |
Title | 출력의 제목입니다. 기본값은 Single Exponential Smoothing입니다. |
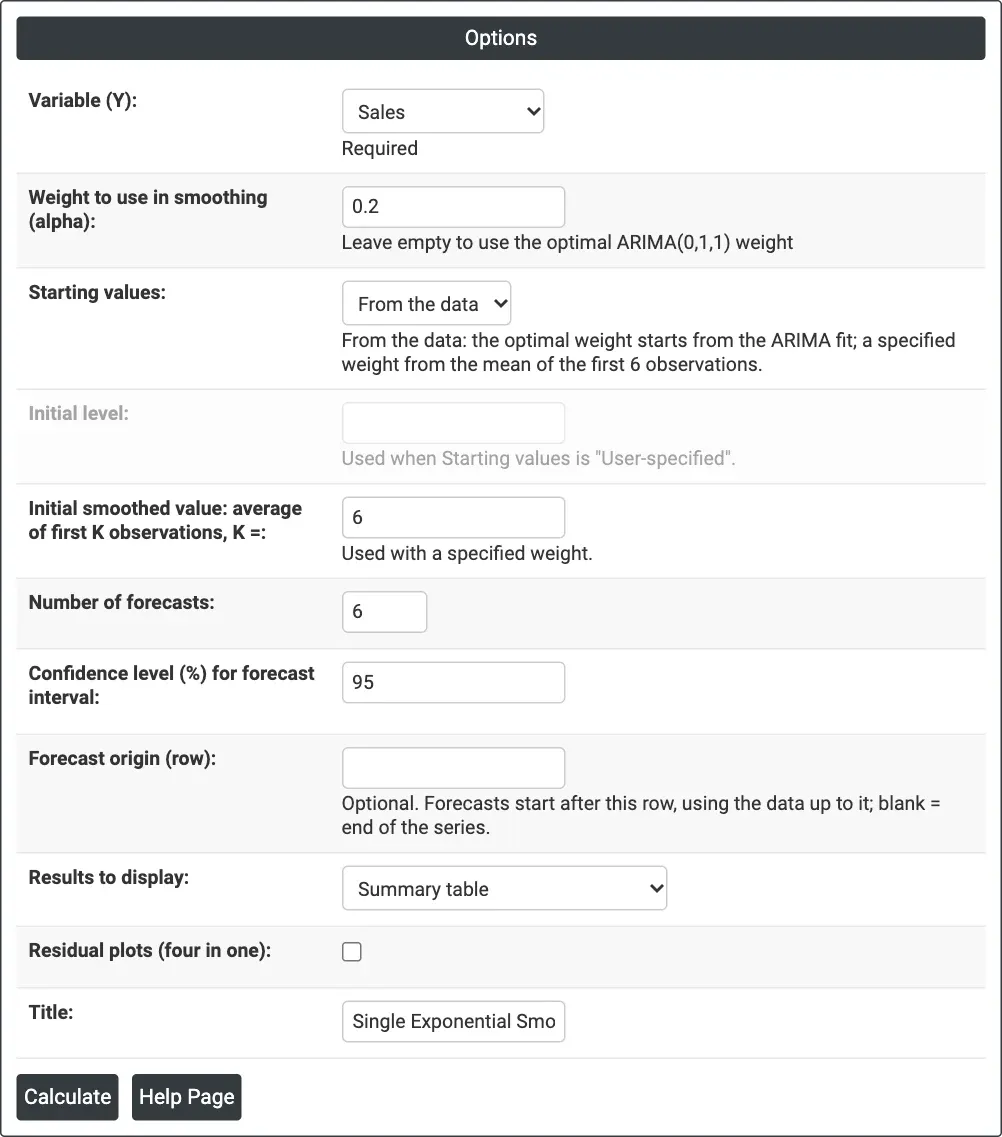
그림 1 — alpha = 0.2와 예측값 6개로 평활한 Monthly Sales.
출력 설명
- Single Exponential Smoothing (graph) — 실제 데이터, 적합값, 예측값, 예측 구간 띠이며, 제목에 MAPE, MAD, MSD가, 그림 위에 사용한 가중치가 표시됩니다.
- Method — 데이터 열, 길이, 가중치가 지정되었는지 최적값인지(예측 기준 시점을 설정한 경우에는 이것도 포함).
- Smoothing Constants — 사용한 α의 값.
- Accuracy Measures — MAPE, MAD, MSD의 값.
- Forecasts — 기간, 예측값, 하한, 상한.
- Results — 선택한 경우: 매 기간의 Period, data, Smooth, Predict, Error.
- Residual Plots — 선택한 경우.
- Download를 통한 PDF 내보내기.
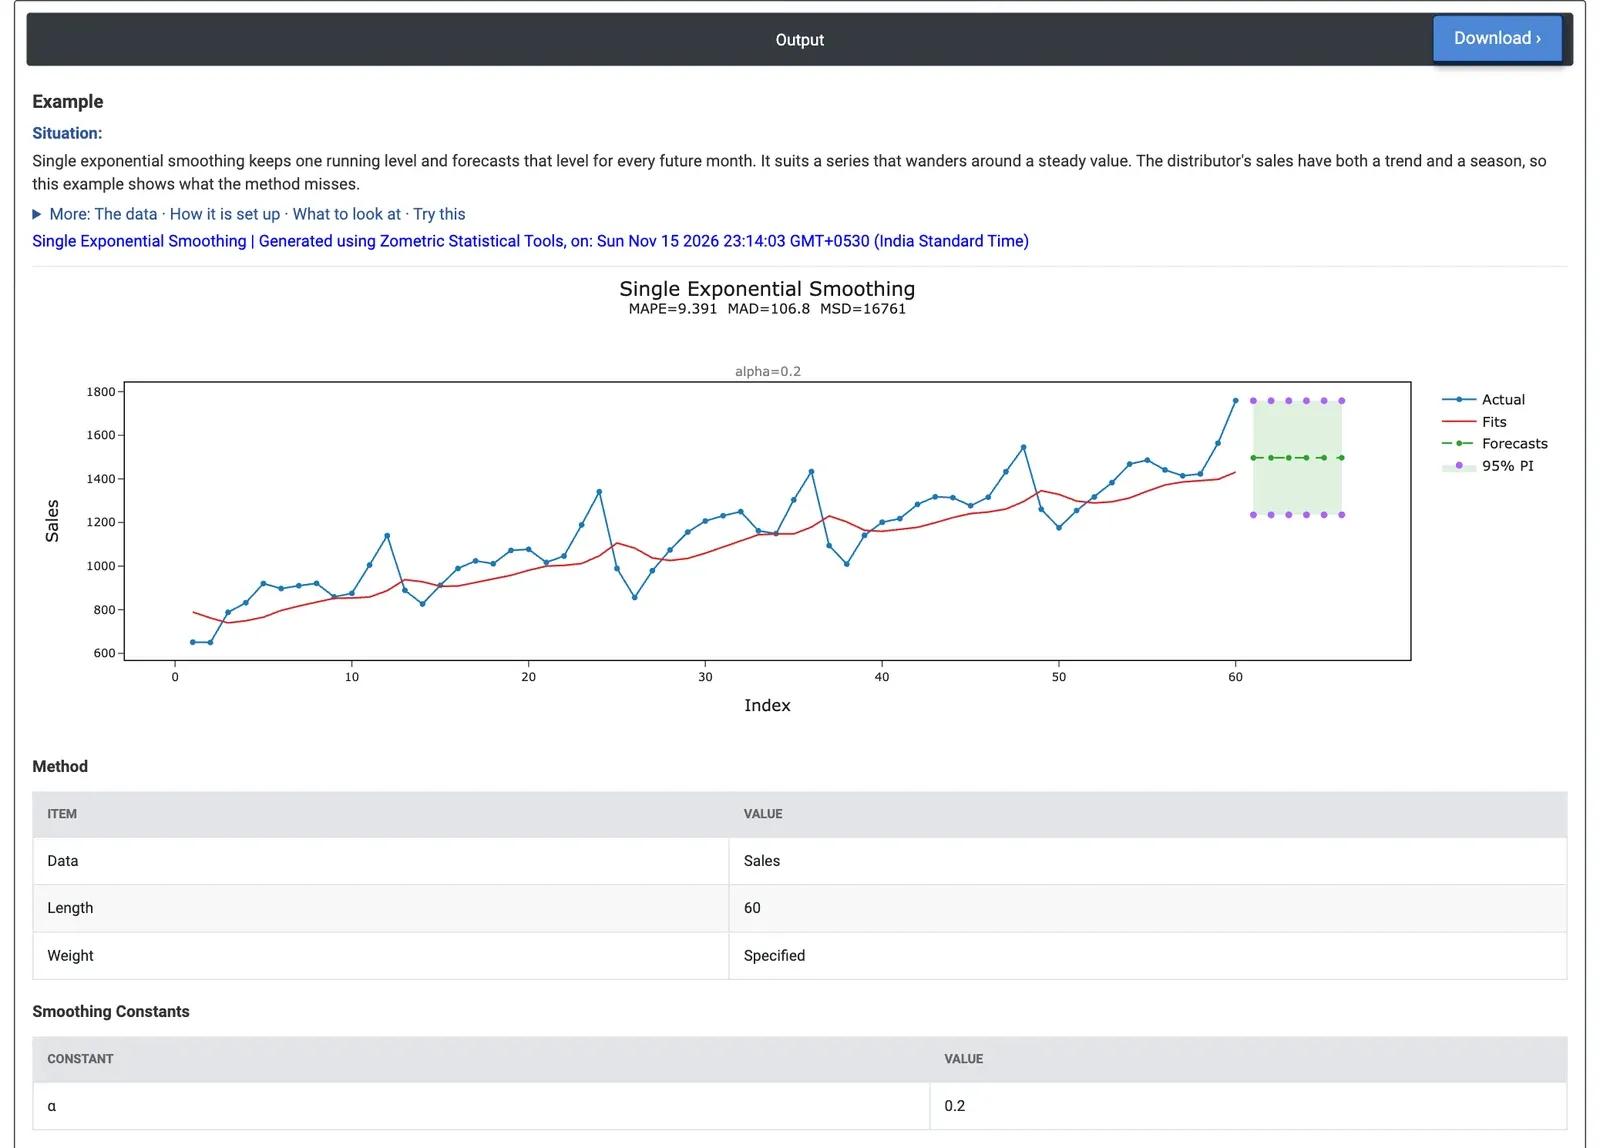
그림 2 — 평활선이 증가하는 매출보다 뒤처지며, 예측값 6개는 모두 1,496.7로 같습니다.
계산 예제
한 가전제품 유통업체에는 60개월(2020년 1월~2024년 12월)의 판매 수량 데이터가 있습니다. 판매 분석가는 가장 단순한 예측 방법을 먼저 시도하여 무엇을 놓치는지 확인합니다. 분석가는 Variable (Y) = Sales를 선택하고, Weight to use in smoothing (alpha) = 0.2를 입력하며, Starting values = From the data와 K = 6을 유지하고, 2025년 1월~6월에 대해 Number of forecasts = 6으로 설정합니다.
예측값 6개는 모두 1,496.7개로 같으며, 95% 구간은 1,234.9~1,758.4입니다. 이 방법에는 추세와 계절성이 없으므로 매출이 증가한다는 점과 1월과 2월이 항상 부진하다는 점을 볼 수 없습니다. 그림에서 평활선은 상승하는 데이터보다 뒤처지며 정점과 저점을 가로지릅니다. MAPE는 9.4%(MAD 106.8개)로, 이 데이터에 대한 예측 도구 중 적합이 가장 약합니다. Winters 방법은 4.2%, 분해는 2.2%에 도달합니다.
alpha를 비워 두면 최적 ARIMA 가중치는 1.43으로 1을 넘으며, 수준이 성장을 따라잡으려고 매달 과잉 반응합니다. MAPE는 6.7%로 떨어지지만, 2025년 모든 달이 12월 정점이 남긴 수준인 1,817로 예측됩니다. 두 결과는 의사결정 측면에서 같은 말을 합니다. 이 시계열에는 추세와 계절성이 있는 방법이 필요합니다. 단일 평활은 데이터에 둘 다 없을 때만 적합한 도구입니다.
자주 묻는 질문
단일 지수 평활은 언제 사용해야 합니까?
성숙 단계 예비 부품의 주간 수요, 일일 폐기율, 안정된 라인의 충전 중량처럼 뚜렷한 추세나 계절성 없이 비교적 일정한 값 주위를 오가는 시계열에 단일 지수 평활을 사용하십시오. 추세가 있는 데이터에는 이중 지수 평활을, 계절성이 있는 데이터에는 Winters 방법 또는 분해를 사용하십시오.
평활 가중치 alpha는 어떻게 선택합니까?
0.1~0.3과 같은 작은 alpha는 천천히 반응하는 매끄러운 선을 만들고, 큰 alpha는 최신 값을 가깝게 따라갑니다. alpha를 비워 두면 최적 가중치는 ARIMA(0,1,1) 적합에서 나오며, alpha = 1 − MA 계수입니다. 최적 alpha가 1을 넘으면 시계열에 추세가 있다는 신호입니다.
단일 지수 평활의 예측값이 모두 같은 이유는 무엇입니까?
이 방법에는 수준만 있고 추세나 계절 성분이 없으므로 모든 예측값은 예측 기준 시점의 마지막 평활값과 같습니다. 예측 한계는 예측값에 z × 1.25 × MAD를 더하고 뺀 값이므로 앞선 모든 기간에서 폭도 같습니다.
예측 정확도는 어떻게 측정합니까?
정확도는 데이터와 한 단계 앞선 적합값 사이의 오차에 기반한 세 가지 척도로 보고됩니다. 평균 절대 백분율 오차인 MAPE, 평균 절대 오차인 MAD, 평균 제곱 오차인 MSD입니다. 값이 낮을수록 적합이 더 가깝다는 뜻이며, 같은 데이터에서 예측 방법을 비교하는 데 사용할 수 있습니다.