
T² – 일반화 분산 관리도
T² – 일반화 분산 관리도는 부품마다 함께 측정한 둘 이상의 관련 특성을, 변수 수보다 큰 동일한 크기의 부분군으로 모니터링합니다. T² 관리도는 상관을 고려하여 공정 중심에서 멀리 떨어진 부분군 평균을 표시하고, |S| 관리도는 결합 산포의 증가를 표시합니다. 다변량 정규 데이터와 독립적인 부분군을 가정하며, Phase 1 또는 Phase 2 관리 한계를 지원하고 요약 표와 특수 원인 표를 보고합니다.
최종 검토
핵심 요점
T² – 일반화 분산 관리도는 상관된 둘 이상의 특성을 부분군으로 모니터링합니다. T² 관리도는 평균 벡터의 이동을, 일반화 분산 관리도는 결합 산포의 증가를 탐지합니다.
목적
T² – 일반화 분산 관리도는 부품마다 함께 측정한 둘 이상의 관련 특성을 부분군으로 한 페이지에서 모니터링합니다. Hotelling T² 관리도는 변수 사이의 상관을 고려하여 부분군의 평균 벡터가 공정 중심에서 벗어났는지를 묻고, 일반화 분산 관리도는 변수들의 결합 산포가 커졌는지를 묻습니다. 선삭 부품의 지름과 길이처럼 특성들이 함께 움직일 때는 특성별 Xbar 관리도와 R 관리도를 따로 사용하는 대신 이 관리도를 사용합니다.
주요 기능
- 같은 부분군 데이터에 대해 T² 관리도와 일반화 분산(|S|) 관리도를 위아래로 함께 표시합니다.
- 변수는 몇 개든(둘 이상) 가능하며, 부분군은 크기가 같고 변수 수보다 커야 합니다.
- 선택한 오경보율(기본값 0.0027, 3σ에 해당)에서의 T² 한계.
- Phase 1(데이터에서 한계 계산) 또는 Phase 2(과거 평균 벡터와 공분산 행렬에서 한계 계산).
- 선택한 부분군만으로 모수를 추정하는 기능, 행 부분집합, x축 레이블 열.
- 각 관리도의 요약 표와 특수 원인 표.
통계적 방법
데이터에는 p개의 변수가 있으며, m개의 부분군 각각에서 부품 n개로 측정합니다. 각 부분군에 대해 도구는 평균 벡터 x̄ⱼ와 표본 공분산 행렬 Sⱼ를 계산합니다. Phase 1에서 공정 공분산은 Sⱼ의 평균인 합동 행렬 S̄이고, 공정 중심은 부분군 평균의 총평균 x̿입니다. 각 부분군의 통계량은 T²ⱼ = n·(x̄ⱼ − x̿)′ S̄⁻¹ (x̄ⱼ − x̿)로, 평균이 중심에서 떨어진 마할라노비스 거리의 제곱에 n을 곱한 값입니다. 관리 상한은 UCL = p(m − 1)(n − 1) / (mn − m − p + 1) × F(1 − α; p, mn − m − p + 1)이고, 하한은 0이며, 중심선은 Minitab과 같이 동일한 분포의 중앙값 p(m − 1)(n − 1) / (mn − m − p + 1) × F(0.5; p, mn − m − p + 1)입니다. 과거 평균 벡터와 공분산 행렬(Phase 2)을 사용하면 이것들이 x̿와 S̄을 대체하고, UCL과 중심선은 χ² 분위수 χ²(1 − α; p)와 χ²(0.5; p)가 됩니다.
일반화 분산 관리도는 각 부분군의 공분산 행렬의 행렬식 |Sⱼ|를 그리며, 이는 모든 변수의 결합 산포를 나타내는 하나의 수입니다. Σ̂ = |S̄|(또는 과거 공분산 행렬의 행렬식)와 i = 1에서 p까지의 상수 b₁ = Π(n − i) / (n − 1)ᵖ, b₂ = Π(n − i) × [Π(n − i + 2) − Π(n − i)] / (n − 1)²ᵖ를 사용하면 한계는 CL = b₁Σ̂, UCL = Σ̂(b₁ + K√b₂), LCL = max(0, Σ̂(b₁ − K√b₂))이며, K의 기본값은 3입니다(Montgomery의 3σ 한계).
두 관리도 모두에서 한계를 벗어난 점만 신호이며, 런 규칙은 이처럼 치우친 통계량에는 적용되지 않습니다. T² 신호는 부분군 평균이 벗어났음을 알려 주지만 어느 변수가 움직였는지는 알려 주지 않으므로, 그 부분군의 평균을 다른 부분군과 비교하십시오. 이 방법은 변수가 다변량 정규분포를 따르고 부분군이 서로 독립이라고 가정합니다. Phase 1 한계에는 관리 이탈 상태인 부분군도 포함되므로, 특별한 원인을 제거한 후에는 해당 부분군을 제외하고 다시 계산하십시오.
입력 항목 및 옵션
항목 | 설명 |
Variables | 필수. 부품마다 측정한 관련 특성인 둘 이상의 수치형 열입니다. |
Subgroup indicator | 필수. 각 행의 부분군을 나타내는 열입니다. 모든 부분군의 크기 n이 같아야 하며, n은 변수 수보다 커야 합니다. |
Alpha (T² false alarm rate) | 기본값은 0.0027이며 범위는 0.0001~0.5입니다. T² UCL만 설정합니다. |
Check Rule 1 (Generalized Variance) / K for Rule 1 (Generalized Variance) | 선택하면 기본값은 K = 3입니다. 선택을 해제하면 일반화 분산 한계를 벗어난 점을 표시하지 않습니다. K는 |S|의 표준편차 단위로 일반화 분산 한계의 폭을 설정합니다. T² 한계는 Alpha로 설정합니다. |
X scale | 수평 축의 레이블로 사용하는 선택 열입니다. |
Historical mean vector (T²) | 선택 사항이며 변수마다 값이 하나씩입니다. T² 관리도에만 사용하며, 과거 공분산 행렬과 함께일 때만 사용합니다(Phase 2). |
Historical covariance matrix | 선택 사항인 p × p 행렬이며, 행은 ";"로, 값은 "," 또는 공백으로 구분하고 예를 들어 4.0,1.2;1.2,3.0입니다. 일반화 분산 관리도는 단독으로 사용하고, T² 관리도는 평균 벡터와 함께 사용합니다. |
Include or Exclude / Specify which rows | 기본적으로 모든 행이며, 지정한 행 번호를 포함하거나 제외할 수 있습니다(예: 4 7 11:14). |
Specify subgroups to estimate parameters (mean vector & covariance matrix) / Subgroups | 중심과 합동 공분산을 추정할 때 나열한 부분군(예: 14:15)을 제외(Omit, 기본값)하거나 사용(Use)합니다. 모든 부분군은 여전히 그려집니다. |
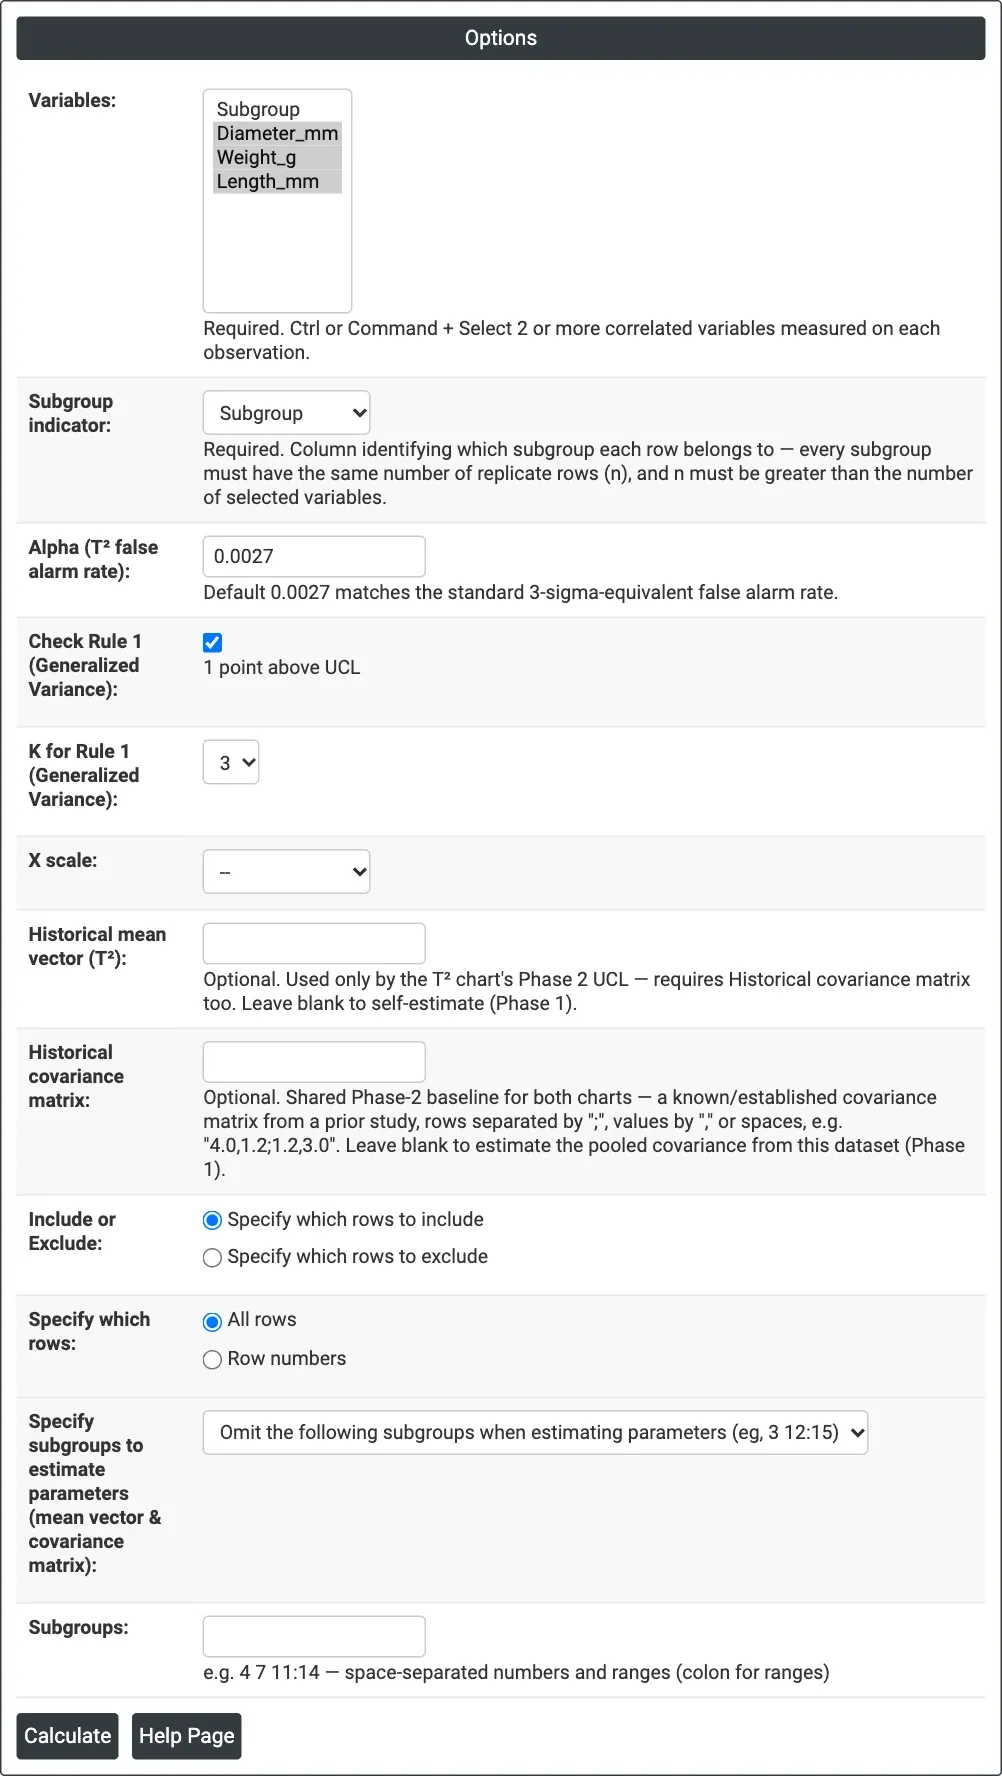
그림 1 — 예제의 옵션: 부품 4개씩의 부분군에서 Diameter_mm, Weight_g, Length_mm, alpha 0.0027, Phase 1.
출력 설명
- T² Chart — 각 부분군의 T²와 중심선(T²의 중앙값), UCL, LCL = 0이며, UCL을 넘는 점은 빨간색입니다.
- T² summary table — Variables, p(변수 수), m(사용한 부분군 수), n(부분군 크기), Alpha, Center Line(T²의 중앙값), UCL, Phase(1은 자체 추정, 2는 알려진 기준).
- Generalized Variance Chart — 각 부분군의 |S|와 CL, UCL, LCL.
- Generalized variance summary table — Variables, p, m, n, 상수 b1과 b2, CL, LCL, UCL, Phase.
- 각 관리도의 Nelson's Rules table — UCL을 넘는 부분군 또는 No special causes found.
- Download를 통한 PDF 내보내기.
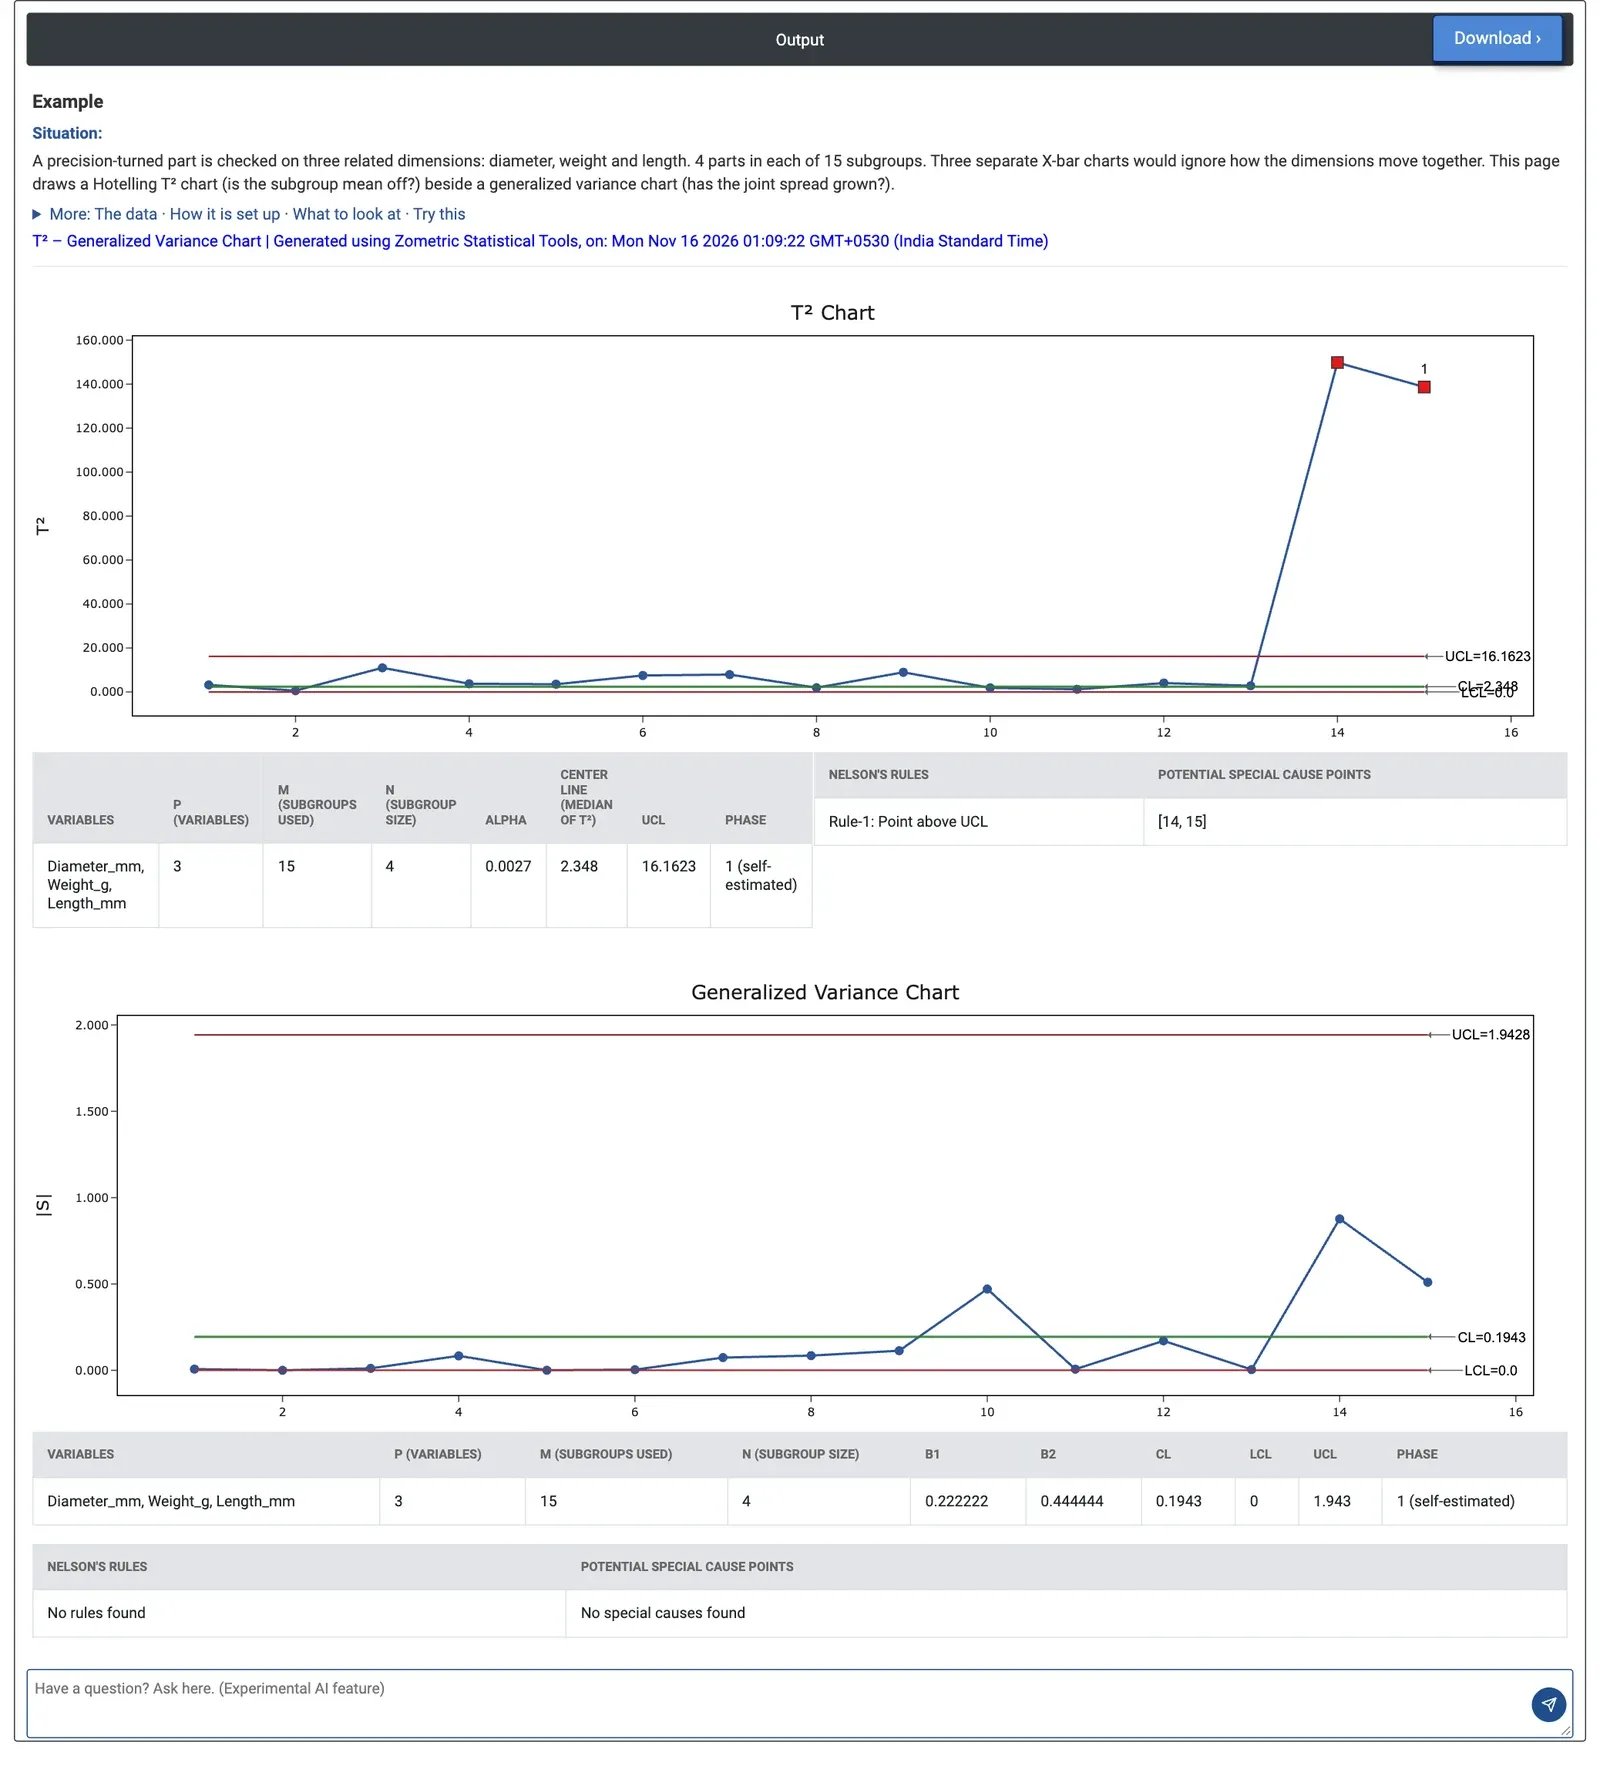
그림 2 — 부분군 14와 15는 T² UCL 16.1623을 크게 넘지만, 모든 |S|는 일반화 분산 UCL 1.943 아래에 머뭅니다.
계산 예제
정밀 선삭 부품을 지름, 무게, 길이의 세 가지 관련 치수로 검사합니다. 15개 부분군 각각에서 부품 4개를 채취합니다. 지름과 길이는 강한 상관(r = 0.83)이 있으므로 Xbar 관리도 세 개를 따로 사용하면 부분군을 공정하게 판단할 수 없습니다. Variables = Diameter_mm, Weight_g, Length_mm, Subgroup indicator = Subgroup, Alpha = 0.0027이며 과거 값은 사용하지 않습니다.
T² 관리도의 UCL은 16.1623이고 중심선은 2.348입니다. 부분군 1~13의 T²는 0.58~10.99이지만, 부분군 14와 15는 149.8과 138.7에 이르러 표시됩니다. 평균을 보면 이유를 알 수 있습니다. 지름은 29.07 mm와 29.89 mm로 이전의 약 24.4~25.3 mm와 다르고, 길이는 13.73 mm와 14.35 mm로 이전의 약 11.3~12.2 mm와 다르며, 부분군 14는 무게도 55.9 g으로 가볍습니다. 일반화 분산 관리도는 CL 0.1943, UCL 1.943이며, 가장 큰 |S|는 부분군 14의 0.877이므로 결합 산포는 신호를 낼 만큼 커지지 않았습니다.
이는 공정이 더 불안정해진 것이 아니라 공정 중심이 이동한 것이므로, 팀은 추가 변동의 원인이 아니라 부분군 14 이전의 설정 또는 공구 변경을 찾아야 합니다. 안정적인 기간에서 한계를 구하기 위해 분석자는 Subgroups에 14:15를 입력하고 Omit을 선택합니다. T² UCL은 16.5221(m = 13)이 되고 부분군 14와 15는 여전히 신호를 냅니다. 일반화 분산 한계는 CL 0.09013, UCL 0.9013으로 좁아지며, 0.877인 부분군 14는 이제 UCL 바로 아래에 있습니다. 주시할 필요는 있지만 아직 신호는 아닙니다.
자주 묻는 질문
별도의 Xbar 관리도 대신 T² 관리도는 언제 사용합니까?
선삭 부품의 지름과 길이처럼 같은 부품에서 측정한 둘 이상의 특성이 함께 움직일 때 T² 관리도를 사용합니다. Xbar 관리도와 R 관리도를 따로 사용하면 상관을 무시하여 부분군을 공정하게 판단하지 못하지만, T² 관리도는 상관을 고려하여 각 부분군 평균이 공정 중심에서 떨어진 거리를 측정합니다.
일반화 분산 관리도는 무엇을 보여 줍니까?
일반화 분산 관리도는 각 부분군의 공분산 행렬의 행렬식 |S|를 그리며, 이는 모든 변수의 결합 산포를 나타내는 하나의 수입니다. 관리 상한을 넘는 점은 결합 산포가 커졌음을 나타냅니다. 반면 T² 신호는 부분군 평균 벡터가 공정 중심에서 벗어났음을 나타냅니다.
T² 일반화 분산 관리도의 요건은 무엇입니까?
둘 이상의 수치형 변수와 부분군 지시 열이 필요합니다. 모든 부분군의 크기가 같아야 하며 그 크기는 변수 수보다 커야 합니다. 이 방법은 변수가 다변량 정규분포를 따르고 부분군이 서로 독립이라고 가정합니다. 한계를 벗어난 점만 신호이며 런 규칙은 적용되지 않습니다.
T² 신호가 나타나면 어떻게 해야 합니까?
T² 신호는 부분군 평균이 벗어났음을 알려 주지만 어느 변수가 움직였는지는 알려 주지 않으므로, 해당 부분군의 평균을 다른 부분군과 비교하십시오. Phase 1 한계에는 관리 이탈 상태인 부분군도 포함되므로, 특별한 원인을 제거한 후에는 모수 추정에서 해당 부분군을 제외하고 다시 계산하십시오.