
개별 변수 집계(Tally Individual Variables)
개별 변수 집계는 결점 유형, 교대, 공급업체 같은 범주형 데이터나 이산형 개수에 대해 선택한 열마다 도수표를 만듭니다. 개수, 백분율, 누적 개수, 누적 백분율을 원하는 조합으로 보고하며 빈 셀은 제외합니다. 행은 도수가 아니라 값 순서로 정렬되고, 각 열은 독립적으로 집계됩니다.
최종 검토
핵심 요점
개별 변수 집계는 하나 이상의 열에서 각 고유 값이 몇 번 나타나는지 세어, 열마다 개수, 백분율, 누적 개수 또는 누적 백분율이 있는 도수표를 보여 줍니다.
목적
개별 변수 집계는 하나 이상의 열에서 각 고유 값이 몇 번 나타나는지 세어 그 결과를 열마다 도수표로 보여 줍니다. 결점 유형, 교대, 라인, 공급업체, 합격/불합격 결과 같은 범주형 데이터와 이산형 개수에 사용하여, 파레토 차트를 그리거나 두 변수를 교차표로 만들기 전에 어떤 범주가 가장 흔하고 각각이 어느 정도의 비중을 차지하는지 확인합니다.
주요 기능
- 선택한 열마다 표 하나이며, 각 열은 독립적으로 집계됩니다.
- 개수, 백분율, 누적 개수, 누적 백분율을 원하는 조합으로 제공합니다.
- 텍스트 범주와 숫자 모두에 사용할 수 있습니다(각 고유 값이 하나의 범주).
- 빈 셀은 개수에서 제외합니다.
통계적 방법
선택한 각 열에서 비어 있지 않은 값을 고유 값별로 묶고, 각 값을 가진 행의 수가 그 개수 nⱼ입니다. 합계 N = Σnⱼ는 해당 열에서 비어 있지 않은 셀의 수이므로 열마다 합계가 다를 수 있습니다. 표의 행은 값 순서로 정렬되며, 텍스트는 알파벳 순서, 숫자는 오름차순입니다.
백분율 = 100 × nⱼ / N이며 소수 둘째 자리로 반올림합니다. 누적 개수는 표를 따라 내려가며 합산한 개수이고, 누적 백분율은 100 × (누적 합) / N으로 마지막 행에서 100에 도달합니다. 행이 도수 순서가 아니라 값 순서이므로, 누적 열은 순서가 있는 값(예: 단위당 결점 수 또는 1에서 5까지의 평점)에 가장 유용하며, 이때 각 값 이하의 비중을 나타냅니다. 범주를 도수순으로 정렬하고 상위 몇 개의 비중을 읽으려면 파레토 차트를 사용하십시오.
각 열은 독립적으로 집계되므로 표는 변수들이 서로 어떻게 관련되는지(예: 어느 라인이 어느 결점을 만드는지)를 보여 주지 않습니다. 이를 위해서는 교차표 및 카이제곱을 사용하십시오.
입력 항목 및 옵션
항목 | 설명 |
Variables | 필수. 하나 이상의 열입니다(여러 개를 선택하려면 Ctrl 또는 Cmd). 각 열마다 별도의 표가 생성됩니다. |
Counts | 기본적으로 선택되어 있습니다. 각 값을 가진 행의 수입니다. |
Percents | 기본적으로 꺼져 있습니다. 열에서 비어 있지 않은 행 중 각 값이 차지하는 비중입니다. |
Cumulative counts | 기본적으로 꺼져 있습니다. 표의 순서대로 합산한 개수입니다. |
Cumulative percents | 기본적으로 꺼져 있습니다. 표의 순서대로 합산한 값을 백분율로 나타낸 것입니다. 네 가지 통계량 중 적어도 하나는 선택해야 합니다. |
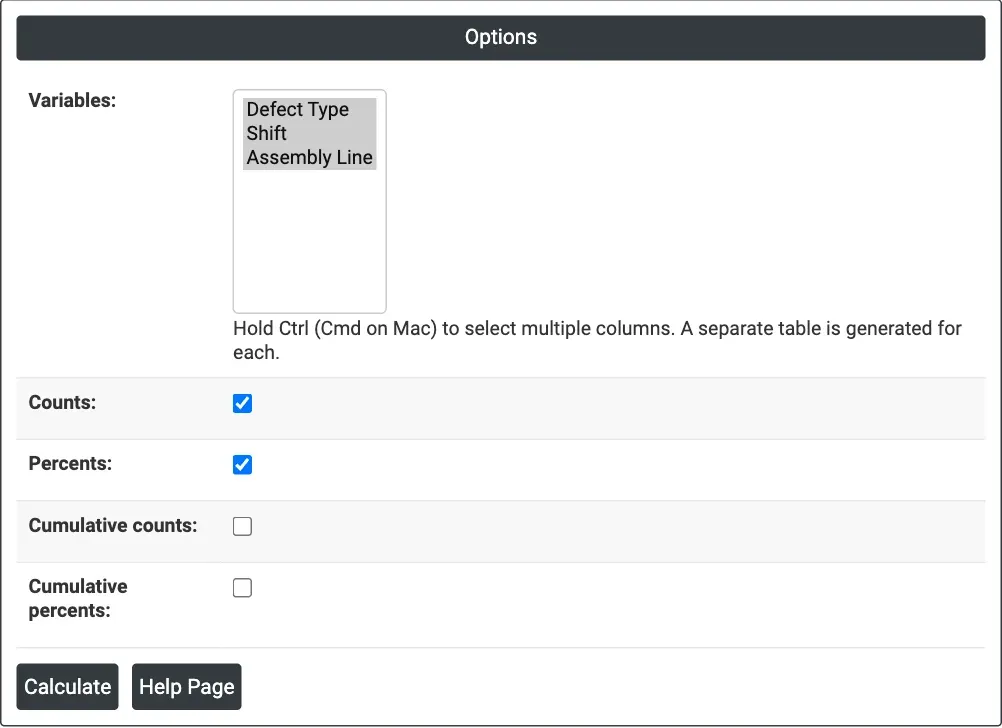
그림 1 — 예제의 옵션: Defect Type, Shift, Assembly Line이며 Counts와 Percents를 선택했습니다.
출력 설명
- Tally for <column> — 선택한 열마다 표 하나이며, 고유 값과 선택한 열 Count, Percent, CumCount, CumPercent가 포함됩니다.
- Download를 통한 PDF 내보내기.
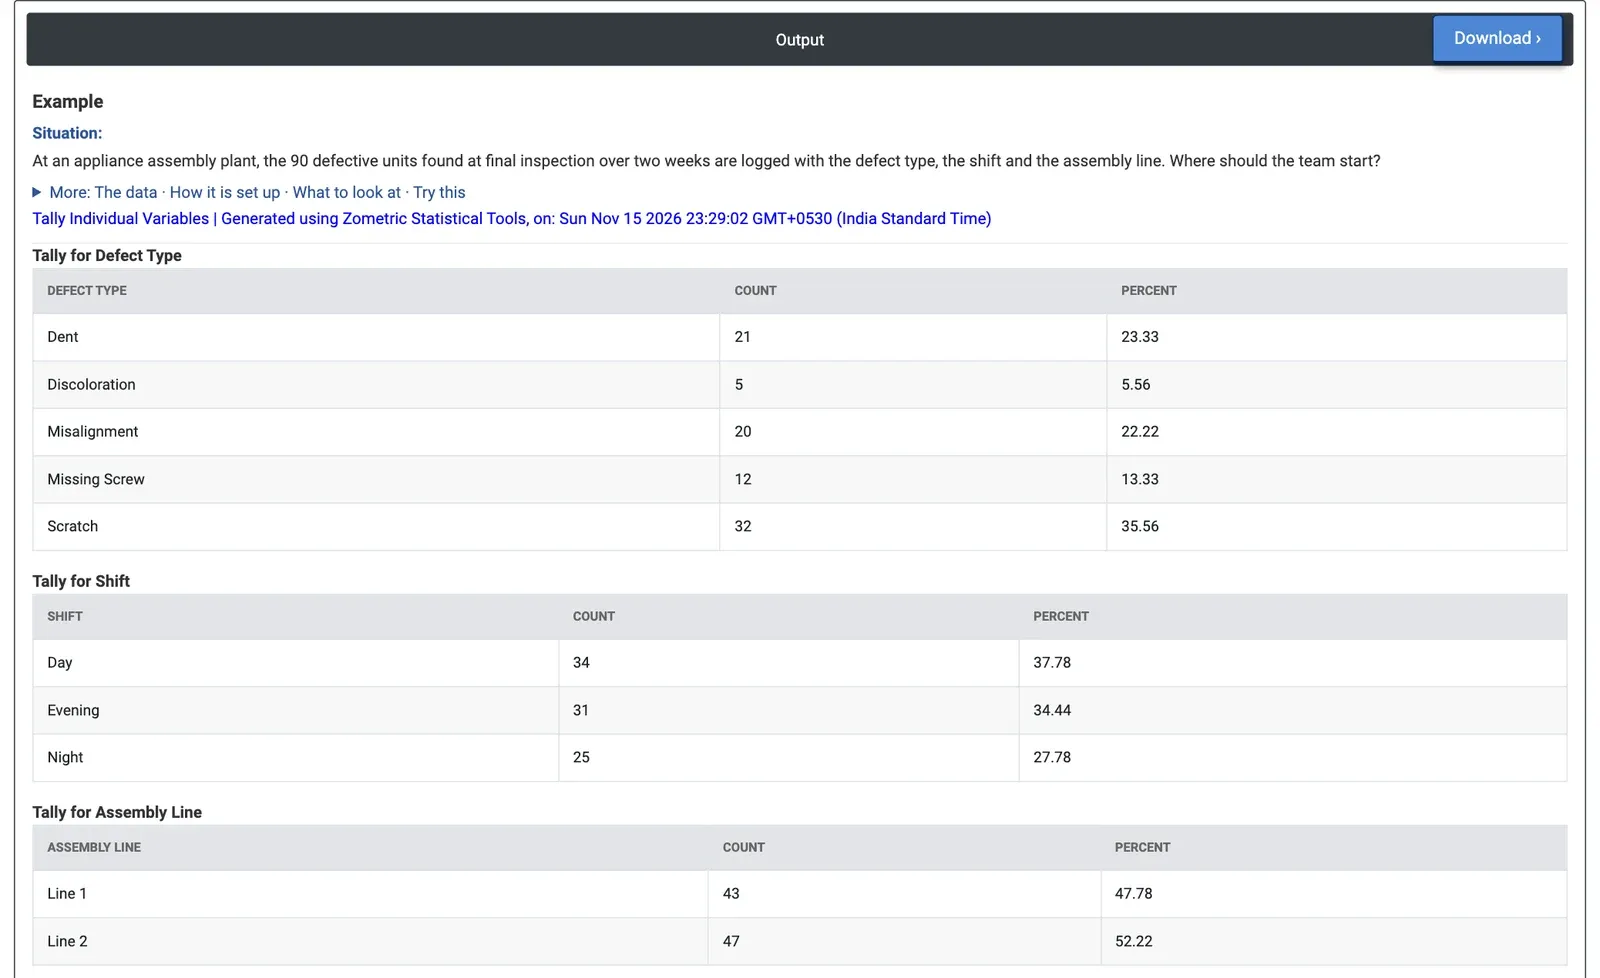
그림 2 — 결점 유형, 교대, 조립 라인별 불량품 90개의 개수와 백분율.
계산 예제
한 가전제품 조립 공장에서 2주 동안 최종 검사에서 발견된 불량품 90개가 결점 유형, 교대, 조립 라인과 함께 기록되어 있습니다. 품질 팀은 어디서부터 시작할지 결정하기 위한 빠른 요약을 원합니다. Variables = Defect Type, Shift, Assembly Line으로 하고 Counts와 Percents를 선택합니다.
Scratch가 가장 흔한 결점이며(32개, 35.56%), 그다음이 Dent(21개, 23.33%)와 Misalignment(20개, 22.22%)입니다. 이 세 가지가 90개 결점 중 73개, 약 81%를 차지합니다. Missing Screw(12개)와 Discoloration(5개)은 더 적습니다. 교대별로는 결점이 꽤 고르게 분포합니다. Day 34개, Evening 31개, Night 25개입니다. 라인별로도 거의 같습니다. Line 1은 43개, Line 2는 47개입니다.
팀은 스크래치부터, 그다음 찌그러짐과 정렬 불량부터 시작해야 합니다. 교대나 라인 어느 것도 단독으로는 두드러지지 않으므로, 다음 단계는 조합을 살펴보는 것입니다. Defect Type과 Assembly Line의 교차표를 보면 Line 2가 스크래치 32개 중 21개를, Line 1이 정렬 불량 20개 중 14개를 만들어, 두 라인의 합계는 비슷해도 서로 문제가 다릅니다. 여기서 Cumulative percents를 선택하면 알파벳 순서(Dent, Discoloration, Misalignment 등)로 누적 합이 추가되며, 이는 순위가 아닙니다. 순위가 있는 보기는 Defect Type의 파레토 차트로 얻을 수 있습니다.
자주 묻는 질문
개별 변수 집계는 무엇을 합니까?
하나 이상의 열에서 각 고유 값이 몇 번 나타나는지 세어 열마다 별도의 도수표를 제공합니다. 텍스트 범주와 숫자 모두에 사용할 수 있고, 빈 셀은 제외하며, 개수, 백분율, 누적 개수, 누적 백분율을 보여 줄 수 있습니다. 백분율은 열에서 비어 있지 않은 행 중 각 값이 차지하는 비중입니다.
집계 대신 파레토 차트는 언제 사용해야 합니까?
집계는 행을 도수가 아니라 값 순서로, 즉 텍스트는 알파벳 순서, 숫자는 오름차순으로 정렬합니다. 범주를 도수순으로 정렬하고 상위 몇 개의 비중을 읽으려면 파레토 차트를 사용하십시오. 집계의 누적 백분율은 평점이나 단위당 결점 수처럼 순서가 있는 값에 가장 유용합니다.
집계로 두 변수가 어떻게 관련되는지 알 수 있습니까?
아니요. 각 열은 독립적으로 집계되므로 표는 변수들이 서로 어떻게 관련되는지(예: 어느 라인이 어느 결점을 만드는지)를 보여 주지 않습니다. 이를 위해서는 두 변수의 조합을 세는 교차표 및 카이제곱을 사용하십시오.