
2-표본 포아송 비율 검정(2-Sample Poisson Rate Test)
2-표본 포아송 비율 검정은 알려진 노출량에 대한 독립 사건의 개수를 사용하여 두 집단의 사건 발생률을 비교합니다. 비율 차이를 신뢰구간으로 추정하고 정규 근사로 검정하며, 가설 차이가 0이면 정확 이항 검정도 제공합니다. 사건이 일정한 비율로 독립적으로 발생한다고 가정합니다. 데이터는 요약값, 두 개의 열, 또는 하나로 쌓은 열일 수 있습니다.
최종 검토
핵심 요점
2-표본 포아송 비율 검정은 단위당 결점 수나 교대당 정지 횟수와 같이 두 집단에서 사건이 발생하는 빈도를 비교하며, 비율 차이를 신뢰구간과 정확 검정 또는 정규 검정으로 추정합니다.
목적
2-표본 포아송 비율 검정은 주간·야간 교대의 교대당 정지 횟수, 두 라인의 단위당 결점 수, 변경 전후의 월간 불만 건수와 같이 두 집단에서 사건이 발생하는 비율을 비교합니다. 두 비율의 차이를 신뢰구간으로 추정하고, 이 차이가 0과 다른지 또는 다른 가설 차이와 다른지를 검정합니다. 알려진 노출량에 대한 독립 사건의 개수에 사용하며, 합격/불합격 결과에는 2-비율 검정을 사용합니다.
주요 기능
- 요약된 개수, 두 개의 개수 열, 또는 개수 열 하나와 표본 ID 열로 입력하는 데이터.
- 가설 차이가 0일 때 나란히 제공되는 정확 검정(조건부 이항)과 정규 근사.
- 각각의 비율 또는 합동 비율로 구하는 차이의 분산.
- 양측 또는 단측 대립가설과, 차이에 대한 신뢰구간 또는 단측 한계.
- 8시간 교대와 12시간 교대처럼 두 표본에 서로 다른 관측 길이를 사용할 수 있습니다.
통계적 방법
Nᵢ개의 단위가 있는 표본 i에서 각 단위를 길이 tᵢ(Observation length)만큼 관측하면 노출량은 Tᵢ = Nᵢ·tᵢ이고, 전체 사건이 Xᵢ개이면 비율은 λ̂ᵢ = Xᵢ / Tᵢ입니다. 추정 차이는 D = λ̂₁ − λ̂₂, 즉 Sample 1에서 Sample 2를 뺀 값입니다. 두 열 또는 쌓은 데이터에서 Nᵢ는 표본의 비어 있지 않은 개수의 수이고 Xᵢ는 그 합입니다.
정규 근사: z = (D − D₀) / SE이며 D₀는 가설 차이입니다. Estimate the rates separately에서는 SE = √(λ̂₁ / T₁ + λ̂₂ / T₂)이고, Use the pooled estimate of the rates에서는 SE = √[λ̂ₚ(1 / T₁ + 1 / T₂)]이며 λ̂ₚ = (X₁ + X₂) / (T₁ + T₂)입니다. 두 노출량이 같으면 두 방법의 SE가 같습니다. p-값은 표준정규분포에서 구하며, 차이에 대한 신뢰구간은 D ± z·SE(또는 단측 한계)입니다.
정확 검정은 D₀ = 0일 때만 제공됩니다. 비율이 같다면 전체 X₁ + X₂ 중 개수 X₁은 확률 T₁ / (T₁ + T₂)인 이항분포를 따릅니다. 단측 p-값은 이항분포의 꼬리이며 양측 p-값은 더 작은 꼬리의 두 배입니다. 개수가 적을 때는 정확 검정이 선호됩니다. 두 방법 모두 각 집단 내에서 사건이 일정한 비율로 독립적으로 발생한다고 가정합니다.
입력 항목 및 옵션
항목 | 설명 |
Data | Summarized data(기본값), Each sample is in its own column 또는 Both samples are in one column입니다. |
Sample 1 / Sample 2 | Each sample is in its own column인 경우: 두 개수 열입니다. |
Samples / Sample IDs | Both samples are in one column인 경우: 개수 열과 각 행의 표본을 나타내는 열입니다(서로 다른 값이 정확히 두 개여야 하며, 먼저 발견된 값이 Sample 1입니다). |
Sample 1 sample size / Sample 1 total occurrences / Sample 2 sample size / Sample 2 total occurrences | Summarized data인 경우: 각 표본의 단위 수와 총 사건 수입니다. |
Hypothesized difference | 기본값은 0입니다. 귀무가설 하에서 λ₁ − λ₂의 값이며, 정확 검정은 0일 때만 제공됩니다. |
Confidence level | 기본값은 95이며, 75~100입니다. |
Alternative hypothesis | Difference ≠ hypothesized difference(기본값), Difference < hypothesized difference 또는 Difference > hypothesized difference입니다. |
Test method | 정규 근사에 대해 Estimate the rates separately(기본값) 또는 Use the pooled estimate of the rates입니다. |
Observation length (Sample 1) / Observation length (Sample 2) | 기본값은 1입니다. 각 단위의 노출량이며, 비워 두면 Sample 2는 Sample 1의 길이를 사용합니다. |
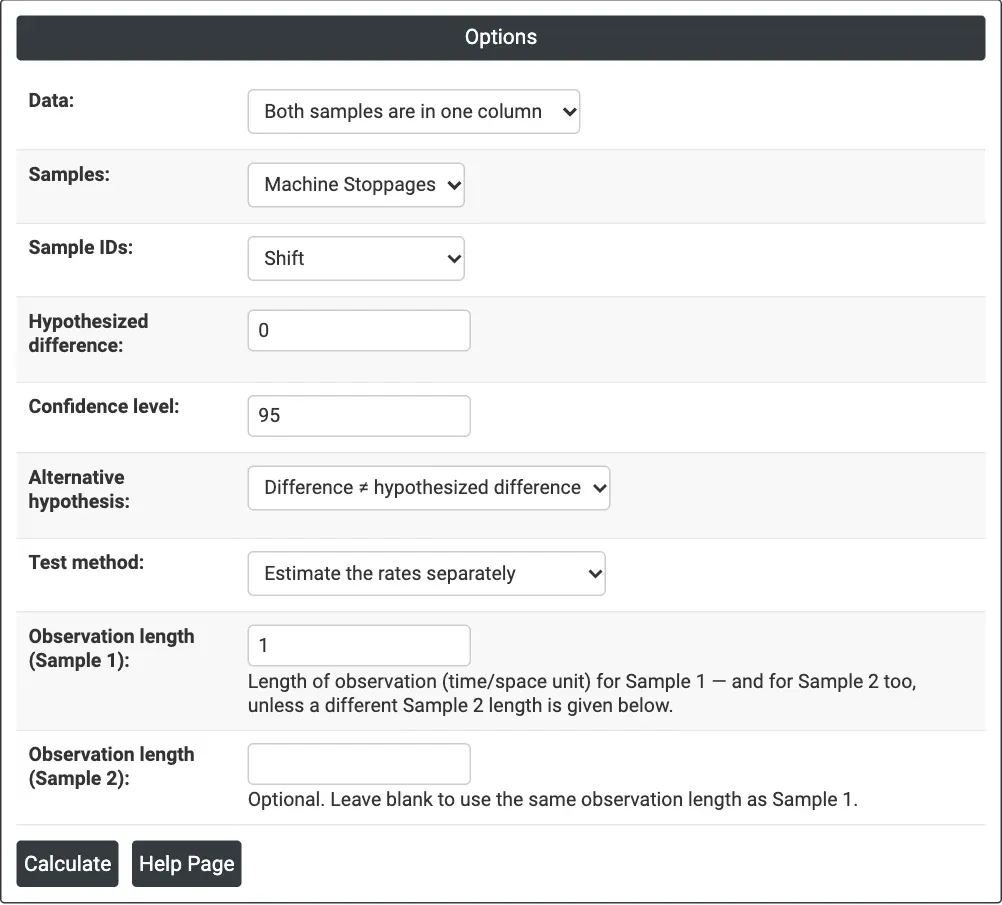
그림 1 — 예제의 옵션: Shift를 표본 ID로 하여 하나의 열에 쌓은 Machine Stoppages, 양측, 비율을 각각 추정.
출력 설명
- Method — 어느 표본이 λ₁이고 어느 표본이 λ₂인지, 그리고 차이 λ₁ − λ₂입니다.
- Descriptive Statistics — 각 표본의 Sample, N, Total Occurrences, Sample Rate입니다.
- Estimation for Difference — Estimated Difference와 그 신뢰구간(또는 상한이나 하한)입니다.
- Test — 귀무가설과 대립가설, 그리고 Exact 및 Normal approximation 방법의 Z-Value와 P-Value 표이며, 합동 추정을 사용한 경우에는 주석이 붙습니다.
- Download를 통한 PDF 내보내기.
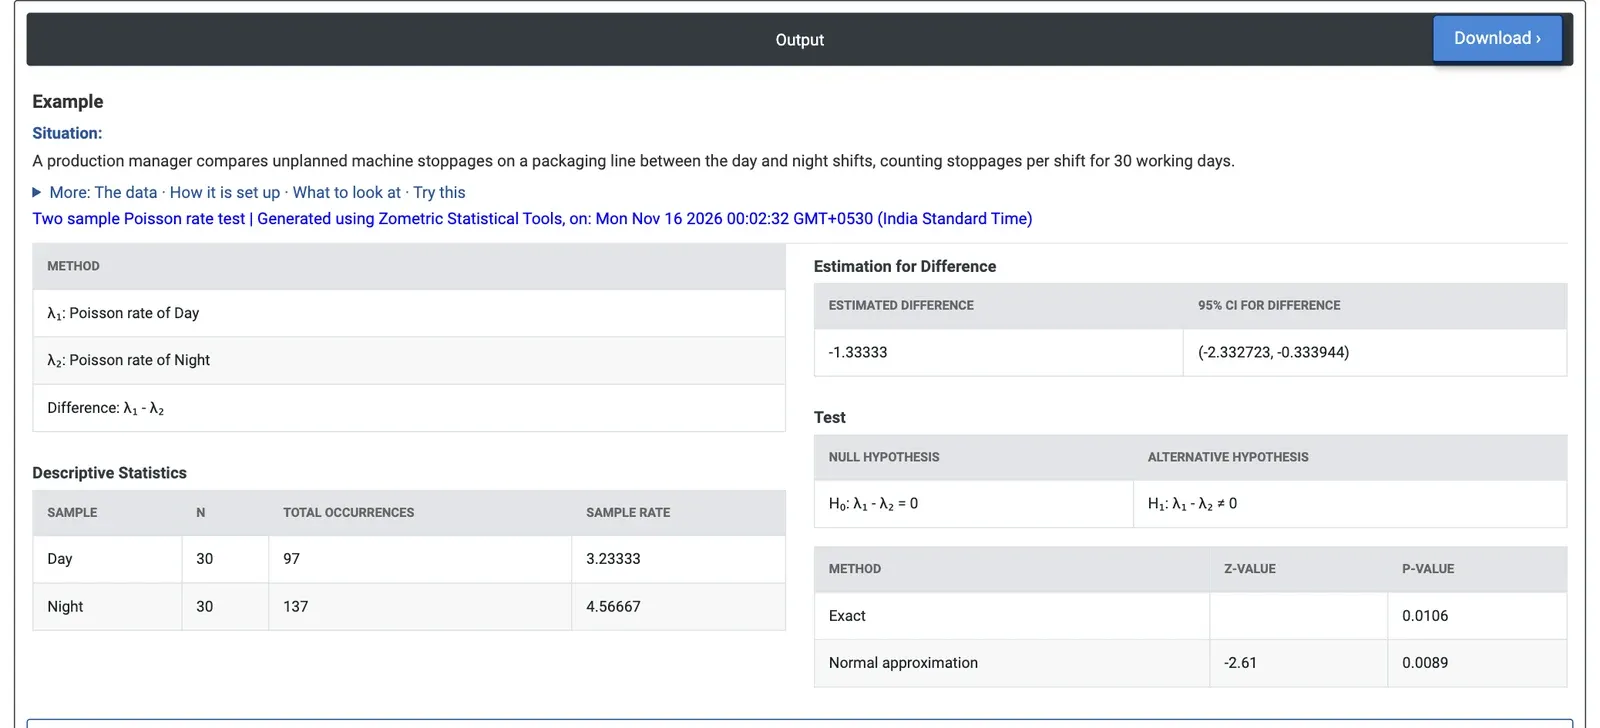
그림 2 — 주간 교대는 평균 3.233회, 야간 교대는 4.567회 정지합니다. 차이의 95% 신뢰구간 −2.333~−0.334는 0을 포함하지 않습니다(정확 p = 0.0106).
계산 예제
한 생산 관리자가 포장 라인에서 계획되지 않은 기계 정지를 주간 교대와 야간 교대 사이에서 비교하며, 근무일 30일 동안 각 교대의 정지 횟수를 셉니다. Data = Both samples are in one column, Samples = Machine Stoppages, Sample IDs = Shift, Hypothesized difference = 0, Confidence level = 95, 양측, Test method = Estimate the rates separately, Observation length = 1(한 교대)로 설정합니다.
주간 교대는 30개 교대에서 정지가 97회로 교대당 3.233회였고, 야간 교대는 30개 교대에서 137회로 교대당 4.567회였습니다. 추정 차이인 주간 빼기 야간은 교대당 정지 −1.333회이고 95% 신뢰구간은 −2.333~−0.334로, 구간이 0을 포함하지 않습니다. 정확 검정은 p = 0.0106, 정규 근사는 z = −2.61, p = 0.0089를 줍니다. 야간 교대의 정지가 주간 교대보다 약 40% 더 많습니다.
두 표본 모두 30개 교대를 포함하므로 Use the pooled estimate of the rates도 여기서는 같은 z와 p-값을 줍니다. 관리자가 데이터를 수집하기 전에 야간 교대가 더 나쁠 것으로 예상했다면 Difference < hypothesized difference는 p = 0.0053(정확)과 차이의 95% 상한 −0.495를 줍니다. 다음 단계는 추가 정지로 생산량 손실이 더 커지기 전에 야간에 무엇이 다른지, 예를 들어 인원 배치, 교체 작업, 자재를 알아보는 것입니다.
자주 묻는 질문
2-표본 포아송 비율 검정은 언제 사용합니까?
주간·야간 교대의 교대당 정지 횟수, 두 라인의 단위당 결점 수, 변경 전후의 월간 불만 건수와 같이, 알려진 노출량에 대한 독립 사건의 개수로 두 집단에서 사건이 발생하는 비율을 비교할 때 사용합니다. 합격/불합격 결과에는 대신 2-비율 검정을 사용합니다.
정확 검정과 정규 근사의 차이는 무엇입니까?
정확 검정은 전체 개수를 조건으로 합니다. 비율이 같다면 Sample 1의 개수는 전체 노출량에서 차지하는 비중과 같은 확률의 이항분포를 따릅니다. 가설 차이가 0일 때만 제공되며 개수가 적을 때 선호됩니다. 정규 근사는 각각의 또는 합동 표준오차를 사용하는 z 통계량을 사용합니다.
2-표본 포아송 비율 검정의 가정은 무엇입니까?
정확 방법과 정규 방법 모두 각 집단 내에서 사건이 일정한 비율로 독립적으로 발생한다고 가정합니다. 각 표본의 비율은 총 사건 수를 노출량(단위 수 × 관측 길이)으로 나눈 값이므로, 8시간 교대와 12시간 교대처럼 두 표본의 관측 길이가 다를 수 있습니다.
2-표본 포아송 비율 검정 결과는 어떻게 해석합니까?
출력에는 각 표본의 비율, 추정 차이(Sample 1 빼기 Sample 2)와 그 신뢰구간, 정확 방법과 정규 방법의 p-값이 제시됩니다. 차이의 신뢰구간이 0을 포함하지 않고 p-값이 작으면 두 사건 발생률이 다릅니다.