
2-표본 t 검정
2-표본 t 검정은 두 기계, 두 공급업체 또는 두 공정 설정처럼 연속형 반응을 갖는 서로 독립인 두 집단의 평균을 비교합니다. 각 집단은 근사적으로 정규분포를 따르거나 관측값이 30개 이상이어야 하며, 집단 간에 대응 관계가 없고 뚜렷한 특이치가 없어야 합니다. 합동 검정(등분산) 또는 Welch 검정을 선택합니다. 출력에는 p-값과 평균 차이에 대한 신뢰구간이 포함됩니다.
최종 검토
핵심 요점
2-표본 t 검정은 두 기계나 두 공급업체처럼 서로 독립인 두 집단의 평균이 유의하게 다른지, 아니면 관측된 차이가 무작위 변동 때문인지를 판단합니다.
2-표본 t 검정이란?
2-표본 t 검정은 서로 독립인 두 집단의 평균이 유의하게 다른지를 판단하는 통계적 방법입니다. 서로 다른 두 모집단 또는 공정 조건의 평균값을 비교하여, 관측된 차이가 실제 차이가 아니라 우연에 의한 것일 확률을 계산합니다.
예를 들어 기계 A와 기계 B의 평균 산출량, 또는 공정 변경 전후의 평균 응답 시간을 비교하는 데 사용할 수 있습니다. 이때 두 집단은 서로 아무런 관련이 없습니다.
간단한 정의: 서로 독립인 두 집단의 평균이 실제로 다른지, 아니면 보이는 차이가 단지 데이터의 무작위 변동 때문인지를 알려 주는 검정입니다.
2-표본 t 검정은 언제 사용합니까?
- 비교 대상이 서로 관련 없는 두 독립 집단 이고 그 평균을 비교하려는 경우에 사용합니다. 예를 들어 두 기계, 두 공급업체 또는 두 공정 설정이 있습니다.
- 반응 변수가 측정값, 무게, 온도, 치수와 같은 연속형 일 때 사용합니다.
- 두 집단이 개별 관측값 간의 대응이나 짝짓기 없이 따로 측정된 경우에 사용합니다.
- 어떤 공정 변경, 재료 전환 또는 운영상의 차이 가 평균 결과에 의미 있는 이동을 일으켰는지 판단하려는 경우에 사용합니다.
2-표본 t 검정의 올바른 사용 지침
- 각 집단의 데이터는 근사적으로 정규분포를 따라야하며, 그렇지 않으면 중심극한정리가 적용되도록 각 집단에 관측값이 30개 이상 있어야 합니다.
- 두 집단은 독립 이어야 합니다. 즉, 한 집단의 어떤 관측값도 다른 집단의 관측값과 관련되거나 짝지어져서는 안 됩니다.
- 검정을 실행하기 전에 두 집단이 등분산인지 이분산인지 확인하십시오. 이는 어떤 버전의 t 검정을 적용할지에 영향을 주므로 F 검정이나 Levene 검정으로 평가하십시오.
- 각 집단에서 충분한 표본 크기 를 수집하십시오. 신뢰할 수 있는 결과를 위해 집단당 관측값 20~30개 이상을 권장합니다.
- 반드시 데이터를 수집하기 전에 유의수준(alpha) 을 정하십시오. 표준 기본값은 0.05이며, 이는 실제로 차이가 없는데도 차이가 있다고 결론 내릴 위험이 5%라는 뜻입니다.
- 데이터에 뚜렷한 특이치가 없는지 확인하십시오. 극단값은 평균을 왜곡하고 검정 결과를 부풀리거나 축소할 수 있습니다.
대안: 2-표본 t 검정을 사용하지 않아야 할 때
- 두 집단이 대응되거나 짝지어진 경우(예: 같은 대상에 대한 전후 측정)에는 다음을 사용하십시오: 쌍체 t 검정
- 비교 대상이 셋 이상의 집단인 경우에는 다음을 사용하십시오: 일원배치 분산분석
- 두 집단이 다르다는 것이 아니라 실질적으로 동등하다는 것을 입증하는 것이 목표라면 다음을 사용하십시오: 2-표본 동등성 검정
- 데이터가 심하게 비정규이고 표본 크기가 작은경우에는 만-휘트니 검정 (비모수 대안)을 대신 사용하십시오.
- 가진 데이터가 원 관측값이 아니라 요약 데이터(평균, SD, n)뿐인 경우에는 다음을 사용하십시오: 2-표본 t 검정(요약값)
2-표본 t 검정 방법
절차는 다음과 같습니다.
- Zometric Statistical Software에 로그인합니다: https://statsai.zometric.com/
- 홈 페이지에서 Statistical Tool> Hypothesis Test >Two sample t test 를 선택합니다.
- 다음으로, 데이터를 직접 입력하거나 Excel 시트에서 데이터 전체를 복사(Ctrl+C)하여 여기에 붙여넣습니다(Ctrl+V).
- 다음으로, 신뢰수준과 가설 차이 값을 입력해야 합니다.
- 마지막으로, 페이지 하단의 calculate를 클릭하면 원하는 결과를 얻을 수 있습니다.
2-표본 t 검정 도구 화면은 두 부분으로 나뉩니다.
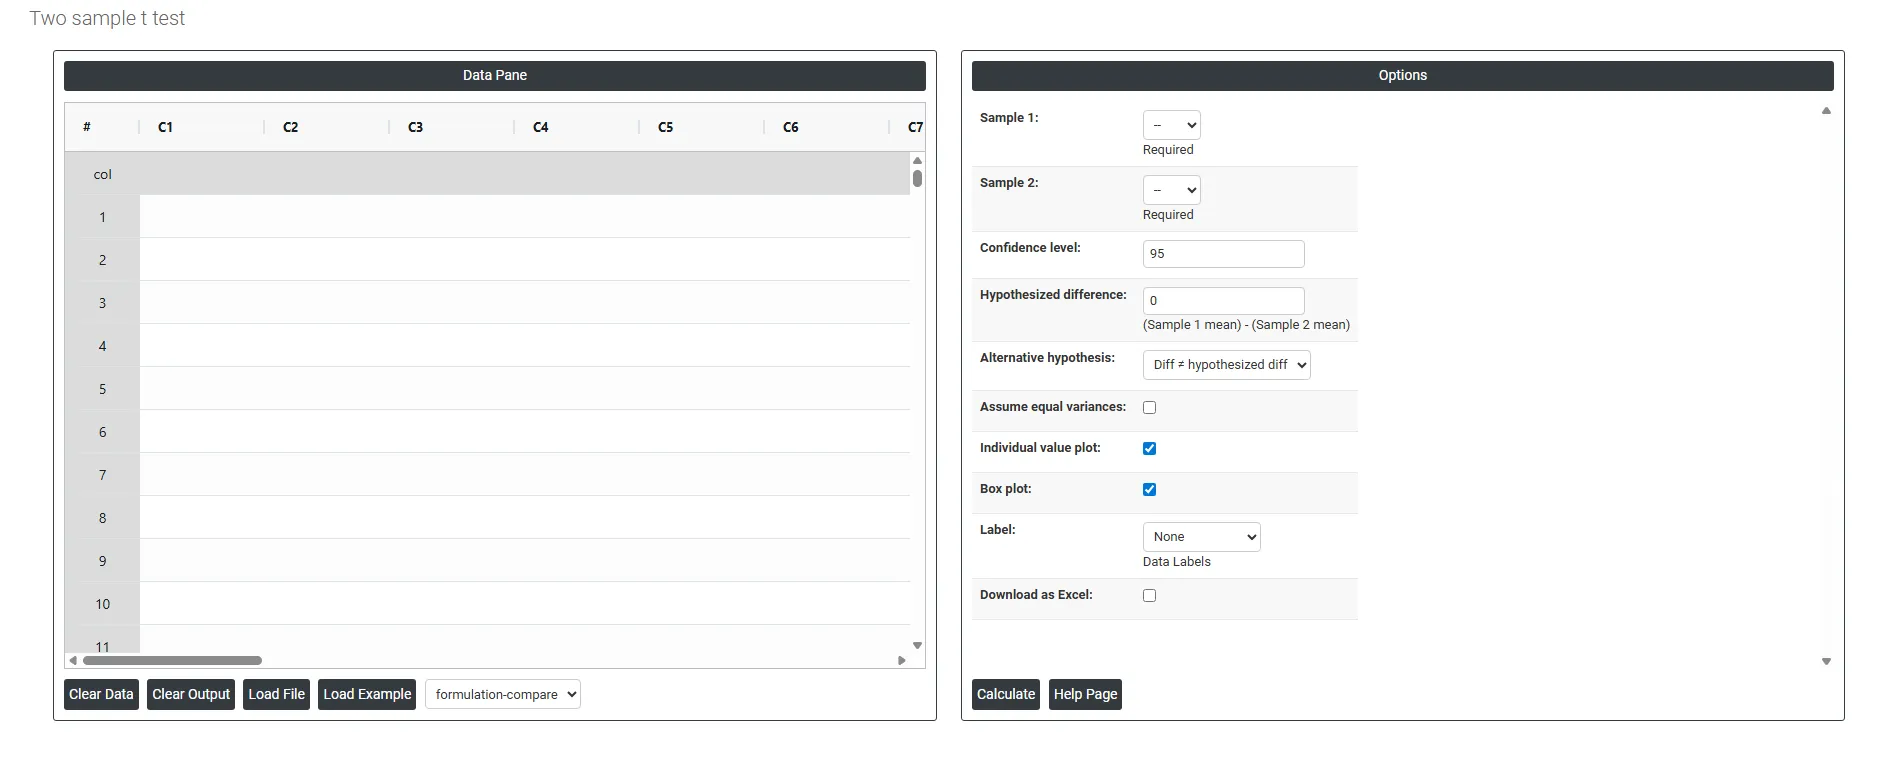
왼쪽 부분에는 데이터 창(Data Pane)이 있습니다. Data Pane에서는 각 행이 하나의 부분군이 됩니다. 데이터를 직접 입력하거나 Excel 시트에서 데이터 전체를 복사(Ctrl+C)하여 여기에 붙여넣을(Ctrl+V) 수 있습니다.
Load example: 예제 데이터가 로드됩니다.
Load File: Excel 데이터를 직접 로드하는 데 사용합니다.
오른쪽 부분에는 다음과 같은 여러 옵션이 있습니다.
- Sample 1: 비교하려는 첫 번째 집단 의 데이터가 들어 있는 열을 선택합니다. 예를 들어 기계 A, 공급업체 1 또는 배합 A의 측정값입니다. 필수 항목이며 연속형 수치 값이어야 합니다.
- Sample 2: 비교하려는 두 번째 집단 의 데이터가 들어 있는 열을 선택합니다. 예를 들어 기계 B, 공급업체 2 또는 배합 B의 측정값입니다. 이 항목도 필수이며 Sample 1과 독립이어야 합니다. 즉, 두 데이터 집합의 개별 관측값 사이에 대응이나 짝짓기가 없어야 합니다.
- Confidence Level: 두 평균의 차이에 대해 계산하는 신뢰구간의 신뢰수준을 설정합니다. 표준 기본값은 95%이며, 이는 두 집단 평균의 실제 차이가 표시된 구간 안에 있다고 95% 확신한다는 뜻입니다. 신뢰수준이 높을수록(예: 99%) 구간이 넓어지고, 낮을수록(예: 90%) 구간이 좁아집니다.
- Hypothesized Difference: 검정의 기준이 되는 값으로, 두 집단 평균 사이의 예상되거나 가정한 차이(Sample 1 평균 빼기 Sample 2 평균)를 나타냅니다. 이 값을 0 으로 설정하면 두 평균이 같은지를 검정합니다. 다른 값으로 설정하면 차이가 그 특정 값과 같은지를 검정합니다. 예를 들어 5를 입력하면 집단 1의 평균이 집단 2보다 정확히 5단위 더 큰지를 검정합니다.
- Alternative Hypothesis; 검정의 방향, 즉 두 평균의 차이에 대해 입증하려는 내용을 정의합니다. 다음 세 가지 옵션이 있습니다.
- Diff ≠ Hypothesized Diff — 방향과 관계없이 차이가 가설 값과 같지 않은지를 확인하는 양측 검정입니다. 어느 집단이 더 클지 사전에 예상하는 바가 없을 때 사용합니다.
- Diff < Hypothesized Diff — 실제 차이가 가설 값보다 작은지를 확인하는 단측 검정입니다. Sample 1이 Sample 2보다 낮을 것으로 특별히 예상할 때 사용합니다.
- Diff > Hypothesized Diff — 실제 차이가 가설 값보다 큰지를 확인하는 단측 검정입니다. Sample 1이 Sample 2보다 높을 것으로 특별히 예상할 때 사용합니다.
- Assume Equal Variances: 선택하면 두 집단의 모분산이 같다고 가정하고 합동 표준편차를 사용하여 검정 통계량을 계산합니다. 가정이 성립하면 검정력이 약간 더 높아집니다. 선택하지 않으면 집단마다 별도의 분산 추정값을 사용하며(Welch t 검정), 두 집단의 산포가 눈에 띄게 다를 때 더 신뢰할 수 있습니다. 확실하지 않으면 더 안전하고 보수적인 방법이므로 선택하지 않은 상태로 두십시오.
- Individual Value Plot: 활성화하면 두 집단의 모든 개별 데이터 점을 나란히 보여 주는 그림을 표시합니다. 전체 데이터 분포, 산포, 비정상적인 값을 명확하게 볼 수 있어 두 집단이 다른지, 특이치가 있는지를 시각적으로 쉽게 평가할 수 있습니다.
- Box Plot: 활성화하면 집단별로 중앙값, 사분위 범위, 전체 산포를 요약한 상자 그림(상자-수염 그림)을 표시합니다. 상자 그림은 두 집단의 중심과 변동성을 한눈에 비교하고, 검정 결과에 영향을 줄 수 있는 왜도나 특이치를 찾아내는 데 유용합니다.
- Label: Individual Value Plot 또는 Box Plot에 표시할 추가 정보를 지정합니다. 옵션은 다음과 같습니다.
- None — 그림에 추가 레이블을 표시하지 않습니다
- Outliers — 통계적으로 극단적인 데이터 점만 강조합니다
- Individual Data — 표시된 각 데이터 점에 레이블을 붙입니다
- All Quartiles — Q1, 중앙값, Q3 값을 표시합니다
- Means — 그림에 각 집단의 평균을 표시합니다
- Data Labels — 표시된 점의 실제 값을 표시합니다
- Download as Excel: 검정 결과, 요약 통계량, 신뢰구간, p-값을 Excel 파일로 내보냅니다. 결과를 보고서에 포함하거나, 동료와 공유하거나, 분석의 공식 기록으로 보관할 때 유용합니다.
자주 묻는 질문
2-표본 t 검정이란 무엇입니까?
2-표본 t 검정은 서로 독립인 두 집단의 평균이 유의하게 다른지를 판단합니다. 기계 A와 기계 B처럼 서로 다른 두 모집단 또는 공정 조건의 평균을 비교하여, 관측된 차이가 실제 차이가 아니라 우연에 의한 것일 확률을 계산합니다.
2-표본 t 검정의 가정은 무엇입니까?
반응은 연속형이어야 하고, 두 집단은 대응 관계 없이 서로 독립이어야 하며, 각 집단은 근사적으로 정규분포를 따르거나 중심극한정리가 적용되도록 관측값이 30개 이상이어야 합니다. 데이터에 뚜렷한 특이치가 없어야 하며, 집단당 관측값 20~30개 이상을 권장합니다.
2-표본 t 검정에서 등분산을 가정해야 합니까?
집단의 분산이 같다면 합동 표준편차를 사용하는 검정의 검정력이 약간 더 높습니다. 그렇지 않다면 별도의 분산 추정값을 사용하는 Welch t 검정이 산포가 다를 때 더 신뢰할 수 있습니다. F 검정이나 Levene 검정으로 확인하고, 확실하지 않으면 더 안전한 선택인 Assume Equal Variances를 선택하지 않은 상태로 두십시오.
2-표본 t 검정은 언제 사용하지 않아야 합니까?
같은 대상에 대한 대응 데이터나 전후 데이터에는 쌍체 t 검정을, 셋 이상의 집단에는 일원배치 분산분석을, 집단이 실질적으로 동등함을 입증하려면 2-표본 동등성 검정을, 데이터가 심하게 비정규이고 표본이 작으면 만-휘트니 검정을 사용하십시오. 요약 데이터만 있다면 요약값 버전을 사용하십시오.