
ARIMA(Box-Jenkins予測)
ARIMAは、等間隔で測定された系列を、自己回帰(p)、差分(d)、移動平均(q)の各項と、任意の季節項(P、D、Q、s)および定数でモデル化します。値が過去の値に依存する場合や、系列にトレンドや季節性がある場合に使用します。ACFとPACFのプロットが次数の決定に役立ちます。出力には、パラメータ推定値、Ljung-Box検定、残差のACF/PACF、MAPE、MAD、MSD、予測限界付きの予測値が含まれます。
最終レビュー
重要なポイント
ARIMAは、等間隔の時系列にBox-Jenkinsの自己回帰和分移動平均モデルを当てはめ、持ち越し効果、トレンド、季節性を捉えて、予測区間付きで将来値を予測します。
目的
ARIMAは、等しい時間間隔(日次、週次、月次)で測定された系列にBox-Jenkinsの自己回帰和分移動平均モデルを当てはめ、予測区間付きで次の値を予測します。各値がその前の値に依存する場合や、移動平均や指数平滑法などの単純な手法では捉えにくいトレンドや繰り返しの季節性が系列にある場合に使用します。実行前に、系列の自己相関(ACF)と偏自己相関(PACF)のプロットを見ると、モデルの次数を選ぶのに役立ちます。
主な機能
- 非季節の自己回帰(p)、差分(d)、移動平均(q)の各項と、任意の季節周期に対応した季節項(P、D、Q)。たとえば、年周期のある月次データなら12、週周期のある日次データなら7です。
- 任意の定数項:差分をとっていない系列の平均水準、または差分をとった系列の平均的なドリフト(トレンド)です。
- 標準誤差、T値、p値付きのパラメータ推定値。これにより、不要な項を除外できます。
- 残差の確認:残差平方和と平均平方、ラグ12、24、36、48でのModified Box-Pierce(Ljung-Box)のカイ二乗検定、残差のACFとPACFのプロット。
- 選択した信頼水準での、下側と上側の予測限界付きの予測値。予測の起点を指定すると、それより前の行から予測を行い、予測値を実際に起こったことと比較できます。
- 当てはめの精度の指標であるMAPE、MAD、MSD。他の時系列ツールと比較できます。
- 任意の追加出力:各反復での推定値、推定されたパラメータの相関行列、後ろ向き予測(back forecasts)、4種類を1枚にまとめた残差プロット。
統計的手法
モデルは φ(B)Φ(Bˢ)(1−B)ᵈ(1−Bˢ)ᴰ yₜ = C + θ(B)Θ(Bˢ) aₜ です。ここで、Bは後退シフト演算子、φとθは次数がpとqの非季節のARとMA多項式、ΦとΘはBˢにおける次数がPとQの季節のARとMA多項式、sは季節周期、Cは定数、aₜは残差(ランダムな衝撃)です。差分 (1−B)ᵈ(1−Bˢ)ᴰ は、ARとMAの項を当てはめる前にトレンドと季節性を除去するため、系列の先頭で d + D·s 個の観測が失われます。
パラメータは、後ろ向き予測を用いたBox-Jenkinsの最小二乗法で推定します。初期値を反復的に改良して残差平方和を最小にし、標本期間より前の値を得るために系列を後ろ向きに予測します。残差の平均平方は MS = SS / DF で、DF = 差分後の観測数 − 推定したパラメータ数 です。各係数のT値は、係数をその標準誤差で割ったもので、p値は残差のDFによるt分布から求めます。差分をとらず定数を含むモデルでは、過程の平均 C / (φ(1)Φ(1)) も報告されます。
Ljung-Box統計量 Q = n(n+2) Σ rₖ² / (n−k) は、各ラグまでの残差の自己相関 rₖ から計算し、DFがラグから推定したパラメータ数を引いた値であるカイ二乗分布と比較します。p値が0.05を超える場合は、残差に自己相関が残っている証拠がないことを意味します。予測は、当てはめた式から再帰的に行います。h期先の予測区間は、予測値 ± z·√(MS·Σψⱼ²) で、モデルの最初のh個のψ重みを合計するため、予測期間が長くなるほど区間は広がります。
入力フィールドとオプション
項目 | 説明 |
Variable (Y) | 必須です。系列を含む列で、時間順に、等間隔で並べます。 |
Autoregressive order (p) | 非季節のAR項の数(0〜10、既定は1):過去のいくつの値が現在の値に持ち越されるかを指定します。 |
Difference order (d) | 非季節の差分の回数(0〜3、既定は0)。変動したり増加したりするトレンドのある系列では1を使用します。 |
Moving average order (q) | 非季節のMA項の数(0〜10、既定は0):過去のいくつのランダムな衝撃が持ち越されるかを指定します。 |
Include seasonal terms | チェックすると、下の季節の次数が追加されます。モデルには、合計で少なくとも1つのAR項またはMA項が必要です。 |
Seasonal AR order (P) / Seasonal difference order (D) / Seasonal MA order (Q) | 季節の次数(PとQは0〜5、Dは0〜2)。s = 12の月次データでは、D = 1で前年同月比の変化をモデル化します。 |
Seasonal period (s) | 季節項を使う場合は必須です。1つの季節に含まれる観測数を指定します(年周期のある月次データなら12、四半期データなら4、週周期のある日次データなら7)。 |
Include constant term | 既定でチェックされています。ドリフトのない差分系列では、チェックを外します。 |
Number of forecasts | 予測の起点以降に何期先まで予測するか(0〜1000。0 = 予測なし)。 |
Confidence level (%) for forecast interval | 既定は95です。 |
Forecast origin (row) | 任意です。この行までのデータを使って、この行の次から予測を開始します。空欄の場合は系列の末尾です。既にあるデータに対してモデルを検証する場合に使用します。 |
Results to display | 最終推定値、差分に関する情報、残差平方和、観測数。これに加えて、各反復での推定値、推定されたパラメータの相関行列、または後ろ向き予測を選べます。 |
Residual plots (four in one) | 正規確率プロット、残差と近似値の関係、ヒストグラム、残差と順序の関係を追加します。 |
Title | 出力に表示するタイトルです。 |
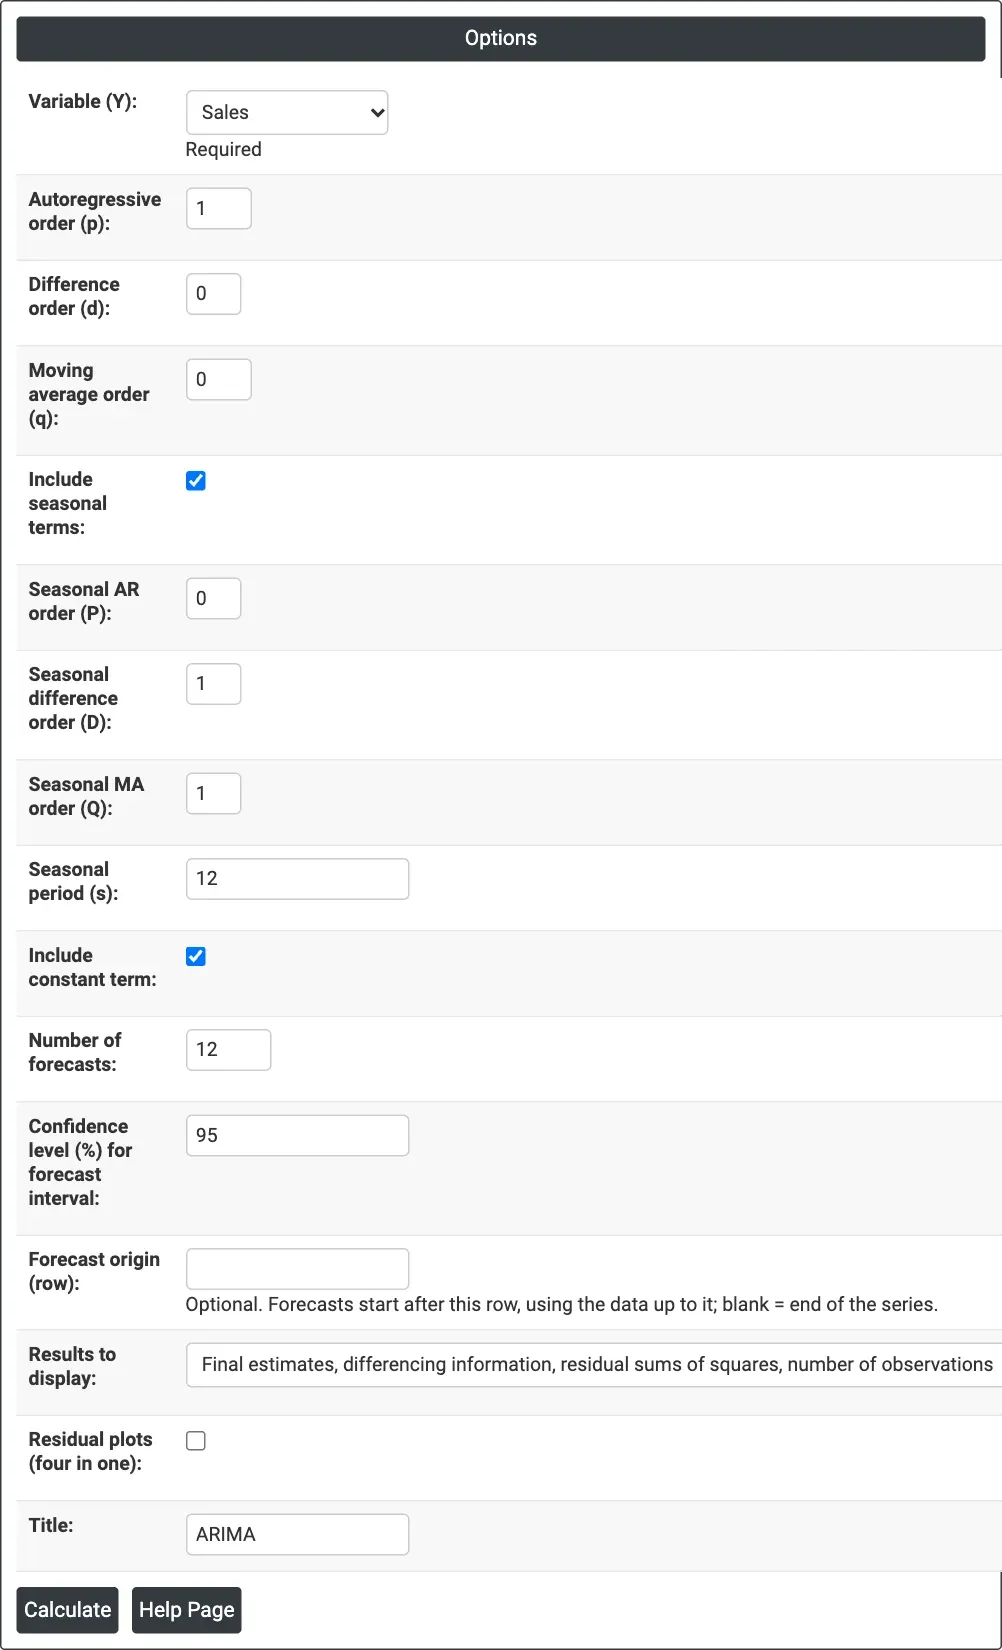
図1 — 月次売上の例:Variable (Y) = Sales、定数を含む季節ARIMA(1, 0, 0)(0, 1, 1)12モデルと12期の予測。
出力の説明
- ARIMA plot — 系列と、近似値、予測値、およびその予測区間の帯。タイトルの下にMAPE、MAD、MSDが表示されます。
- Final Estimates of Parameters — 各AR、SAR、MA、SMAの項と定数について、係数、SE Coef、T-Value、P-Value(差分をとらず定数を含むモデルではMeanも)が表示されます。
- Residual Sums of Squares — 残差のDF、SS、MS。
- Modified Box-Pierce (Ljung-Box) Chi-Square statistic — ラグ12、24、36、48でのChi-Square、DF、P-Value(系列より長いラグは除かれます)。
- Forecasts — 期、予測値、下側と上側の予測限界。
- ACF and PACF of Residuals — 破線の限界の内側にある棒は、自己相関が残っていないことを意味します。
- Results to displayとResidual plotsで選択した任意の表とプロット、およびDownloadによるPDFエクスポート。
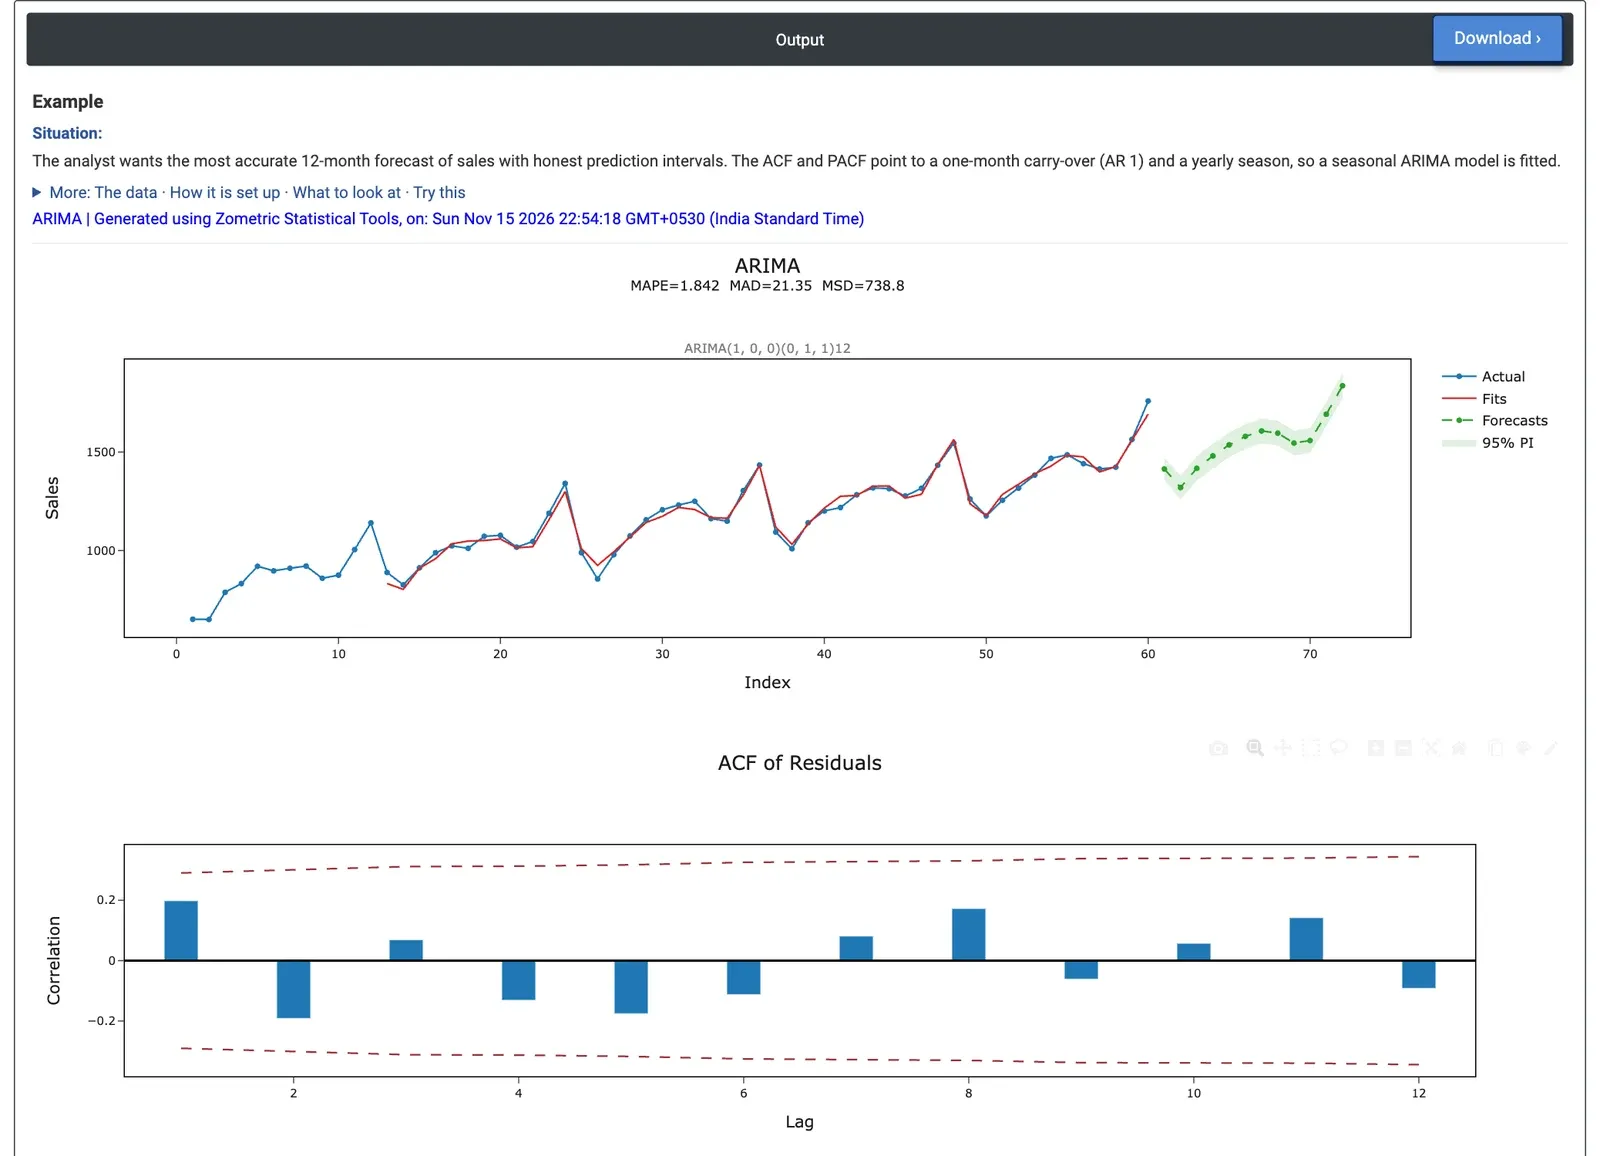
図2 — 月次売上の例のARIMA出力:当てはめと、95%予測区間の帯付きの12か月先の予測、および残差のACF。
計算例
分析担当者は、60か月分の売上(2020年1月から2024年12月)を持っており、信頼できる予測区間付きで12か月先の予測を得たいと考えています。ACFとPACFは、1か月の持ち越しと年周期の季節性を示しているため、モデルは定数を含むARIMA(1, 0, 0)(0, 1, 1)12とします。Autoregressive order (p) = 1、Seasonal difference order (D) = 1、Seasonal MA order (Q) = 1、Seasonal period (s) = 12、Number of forecasts = 12です。
両方の項は明らかに必要です。AR 1 = 0.481(SE 0.104、T = 4.63、p < 0.001)、SMA 12 = 0.805(SE 0.144、T = 5.59、p < 0.001)で、定数は69.34(前年同月比の平均的な伸び)です。残差のMSは、45のDF(60か月 − 季節差分で失われる12 − パラメータ3つ)で788.1です。Ljung-Boxのp値は、ラグ12、24、36でそれぞれ0.214、0.319、0.254で、すべて0.05を上回るため、残差はランダムなノイズのように見え、モデルがパターンを捉えていると考えられます。当てはめは良好です:MAPE 1.84%、MAD 21.35、MSD 738.8。
2025年1月(第61期)の予測値は1,414個で、95%予測区間は1,359〜1,469です。2025年12月(第72期)の予測値は1,837個に上昇し、区間は1,774〜1,899です。モデルを信頼する前に検証するには、Forecast origin (row) = 48に設定します。2023年12月までのデータから2024年を予測し、その予測値を2024年の実際の売上と比較します。
よくある質問
ARIMAモデルとは何ですか?
ARIMAは、等間隔の時間間隔で測定された系列に対するBox-Jenkinsの自己回帰和分移動平均モデルです。自己回帰項は過去の値を持ち越し、差分はトレンドを除去し、移動平均項は過去のランダムな衝撃を持ち越します。繰り返しの季節性には季節項を追加できます。たとえば、年周期のある月次データでは周期12を使います。
指数平滑法ではなくARIMAを使用するのはどのような場合ですか?
各値がその前の値に依存する場合や、移動平均や指数平滑法などの単純な手法では捉えにくいトレンドや繰り返しの季節性が系列にある場合に、ARIMAを使用します。当てはめる前に、系列の自己相関(ACF)と偏自己相関(PACF)のプロットを見ると、モデルの次数を選ぶのに役立ちます。
ARIMAモデルがよく当てはまっているかどうかは、どのように確認しますか?
各項のp値が、その項が必要であることを示しているかを確認し、ラグ12、24、36、48でのLjung-Boxのカイ二乗検定を見ます。p値が0.05を超える場合は、残差に自己相関が残っている証拠がないことを意味します。残差のACFとPACFの棒は、破線の限界の内側にとどまっているはずです。MAPE、MAD、MSDは、当てはめの精度を要約します。
ARIMAの予測を信頼する前に検証するにはどうすればよいですか?
予測の起点を前の行に設定し、その時点までのデータからモデルに予測させて、その予測値を実際に起こったことと比較します。計算例では、起点を48行目に設定すると、2023年12月までのデータから2024年を予測し、2024年の実際の売上と比較できます。予測区間は、予測期間が長くなるほど広がります。