
拡張Dickey-Fuller検定(Augmented Dickey-Fuller Test)
拡張Dickey-Fuller検定は、単位根(非定常性)があるという仮説を、定常という対立仮説に対して検定します。ARIMAなど定常性を仮定するモデルの前に使用します。定数項、定数項とトレンド、2次トレンド、項なしから選び、ラグはAIC、BIC、t-statまたは固定値で選択します。系列に欠測がなく、値が6個以上必要です。出力には統計量、p値、ラグ数、臨界値が示されます。
最終レビュー
重要なポイント
拡張Dickey-Fuller(ADF)検定は、時系列が定常か単位根を持つかを調べる検定で、ARIMAの前に、元のデータをそのままモデル化するか、トレンドをモデル化するか、系列を差分するかを判断するのに役立ちます。
目的
拡張Dickey-Fuller(ADF)検定は、時系列が定常かどうか、つまり一定の平均(または一定のトレンド)の周りで変動しているのか、それとも元に戻らずに漂っているのかを調べる検定です。多くの予測モデル、特にARIMAは、定常な系列を仮定します。そのようなモデルを当てはめる前にこの検定を実行し、元のデータをそのままモデル化するか、トレンドをモデル化するか、先に系列を差分するかを判断します。
主な機能
- 単位根がある(非定常な系列)という帰無仮説を、定常という対立仮説に対して検定します。
- 検定回帰の4つの形式:定数項の周り、定数項と線形トレンド、定数項と線形・2次トレンド、またはどちらもなし。
- ラグ付き差分の数を、AIC、BIC、または最後のラグのt統計量により自動で選択するか、入力した固定値を使用します。
- 検定統計量、p値、使用したラグ数、1%、5%、10%の臨界値を報告し、設定した有意水準での結論を平易な文章で示します。
統計的手法
この検定は、回帰 Δyₜ = α + βt + γ·yₜ₋₁ + δ₁Δyₜ₋₁ + … + δₖΔyₜ₋ₖ + εₜ(Δyₜ = yₜ − yₜ₋₁)を当てはめます。定数項αとトレンドβtは、Regression typeに応じて含めるか除外されます(2次のオプションではt²の項が加わります)。検定統計量はγのt比です。系列に単位根があればγ = 0となります。統計量が大きな負の値であれば、系列が平均またはトレンドに引き戻されていることを意味し、したがって定常です。この統計量は通常のt分布には従いません。p値にはMacKinnonの近似分布を、臨界値にはMacKinnonの表を使用し、いずれも選択した回帰の種類に対応するものです。
ラグ付き差分Δyₜ₋ᵢは、短期的な自己相関を吸収します。Maximum lagの既定値はmin(n/2 − 3, 12·(n/100)^¼)を切り捨てた値です。AICまたはBICでは、0から最大値までのすべてのラグを当てはめ、基準が最小のものを採用します。t-statでは最大のラグから始め、最後のラグが|t| ≥ 1.645になるまでラグを減らします。Fixedでは最大ラグをそのまま使用します。N Observationsは回帰に残る行数で、n − 使用したラグ数 − 1です。計算にはstatsmodelsのadfullerを使用します。系列に欠測がなく、値が6個以上必要です。
p値が有意水準を下回る場合、単位根があるという帰無仮説は棄却され、系列は定常とみなされます。そうでない場合は非定常である可能性が高く、差分(またはトレンド項)が必要です。有意水準が変えるのはこの結論の行だけで、臨界値は常に1%、5%、10%で表示されます。
入力項目とオプション
項目 | 説明 |
Variable | 必須。時間順に並んだ系列を含む数値列です。 |
Regression type | Constant(平均の周りでの定常性を検定)、既定値。Constant and trend(トレンドの周りでの定常性を検定)。Constant, linear, and quadratic trend。またはNone(定数項なし、トレンドなし)。 |
Lag selection method | AIC(赤池情報量規準を最小化)、既定値。BIC(ベイズ情報量規準を最小化)。t-stat(最後のラグのt統計量が有意でない間、ラグを減らす)。またはFixed(Maximum lagをそのまま使用)。 |
Maximum lag | 任意。AIC、BIC、t-statで探索する上限、またはFixedで使用するラグそのものです。空白の場合はmin(n/2 − 3, 12·(n/100)^¼)を使用します。 |
Significance level | 既定値は0.05(0.001〜0.5)。結論のために、p値をこの値と比較します。 |
Title | 出力に表示されるタイトルです。 |
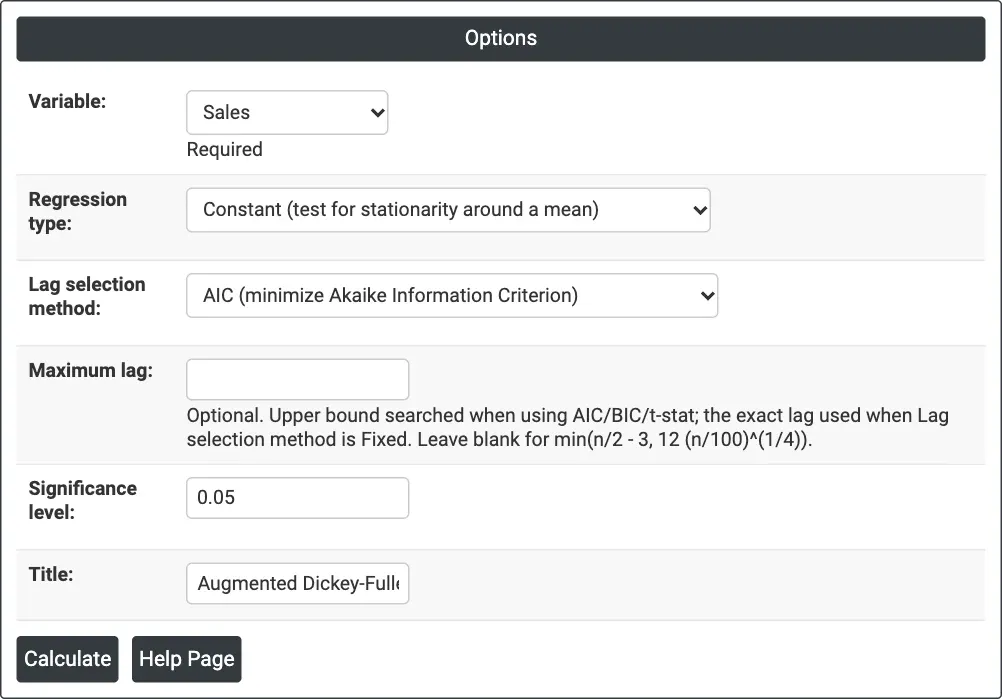
Figure 1 — 月次のSalesを、定数項のみ、ラグをAICで選択、有意水準0.05で検定した結果。
出力の説明
- Test — 変数、検定統計量、p値、使用したラグ付き差分の数、探索した最大ラグ、検定回帰の観測数。
- Critical Values — 選択した回帰の種類における、検定統計量の1%、5%、10%の臨界値。統計量が臨界値より小さい(より負の値である)場合、その水準で系列は定常です。
- Conclusion — p値と有意水準を比較し、系列が定常である可能性が高いか非定常である可能性が高いかを述べる文です。
- DownloadによるPDFエクスポート。
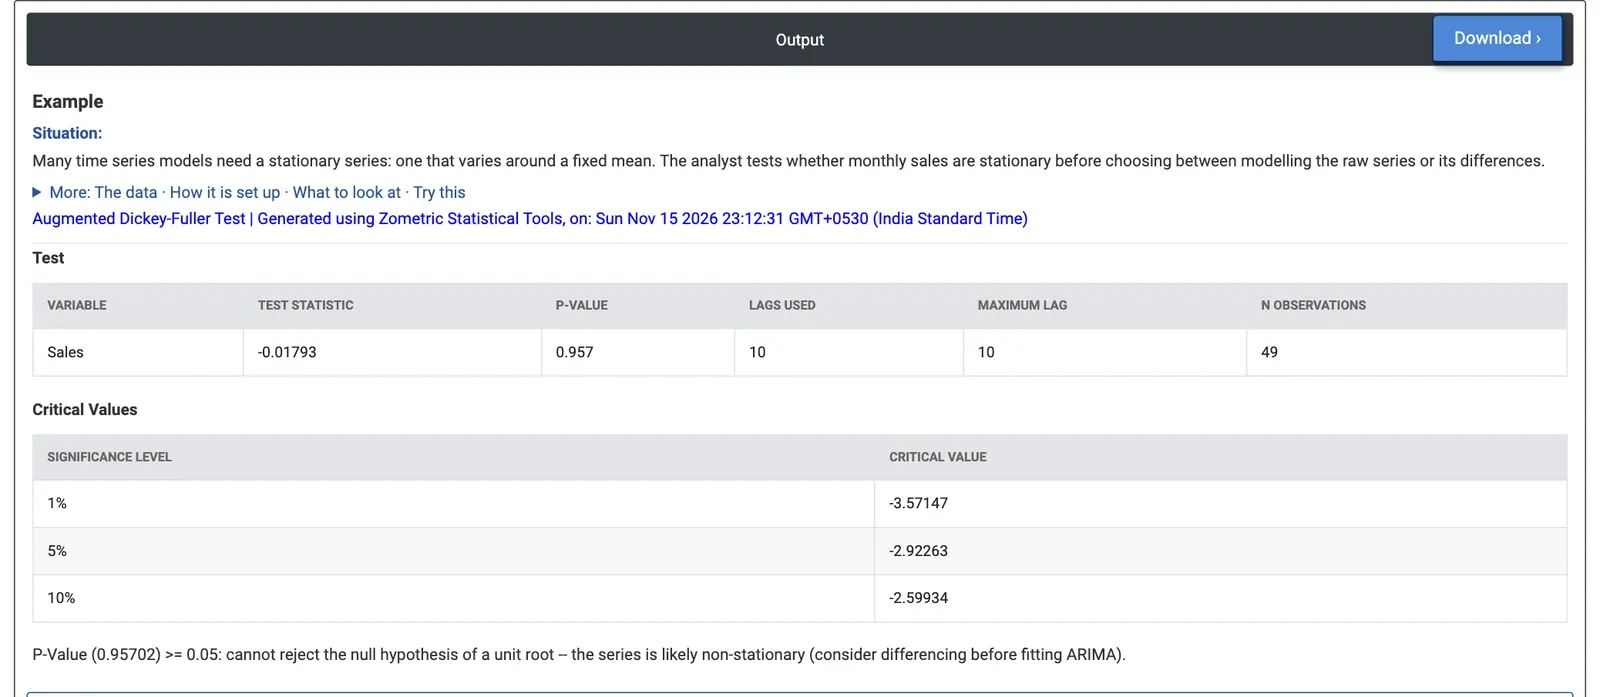
Figure 2 — 固定平均の周りで検定した月次売上:統計量 −0.018、p値 0.957 で、系列は定常ではありません。
計算例
家電製品の販売会社の販売アナリストは、60か月分(2020年1月〜2024年12月)の販売数量データを持っており、ARIMAによる予測を計画しています。まず、売上が定常かどうかを検定します。アナリストはVariable = Salesを選択し、Regression type = Constant、Lag selection method = AIC、Significance level = 0.05のままにします。
探索された最大ラグは10で、AICはその10をすべて採用し、検定回帰には49個の観測が残ります。検定統計量は −0.018、p値は 0.957 です。5%の臨界値は −2.92 で、統計量はそれにはまったく届きません。単位根を棄却できず、売上は固定された平均の周りで変動していません。これは、毎年売上が伸びているデータのプロットと一致します。
Regression type = Constant and trendにすると、統計量は −7.78、5%の臨界値は −3.50(pは0.001未満)となり、使用ラグは9です。直線トレンドの周りでは系列は定常であり、したがって成長は安定しています。モデルとしては、トレンド項または差分のどちらかが必要です。ARIMAのページにあるように、12か月差分と定数項を持つ季節ARIMAであれば、成長と年次パターンの両方に対応できます。Advertising Spendについて定数項で行った検定でも同じ結果になります(統計量 0.13、p値 0.968)。
よくある質問
拡張Dickey-Fuller検定では何がわかりますか?
ADF検定では、時系列が定常、つまり一定の平均またはトレンドの周りで変動しているのか、それとも単位根があるために元に戻らずに漂っているのかがわかります。帰無仮説は単位根があることです。多くの予測モデル、特にARIMAは定常な系列を仮定するため、この検定は、データを差分するかトレンドをモデル化するかの判断の指針になります。
ADF検定のp値はどのように解釈しますか?
p値が有意水準を下回る場合、単位根があるという帰無仮説は棄却され、系列は定常とみなされます。そうでない場合は非定常である可能性が高く、差分またはトレンド項が必要です。同じことですが、検定統計量がその水準の臨界値より小さい、つまり臨界値よりも負の値が大きい場合、その水準で系列は定常です。
ADF検定ではどのRegression typeを選べばよいですか?
一定の平均の周りでの定常性を検定するにはConstant、直線トレンドの周りでの定常性を検定するにはConstant and trend、2次トレンドのオプション、または定数項もトレンドもなしのNoneから選びます。売上の例では、系列は平均の周りでは定常ではありませんでしたが(p = 0.957)、トレンドの周りでは定常でした(統計量 -7.78、pは0.001未満)。
ADF検定のラグ数はどのように選択されますか?
ラグ付き差分は短期的な自己相関を吸収します。AICまたはBICでは、0から最大値までのすべてのラグを当てはめ、基準が最小のものを採用します。t-statでは、最後のラグのtの絶対値が1.645以上になるまでラグを減らします。Fixedでは最大ラグをそのまま使用します。最大ラグの既定値はmin(n/2 - 3, 12 x (n/100)^0.25)です。