
自動工程能力分析(Automated Process Capability)
Automated Process Capabilityは、手動の正規性確認を不要にします。Anderson-Darling検定を実行し、p値がしきい値(既定値0.1)以上の場合は正規分布のPp、Ppl、Ppu、Ppkを算出します。しきい値を下回る場合は、候補となる非正規分布を最尤法で当てはめ、最適なものを選んでzスコア法を用います。出力には、取った経路、当てはめたヒストグラム、各指数、期待PPMと実測PPMが表示されます。
最終レビュー
重要なポイント
Automated Process CapabilityはAnderson-Darling検定で正規性を検定し、正規モデルまたは最適な非正規分布のいずれかからPpとPpkを自動的に算出し、どちらの経路を取ったかを記録します。
目的
Automated Process Capabilityは、まず正規性を検定し、次に正規分布モデルか非正規分布モデルかを別途選ぶという手動の手順を不要にします。このツールはAnderson-Darling正規性検定を自ら実行し、データが検定に合格した場合は標準的な正規分布の工程能力指数に、合格しなかった場合はアプリの候補分布ライブラリから選ばれた最適な非正規分布に、自動的に計算を振り分けます。振り分けの判断は、レポートの冒頭に記録されます。
主な機能
- Anderson-Darling正規性検定を自動的に実行します。別途の正規性確認の手順は不要です。
- 正規分布の仮定が棄却された場合、アプリの他の非正規工程能力ツールと同じ分布当てはめライブラリを用いて、最も当てはまりの良い非正規の候補分布を自動的に選択します。
- 正規性のp値しきい値を設定でき、正規分布の経路を既定とする際の保守性を調整できます。
- どの経路を取ったか(正規か非正規か、非正規の場合はどの分布か)を出力に直接示すため、振り分けの判断が透明で監査可能になります。
- アプリの他の工程能力ツールと同様に、任意のFactor列と「Compare selected columns as separate groups」モードに対応しています。
統計手法
正規性は、Anderson-Darling検定(正規分布を基準としたscipyのanderson())で評価します。標準的な小標本補正 AD = A²·(1 + 0.75/n + 2.25/n²) を用い、p値は補正後のAD統計量に対するD'Agostino–Stephensの区分的経験近似から求めます。
振り分けルール:Anderson-Darling検定のp値がNormality p-value threshold(既定値0.1)以上の場合、このツールはデータを正規分布とみなします。移動範囲法(MRbar/d2、または移動範囲の中央値を用いる方法)でσ_overallを推定し、そこから標準的なzベースの工程性能指数Pp、Ppl、Ppu、Ppkを算出します。p値がしきい値を下回る場合は、アプリが対応する非正規の候補分布(ワイブル分布、3-Parameter Weibull、指数分布、2-Parameter Exponential、ガンマ分布、ロジスティック分布、対数ロジスティック分布、対数正規分布、最小極値分布および最大極値分布)のそれぞれを最尤法で当てはめ、適合度で順位付けして、最も当てはまりの良いものを自動的に選択します。
非正規の経路では、選択された分布自身のCDFをLSLとUSLで評価して裾の確率p_lslとp_uslを求め、逆正規CDF(norm.ppf)で等価な標準正規のzスコアに変換します。これが「zスコア法」です。工程能力は、これらのzスコアを用いて、おなじみのCpkの尺度で報告されます。Pp = (z_usl − z_lsl) / 6、PPL = −norm.ppf(p_lsl) / 3、PPU = norm.ppf(p_usl) / 3、Ppk = min(PPL, PPU) です。これにより、歪んだ分布の実際の裾のリスクを捉えたうえで、アプリ全体で使われているCpk相当の単位で表現でき、非正規データに正規分布の生のZスコアを誤って適用することを避けられます。
PPM(百万分率)は2通りで報告されます。各規格限界を超える部分の、当てはめた分布の裾の確率から求める「期待」PPMと、生のサンプルのうち実際に規格限界の外にある割合を単純に数えて求める「実測」PPMです。
入力項目とオプション
項目 | 説明 |
Choose columns | 分析対象の応答列です。 |
Factor | 任意です。データが1つのResponse列と1つのFactor列で構成されている場合に、グループ間で工程能力を比較します。 |
Compare selected columns as separate groups | 2列以上を選択した場合に、各列について工程能力を別々に算出し、並べて比較します。 |
LSL / USL | 下限規格値と上限規格値です。選択したすべての列に適用されます。 |
Normality p-value threshold | 既定値は0.1です。Anderson-Darling検定のp値がこの値以上の場合は、正規分布を仮定して工程能力を算出します。この値を下回る場合は、最も当てはまりの良い非正規分布が自動的に選択され、代わりに用いられます。 |
Download as Excel | 任意です。レポートをExcelワークブックにエクスポートします。 |
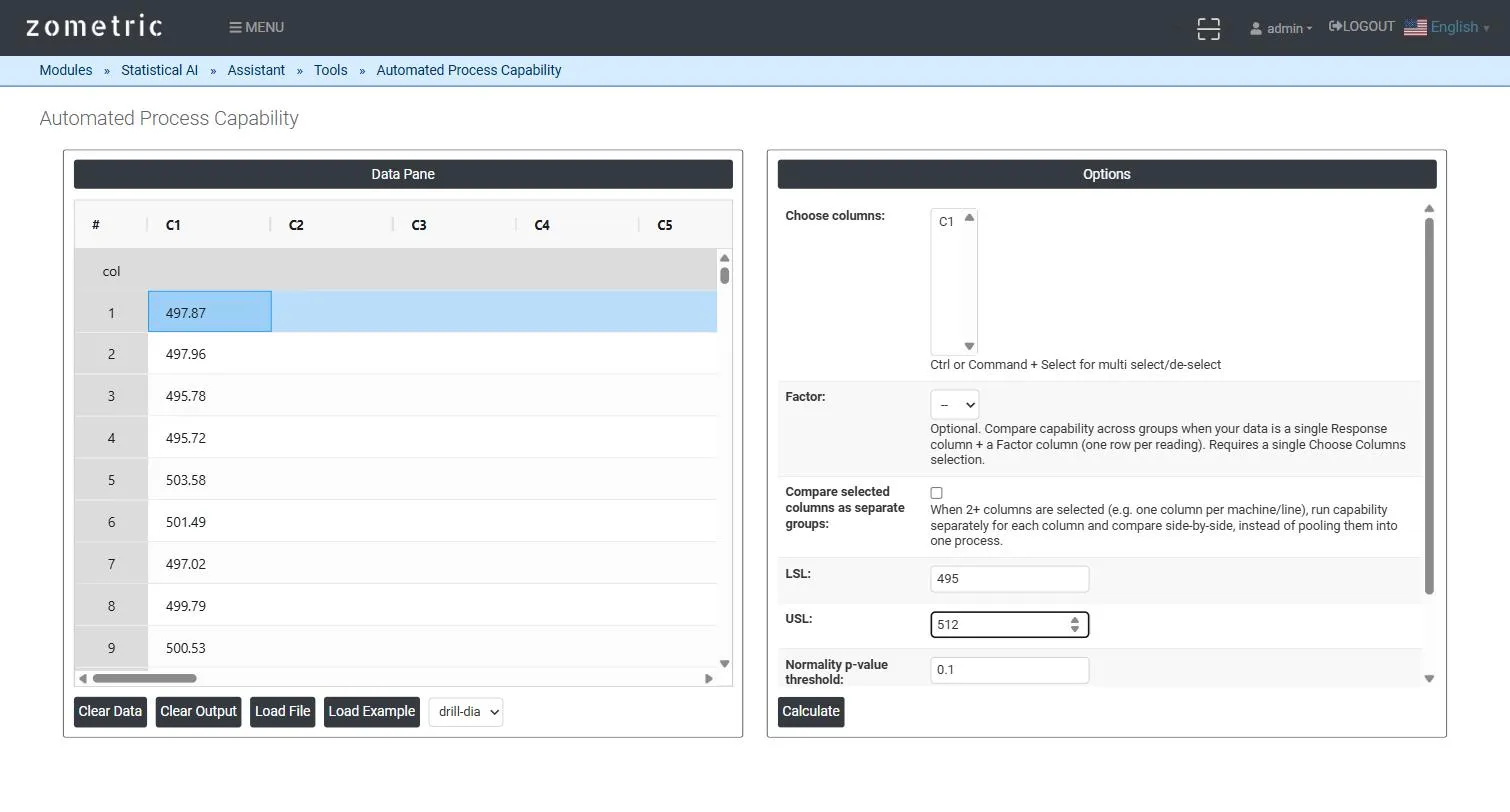
図1 — Data paneのC1に貼り付けた60個の充填重量の測定値と、Optionsパネルに入力したLSL/USLおよびNormality p-value threshold。
出力の説明
- 正規性検定の結果 — Anderson-Darling統計量とp値、および取った経路(正規、または自動選択された特定の非正規分布)。
- 当てはめた分布のヒストグラム — サンプルのヒストグラムに、当てはめた密度曲線とLSL/USLの基準線を重ねたもの。
- 分布パラメータの表 — LSL、USL、サンプル平均、サンプルサイズ、および当てはめた分布の形状・尺度(またはそれに相当する)パラメータ。
- 工程能力指数 — 選択された分布から算出したPp、Ppl、Ppu、Ppk。
- PPMの表 — 期待PPM(当てはめた分布の裾から)と実測PPM(生のサンプルから)。それぞれPPM < LSL、PPM > USL、PPM Totalに分けて表示されます。
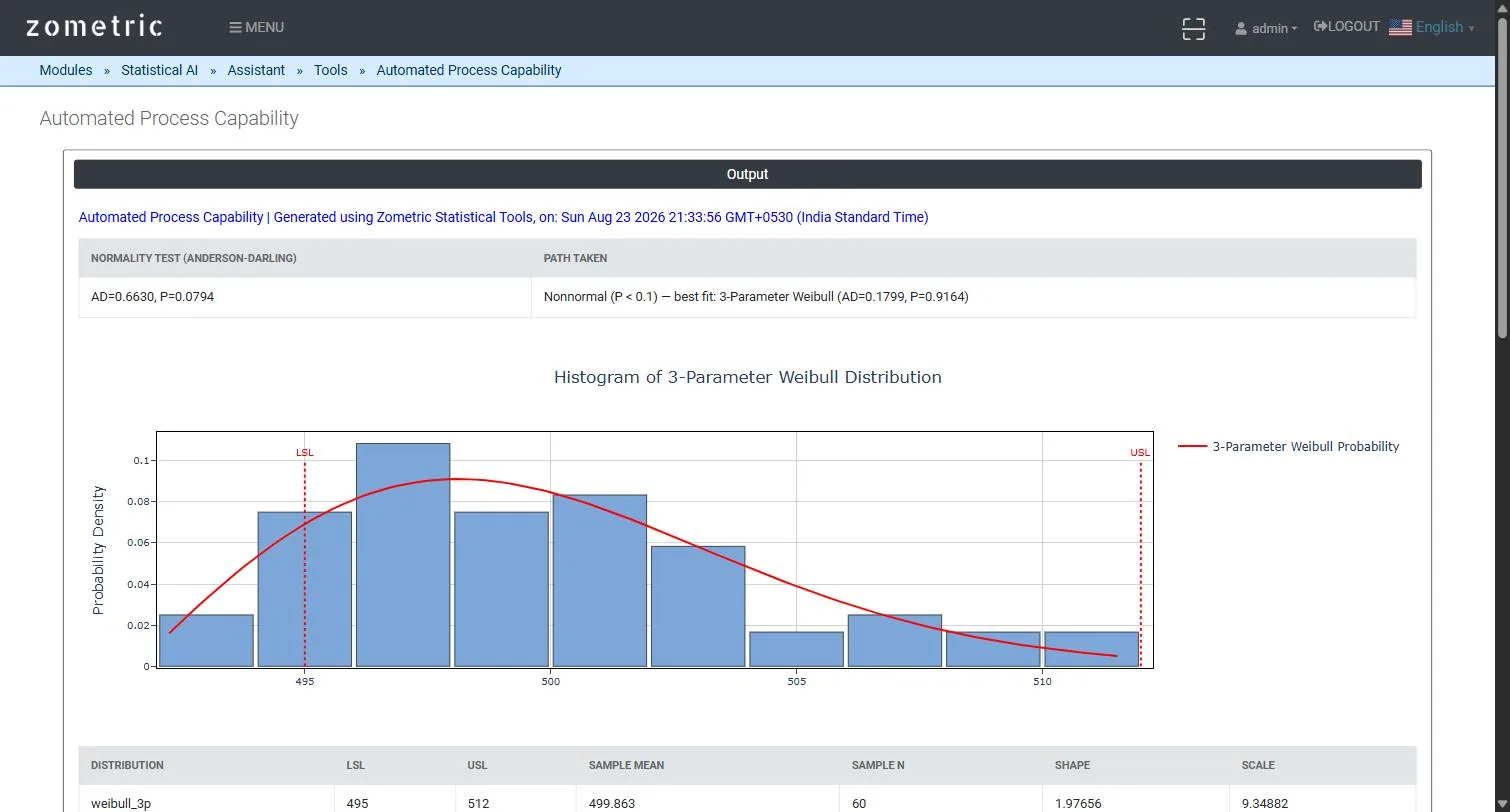
図2 — 分布パラメータと、その結果得られたPp/Ppl/Ppu/Ppk指数、および期待PPMと実測PPMの表。
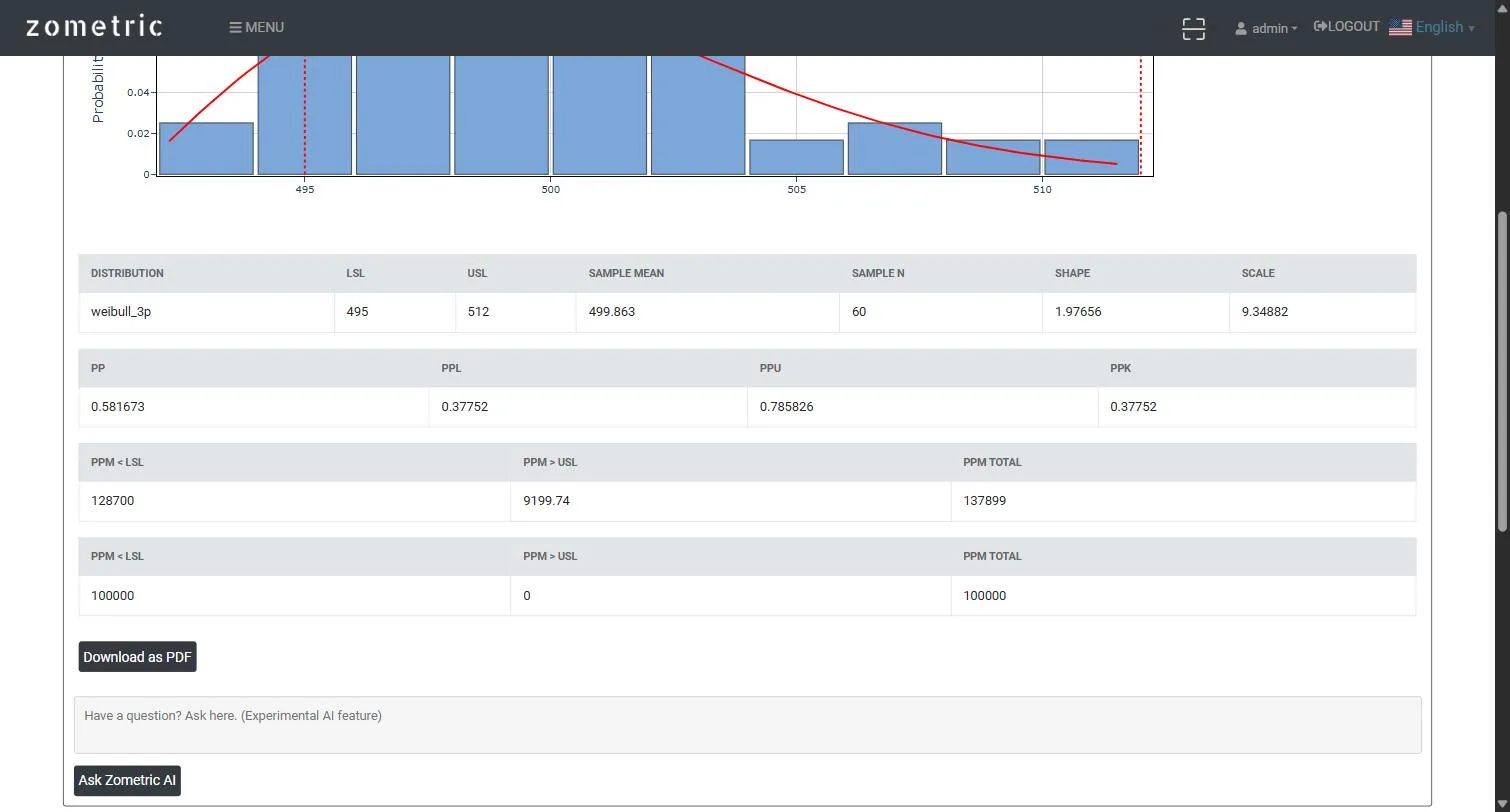
図3 — 自動的な振り分けの判断(Anderson-Darling検定の結果と取った経路)と、当てはめた分布のヒストグラム。
計算例
充填ラインで粘度の高い洗剤をボトルに充填しており、1シフトの間に抜き取った60本のボトルについて充填重量(g)を測定しました(列C1)。LSL = 495 g、USL = 512 gです。既定のしきい値0.1では、Anderson-Darling検定の結果はAD = 0.6630、P = 0.0794で、しきい値を下回ります。そのため、ツールは自動的に非正規の経路に振り分け、最も当てはまりの良い分布として3-Parameter Weibullの当てはめ(AD = 0.1799、P = 0.9164)を選択します。誤解を招く正規分布の仮定ではなく、当てはめたワイブル分布の裾の確率から、Ppk = 0.378を報告します。
よくある質問
自動工程能力分析は何をしますか?
データに対してAnderson-Darling正規性検定を実行し、その結果に応じて工程能力の計算を自動的に振り分けます。データが検定に合格した場合は標準的な正規分布の工程能力指数に、合格しなかった場合は最も当てはまりの良い非正規分布に振り分けます。1つのレポートに、正規性の結果、取った経路、用いた分布が示されるため、振り分けの判断は透明で監査可能です。
ツールは正規と非正規の工程能力をどのように判断しますか?
Anderson-Darling検定のp値がNormality p-value threshold(既定値0.1)以上の場合、データは正規分布とみなされます。しきい値を下回る場合は、ワイブル分布、3-Parameter Weibull、ガンマ分布、対数正規分布などの候補分布を最尤法で当てはめ、適合度で順位付けして最も良いものを選択します。
非正規データのPpkはどのように計算されますか?
選択された分布のCDFから、LSLとUSLを超える裾の確率を求め、等価な標準正規のzスコアに変換します。そのうえで、PPL = -z(p_lsl)/3、PPU = z(p_usl)/3、Ppk = min(PPL, PPU) とします。これにより、歪んだ分布の実際の裾のリスクを捉えつつ、おなじみのCpk相当の尺度で結果を示せます。
Zometric Statistical Softwareで自動工程能力分析を実行するにはどうしますか?
データを貼り付け、応答列を選択し、必要に応じてFactorまたは列を別々のグループとして比較するオプションを選び、LSLとUSLを入力します。Normality p-value threshold(既定値0.1)を設定します。レポートには、振り分けの判断、当てはめたヒストグラム、分布パラメータ、工程能力指数、PPMの表が表示され、Excelにエクスポートできます。