
カイ二乗適合度検定(Chi Square Goodness Of Fit)
カイ二乗適合度検定は、カテゴリ変数の観測度数分布が、特定の期待分布と一致するかどうかを判定する検定です。データ内で各カテゴリが実際に出現する頻度と、理論モデルや事前の仮定に基づいて各カテゴリが出現すると期待される頻度とを比較します。
最終レビュー
重要なポイント
カイ二乗適合度検定は、カテゴリ変数の観測度数分布が、特定の期待分布と一致するかどうかを判定する検定です。
このページの内容
カイ二乗適合度検定とは
カイ二乗適合度検定は、カテゴリ変数の観測度数分布が、特定の期待分布と一致するかどうかを判定する検定です。データ内で各カテゴリが実際に出現する頻度と、理論モデルや事前の仮定に基づいて各カテゴリが出現すると期待される頻度とを比較します。
たとえば、生産ラインで不良がすべての勤務シフトで均等に発生しているかどうか、あるいは顧客からの苦情が、モデルの予測する比率でカテゴリに分布しているかどうかを検定できます。
簡単な定義:カテゴリごとに観測された実際の度数が、期待していた度数と一致するかどうかを調べる検定で、データが予測したパターンに当てはまるかを教えてくれます。
カイ二乗適合度検定を使用する場面
- 応答変数が カテゴリ変数 であり、その観測分布が期待分布または理論分布と一致するかを検定したい場合に使用します。
- シフト、機械、製品タイプなどのカテゴリにわたって、工程が期待どおりの比率で不良や結果を生み出しているか を確認するために使用します。
- 検定の際に、理論モデルや事前分布 があり、実際のデータがそれにどの程度適合するかを検定したい場合に使用します。
- 仕様や過去のデータから期待度数がわかっている 抜取監査、コンプライアンス確認、品質レビュー で使用します。
カイ二乗適合度検定を正しく使用するためのガイドライン
- 各カテゴリの 期待度数は5以上 でなければなりません。期待度数が非常に小さいカテゴリがあると、検定の信頼性が低下します。必要に応じてカテゴリを統合してください。
- 観測値は 独立 でなければなりません。あるカテゴリの度数が、別のカテゴリの度数に影響してはいけません。
- 期待される比率または度数は、データを見る前に指定 しなければなりません。検定対象と同じデータセットから導くのは循環論法であり、無効です。
- 検定の結果、p値が0.05未満 の場合は、観測分布が期待分布と有意に異なることを示します。どのカテゴリの偏りが最も大きいかを調べてください。
- すべてのセルの期待度数が最小のしきい値5を満たすように、十分に大きな総サンプル を収集してください。
代替手法:カイ二乗適合度検定を使用すべきでない場合
- 分析の目的が 2つのカテゴリ変数の関係の検定である場合に適した手法:カイ二乗独立性検定
- 応答変数が 連続である場合に適した手法:正規性の検定または個別分布の同定
- カウントデータが ポアソン過程(時間または面積当たりの稀な事象)に従う場合に適した手法:ポアソン適合度検定
カイ二乗適合度検定の例
調達担当マネージャーが、販売されたTシャツのサイズ別の比率と、発注したサイズ別の比率を比較したいと考えています。マネージャーは1週間に販売されたTシャツの枚数をサイズごとに数えます。バイヤーはカイ二乗適合度検定を行い、販売されたTシャツのサイズ別の比率が、発注したサイズ別の比率と整合しているかを判定します。検定は次の手順で行います。
- 必要なデータを収集しました。
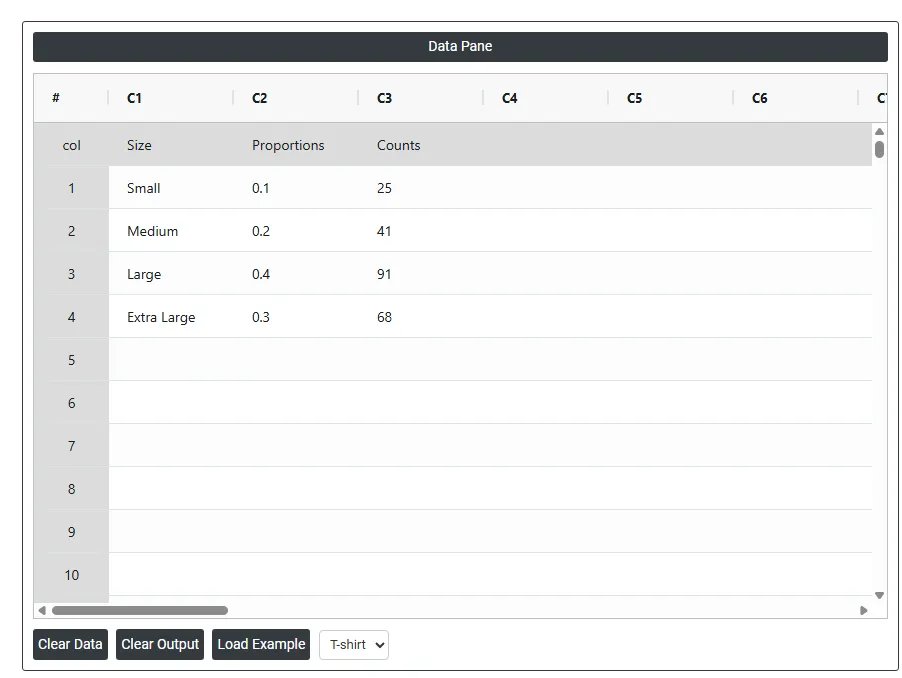
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- Chi Square Goodness Of Fitを見つけるには、Statistical module> Hypothesis Test> Chi Square Goodness Of Fitを選択します。
- ツール内で、データとその他の入力を次のように入力します。
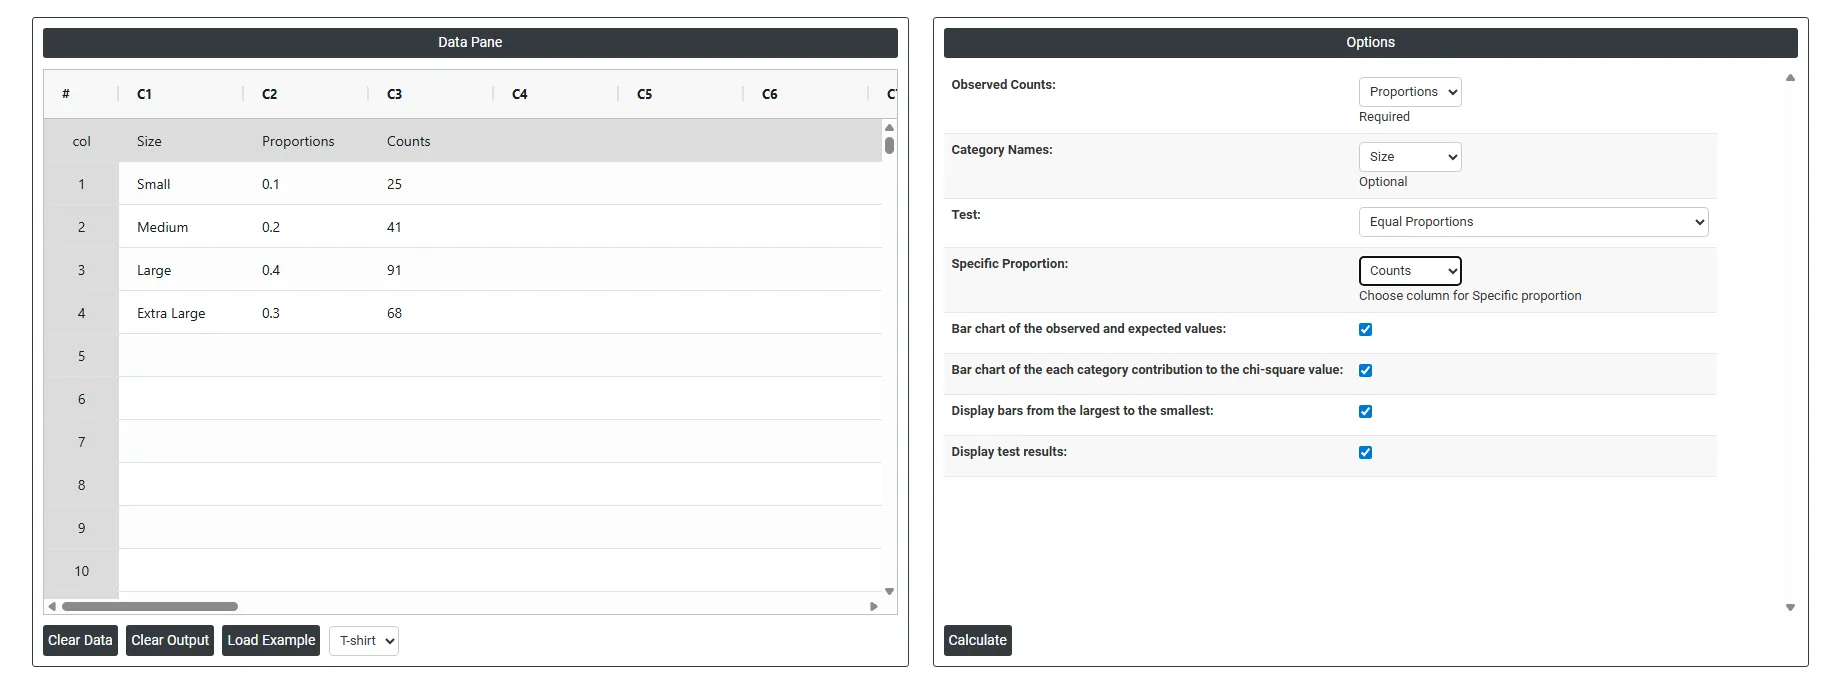
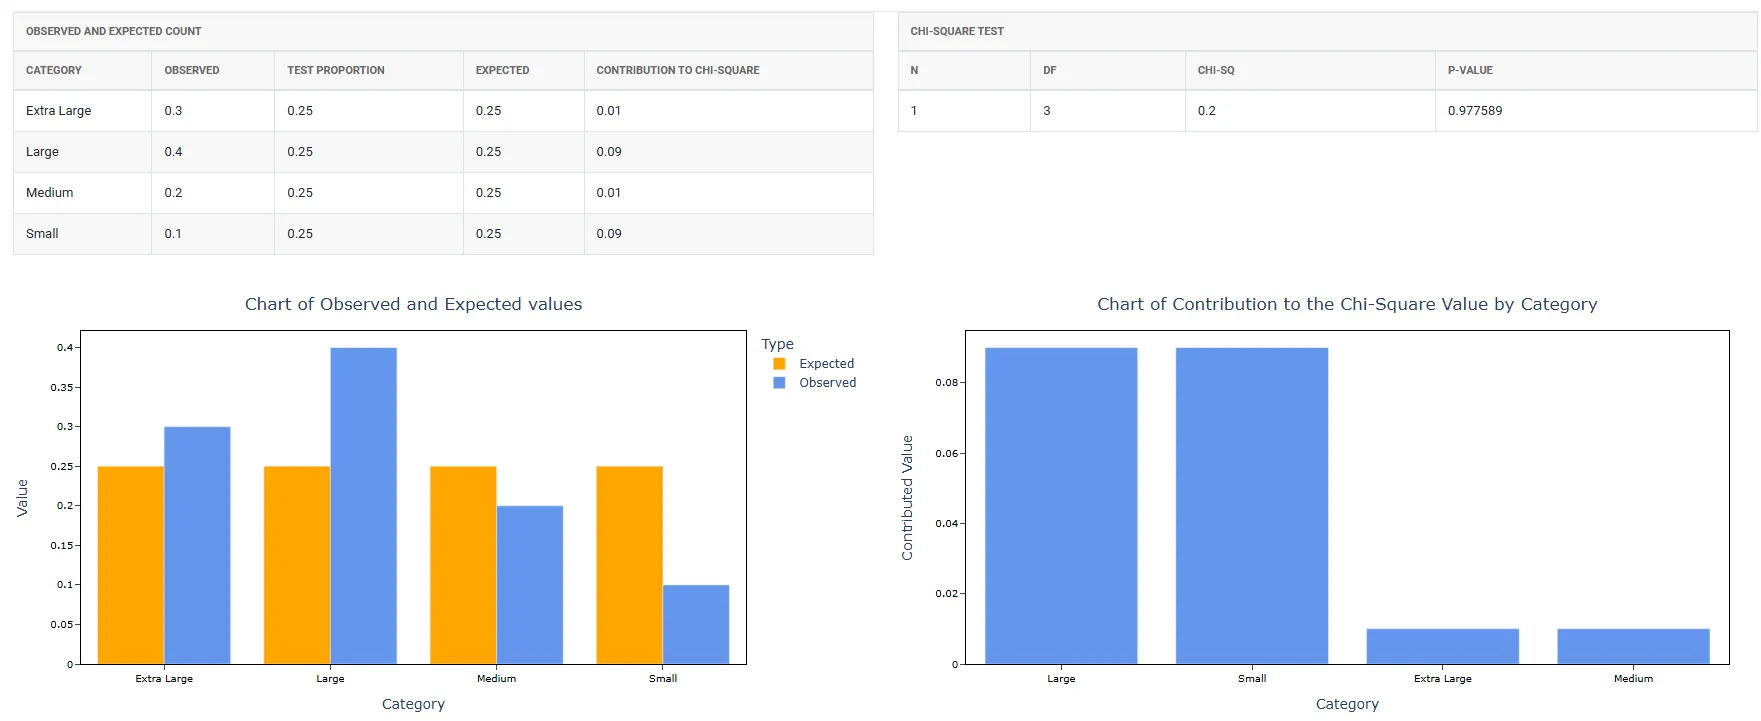
5. 上記のツールを使用すると、次のような出力が得られます。
カイ二乗適合度検定の実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Hypothesis Test >Chi Square Goodness Of Fit を選択します。
- 次に、データを手動で更新するか、Excelシートのデータをすべてコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
- 必要なオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
Chi Square Goodness Of Fitのダッシュボードは、ウィンドウが2つの部分に分かれています。
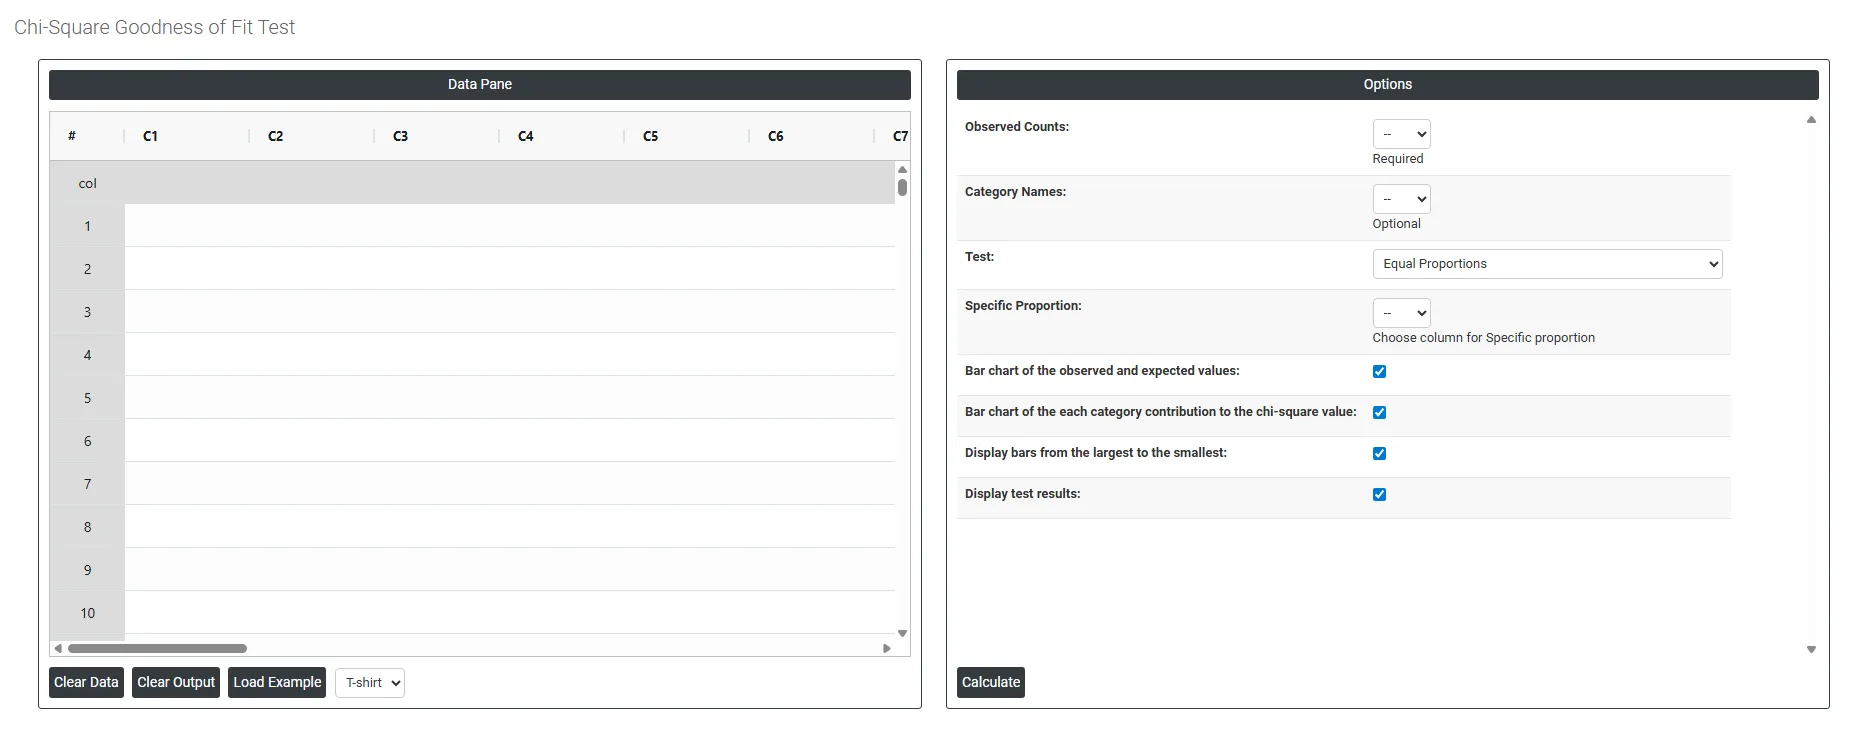
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートのデータをすべてコピー(Ctrl+C)して、ここに貼り付け(Ctrl+V)ます。
Load example: サンプルデータが読み込まれます。
Load File: Excelのデータを直接読み込むときに使用します。
右側には、次のような多くのオプションがあります。
- Observed Counts データ内の各カテゴリについて記録された 実際の度数 を含む列を選択します。たとえば、各シフトで観測された不良の数、カテゴリごとの顧客からの苦情の件数、各グループでの発生回数などです。これは、実際に起きたことと期待されていたことを検定が比較するための中核となる入力です。この項目は必須です。
- Category Names; 各カテゴリの ラベルまたは名前 を含む列を選択します。たとえば、Shift 1、Shift 2、Shift 3、またはScratch、Dent、Tearなどです。これは任意ですが、指定すると出力のグラフと結果表にラベルが明確に付き、解釈やレポートでの提示がしやすくなるため推奨します。
- Test: 観測度数をどの期待分布と比較するかを定義します。次の3つのオプションがあります。
- Equal Proportions — すべてのカテゴリが同じ頻度で出現するかを検定します。各カテゴリが同じ回数だけ現れるはずだというのが帰無仮説の場合に使用します。たとえば、不良が曜日全体で均等に分布しているかを検定する場合です。
- Specific Proportions — 手動で入力した、あらかじめ定めた特定の比率でカテゴリが出現するかを検定します。理論、過去のデータ、仕様に基づく期待分布がある場合に使用します。たとえば、結果の60%がカテゴリA、30%がカテゴリB、10%がカテゴリCに入るかを検定する場合です。
- Properties Specified by Historical Counts (Input Column) — 手動で入力した値ではなく、過去の度数を収めた参照列から導いた期待比率に対して検定します。現在のデータを比較したい分布を持つ、以前のデータセットやベースライン期間がある場合に使用します。
- Specific Proportion: Specific ProportionsまたはHistorical Countsのテストオプションを使用する場合に、各カテゴリの 期待比率または参照度数 を含む列を選択します。この列の値は、帰無仮説の下で分布がどのようになるべきかを定義します。各カテゴリの期待比率は、Observed Counts列のカテゴリと順序が対応していなければなりません。
- Bar Chart of Observed and Expected Values: 有効にすると、各カテゴリの 観測度数と期待度数 を並べて比較する棒グラフを表示します。これは最も有用な視覚的出力の1つで、観測値と期待値の差が最も大きいカテゴリが一目でわかり、分布が最も大きくずれている箇所を特定するのに役立ちます。
- Bar Chart of Each Category Contribution to the Chi-Square Value: 有効にすると、各カテゴリが カイ二乗統計量全体に寄与する大きさを示す棒グラフを表示します。棒が最も高いカテゴリが有意な結果の要因です。全体として差があることを知るだけでなく、期待分布からのずれに最も寄与しているカテゴリを正確に特定できます。
- Display Bars from Largest to Smallest: 有効にすると、グラフの棒を寄与度または度数の大きいものから小さいものへ、降順 に並べ替えます。どのカテゴリが最も重要かの優先順位をつけやすくなり、最も大きな偏りから先に注目できます。カテゴリが多く、最も有意なものをすばやく特定したい場合に特に便利です。
- Display Test Results: 有効にすると、検定の統計出力の全体(カイ二乗統計量、自由度、p値を含む)を、グラフ上またはグラフと並べて直接表示します。別の出力表を参照しなくても、視覚的な結果と統計的な結果を1か所でまとめて確認できます。
よくある質問
カイ二乗適合度検定では何がわかりますか?
各カテゴリが実際に出現する頻度と、理論モデルや事前の仮定の下で出現すべき頻度とを比較することで、カテゴリ変数の観測度数分布が、特定の期待分布と一致するかどうかがわかります。p値が0.05未満の場合は有意な差があることを示します。その場合は、どのカテゴリの偏りが最も大きいかを調べてください。
カイ二乗適合度検定の前提条件は何ですか?
各カテゴリの期待度数は5以上である必要があります。必要に応じてカテゴリを統合し、十分に大きな総サンプルを収集してください。観測値は独立でなければならず、あるカテゴリの度数が別のカテゴリに影響してはいけません。期待される比率は、データを見る前に指定する必要があります。同じデータセットから導くのは循環論法であり、無効だからです。
どのような期待分布に対して検定できますか?
Zometric Statistical SoftwareのTestオプションには3つの選択肢があります。Equal Proportionsは、すべてのカテゴリが同じ頻度で出現するはずの場合です。Specific Proportionsは、理論、過去のデータ、仕様に基づいて手動で入力します。3つ目は、参照列の過去の度数で期待比率を指定する方法で、現在のデータを以前のデータセットやベースライン期間と比較します。
代わりにカイ二乗独立性検定を使用するのはどのような場合ですか?
適合度検定は、1つのカテゴリ変数を期待分布と比較する場合に使用します。2つのカテゴリ変数の関係を検定するには、カイ二乗独立性検定を使用します。応答が連続の場合は正規性の検定または個別分布の同定を、カウントがポアソン過程に従う場合はポアソン適合度検定を使用します。