
カイ二乗独立性検定(クロス集計)(Chi-Square Test of Independence)
カイ二乗独立性検定は、集計済みの2元表の度数、または元の記録から、2つのカテゴリー変数に関連があるかどうかを検定します。独立の場合の期待度数と観測度数を、自由度 (r − 1)(c − 1) のPearsonのカイ二乗および尤度比カイ二乗で比較します。寄与と調整済み残差から、どのセルが結果の原因となっているかがわかります。期待度数が小さすぎてはいけません。
最終レビュー
重要なポイント
カイ二乗独立性検定は、2つのカテゴリー変数に関連があるかどうかを調べます。たとえば、欠点の種類の構成が直、供給者、ラインによって異なるかを調べ、どのセルが関連の原因となっているかを示します。
目的
カイ二乗独立性検定は、2つのカテゴリー変数に関連があるかどうかを調べます。たとえば、欠点の種類の構成が、直、供給者、ラインによって異なるかどうかを調べます。すでに集計した度数の表、または1単位につき1行の元の記録を入力すると、本ツールは関連を検定し、どのセルがその原因となっているかを示します。
主な機能
- 集計済みの2元表(列カテゴリーごとに1列、行カテゴリーごとに1行)、または度数(任意)付きの元のカテゴリーデータ。
- Pearsonのカイ二乗検定と尤度比カイ二乗検定。
- 期待度数、カイ二乗への寄与、元の残差・標準化残差・調整済み残差、行・列・全体の割合の各表(いずれも任意)。
- 任意のガイド付き解釈:百分率プロファイルと%差のグラフを含むサマリーレポート、診断レポート、レポートカード。
- Data Options:分析前に行を絞り込みます。
統計的手法
行合計Rᵢ、列合計Cⱼ、総計Nをもつ r × c の観測度数Oの表では、独立の場合の期待度数は Eᵢⱼ = Rᵢ·Cⱼ / N です。Pearson統計量は χ² = Σ (O − E)² / E、尤度比統計量は G² = 2 Σ O·ln(O / E) です。どちらも自由度 (r − 1)(c − 1) のカイ二乗分布と比較します。p値が小さいことは、行変数と列変数に関連があること、つまり列の構成がすべての行で同じではないことを意味します。
各セルの寄与 (O − E)² / E は、関連がどこから生じているかを示します。元の残差は O − E、標準化残差は (O − E) / √E、調整済み残差は (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)) で、これはおおよそ標準正規分布に従います。±2をおよそ超える値は、独立の場合から明らかに異なるセルを示します。元のデータでは、本ツールはまず2つの列をクロス集計し、度数列が指定されていればそれを合計します。空白のセルは除外されます。合計が0の行または列は削除する必要があります。p値は、期待度数が小さすぎない場合に信頼できます。ガイド付き解釈でこれを確認します。
入力項目とオプション
項目 | 説明 |
Data | Summarized data in a two-way table(既定)、またはRaw data (categorical variables)です。 |
Columns (one per column-category) | 表形式:2つ以上の数値列で、各列に列変数の1つのカテゴリーの度数を入力し、行カテゴリーごとに1行とします。必須です。 |
Row labels | 表形式、任意:各行カテゴリーの名称を示す列です。空白の場合は Row 1、Row 2、… になります。 |
Rows / Columns / Frequencies (optional) | 元データ形式:2つのカテゴリー列と、各記録の度数を示す任意の列です。 |
Statistics | Expected cell countsとEach cell's contribution to chi-square(既定でチェック済み)、Raw residuals、Standardized residuals、Adjusted residuals、Row percents、Column percents、Total percentsです。 |
Data Options: Subset (optional) | 行番号や条件により、一致する行を除外(既定)するか、一致する行のみを対象にします(Exclude matching rows / Include only matching rows)。 |
Show guided interpretation | 平易な言葉によるSummary、Diagnostic、Report Cardを追加します。これに対し、Difference between the % defectives with practical valueは任意の入力項目です。 |
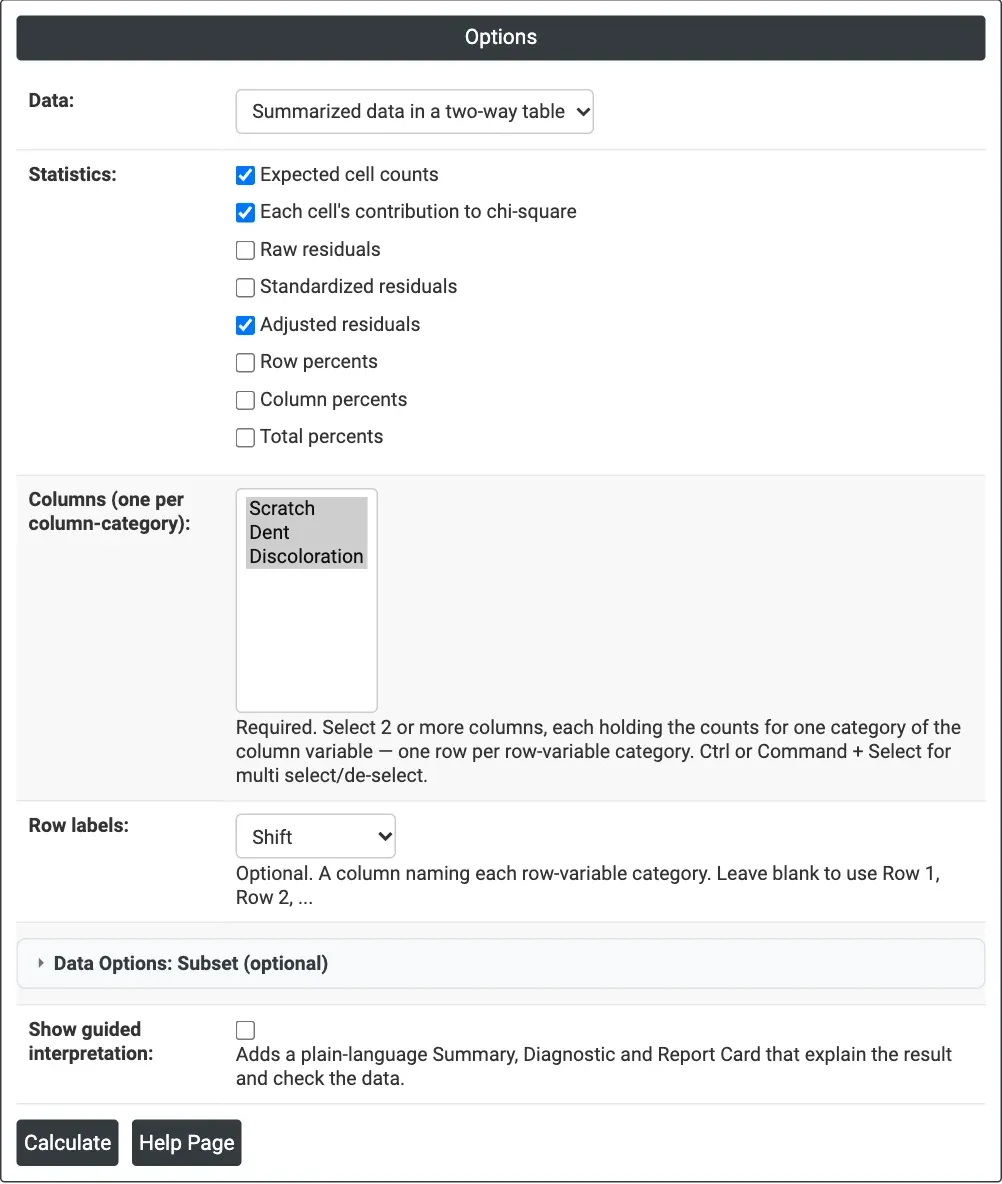
図1 — 欠点の種類の例のオプション:Scratch、Dent、Discolorationの度数を列、Shiftを行ラベルとした集計済みの表で、adjusted residualsにチェックを入れています。
出力の説明
- Observed Counts — 行合計と列合計(All)を含む表。
- Expected Counts と Contribution to Chi-Square — チェックを入れた場合。
- Chi-Square Tests — Pearson検定と尤度比検定の Chi-Sq、DF、P-Value。
- Raw Residuals、Standardized Residuals、Adjusted Residuals、Row Percents、Column Percents、Total Percents — チェックを入れた場合。
- Summary Report、Diagnostic Report、Report Card — ガイド付き解釈を使用した場合。
- Download によるPDF出力。
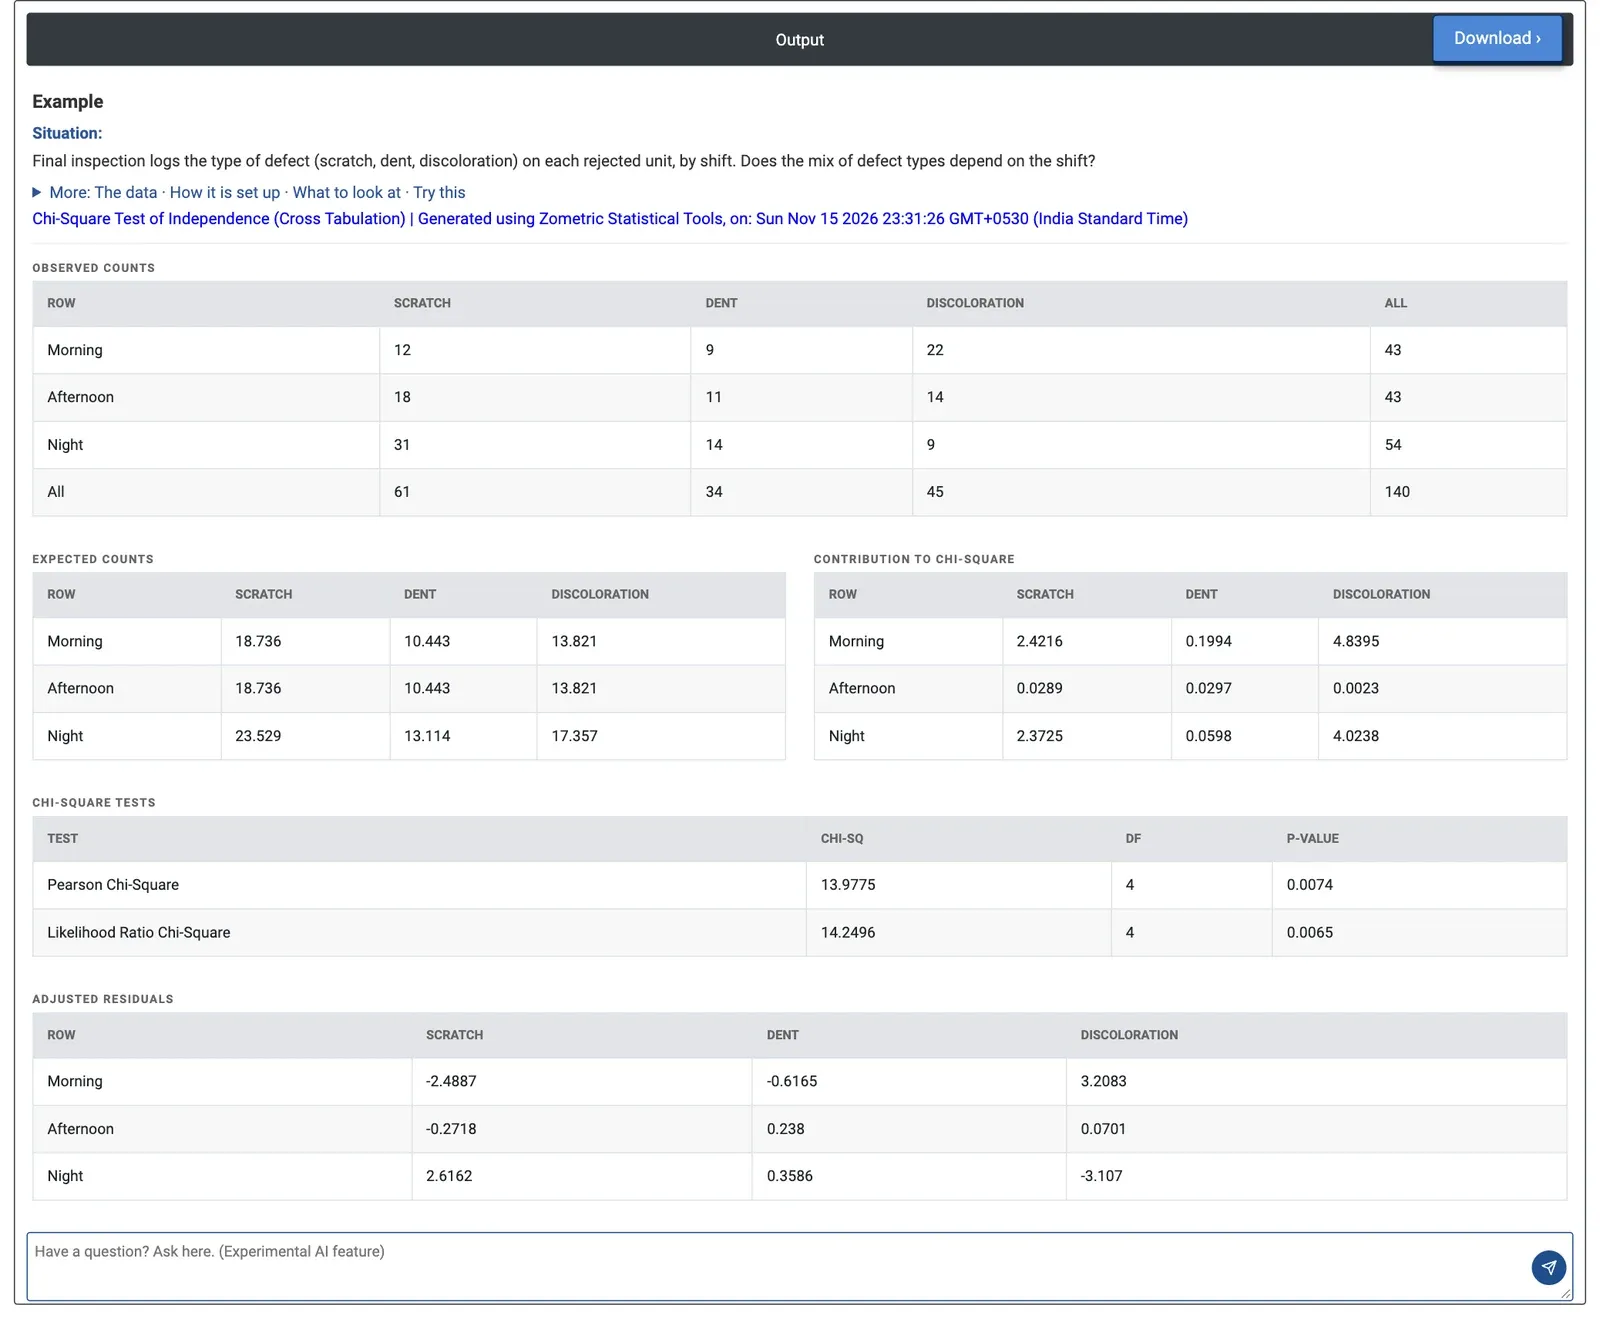
図2 — 直ごとの欠点の種類:Pearsonのカイ二乗は13.98、自由度4、p = 0.0074。調整済み残差は、朝の直の変色と夜の直のキズを示しています。
計算例
最終検査では、不合格となった各単位の欠点の種類を直ごとに記録しており、不合格は合計140個です。品質チームは、欠点の種類の構成が直によって異なるかどうかを知りたいと考えています。チームは、欠点の種類(Scratch、Dent、Discoloration)ごとに1列、Shiftを行ラベルとした表として度数を入力し、既定の統計量に加えてAdjusted residualsにチェックを入れます。
欠点の構成は直によって異なります。Pearsonのカイ二乗は13.98、自由度4、p = 0.0074です(尤度比は14.25、p = 0.0065)。寄与からその原因がわかります。朝の直の変色(4.84;観測22個に対して期待13.8個)と夜の直の変色(4.02;9個に対して17.4個)、次に朝の直のキズ(2.42;12個に対して18.7個)と夜の直のキズ(2.37;31個に対して23.5個)です。午後の直は全体の構成と一致しており、へこみは均等に分布しています。
調整済み残差もこれを裏付けています。朝の直の変色の3.21と夜の直のキズの2.62は、2を大きく超えています。チームは、変色については一日の始まりに変わること(たとえば、暖機運転や塗料のバッチの違い)を、キズについては夜の直での取扱いと照明を調べます。期待度数はすべて10を上回っているため、p値は信頼できます。
よくある質問
カイ二乗独立性検定では、期待度数はどのように計算しますか?
独立の場合、セルの期待度数は、その行合計に列合計を掛けて総計で割った値、E = R x C / N です。Pearson統計量は、すべてのセルについて (O − E)² / E を合計したもので、自由度 (r − 1)(c − 1)(rとcはそれぞれ行数と列数)のカイ二乗分布と比較します。
カイ二乗独立性検定の結果は、どのように解釈しますか?
p値が小さいことは、行変数と列変数に関連があること、つまり列の構成がすべての行で同じではないことを意味します。関連がどこから生じているかを調べるには、各セルの寄与 (O − E)² / E と調整済み残差を確認します。調整済み残差はおおよそ標準正規分布に従い、±2をおよそ超える値は、独立の場合から明らかに異なるセルを示します。
この検定には、どのようなデータ形式が必要ですか?
Zometric Statistical Softwareでは、集計済みの2元表(列カテゴリーごとに1つの数値列、行カテゴリーごとに1行)、または2つのカテゴリー列と任意の度数列をもつ元のデータを入力できます。元のデータでは、本ツールはまず2つの列をクロス集計します。合計が0の行または列は削除する必要があります。
カイ二乗検定のp値が信頼できるのはどのような場合ですか?
p値は、期待度数が小さすぎない場合に信頼できます。任意のガイド付き解釈でこれを確認します。直ごとの欠点の種類の計算例では、期待度数がすべて10を上回っていたため、自由度4でのPearsonのp値0.0074は信頼できました。