
K平均法クラスター分析(Cluster K-Means)
クラスターK-Meansは、2つ以上の数値変数に基づく観測値を、指定したK個のクラスターにグループ化します。Lloyd法を用い、初期中心はk-means++で選び、乱数による開始を複数回行います。単位の異なる変数は標準化してください。グループ数がわかっている場合に使用します。出力には、最終分割、クラスターの重心、各観測値のクラスターと距離、説明される変動の割合が含まれます。
最終レビュー
重要なポイント
クラスターK-Meansは、観測値を指定した数(K)のグループに分け、選択した変数について各グループ内の観測値ができるだけ似るようにします。たとえば、ロット、部品、供給者をタイプ別に分類する場合に使用します。
目的
クラスターK-Meansは、観測値を指定した数(K)のグループに分け、選択した変数について各グループ内の観測値ができるだけ似るようにします。グループ数がわかっている場合に使用します。たとえば、複数の測定特性から材料ロット、部品、供給者をタイプ別に分類する場合や、すでに使っているラベル(グレード、ライン、シフト)が測定値に表れているかどうかを確認する場合です。
主な機能
- 2つ以上の数値変数に基づいて観測値を、指定したK個のクラスターにグループ化します。
- 任意の標準化。大きな単位で測定された変数がグループ化を支配しないようにします。
- 乱数による複数の開始点から、最良の解(クラスター内のばらつきが最小のもの)を採用します。同じデータであれば常に同じ結果になります。
- 最終分割(大きさ、クラスター内平方和、重心からの平均距離と最大距離)、元の単位での各クラスターの重心、各観測値のクラスター、およびクラスターで説明される全変動の割合を報告します。
- 選択した最初の2変数の散布図。クラスターごとに色分けします。
統計的手法
選択した変数のいずれかに欠損値または数値でない値がある行は除外します。Standardize variables にチェックを入れると、クラスタリングの前に各変数を標本標準偏差 s を用いて z = (x − mean) / s に変換し、すべての変数の平均が0、標準偏差が1になるようにします。
K-meansアルゴリズム(Lloyd法)は、各観測値をユークリッド距離で最も近いクラスターの中心に割り当て、各中心をそのメンバーの平均として再計算し、割り当てが変化しなくなるまで繰り返します。初期中心はk-means++の規則で選びます。結果は開始点に依存することがあるため、Number of random starts の回数だけアルゴリズムを実行し、クラスター内平方和が最小の実行結果を採用します。乱数シードは固定されているため、結果は正確に再現されます。
クラスターで説明される変動の割合は (全平方和 − クラスター内平方和) / 全平方和 × 100 です。全平方和は全観測値の全体平均からの距離の二乗和、クラスター内平方和は各観測値から自身のクラスター中心までの距離の二乗和です。どちらも、クラスタリングしたデータ(標準化にチェックを入れた場合は標準化後)で測定します。この値が高いほど、グループはより明確で密になりますが、K を増やすと必ず上昇するため、K 間の比較は慎重に行ってください。重心は、報告のために元の単位に戻されます。最終分割では、各クラスターについて、観測値の数、クラスター内平方和、メンバーの重心からの平均距離と最大距離が示されます。これらの距離と、メンバーシップ表の各観測値の距離は、クラスタリングに用いた単位(標準化にチェックを入れた場合は標準化後)でのユークリッド距離で、Minitabと同じです。
入力項目とオプション
項目 | 説明 |
Variables | クラスタリングに用いる2つ以上の数値の列です。Ctrl または Command を押しながらクリックすると複数選択できます。 |
Number of clusters (K) | 作成するグループの数です。既定値は3で、最小は2です。少なくとも K 個の完全な観測値が必要です。 |
Standardize variables | 既定でチェックされています。クラスタリングの前に、すべての変数を同じ尺度(平均0、標準偏差1)にそろえます。すべての変数の単位が同じで、ばらつきの大きい変数により大きな重みを与えたい場合にのみ、チェックを外してください。 |
Number of random starts | 試行する開始点の数で、最良の結果が採用されます。既定値は10で、1〜100を指定できます。 |
Title | プロットと出力に表示されるタイトルです。既定値は Cluster K-Means です。 |
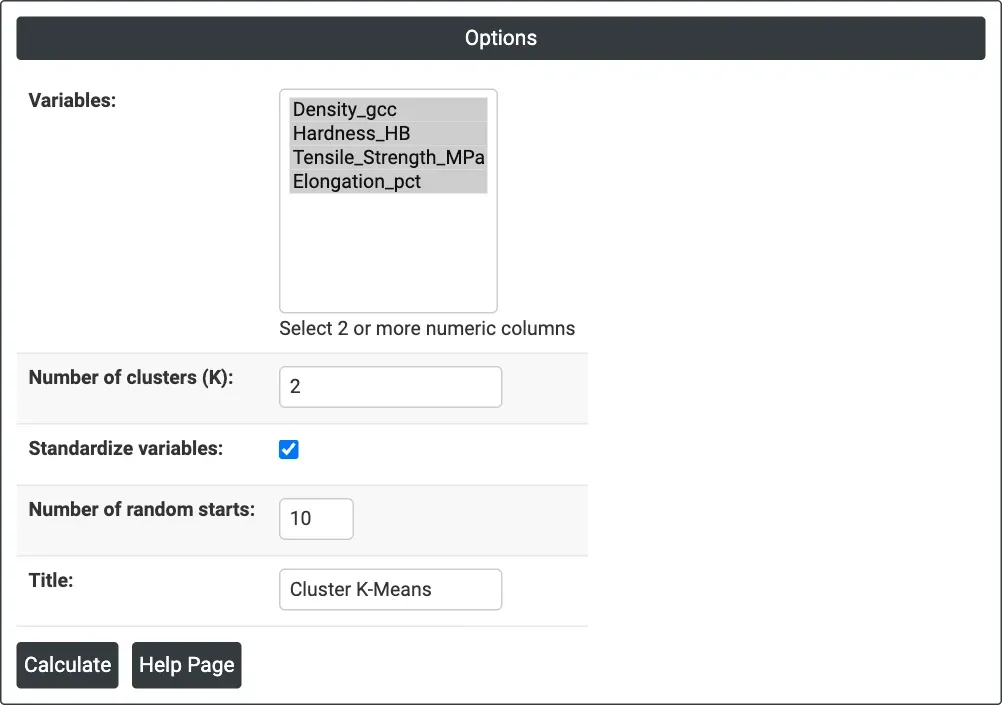
図1 — 例のオプション:4つの特性の列、K = 2、標準化あり、乱数による開始10回。
出力の説明
- Cluster K-Means plot — 最初に選択した変数(x)に対する2番目の変数(y)の散布図。各点はクラスターごとに色分けされます。
- % variation explained by clusters — 全変動のうち、クラスター内ではなくクラスター間にある割合です。
- Final Partition — クラスターごとに、Number of observations、Within cluster sum of squares、Average distance from centroid、Maximum distance from centroid を示します。
- Cluster Centroids — クラスターごとの観測値の数 N と、元の単位での各変数の平均です。
- Cluster Membership — 各観測値(ワークシートの行)、そのクラスター、およびそのクラスターの重心からの距離です。
- Download によるPDF出力。
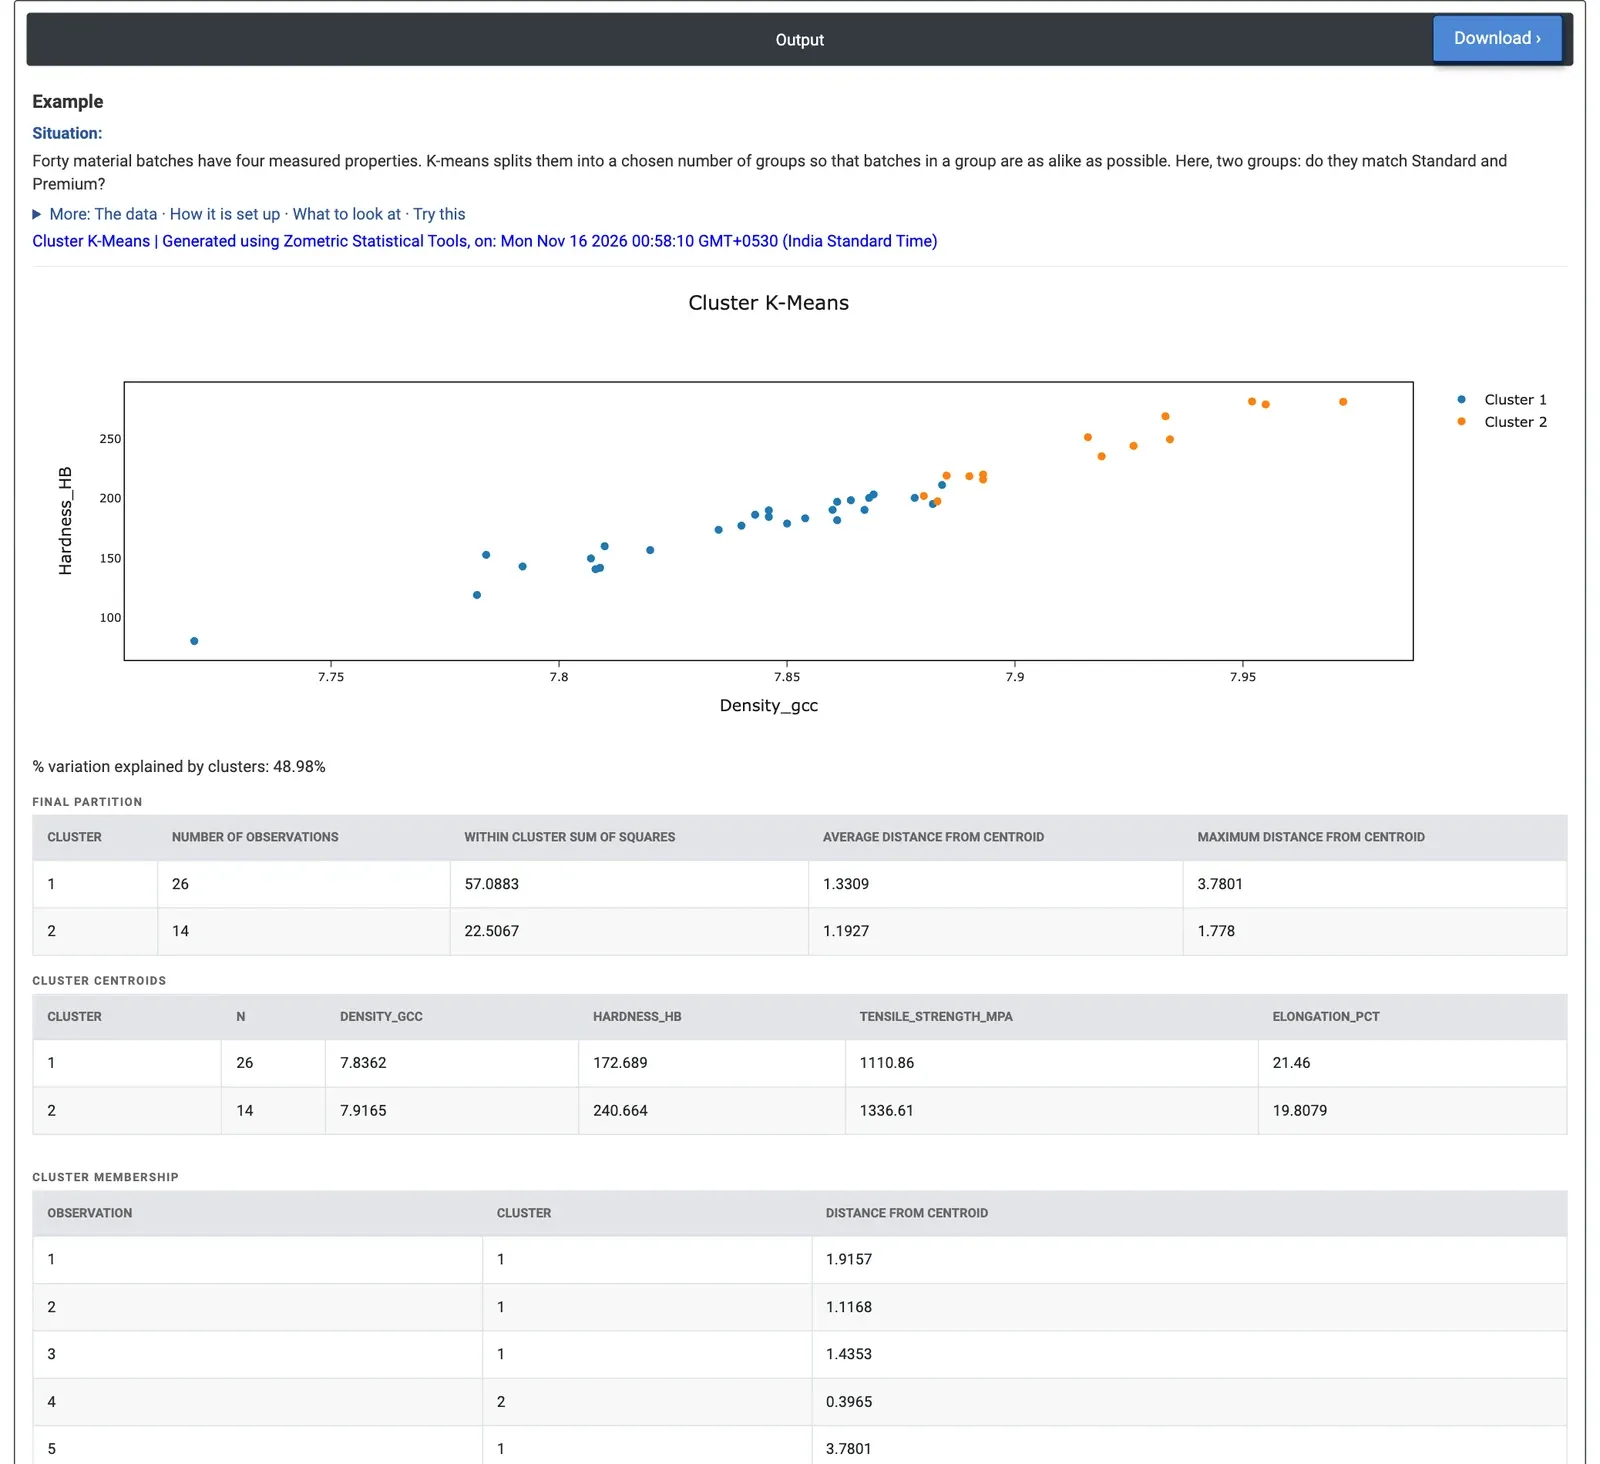
図2 — 40ロットの材料の2つのクラスター:Cluster 2(14ロット)はより硬く強度が高く、クラスターは変動の48.98%を説明しています。最終分割、重心、メンバーシップ表の冒頭がプロットの後に続きます。
計算例
材料試験所に40ロットがあり、それぞれ密度(g/cc)、硬さ(HB)、引張強さ(MPa)、伸び(%)が測定されています。ロットはStandardまたはPremiumとして販売されており、各20ロットです。試験所は、測定値だけで2つの自然なグループに分かれるか、またそのグループがロットのタイプと一致するかを知りたいと考えています。4つの特性の列を選択し、Number of clusters (K) = 2 を設定し、Standardize variables にチェックを入れたまま(そうしないと、数百の値をとる引張強さが支配的になります)、乱数による開始は10回のままにします。
クラスターは変動の48.98%を説明します。Cluster 2は、より硬く強度が高く(平均240.7 HB、1,336.6 MPa)、伸びがやや小さい(19.8%)14ロットで構成されます。Cluster 1は、平均172.7 HB、1,110.9 MPa、伸び21.5%の26ロットで構成されます。密度の重心の差はわずかです(7.92 g/ccと7.84 g/cc)。最終分割では、Cluster 2のほうが密なグループです(重心からの平均距離は、標準化後の単位で1.19に対し1.33)。Cluster 1で最も離れたメンバーである行5は、重心から3.78単位離れており、確認する価値のある異例のロットです。ロットのタイプの列と比較すると、Cluster 2にはPremium 11ロットとStandard 3ロット、Cluster 1にはStandard 17ロットとPremium 9ロットが含まれ、40ロット中28ロットがタイプに一致するクラスターに入っています。
試験所にとってこれは、最も強いロットが明確なグループを形成する一方、多くのPremiumロットはStandardより硬くも強くもないことを意味します。つまり、ラベルは特性によって完全には裏付けられていません。K = 3では、説明される変動が69.66%に上昇し、軟らかく弱い9ロットのグループ(138.2 HB、995.9 MPa)が、中間の23ロットのグループと上位の8ロットのグループから分離します。Standardize variables のチェックを外すと、引張強さが大部分の重みを占めるため、分割は19ロットと21ロットに変わります。既知のタイプを用いるルールを作成するには、同じデータに対してDiscriminant Analysisを実行してください。
よくある質問
k-means法はどのような場合に使用しますか?
グループ数がわかっていて、複数の測定特性から、材料ロット、部品、供給者などの観測値をタイプ別に分類したい場合に使用します。また、グレード、ライン、シフトなど、すでに使っているラベルが測定値に実際に表れているかどうかを確認するのにも役立ちます。
k-meansの前に変数を標準化すべきですか?
標準化により、各変数が平均0、標準偏差1に変換されるため、大きな単位で測定された変数がグループ化を支配しません。既定でチェックされています。すべての変数の単位が同じで、ばらつきの大きい変数により大きな重みを与えたい場合にのみ、チェックを外してください。計算例では、チェックを外すと引張強さが大部分の重みを占めるため、分割が変わりました。
クラスター数Kはどのように選びますか?
出力には、クラスターで説明される全変動の割合が示され、この値が高いほど、グループはより明確で密になります。K を増やすと必ず上昇するため、K 間の比較は慎重に行ってください。例では、2クラスターで変動の48.98%、3クラスターで69.66%が説明され、軟らかく弱い9ロットのグループが分離しました。
k-means法と判別分析の違いは何ですか?
K-meansは、既知のラベルを使わず、測定値だけからグループを見つけます。例では、2つのクラスターがStandardまたはPremiumのラベルと一致したのは、40ロット中28ロットだけでした。既知のタイプを用いてグループを分離するルールを作成するには、同じデータに対してDiscriminant Analysisを実行してください。