
観測値のクラスター分析(Cluster Observations)
Cluster Observationsは、2つ以上の数値変数について、最も類似した観測値を段階的に結合し、結果をデンドログラムとして描画します。7種類の連結法と5種類の距離尺度から選択でき、単位の異なる変数は標準化します。Ward、Centroid、Medianはユークリッド距離または平方ユークリッド距離が必要です。クラスター数を入力すると、樹形図が切断され、各観測値にラベルが付きます。
最終レビュー
重要なポイント
Cluster Observationsは階層的クラスター分析で、グループ数を事前に知らなくても、複数の数値変数にわたって似ている行をまとめます。自然なグループや外れた行を示すデンドログラムを描画します。
目的
Cluster Observationsは、グループ数を事前に知らなくても、複数の数値変数にわたって似ている観測値(行)をまとめます。最も類似した観測値を段階的に結合し、結果をデンドログラム(樹形図)として描画するため、自然なグループがいくつあるか、どの観測値が同じグループに属するかがわかります。バッチ、部品、サプライヤー、生産ランの自然なまとまりを探したり、どのグループにも当てはまらない観測値を見つけたりするのに使用します。
主な機能
- 2つ以上の数値変数に基づく観測値の階層的(凝集型)クラスター分析。
- 7種類の連結法:Single、Complete、Average、Centroid、Median、McQuitty、Ward。
- 5種類の距離尺度:Euclidean、Squared Euclidean、Manhattan (City Block)、Cosine、Correlation。
- 任意の標準化:単位の異なる変数を同等に扱えます。
- 結合の全過程を示すデンドログラム。クラスター数を指定すると、各観測値のクラスター割り当ても表示できます。
統計的手法
選択した変数のいずれかに欠損値または非数値がある行は除外され、観測値は3つ以上必要です。Standardize variables にチェックを入れると、各変数は標本標準偏差 s を用いて z = (x − mean) / s に変換されます。その後、選択した尺度ですべての観測値の組の間の距離が計算されます。尺度は、Euclidean √Σ(xᵢ − yᵢ)²、Squared Euclidean Σ(xᵢ − yᵢ)²、Manhattan Σ|xᵢ − yᵢ|、Cosine 1 − cos(2つの行の間の角度)、Correlation 1 − r(2つの行の間)です。
クラスター分析は、すべての観測値をそれぞれ1つのクラスターとして開始し、最も近い2つのクラスターを1つになるまで繰り返し併合します。連結法は、2つのクラスター間の距離の測り方を決めます。Singleは最も近いメンバーの組、Completeは最も遠いメンバーの組、Averageはすべての組の距離の平均、McQuittyは加重平均、Centroidはクラスターの中心間の距離、Medianは重み付けのない中心間の距離を用います。Wardは、クラスター内平方和の増加が最小になるクラスターの組を併合します。Ward、Centroid、Medianにはユークリッド距離または平方ユークリッド距離が必要で、それ以外の組み合わせはツールが受け付けません。
デンドログラムで2つの枝が結合する高さは、併合時点での両者の間の距離であるため、縦に長い枝はよく分離したグループを示します。Number of clusters を入力すると、その数のクラスターが得られる水準で樹形図が切断され、各観測値にクラスター番号のラベルが付きます。
入力項目とオプション
項目 | 説明 |
Variables | 各観測値を表す2つ以上の数値列。複数選択するには、Ctrl または Command を押しながらクリックします。 |
Linkage method | クラスター間の距離の測り方:Single、Complete、Average(既定値)、Centroid、Median、McQuitty、Ward。 |
Distance measure | 2つの観測値間の距離の測り方:Euclidean(既定値)、Squared Euclidean、Manhattan (City Block)、Cosine、Correlation。 |
Standardize variables | 既定でチェックが入っています。まずすべての変数を平均0、標準偏差1にスケーリングするため、単位が大きい変数が結果を支配しません。 |
Number of clusters | 任意で、2以上。樹形図をこの数のクラスターに切断し、Cluster Assignments の表を追加します。空欄のままにすると、デンドログラムのみが表示されます。 |
Title | デンドログラムに表示されるタイトル。既定値は Cluster Observations です。 |
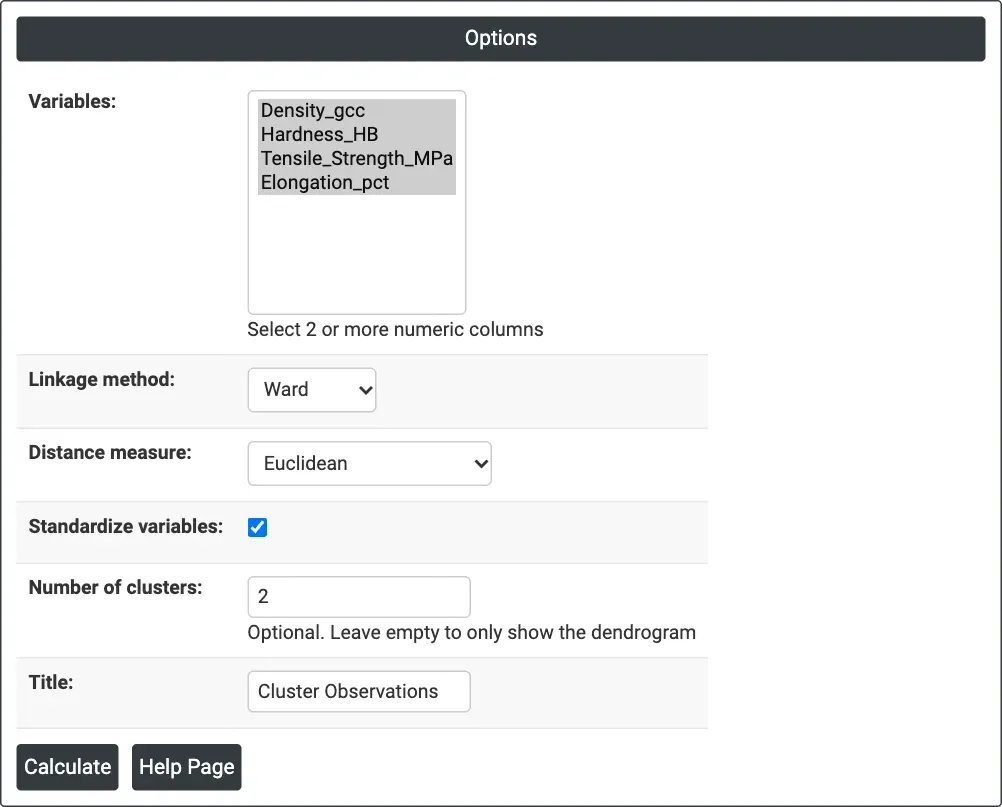
図1 — 例のオプション:4つの特性列、Ward連結、ユークリッド距離、標準化あり、2クラスター。
出力の説明
- Dendrogram — 結合の過程。観測値(行番号)は樹形図の順にx軸に沿って並び、y軸(Distance)は枝が結合する水準を示します。
- Cluster Assignments — Number of clusters を入力した場合に表示されます。各観測値の行番号とそのクラスター番号を示します。
- Download からPDFにエクスポートできます。
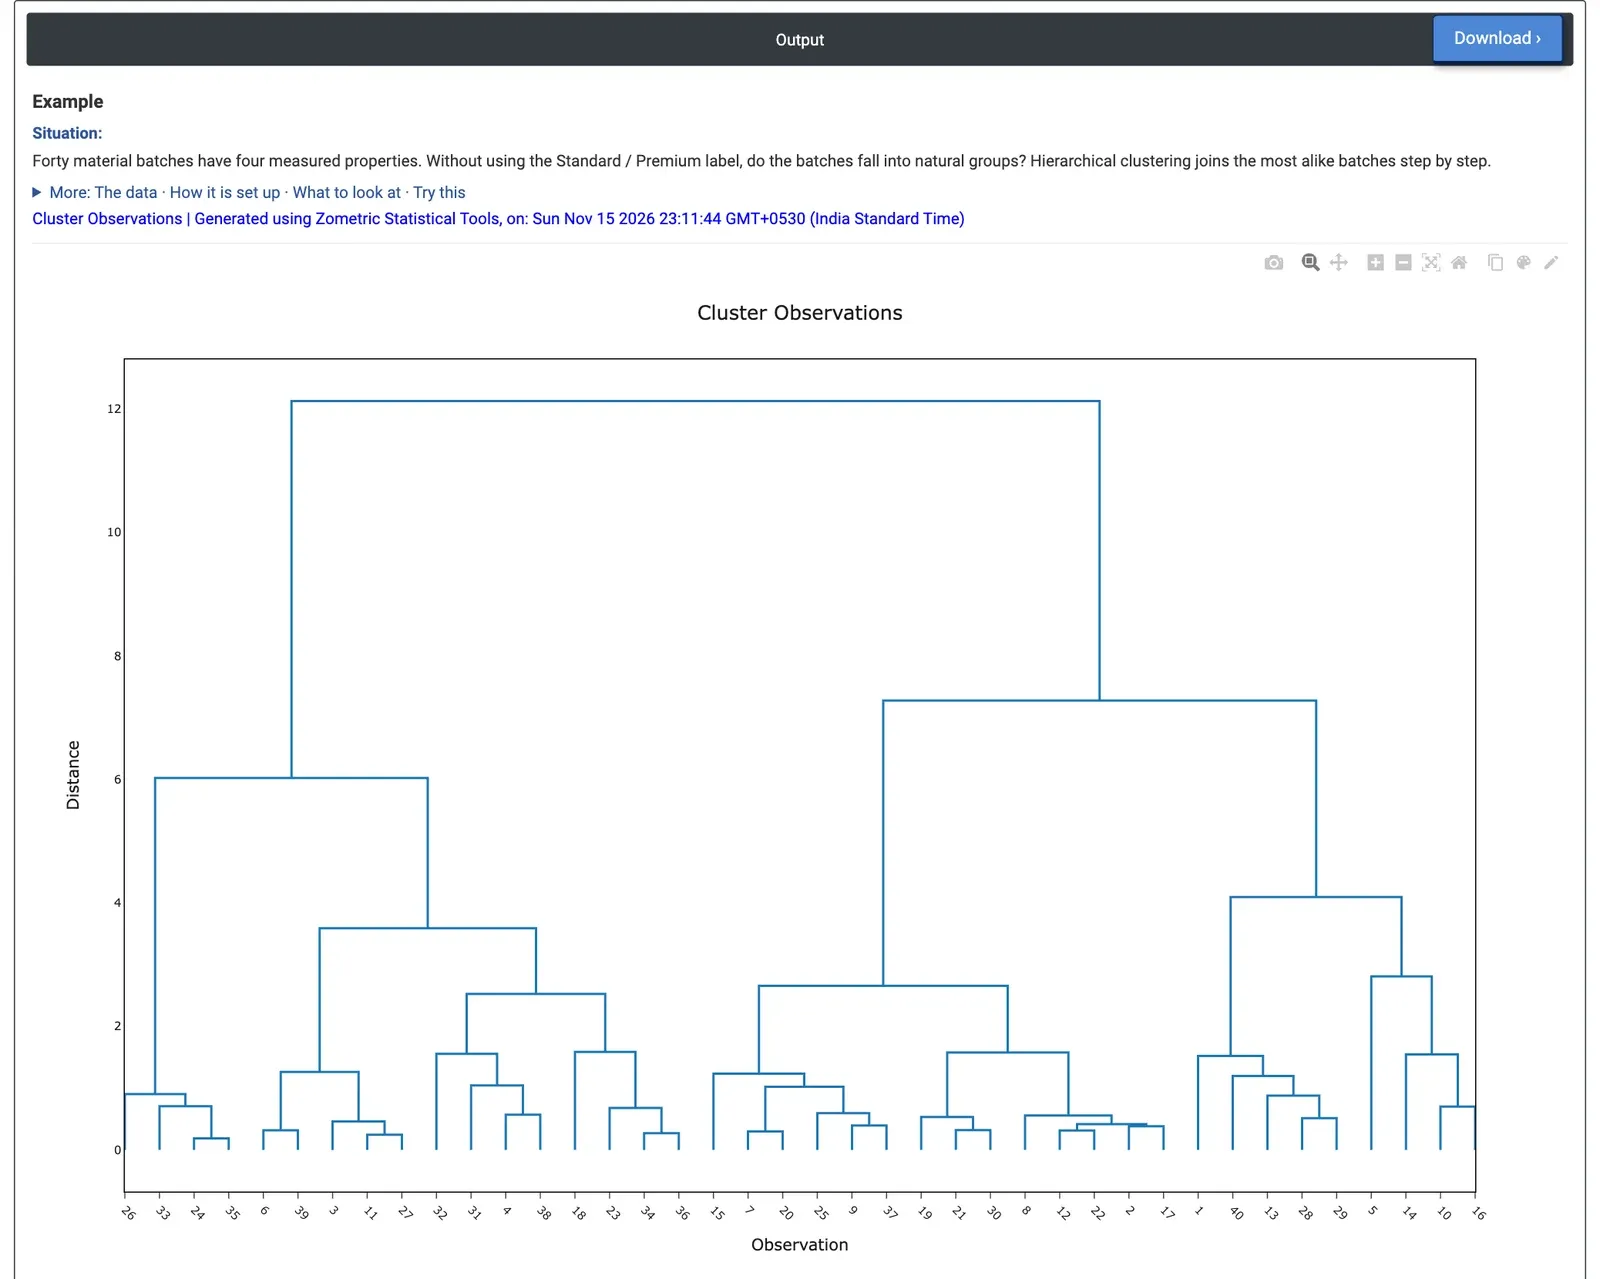
図2 — 40個の材料バッチのWard連結によるデンドログラム:2つの主要な枝が約12.1の距離で結合しています。
計算例
材料試験所に、密度(g/cc)、硬さ(HB)、引張強さ(MPa)、伸び(%)を測定した40個のバッチがあります。試験所は、StandardまたはPremiumのラベルを使わずに、バッチが自然なグループに分かれるかどうかを知りたいと考えています。4つの特性列を選択し、Linkage method = Ward、Distance measure = Euclidean を選び、Standardize variables のチェックは入れたままにして(そうしないと、g/ccの密度とMPaの強さは比較できません)、Number of clusters = 2 を入力します。
デンドログラムには、12.1の距離で結合する2つの主要な枝が示されます。これは次の結合(7.3と6.0)をはるかに上回るため、2グループへの切断が自然です。クラスター1は、より硬く強い17個のバッチ(平均231.6 HBと1,308 MPa、伸び19.8%)で、クラスター2は、より軟らかく延性の高い23個のバッチ(170.5 HB、1,103 MPa、伸び21.7%)です。バッチの種類と照らし合わせると、クラスター1にはPremiumが12個とStandardが5個、クラスター2にはStandardが15個とPremiumが8個含まれます。クラスターが種類に一致するのは、40個のバッチのうち27個にとどまります。
試験所にとっては、2つの種類の間で特性が大きく重なっており、かなりの割合のStandardのバッチがPremiumと同等の強さを持っています。連結法の選択は重要です。Average連結では、2クラスターへの切断で1つのバッチ(行5、80.1 HBと822.6 MPaで、他よりはるかに軟らかい)だけが分離され、残りの39個が1つにまとまります。これはグループではなく外れ値を見つけるのに役立つ方法です。Wardの樹形図を3クラスターで切断すると、9個のバッチからなる軟らかいグループ(138.2 HB、995.9 MPa)が分離されます。
よくある質問
観測値の階層的クラスター分析とは何ですか?
すべての観測値をそれぞれ1つのクラスターとして開始し、最も近い2つのクラスターを1つになるまで繰り返し併合します。結果はデンドログラムとして描画されるため、グループ数を事前に知らなくても、自然なグループがいくつあるか、どの観測値が同じグループに属するかがわかります。どのグループにも当てはまらない観測値を明らかにすることもできます。
デンドログラムはどのように読みますか?
観測値は樹形図の順にx軸に沿って並び、y軸は枝が結合する距離を示します。縦に長い枝は、よく分離したグループを示します。計算例では、2つの主要な枝が12.1の距離で結合し、これは次の結合(7.3と6.0)をはるかに上回っていたため、2グループへの切断が自然でした。
どの連結法を使用すべきですか?
ツールには、Single、Complete、Average、Centroid、Median、McQuitty、Wardがあります。Wardは、クラスター内平方和の増加が最小になるクラスターの組を併合し、CentroidやMedianと同様に、ユークリッド距離または平方ユークリッド距離が必要です。選択は重要で、例ではAverage連結が1つの外れたバッチを分離したのに対し、Wardは2つのグループを見つけました。
観測値をクラスター分析する前に、変数を標準化すべきですか?
Standardize variables は既定でチェックが入っており、まずすべての変数を平均0、標準偏差1にスケーリングするため、単位が大きい変数が結果を支配しません。例では、そうしないと、g/ccの密度とMPaの強さは比較できませんでした。欠損値または非数値がある行は除外され、観測値は3つ以上必要です。