
変数のクラスター分析(Cluster Variables)
Cluster Variablesは、3つ以上の数値変数に対して、相関、絶対相関、またはユークリッド距離と、7つの連結法のいずれかを用いて階層的クラスタリングを行います。ともに動く変数が先に結合され、デンドログラムで示されます。長い測定項目やアンケート項目のリストを絞り込む場合に使用します。完全な行が少なくとも3行必要です。クラスター数を入力すると、各変数にラベルが付きます。
最終レビュー
重要なポイント
Cluster Variablesは、似た情報をもつ変数(列)を、ともに増減するものから順に結合してグループ化します。多数の測定項目やアンケート項目を、クラスターごとに1つに絞り込めます。
目的
Cluster Variablesは、似た情報をもつ変数(列)をグループ化します。観測値全体を通じてともに増減する変数が先に結合され、結果はデンドログラムとして描かれます。長い測定項目やアンケート項目のリストを絞り込むために使用します。複数の変数が同じクラスターに入った場合は、それらすべてではなく、そのうちの1つ、または合成スコアを追跡すれば十分です。
主な機能
- 3つ以上の数値変数の階層的クラスタリング。
- 相関、絶対相関、またはユークリッド距離に基づく距離。
- 7つの連結法:Single、Complete、Average、Centroid、Median、McQuitty、Ward。
- 変数が結合される順序と水準を示すデンドログラム。
- クラスター数を指定した場合の、各変数へのクラスター割り当て(任意)。
統計手法
選択した変数のいずれかに欠損値または数値でない値がある行は除外されます。変数が少なくとも3つ、完全な行が少なくとも3行必要です。各変数は、各行の値を座標とする点として扱われ、すべての変数の組について、選択した尺度で距離を計算します。相関距離は 1 − r で、rは2つの変数間のPearson相関です。完全な正の相関では0、完全な負の相関では2になります。絶対相関距離は 1 − |r| で、強い負の関係も強い正の関係と同じだけ近いものとして扱います。ユークリッド距離は生の値に対する √Σ(xᵢ − yᵢ)² であり、各変数の単位に依存します。
クラスタリングは、各変数を単独のクラスターとして始め、最も近い2つのクラスターを繰り返し結合します。クラスター間の距離は連結法によって決まります。Singleは最も近い組、Completeは最も遠い組、Averageはすべての組の距離の平均、McQuittyは重み付き平均、CentroidとMedianはクラスターの中心間の距離、Wardはクラスター内平方和の増加が最も小さくなるものを用います。Ward、Centroid、Medianにはユークリッド距離が必要で、ツールはそれ以外の組合せを受け付けません。
相関距離を用いる場合、高さhでの結合は、2つの枝にある変数の平均相関がおよそ 1 − h であることを意味します。Number of clustersを入力すると、その数のクラスターが得られるように樹形図が切断され、各変数にそのクラスターのラベルが付きます。
入力項目とオプション
項目 | 説明 |
Variables | グループ化する3つ以上の数値列。Ctrlキーまたはcommandキーを押しながらクリックすると、複数を選択できます。 |
Linkage method | クラスター間の距離の測り方:Single、Complete、Average(既定)、Centroid、Median、McQuitty、Ward。 |
Distance measure | Correlation(既定)、Absolute Correlation、またはEuclidean。 |
Number of clusters | 任意で、2以上です。樹形図をこの数のクラスターに切断し、Cluster Assignmentsの表を追加します。デンドログラムのみを表示する場合は空欄のままにします。 |
Title | デンドログラムに表示するタイトル。既定値はCluster Variablesです。 |
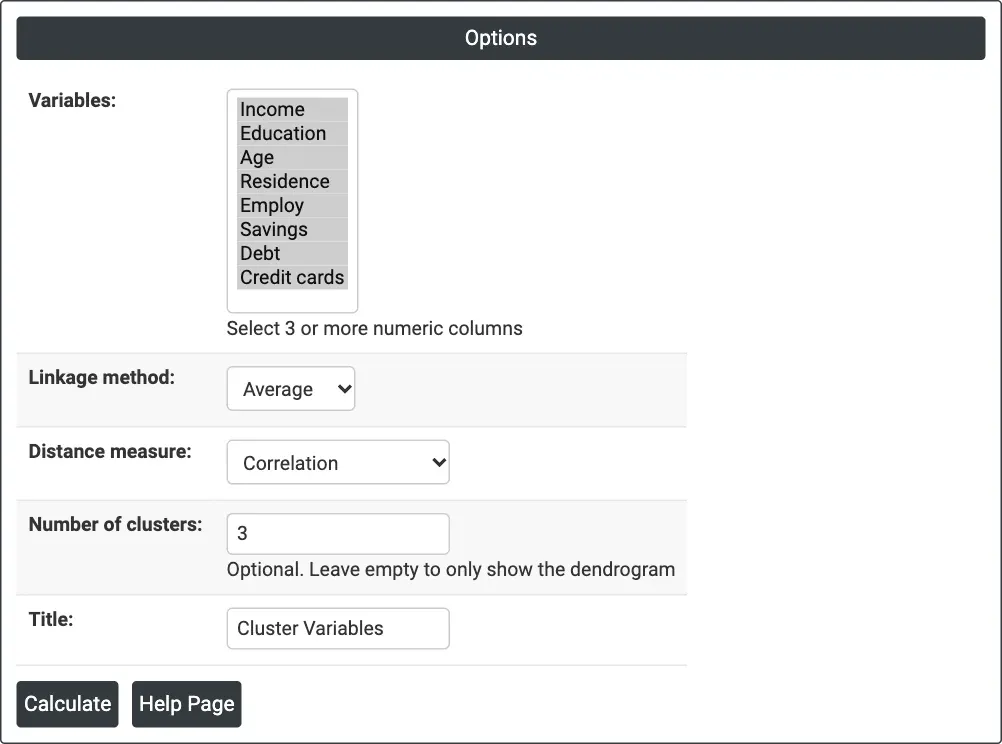
図1 — 例のオプション:融資申込者の8つの変数、Average連結法、Correlation距離、3クラスター。
出力の説明
- Dendrogram — 樹形図の順にx軸に並んだ変数。y軸(Distance)は枝が結合される水準を示します。結合が低いほど、変数は似ています。
- Cluster Assignments — Number of clustersを入力した場合に表示されます。各変数とそのクラスター番号。
- DownloadによるPDFエクスポート。
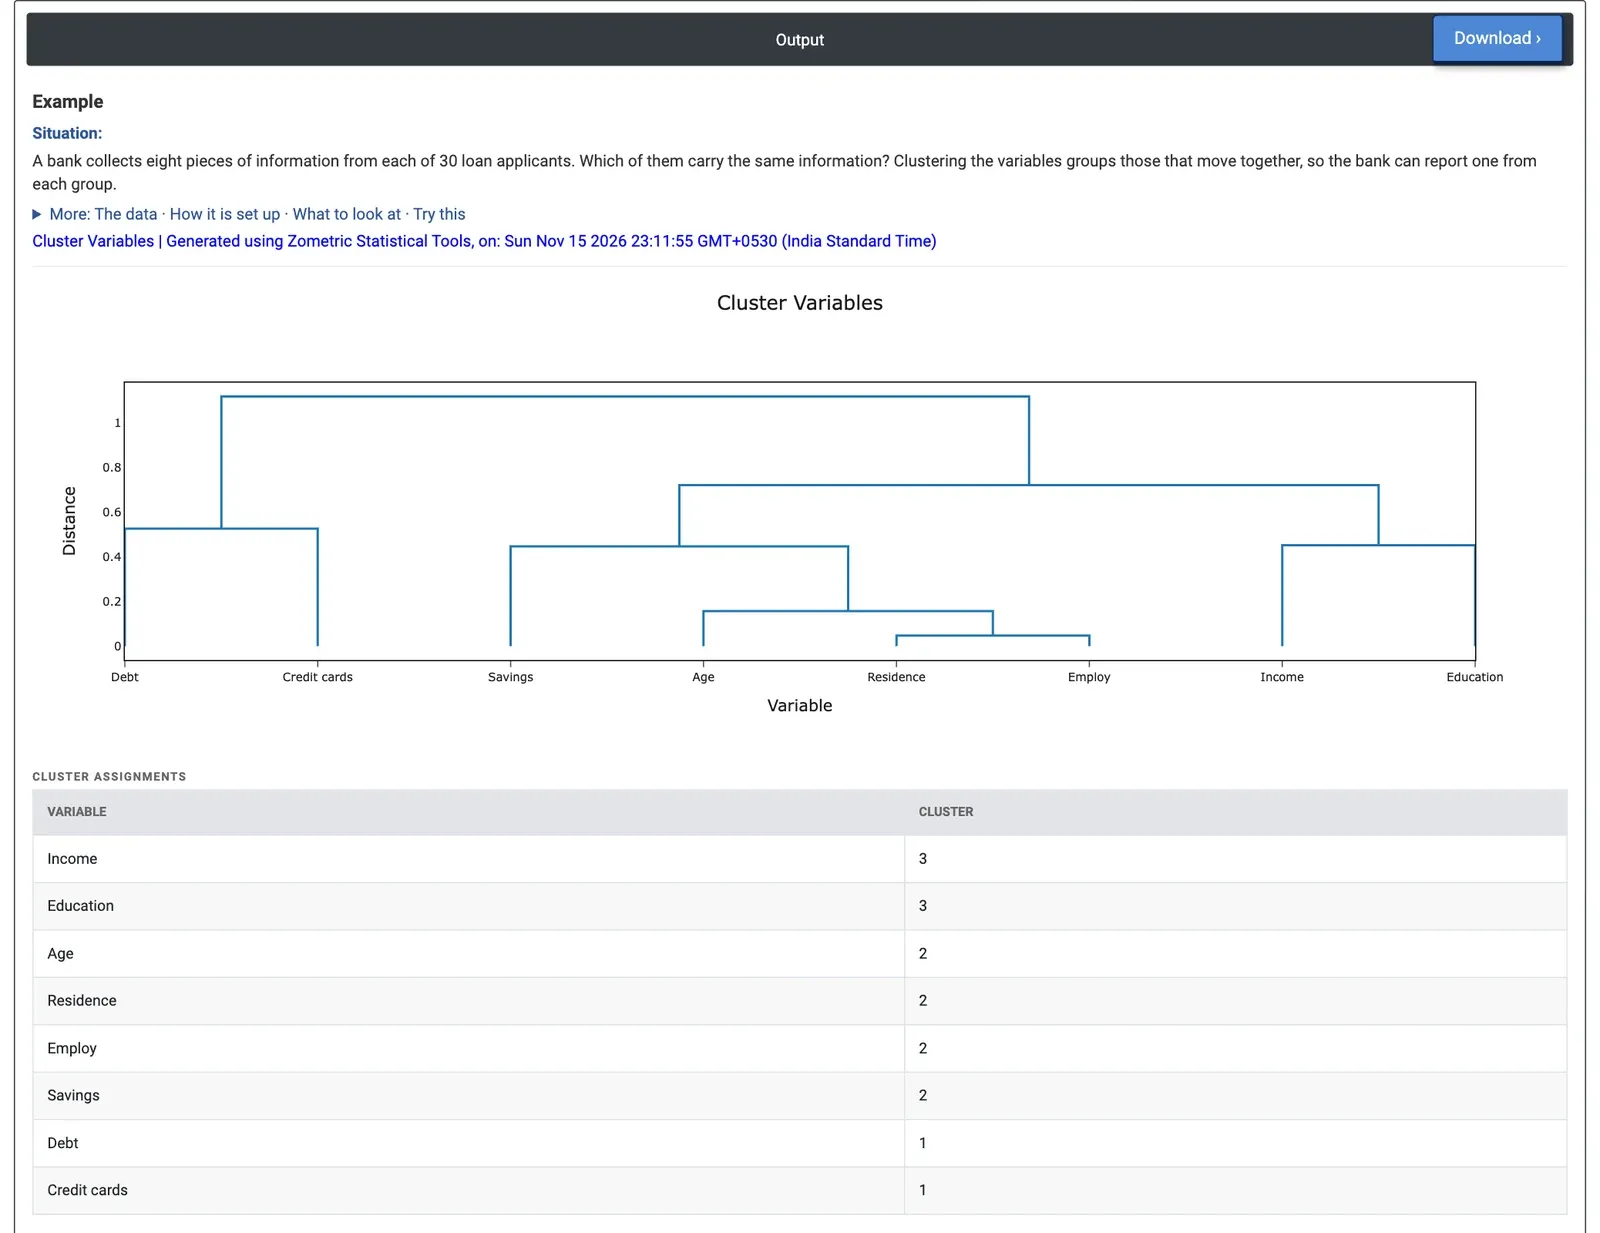
図2 — 融資申込者の8つの変数のデンドログラムとクラスター割り当て:安定性、収入、借入のクラスター。
計算例
ある銀行は、融資申込者ごとに8つの情報を記録しています。収入、教育年数、年齢、現住所での居住年数(Residence)、現在の勤務先での勤続年数(Employ)、貯蓄、債務、クレジットカードの枚数です。信用アナリストは、どの項目が同じ情報をもっているかを知り、各グループから1つずつ示す短い報告書を作成したいと考えています。30人の申込者を用い、アナリストは8つの列をすべて選択し、Linkage method = AverageとDistance measure = Correlationを維持して、Number of clusters = 3を入力します。
ResidenceとEmployが距離0.048(相関0.95)で最初に結合し、Ageが0.157でこれに加わります。Savingsは0.446でこのグループに加わります。IncomeとEducationは0.451で、DebtとCredit cardsは0.526で結合します。3クラスターでは、Cluster 2に申込者の安定性を表すAge、Residence、Employ、Savingsが入り、Cluster 3にIncomeとEducation、Cluster 1に借入を表すDebtとCredit cardsが入ります。最後の2回の結合は0.72と1.117で、他よりはるかに高く、3つのグループを裏付けています。
アナリストにとっては、各クラスターから1つの変数、たとえばEmploy、Income、Debtを選べば、8つの変数が示す内容の大部分をカバーできます。Number of clusters = 2にすると、安定性と収入のクラスターが統合され、DebtとCredit cardsだけが残ります。4クラスターにすると、DebtとCredit cardsが分離します。同じ8つの列にFactor Analysisを適用しても同様のグループ化が得られ、因子負荷量から各変数がそのグループにどの程度強く属するかがわかります。
よくある質問
Cluster Variablesは何に使用しますか?
長い測定項目やアンケート項目のリストを絞り込むために使用します。観測値全体を通じてともに増減する変数が先に結合され、結果はデンドログラムとして描かれます。複数の変数が同じクラスターに入った場合は、それらすべてではなく、そのうちの1つ、または合成スコアを追跡すれば十分です。
相関距離とは何ですか?
相関距離は 1 − r で、rは2つの変数間のPearson相関です。完全な正の相関では0、完全な負の相関では2になります。絶対相関距離 1 − |r| は、強い負の関係も強い正の関係と同じだけ近いものとして扱います。ユークリッド距離は生の値を用いるため、各変数の単位に依存します。
変数のデンドログラムはどのように読みますか?
変数は樹形図の順にx軸に並び、y軸は枝が結合される距離を示します。結合が低いほど、変数は似ています。相関距離を用いる場合、高さhでの結合は、2つの枝にある変数の平均相関がおよそ 1 − h であることを意味します。
変数のクラスター数はどのように選びますか?
他よりはるかに高い位置で起こる結合を探します。融資申込者の例では、最後の2回の結合が0.72と1.117で他よりはるかに高く、安定性、収入、借入の3つのクラスターを裏付けました。各クラスターから1つの変数、たとえばEmploy、Income、Debtを選べば、8つの変数が示す内容の大部分をカバーできます。