
単純コレスポンデンス分析(Simple Correspondence Analysis)
単純コレスポンデンス分析は、生のカテゴリーデータまたは分割表を取り込み、行と列のカテゴリーをマップ上にプロットします。出力は、連関のカイ2乗検定、各成分がどれだけ説明するかを示すイナーシャの表、行と列の寄与の表です。各変数には少なくとも2つのカテゴリーが必要です。機械別の不良の種類のような大きなクロス表のパターンを読み取るために使用します。
最終レビュー
重要なポイント
単純コレスポンデンス分析は、度数の二元表を、偶然から期待されるより頻繁に一緒に現れる行と列のカテゴリーが互いに近くに位置するマップに変換します。
目的
単純コレスポンデンス分析は、度数の二元表をマップに変換します。行のカテゴリーと列のカテゴリーが点として描かれ、偶然から期待されるより頻繁に一緒に現れるカテゴリーは互いに近くに位置します。大きなクロス表のパターンを一目で把握するために使用します。例えば、どの不良の種類がどの機械と結びつくか、どの苦情のカテゴリーがどの製品と結びつくか、顧客がどの属性をどのブランドと結びつけるか、といった場合です。
主な機能
- 生データ(1品目につき1行、2つのカテゴリー列)、または度数としてすでに集計された分割表を受け付けます。
- 行の変数と列の変数の間の連関に関するカイ2乗検定。
- 各成分(マップの軸)が連関をどれだけ説明するかを示すイナーシャの表。
- 行と列の寄与の表:選択した成分数についての、質(quality)、質量(mass)、イナーシャ、座標、2乗相関、寄与。
- 5種類のプロット:行と列の対称プロット、行のみ、列のみ、および行または列の非対称プロット。
統計手法
入力にCategorical variablesを選ぶと、ツールは行の変数を列の変数に対してクロス集計し、欠測値のある行は無視します。Columns of a contingency tableを選ぶと、選択した各列が1つの列カテゴリーの度数を保持し、各行が行カテゴリーになります。合計がゼロの行や列は除外されます。各変数には少なくとも2つのカテゴリーが必要です。
度数を総計 n で割って比率 P を求め、行の質量 r(P の行合計)と列の質量 c(列合計)を求めます。標準化残差の行列 S = Dr^−½ (P − r cᵀ) Dc^−½ を特異値分解によって分解します。各特異値 d は、イナーシャ d² を持つ1つの成分を与え、成分の数は(行数 − 1)と(列数 − 1)のうち小さい方です。総イナーシャはカイ2乗統計量を n で割った値に等しく、ツールは、カイ2乗 = n × 総イナーシャを自由度(行数 − 1)(列数 − 1)およびそのp値とともに報告します。p値が小さい場合、行と列は連関しているため、マップは実際のパターンを示しています。
行の主座標は Dr^−½ U D、列の主座標は Dc^−½ V D です。寄与の表では、Mass はそのカテゴリーが総度数に占める割合、Inert は総イナーシャに占める割合、Corr は余弦の2乗(1つの成分がその点をどれだけよく表すか)、Qual は報告された成分にわたる Corr の合計、Contr はその点が占める成分のイナーシャの割合です。対称プロットでは、両方の点の集合に主座標を使用します。行の非対称プロットでは、行を主座標で、列を標準座標(主座標を d で割った値)で示し、列の非対称プロットではその逆になります。
入力項目とオプション
項目 | 説明 |
Input data | Categorical variables(既定):1品目につき1行。Columns of a contingency table:すでに集計された度数。以下の項目は、この選択に応じて変わります。 |
Row variable / Column variable | Categorical variablesを入力とする場合:クロス集計する2つのカテゴリー列。両方とも必須で、異なる列である必要があります。 |
Contingency table columns | 分割表を入力とする場合:2列以上で、各列が1つの列カテゴリーの度数を保持し、行カテゴリーごとに1行とします。 |
Row names | 分割表を入力とする場合の任意の項目:表の各行に名前を付ける列。空欄の場合は、Row 1、Row 2などが使われます。 |
Column names | 分割表を入力とする場合の任意の項目:選択した表の列ごとに1つの名前を、同じ順序で並べた列。空欄の場合は、列の見出しが使われます。 |
Number of components | 寄与の表でCoord、Corr、Contrを報告する成分の数。既定は2。1〜20で、利用可能な成分数が上限です。 |
Symmetric plot showing rows and columns | 既定ではチェックあり。行と列を1つのマップに、いずれも主座標で表示します。 |
Symmetric plot showing rows only / columns only | 既定ではチェックなし。同じマップで、一方の点の集合のみを表示します。 |
Asymmetric row plot / Asymmetric column plot | 既定ではチェックなし。行を主座標、列を標準座標で表示するか、その逆で表示します。 |
Title | プロットに表示されるタイトル。既定値はSimple Correspondence Analysisです。 |
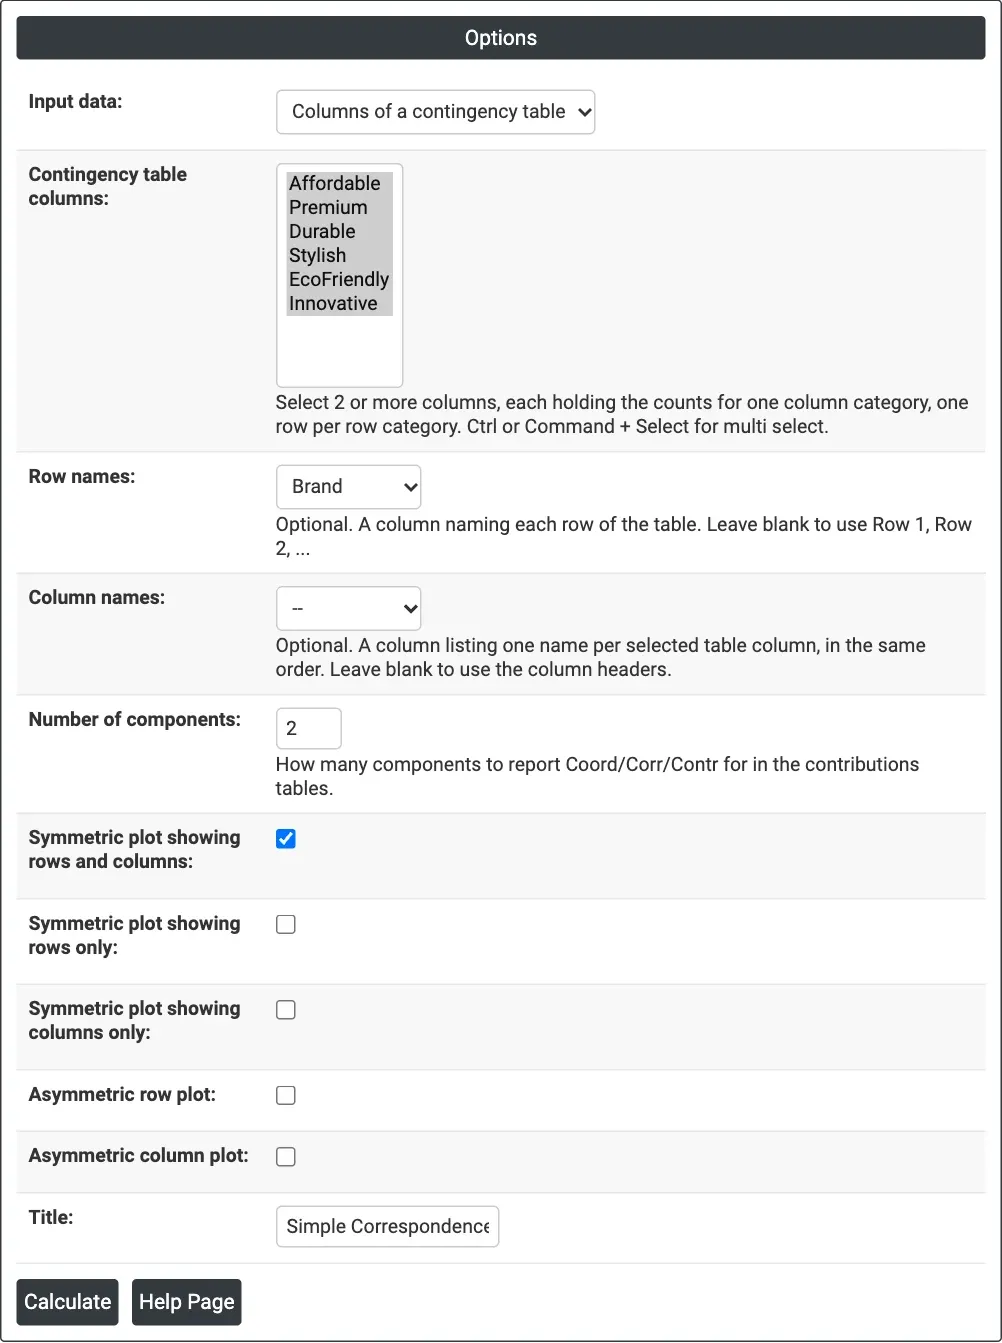
図1 — ブランドイメージの例のオプション:6つの属性列を指定した分割表入力で、Brandを行名としたもの。
出力の説明
- Symmetric Plot、Row Plot、Column Plot、Asymmetric Row Plot、Asymmetric Column Plot — チェックを入れたプロットで、軸はComponent 1とComponent 2、各軸のタイトルにそれぞれが説明するイナーシャの割合を表示します。
- Contingency Table — 分割表入力の場合に表示されます。分析に使用した表です。
- Chi-square、DF、P-value — 行と列の連関の検定です。
- Analysis of Contingency Table — 各軸のイナーシャ、比率、累積比率をテキストヒストグラムとともに示し、総イナーシャも示します。
- Row ContributionsとColumn Contributions — ID、Name、Qual、Mass、Inert、および報告された各成分のCoord、Corr、Contr。
- DownloadによるPDF出力。
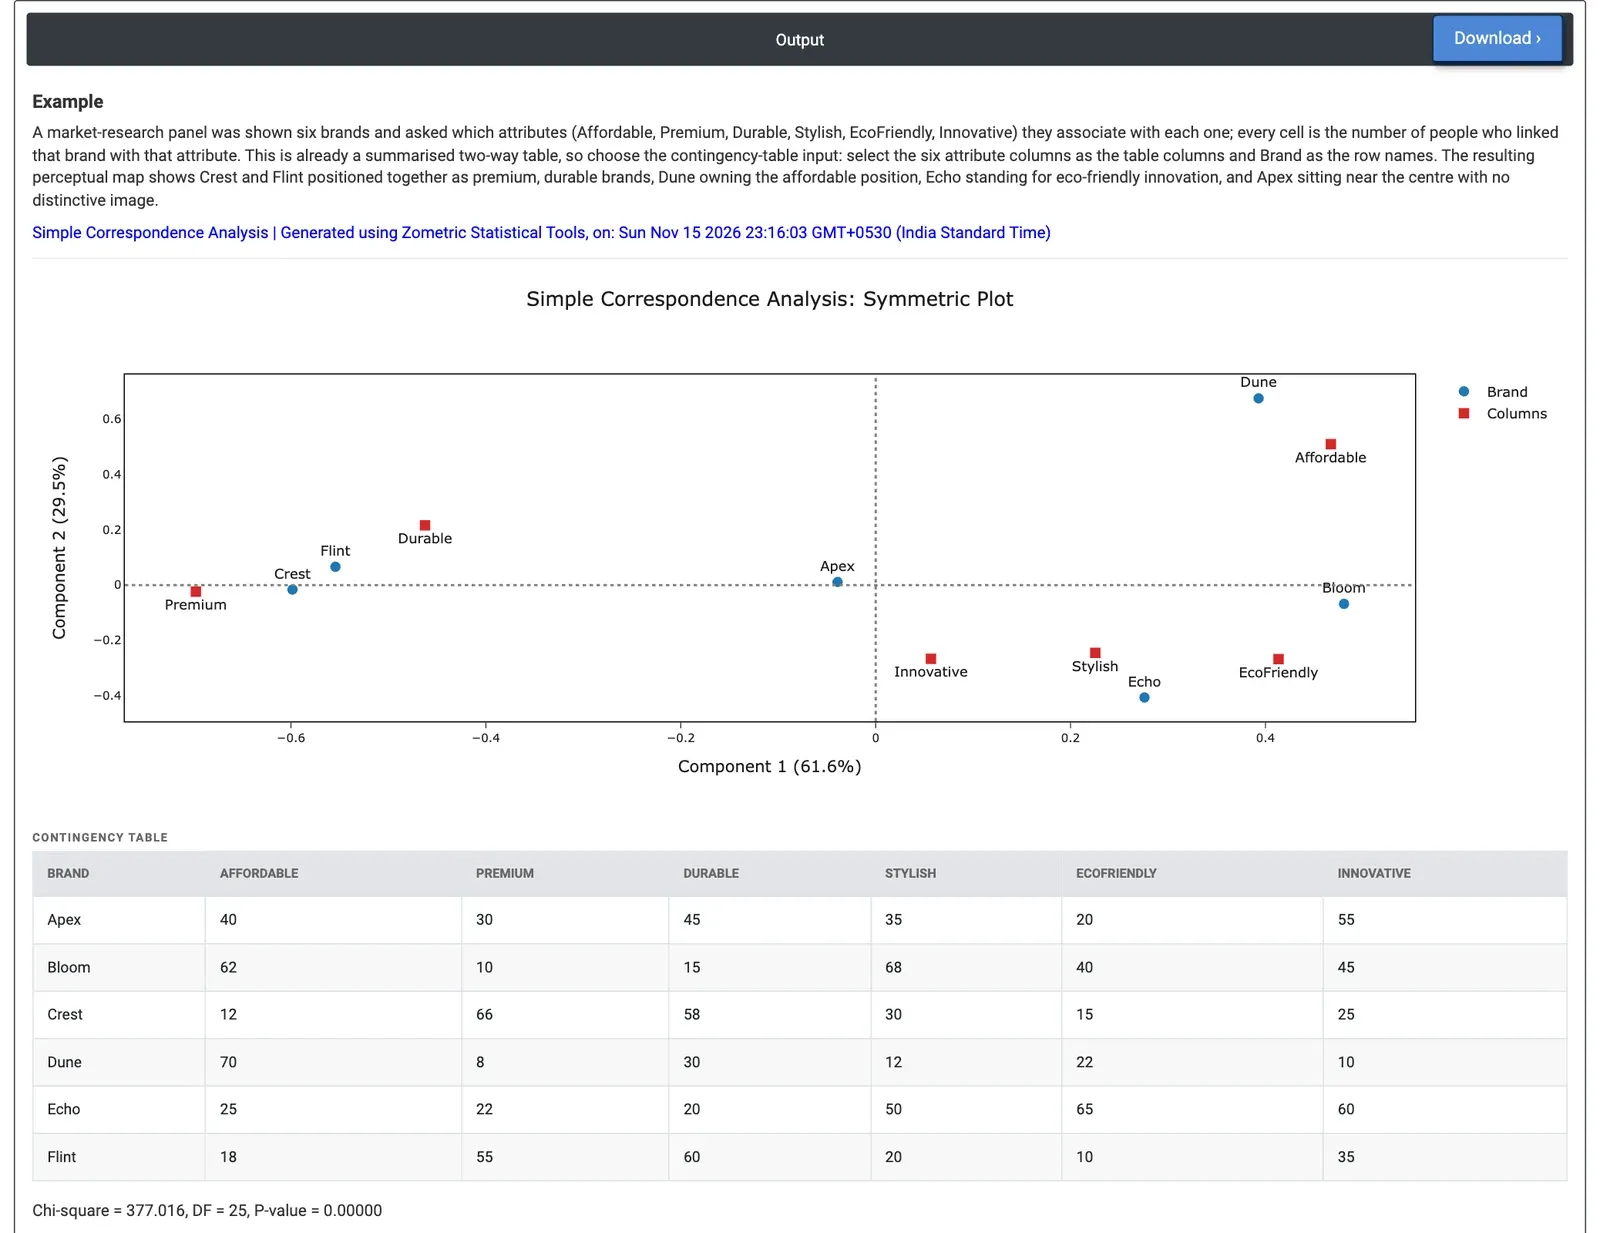
図2 — 6つのブランドと6つの属性の対称プロット:CrestとFlintはPremiumとDurableの近く、DuneはAffordableの近く、EchoはEcoFriendlyの近くに位置し、カイ2乗は377.0、自由度25。
計算例
市場調査のパネルに、6つのブランド(Apex、Bloom、Crest、Dune、Echo、Flint)を提示し、6つの属性(Affordable、Premium、Durable、Stylish、EcoFriendly、Innovative)のうち、それぞれのブランドと結びつけるものを尋ねました。各セルには、そのブランドをその属性と結びつけた人数が入っています。マーケティングチームは各ブランドの位置を把握したいと考えています。データはすでに度数の表なので、Input data = Columns of a contingency tableに設定し、6つの属性列をContingency table columnsとして選択し、Row namesとしてBrandを選択して、行と列の対称プロットはそのままにします。
カイ2乗は377.016、自由度25(p < 0.00001)であり、ブランドイメージがブランド間で明確に異なることがわかります。Component 1がイナーシャの61.6%、Component 2が29.5%を占めるため、2次元のマップがパターンの91.1%を示しています。Component 1は、左側のPremium(−0.698)とDurable(−0.462)から、右側のAffordable(0.467)とEcoFriendly(0.414)に及びます。Crest(−0.599)とFlint(−0.554)は、プレミアムで耐久性のある側に位置し、この軸ではほぼ完全に表されています(Corrは0.94と0.98)。DuneはComponent 2の高い位置(0.674)でAffordableの隣にあり、その成分のイナーシャの62.2%を占めます。Echo(0.276、−0.406)はEcoFriendly、Stylish、Innovativeの近くに位置し、Bloom(0.481)はStylishとAffordableの方向に寄っています。
Apexは中心付近(−0.039、0.011)にあり、質は0.038にすぎません。そのプロファイルは全ブランドの平均に近く、際立ったイメージがないことを意味します。チームにとっては、CrestとFlintが同じプレミアムで耐久性のあるポジションを争い、Duneが手頃な価格のポジションを占め、Apexがより明確なメッセージを必要とするブランドである、ということになります。
よくある質問
コレスポンデンス分析は何に使用しますか?
大きなクロス表のパターンを一目で把握するために使用します。例えば、どの不良の種類がどの機械と結びつくか、どの苦情のカテゴリーがどの製品と結びつくか、顧客がどの属性をどのブランドと結びつけるか、といった場合です。行と列のカテゴリーが点として描かれ、偶然より頻繁に一緒に現れるカテゴリーは近くに位置します。
コレスポンデンス分析のイナーシャとは何ですか?
イナーシャは、表の連関を測る尺度です。各成分(マップの軸)のイナーシャは、その特異値の2乗に等しく、総イナーシャはカイ2乗統計量を総計 n で割った値に等しくなります。イナーシャの表は各成分が説明する割合を示し、ブランドの例では、最初の2つの成分がパターンの91.1%を示しました。
質、質量、寄与はどのように解釈しますか?
Mass はカテゴリーが総度数に占める割合、Inert は総イナーシャに占める割合、Corr は1つの成分がその点をどれだけよく表すか、Qual は報告された成分にわたる Corr の合計、Contr はその点が占める成分のイナーシャの割合です。例のApexのように、中心付近にあって質が低い点は、そのプロファイルが平均に近いことを示します。
対称プロットと非対称プロットの違いは何ですか?
対称プロットは行と列をともに主座標で一緒に表示し、既定でチェックが入っています。行の非対称プロットは、行を主座標、列を標準座標(主座標を特異値で割った値)で表示し、列の非対称プロットはその逆です。行のみ、または列のみのプロットも利用できます。