
クロス集計とカイ二乗(Cross Tabulation and Chi-Square)
1レコード1行のデータから、行、列、全体のパーセントを任意で付けた度数の二元表を作成します。PearsonおよびLikelihood-ratioのカイ二乗で関連性を検定し、期待度数、残差、セルの寄与を確認して、Cramér's V-squareで関連の強さを測定します。2x2表にはFisherの正確確率検定が使えます。期待度数が5未満になると注記が表示されます。層変数を指定すると、水準ごとに1つの表が作成されます。
最終レビュー
重要なポイント
クロス集計とカイ二乗は、生のレコードで2つのカテゴリ変数の各組み合わせが現れる回数を数え、2つの変数に関連があるかを検定します。3つ目の変数で層に分けることもできます。
目的
クロス集計とカイ二乗は、部門と満足度、欠点の種類とライン、供給者と合格/不合格など、生のレコードで2つのカテゴリ変数の各組み合わせが現れる回数を数え、2つの変数に関連があるかを検定します。3つ目の変数で解析を層に分けることもできます。たとえば、シフトごとに1つの表を作成できます。
主な機能
- 1レコード1行のデータから作成する、行と列の合計付きの度数の二元表。
- 層別:3つ目の変数の値ごとに、個別の表と検定。
- 行、列、全体のパーセント。
- Pearsonのカイ二乗検定(デフォルトでオン)とLikelihood-ratioのカイ二乗。
- 期待度数、生の残差、標準化残差、調整済み残差、および各セルのカイ二乗への寄与。
- Cramér's V-squareと、2×2表向けのFisherの正確確率検定。
- 期待度数が5未満のセルがある場合の警告。
統計手法
行、列、または層の変数に欠測値があるレコードは除外されます。観測度数の表Oについて、行合計をRᵢ、列合計をCⱼ、総計をNとすると、独立の場合の期待度数は Eᵢⱼ = Rᵢ·Cⱼ / N です。Pearson統計量 χ² = Σ (O − E)² / E(連続性補正なし。2×2表でも同様)とLikelihood-ratio統計量 G² = 2 Σ O·ln(O / E) を、自由度(r − 1)(c − 1)のカイ二乗分布と比較します。p値が小さい場合は、行によって列の構成が異なることを意味します。
どのセルが結果を左右しているかを見るには、次を使用します。セルの寄与は (O − E)² / E、生の残差は O − E、標準化残差は (O − E) / √E です。調整済み残差 (O − E) / √(E(1 − Rᵢ/N)(1 − Cⱼ/N)) はほぼ標準正規分布に従うため、約±2を超える値は、独立から明確に外れているセルを示します。Cramér's V-square = χ² / (N·(min(r, c) − 1)) は、関連の強さを0(なし)から1(完全)で測定します。サンプルが大きいと、弱い関連でも有意になることがあります。
カイ二乗近似には、ある程度大きな期待度数が必要です。このページは、期待度数が5未満のセルの数を報告します。2×2表では、Fisherの正確確率検定により、この近似に依存しない正確なp値が得られます。カテゴリは並べ替えられた順に表示されます。
入力項目とオプション
項目 | 説明 |
Rows | 表の行にするカテゴリ列です。必須。 |
Columns | 列にするカテゴリ列です。必須で、Rowsとは異なる列にする必要があります。 |
For layers | 任意。この変数の値ごとに、個別の表と検定を作成します。 |
Row percents / Column percents / Total percents | パーセントの表を追加します。デフォルトではオフです。 |
Chi-Square test | Pearsonのカイ二乗検定です。デフォルトでオンです。 |
Likelihood ratio chi-square | Likelihood-ratio検定を追加します。 |
Expected cell counts / Raw residuals / Standardized residuals / Adjusted residuals / Each cell's contribution to chi-square | これらの表を追加します。デフォルトではオフです。 |
Cramer's V-square statistic | 関連の強さです。 |
Fisher's exact test for 2x2 tables | 正確なp値です。2×2表の場合にのみ報告されます。 |
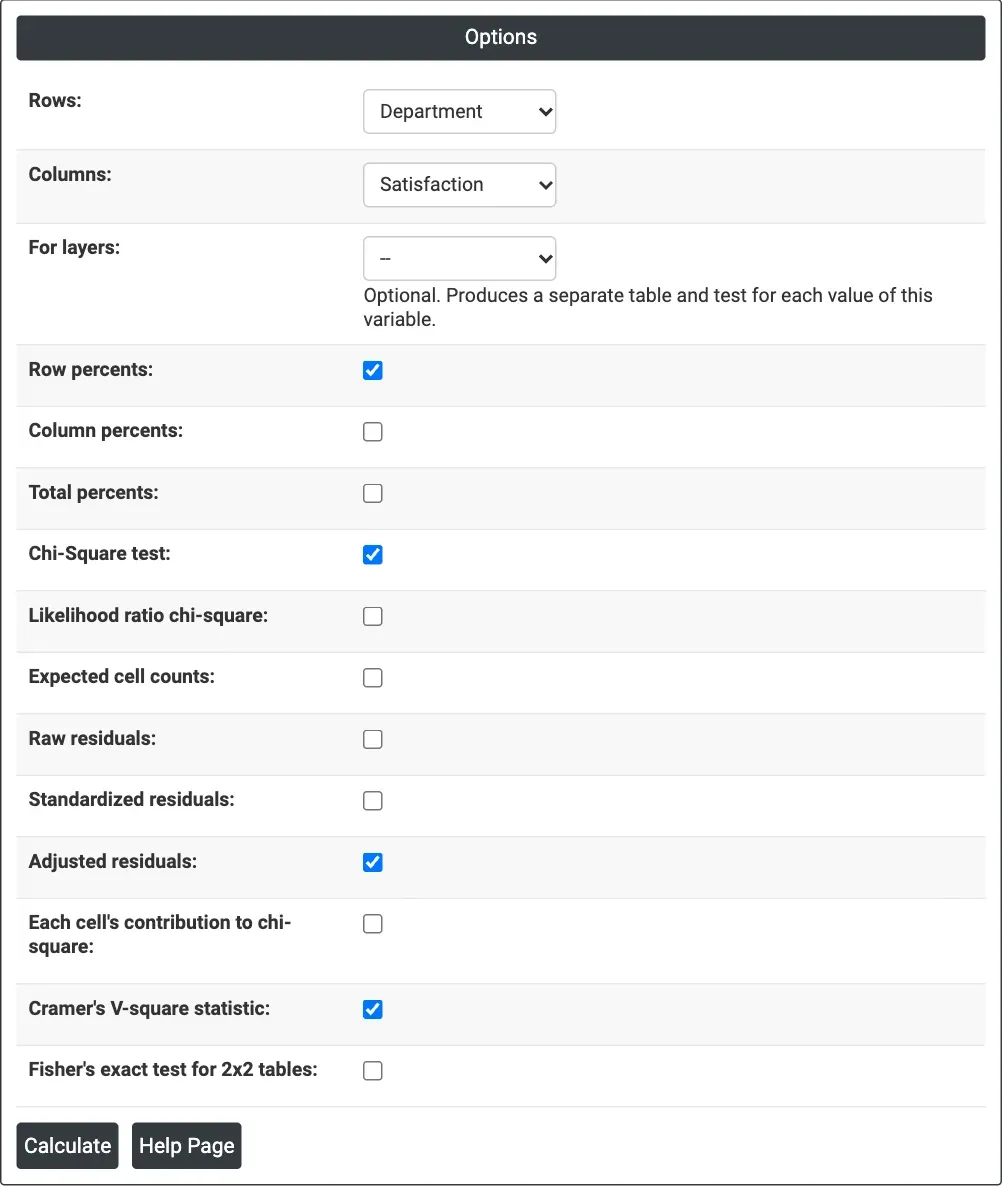
図1 — 従業員調査の例のオプション:行にDepartment、列にSatisfactionを指定し、row percents、chi-square test、adjusted residuals、Cramer's V-squareにチェックを入れた状態。
出力の説明
- Counts — Allの合計付きの度数の表(層ごとに1つ)。
- Row percents、Column percents、Total percents、Expected counts、Raw、Standardized、Adjusted residuals、Contribution tables — チェックを入れた場合。
- Chi-Square Test — PearsonおよびLikelihood-ratio検定のChi-Square、DF、P-Value。期待度数が5未満の場合は注記が付きます。
- Other Statistics — Cramer's V-squareとFisherの正確確率検定のP-Value。
- Downloadによる、PDFエクスポート。
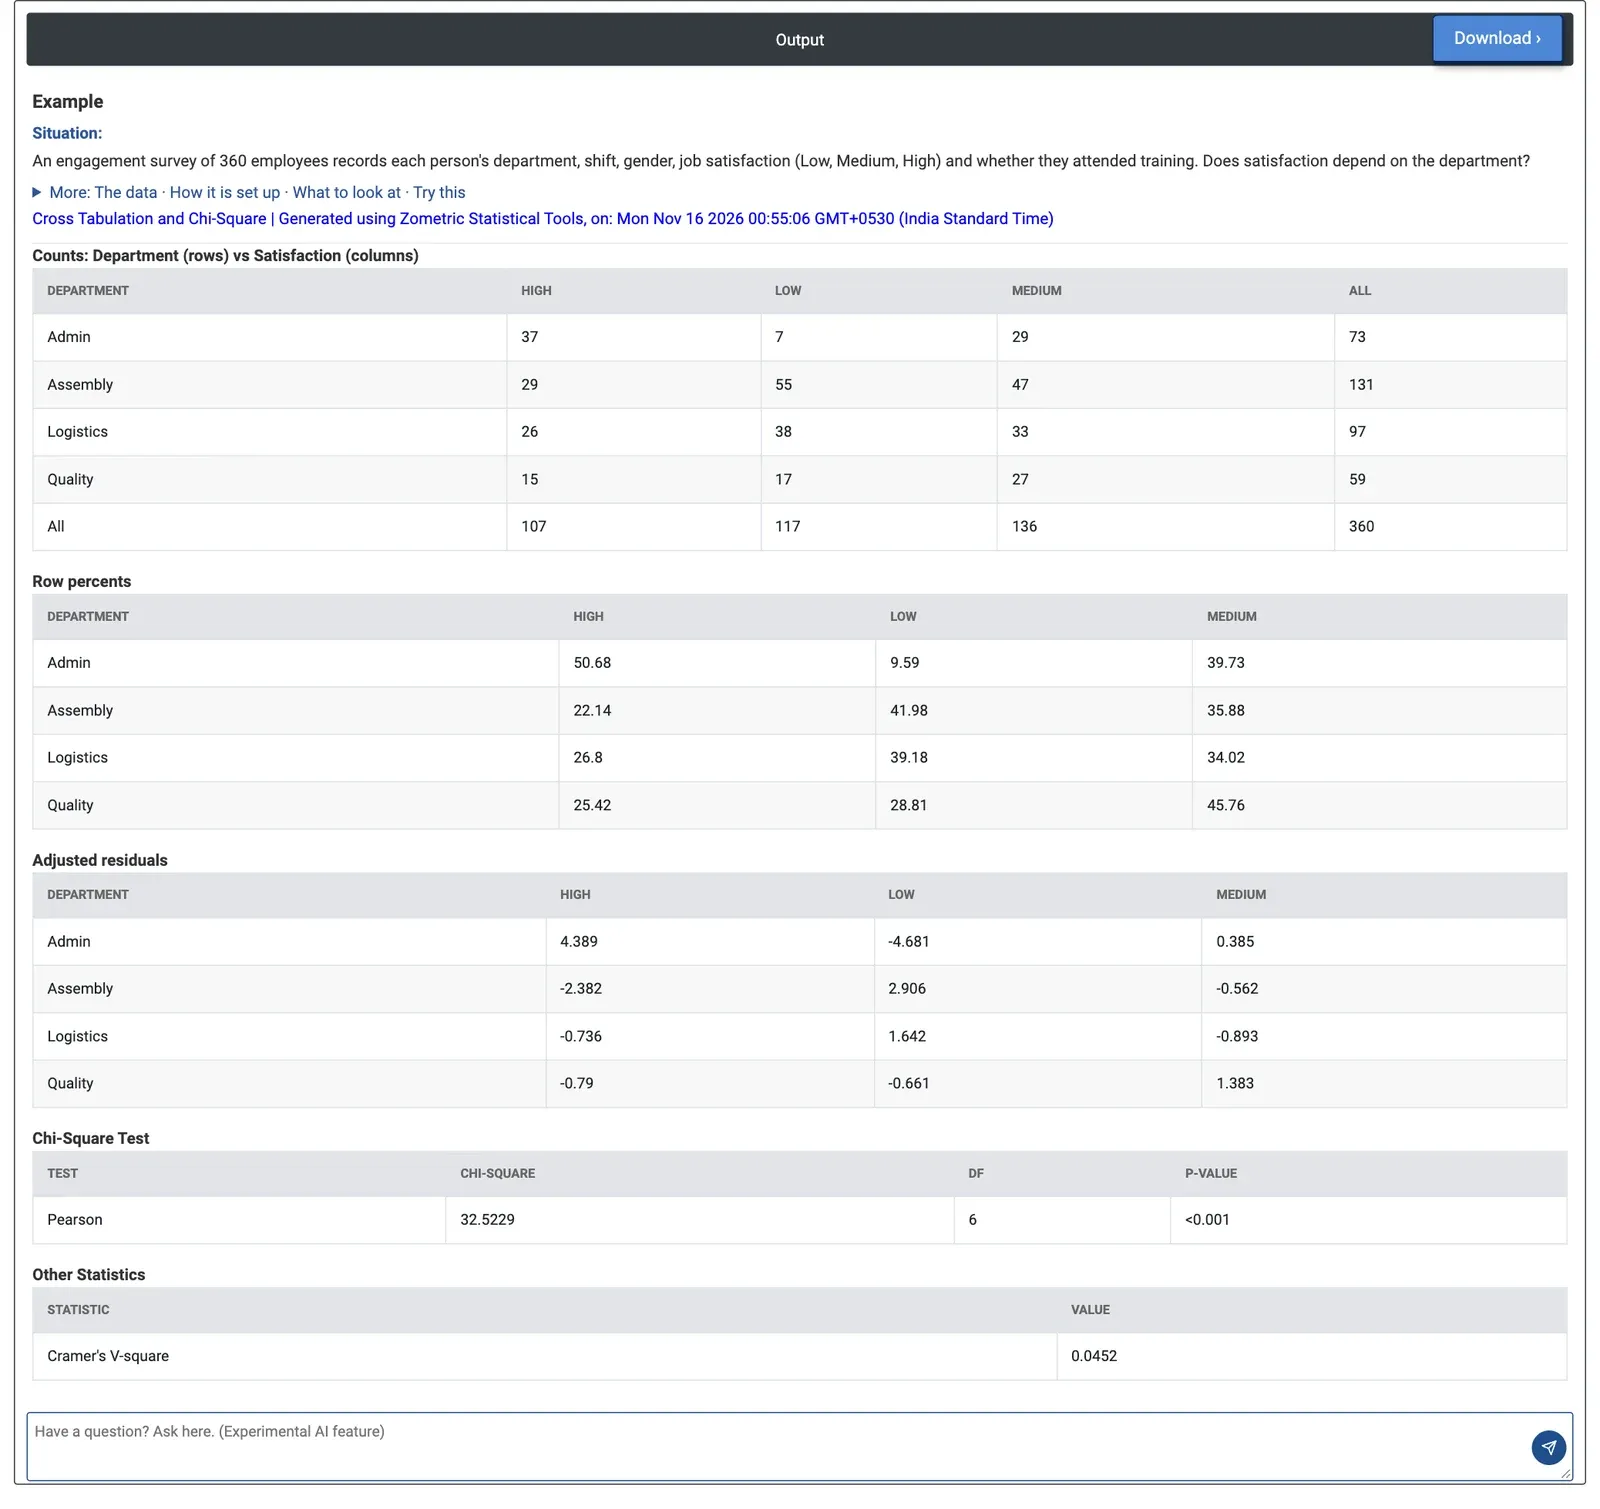
図2 — 部門別の満足度:Pearsonのカイ二乗は32.52、自由度6、p < 0.001。AdminはHighの評価が最も多く、AssemblyはLowが最も多くなっています。
計算例
360人の従業員を対象とした従業員エンゲージメント調査では、各人の部門、シフト、性別、満足度(Low、Medium、High)、研修を受講したかどうかを記録しています。人事部門は、満足度が部門によって異なるかを知りたいと考えています。行にDepartment、列にSatisfactionを選択し、row percents、adjusted residuals、Cramer's V-squareにチェックを入れます。
満足度は部門によって異なります。Pearsonのカイ二乗は32.52、自由度6、p < 0.001です。Adminの満足度が最も高く、Highが50.68%、Lowは9.59%にとどまります。Assemblyは最も低く、Lowが41.98%、Highが22.14%です。±2を超える調整済み残差が、結果の要因となるセルを示しています。Adminは High(+4.389)とLow(−4.681)、AssemblyはLow(+2.906)とHigh(−2.382)です。Cramér's V-squareは0.0452で、実在するもののわずかな関連です。
For layersをShiftに設定すると、シフトごとに1つの表が作成されます。夜勤では、LogisticsのHighはわずか4.88%、Lowは53.66%(Highの調整済み残差は−2.475)で、日勤のHigh 42.86%と比べて低く、夜勤のLogisticsチームから着手するのがよいとわかります。夜勤の表には、1つのセルの期待度数が5未満であるという注記が付きます。性別と研修受講の関係は2×2表です。Fisherの正確確率検定ではp = 0.5888となり、研修の受講が性別によって異なる兆候はありません。
よくある質問
クロス集計とカイ二乗検定の違いは何ですか?
クロス集計は、2つのカテゴリ変数の各組み合わせが現れる回数を数え、行と列の合計および任意のパーセントを付けた二元表を作成します。その後、カイ二乗検定で2つの変数に関連があるかを調べます。p値が小さい場合は、行によって列の構成が異なることを意味します。3つ目の変数で解析を層に分けることもできます。
Cramér's V-squareは何を測定しますか?
Cramér's V-square = χ² / (N·(min(r, c) − 1)) は、関連の強さを、なしの0から完全の1までで測定します。サンプルが大きいと、弱い関連でも統計的に有意になることがあります。従業員調査の例では、pが0.001未満であっても、V-squareは0.0452で、実在するもののわずかな関連でした。
Fisherの正確確率検定はどのような場合に使用しますか?
カイ二乗近似にはある程度大きな期待度数が必要で、出力には期待度数が5未満のセルの数が報告されます。2x2表では、Fisherの正確確率検定により、この近似に依存しない正確なp値が得られます。これは2x2表の場合にのみ報告されます。
どのセルが関連の要因になっているかは、どのように調べますか?
各セルのカイ二乗への寄与 (O − E)² / E と、残差を確認します。調整済み残差はほぼ標準正規分布に従うため、約±2を超える値は、独立から明確に外れているセルを示します。例では、Admin High(+4.389)とAssembly Low(+2.906)が、結果の要因となったセルに含まれていました。