
時系列分解(Decomposition)
古典的な分解は、中心化移動平均で系列を平滑化し、周期ごとの中央値から季節指数を求め、季節調整後のデータに最小二乗法のトレンド直線を当てはめて、トレンドに指数を掛けた値(または足した値)で予測します。乗法モデルまたは加法モデルを選択します。少なくとも2つの完全な季節が必要で、欠損は許されません。出力には、トレンドの式、季節指数、MAPE、MAD、MSD、予測値が含まれます。
最終レビュー
重要なポイント
時系列分解は、季節性のある時系列を、直線のトレンド、繰り返される季節パターン、そして残りの部分に分け、トレンドを延長して季節パターンを繰り返すことで予測します。
目的
Decompositionは、季節性のある時系列を、直線のトレンド、繰り返される季節パターン、そして残りの部分に分けます。「需要は毎月どれだけ増えているか」「毎年、12月はトレンドよりどれだけ上または下か」といった問いに答え、トレンドを延長して季節パターンを繰り返すことで予測します。安定した季節を持つ月次、四半期、またはシフトパターンのデータに使用し、例えば繁忙月に向けた生産能力や在庫の計画に役立ちます。
主な機能
- 乗法モデル(各季節がトレンドに対して何パーセント上または下か)、または加法モデル(各季節がトレンドに対して一定量だけ上または下か)。
- 季節の各周期の季節指数と、あてはめたトレンドの式。
- 任意の数の周期の予測。系列の末尾から、または既知のデータに対して手法を検証するため、それより前の行から予測できます。
- 予測精度の指標であるMAPE、MAD、MSD。
- 分解プロット(観測値、トレンド、季節、残差)、Component AnalysisとSeasonal Analysisのグラフ、および任意の4つ1組の残差プロット。
- 各行のトレンド、季節、トレンド除去、季節調整、あてはめ、誤差の値を含む完全な結果の表。
統計的手法
このツールは古典的な分解を使用します。まず、長さL(季節の長さ)の中心化移動平均でデータを平滑化します。Lが偶数の場合は2×Lの平均を使用するため、各値が時点の上に位置します。生の季節値は、データをこの平均で割った値(乗法)、またはこの平均を引いた値(加法)です。季節の各周期について、その生の値の中央値を求め、その中央値を平均が1(乗法)または0(加法)になるようにスケール調整します。これが季節指数です。
次に、データを季節調整し(指数で割る、または指数を引く)、調整後のデータに最小二乗法の直線 Yt = b₀ + b₁·tを当てはめます。各行のあてはめ値は、トレンド × 指数(乗法)またはトレンド + 指数(加法)で、誤差はどちらのモデルでもデータ − あてはめ値です。予測値はトレンド直線を延長し、対応する周期の指数を適用して求めます。予測区間は示されません。予測の起点を指定した場合、指数とトレンドはその行までのデータから再計算されます。精度:MAPE = |誤差 / データ| × 100の平均、MAD = |誤差|の平均、MSD = 誤差²の平均。
系列には少なくとも2つの完全な季節が必要で、欠損があってはなりません。乗法モデルでは、すべての値が0より大きい必要があります。季節の振れ幅が系列の水準とともに大きくなる場合は乗法を、同じ大きさのままの場合は加法を選択してください。
入力項目とオプション
項目 | 説明 |
Variable (Y) | 必須。時間順に並んだ数値の系列。 |
Seasonal length | 必須、2以上。1つの季節あたりの周期の数。例:年間パターンを持つ月次データでは12、四半期データでは4。 |
Model | Additive(既定)またはMultiplicative。 |
First observation is in seasonal period | 既定値は1。季節の中での最初の行の位置。例:季節が1月に始まり、データが6月に始まる場合は6。 |
Number of forecasts | 既定値は0(なし)、最大1000。 |
Forecast origin (row) | 任意。予測を要求した場合に有効になります。予測はこの行の後から始まり、この行までのデータを使用します。空欄の場合は系列の末尾です。 |
Results to display | Summary table(既定)、またはSummary table and results table。 |
Residual plots (four in one) | 既定ではチェックなし。正規確率プロット、あてはめ値に対する残差、ヒストグラム、順序に対する残差。 |
Component analysis graph / Seasonal analysis graph | 既定では両方にチェックあり。さらに2つの4分割グラフを追加します。 |
Title | 出力のタイトル。既定値はDecomposition。 |
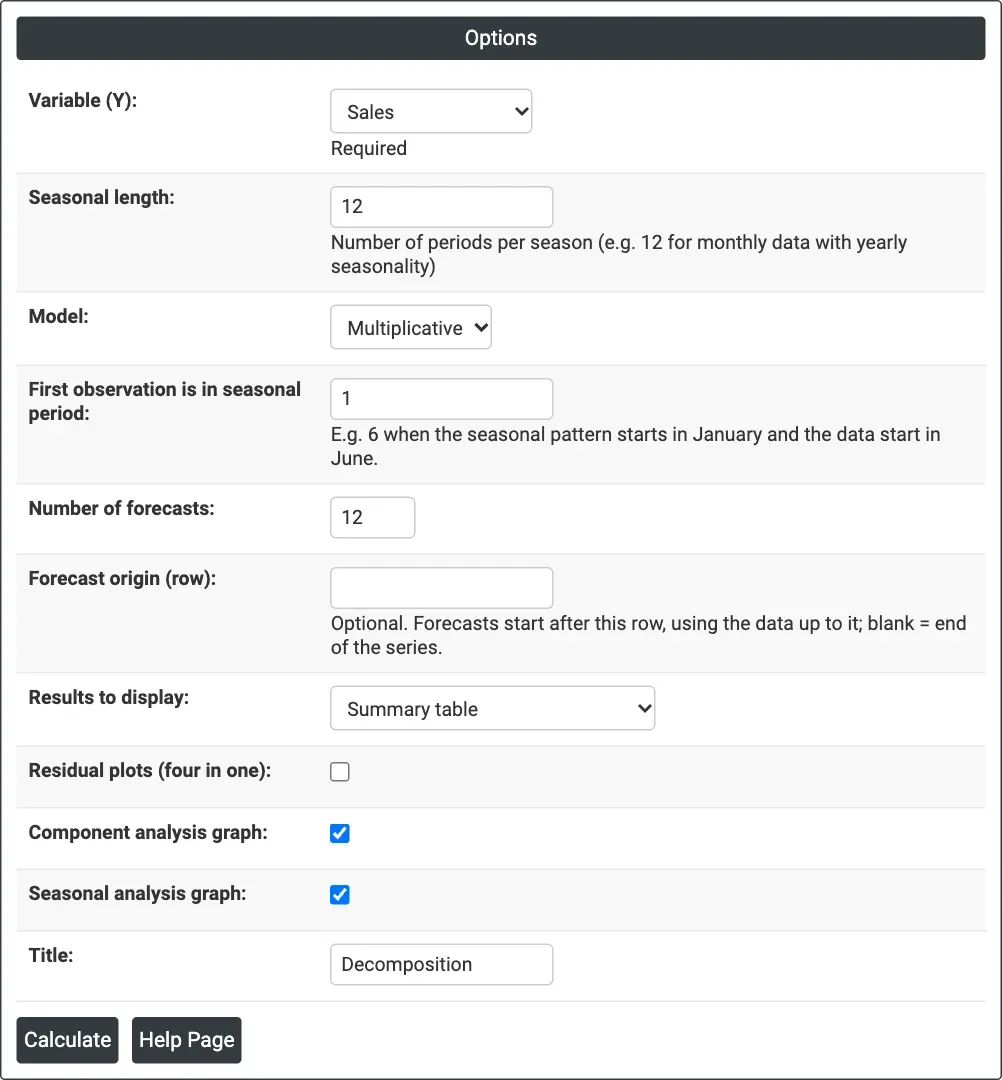
図1 — 季節の長さを12、予測を12として行った、月次Salesの乗法分解。
出力の説明
- <Model> Decomposition of <variable> — 4つのパネル(Observed、Trend、Seasonal、Residual)で、タイトルにMAPE、MAD、MSDが表示されます。
- Component Analysis for <variable> — Original Data、Detrended Data、Seasonally Adjusted Data、Seasonally Adj. and Detrended Dataの4つのパネル。
- Seasonal Analysis for <variable> — Seasonal Indices、Detrended Data by Season(箱ひげ図)、Percent Variation by Season、Residuals by Season。
- Residual Plots for <variable> — チェックした場合。
- Method — モデルの種類、データ列、長さ、季節の長さ(設定した場合は最初の周期と予測の起点も)。
- Fitted Trend Equation、Seasonal Indices(周期ごとに1つ)、Accuracy Measures(MAPE、MAD、MSD)、Forecasts(周期と予測値)。
- Results — 選択した場合:各行のPeriod、data、Trend、Seasonal、Detrend、Deseason、Predict、Error。
- DownloadによるPDFエクスポート。
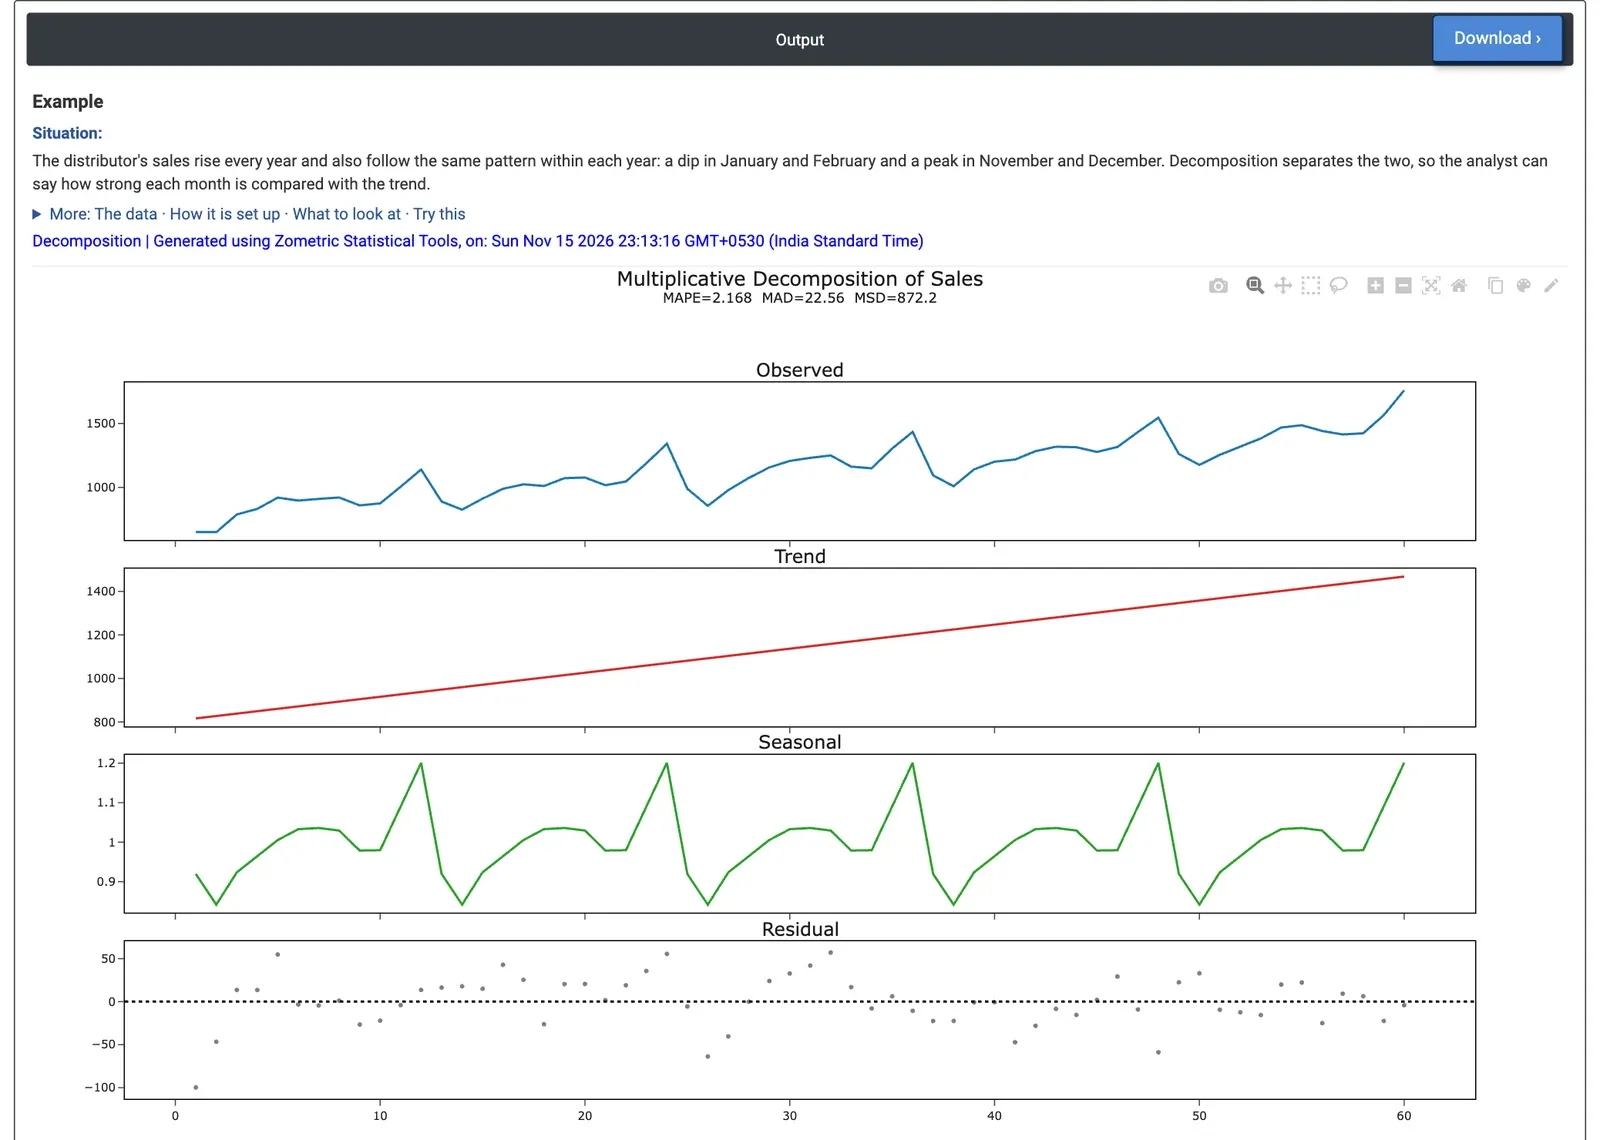
図2 — 60か月の売上の乗法分解:上昇するトレンド、毎年繰り返される季節パターン、小さな残差。
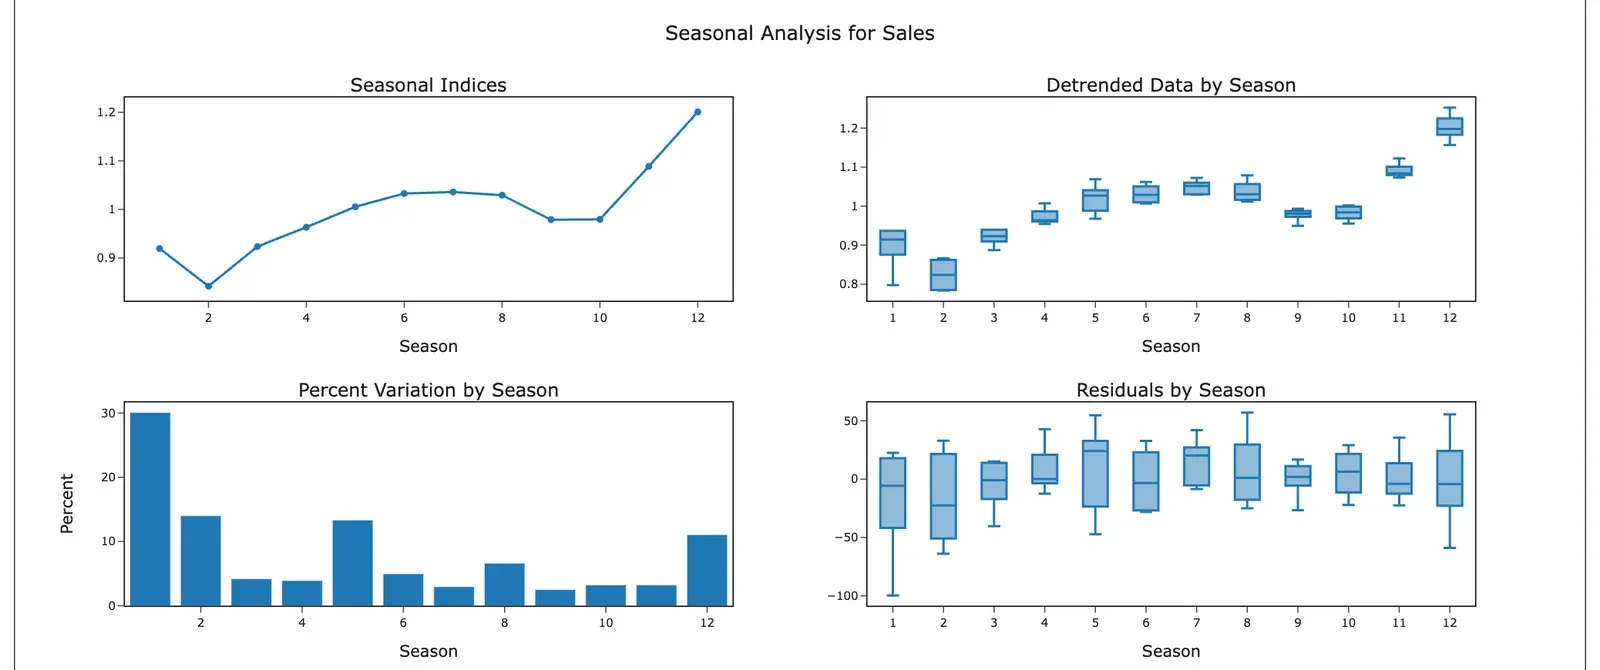
図3 — この例のSeasonal Analysis:2月が最も低い月(指数0.84)、12月が最も高い月(指数1.20)です。
計算例
ある家電製品の販売会社の売上は毎年増加しており、年内でも同じパターンをたどります。年の初めに落ち込み、11月と12月にピークを迎えます。販売アナリストは60か月分の販売数量(2020年1月〜2024年12月)を持っており、各月がトレンドと比べてどれだけ強いか、および2025年の予測を知る必要があります。アナリストは、Variable (Y) = Sales、Seasonal length = 12、Model = Multiplicative、Number of forecasts = 12を選択します。
トレンドは Yt = 805.33 + 11.049×tで、毎月約11個ずつ増えています。季節指数は、12月が1.20(トレンドより20%高い)、11月が1.09、2月が0.84(トレンドより16%低い)、1月と3月が0.92です。MAPEは2.2%(MAD 22.6個)で、Trend Analysisページの直線トレンドのみの7.4%と比べて小さくなっています。直線では説明できない部分の大半を、季節が説明しているのです。2025年の予測も同じ形をたどり、2月の1,255個から12月の1,922個まで推移します。
計画の観点では、12月の在庫と人員をトレンドの水準より約5分の1多く確保する必要があり、2月はそれを大きく下回っても構わないことを意味します。Percent Variation by Seasonのグラフからは、1月が年ごとの変動が最も大きく、その予測が最も不確かであることがわかります。Model = Additiveでは、MAPEは2.21%で、乗法の2.17%とほぼ同じなので、どちらの形でもこの季節を説明できます。加法版では、各月にパーセントではなく一定の個数(12月は+224、2月は−193)が割り当てられます。
よくある質問
加法分解と乗法分解のどちらを使用すべきですか?
季節の振れ幅が系列の水準とともに大きくなり、各季節がトレンドに対して何パーセント上または下かで表される場合は、乗法を選択します。振れ幅が同じ大きさのままで、各季節がトレンドに対して一定量だけ上または下の場合は、加法を選択します。乗法モデルでは、すべての値が0より大きい必要があります。
季節指数とは何ですか?
季節指数は、季節の各周期がトレンドよりどれだけ上または下にあるかを示します。乗法モデルでは指数の平均が1になるため、計算例の12月の1.20はトレンドより20%高いことを、2月の0.84は16%低いことを意味します。加法モデルでは指数の平均は0で、一定の量になります。
時系列分解にはどれくらいのデータが必要ですか?
系列には少なくとも2つの完全な季節が必要で、欠損があってはなりません。予測値は、あてはめたトレンド直線を延長し、対応する周期の季節指数を適用して求めます。予測区間は示されません。予測の起点を設定すると、指数とトレンドがその行までのデータから再計算されるため、既知のデータに対して手法を検証できます。
時系列分解の予測精度はどのように測定しますか?
Zometric Statistical Softwareは、平均絶対パーセント誤差のMAPE、平均絶対誤差のMAD、平均二乗誤差のMSDを報告します。例では、MAPEは2.2%で、直線トレンドのみの7.4%と比べて小さく、トレンド直線では説明できなかった部分の大半を季節パターンが説明していることを示しています。