
記述統計(Descriptive Statistics)
記述統計は、データの主な特性を表す包括的な数値要約を計算して示す、基本的な解析ツールです。中心傾向(データの中心がどこにあるか)、ばらつき(データがどの程度変動するか)、形状(データがどのように分布しているか)という3つの主要な側面を扱います。
最終レビュー
重要なポイント
記述統計は、データの主な特性である中心傾向、ばらつき、形状を表す数値要約を計算して示す、基本的な解析ツールです。
記述統計とは
記述統計は、データの主な特性を表す包括的な数値要約を計算して示す、基本的な解析ツールです。中心傾向(データの中心がどこにあるか)、ばらつき(データがどの程度変動するか)、形状(データがどのように分布しているか)という3つの主要な側面を扱います。
記述統計は、推論や予測を行うのではなく、データにすでに存在するものをそのまま記述します。通常、あらゆる統計調査の最初のステップであり、より高度な手法を適用する前に、データセットを明確かつ客観的に理解するのに役立ちます。
記述統計を使用する場面
- 他のツールを適用する前に、データセットの基本的な構造と挙動を把握するため、あらゆるデータ解析の最初のステップ として使用します。
- 簡潔な数値の概要を必要とするチーム、マネージャー、関係者に、データをわかりやすく要約して伝える 必要がある場合に使用します。
- 使用する場面:複数のグループやデータセットの比較。各グループの記述統計から、中心とばらつきの違いが一目でわかります。
- 正式な統計解析に進む前に、外れ値、歪み、異常なパターンを確認する 場合に使用します。
主な統計量の解説
統計量
わかること
平均(Mean)
算術平均。すべての測定値のつり合いの点
中央値(Median)
中央の値。平均より外れ値の影響を受けにくい
標準偏差(Standard Deviation)
測定値が平均のまわりに通常どの程度ばらつくか
分散(Variance)
ばらつきの2乗。さらなる統計計算に使われる
最小値/最大値(Minimum / Maximum)
データセットで観測された最小の値と最大の値
範囲(Range)
最小値から最大値までの全体のばらつき
歪度(Skewness)
データが中心の左(負)と右(正)のどちらに偏っているか
尖度(Kurtosis)
分布の裾が、正規分布より重いか軽いか
N(サンプルサイズ)
解析に含まれる観測値の総数
記述統計を正しく使用するためのガイドライン
- 常に 中心の指標とばらつきの指標 を併せて報告してください。標準偏差なしで平均だけを報告すると、不完全な全体像になります。
- データが 歪んでいる、または外れ値を含む場合は、主な中心の指標として、平均ではなく中央値を使用してください。そのほうがより代表的です。
- パラメトリックな統計手法を適用する前に、歪度と尖度の値を確認して、正規性を仮定できるかどうかを評価 してください。
- 標準偏差や歪度などの統計量が安定して意味のあるものになるよう、少なくとも 20〜30個の観測値 を収集してください。
代替手法:記述統計を使用すべきでない場合
状況
代わりに使用するもの
数値とともに分布の形を視覚的に見る必要がある
グラフィカル要約
グループ間の有意な差を検定する必要がある
仮説検定(t検定、ANOVA)
変数間の関係を理解する必要がある
相関分析または回帰分析
データがカテゴリ(ラベル、グループ)である
棒グラフ
経時的な傾向やシフトを検出する必要がある
ランチャートまたは管理図
記述統計の例
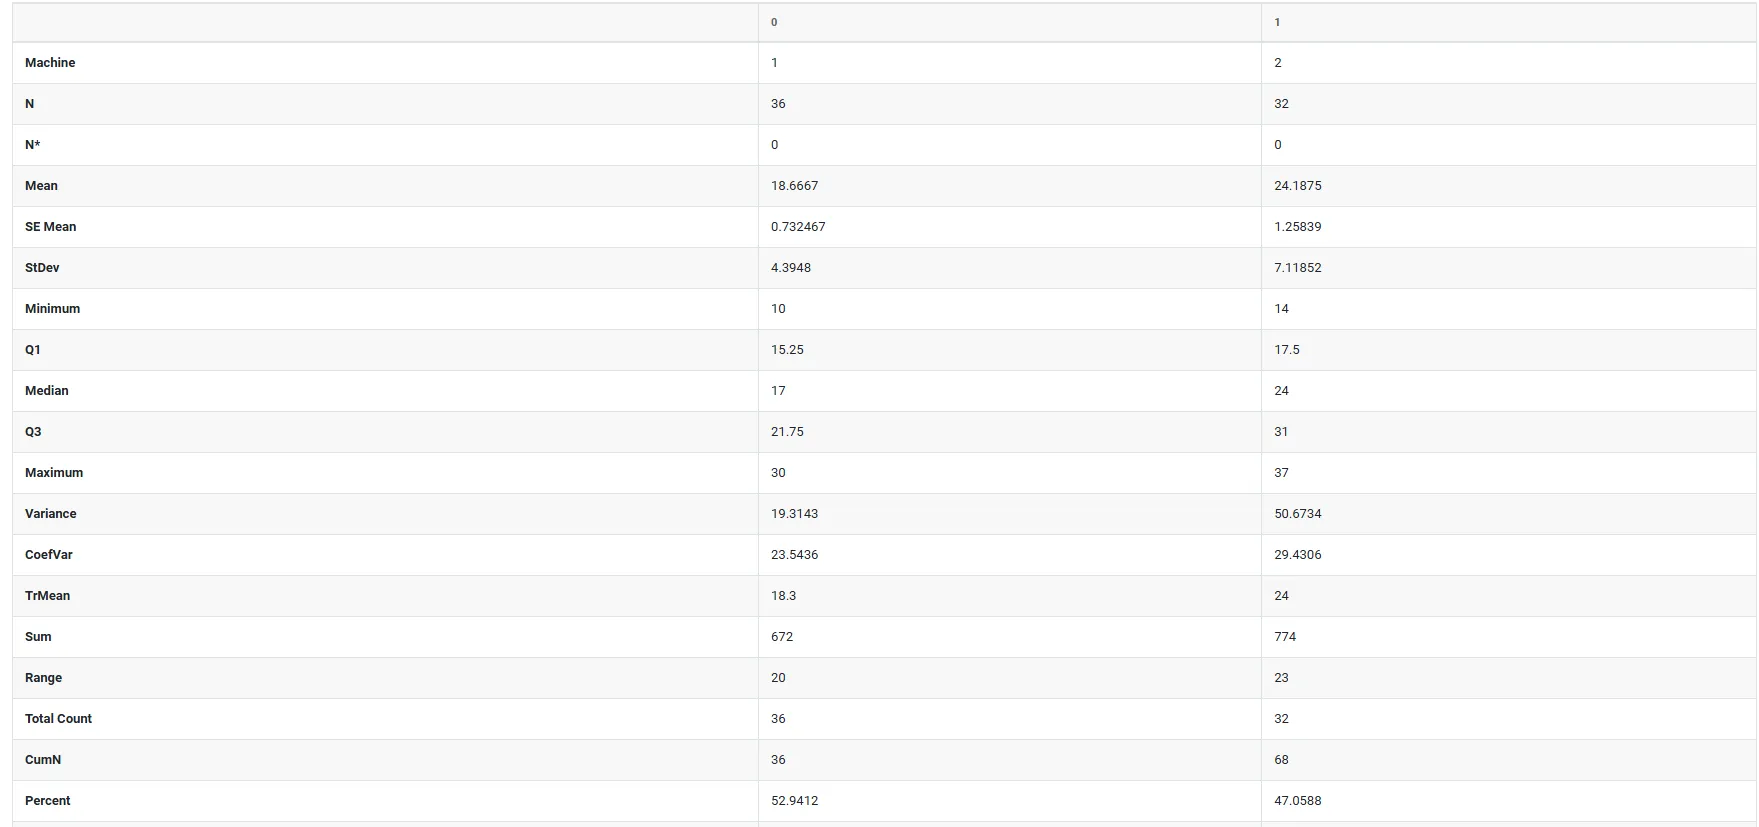
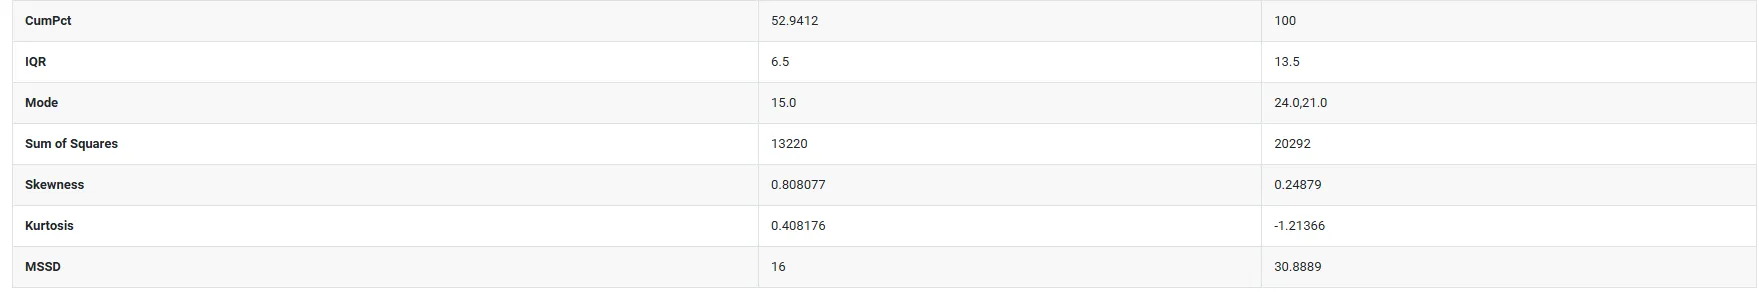
品質管理エンジニアが、シャンプーボトルのキャップが正しく締められているかを確認する必要があります。キャップの締め方が緩すぎると、輸送中に外れる可能性があります。締め方がきつすぎると、開けるのが難しくなる可能性があります。キャップを締める際の目標トルク値は18です。エンジニアは68本のボトルをランダムに抽出し、キャップを外すのに必要なトルクを試験します。手順は次のとおりです。
- 必要なデータを収集しました。
- 次に、次のサイトでZometric Statistical Softwareを使ってデータを分析します:https://statsai.zometric.com/。
- 記述統計を探すには、次を選択します:Statistical module> Graphical analysis > Descriptive Statistics
- ツール内で、データとその他の入力を次のように入力します。
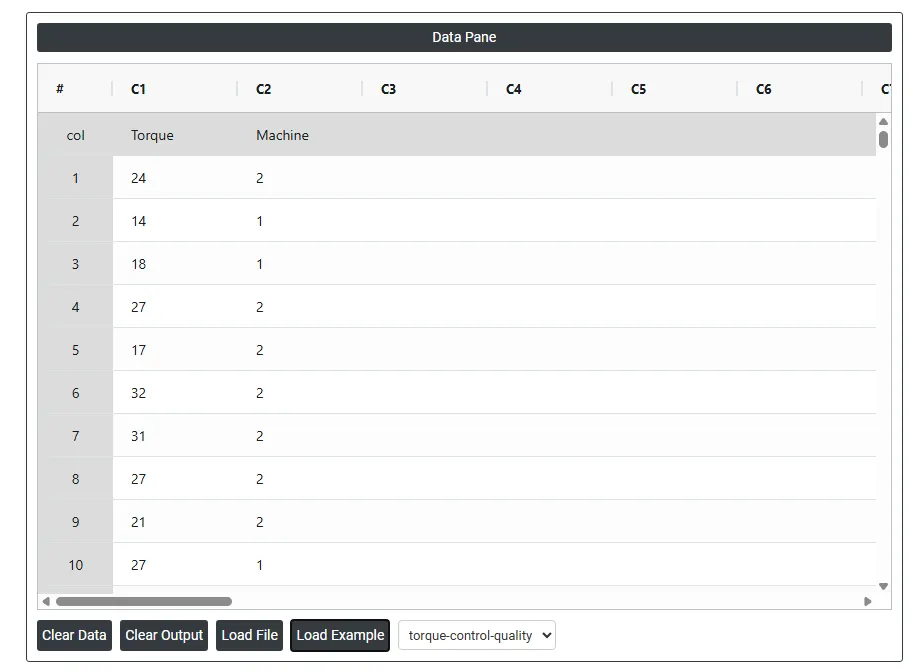
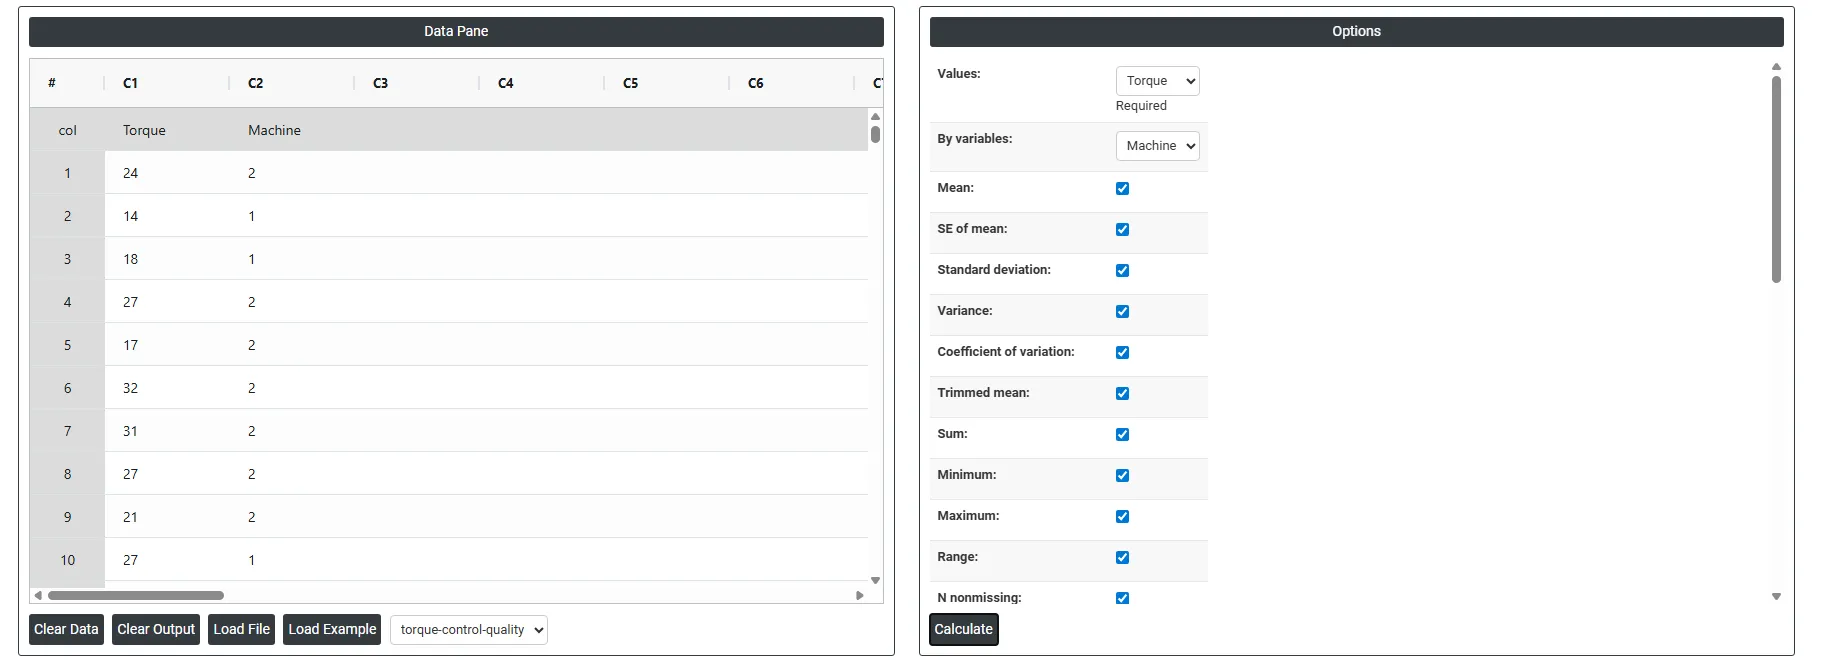
6. 上記のツールを使用すると、次のような出力が得られます。
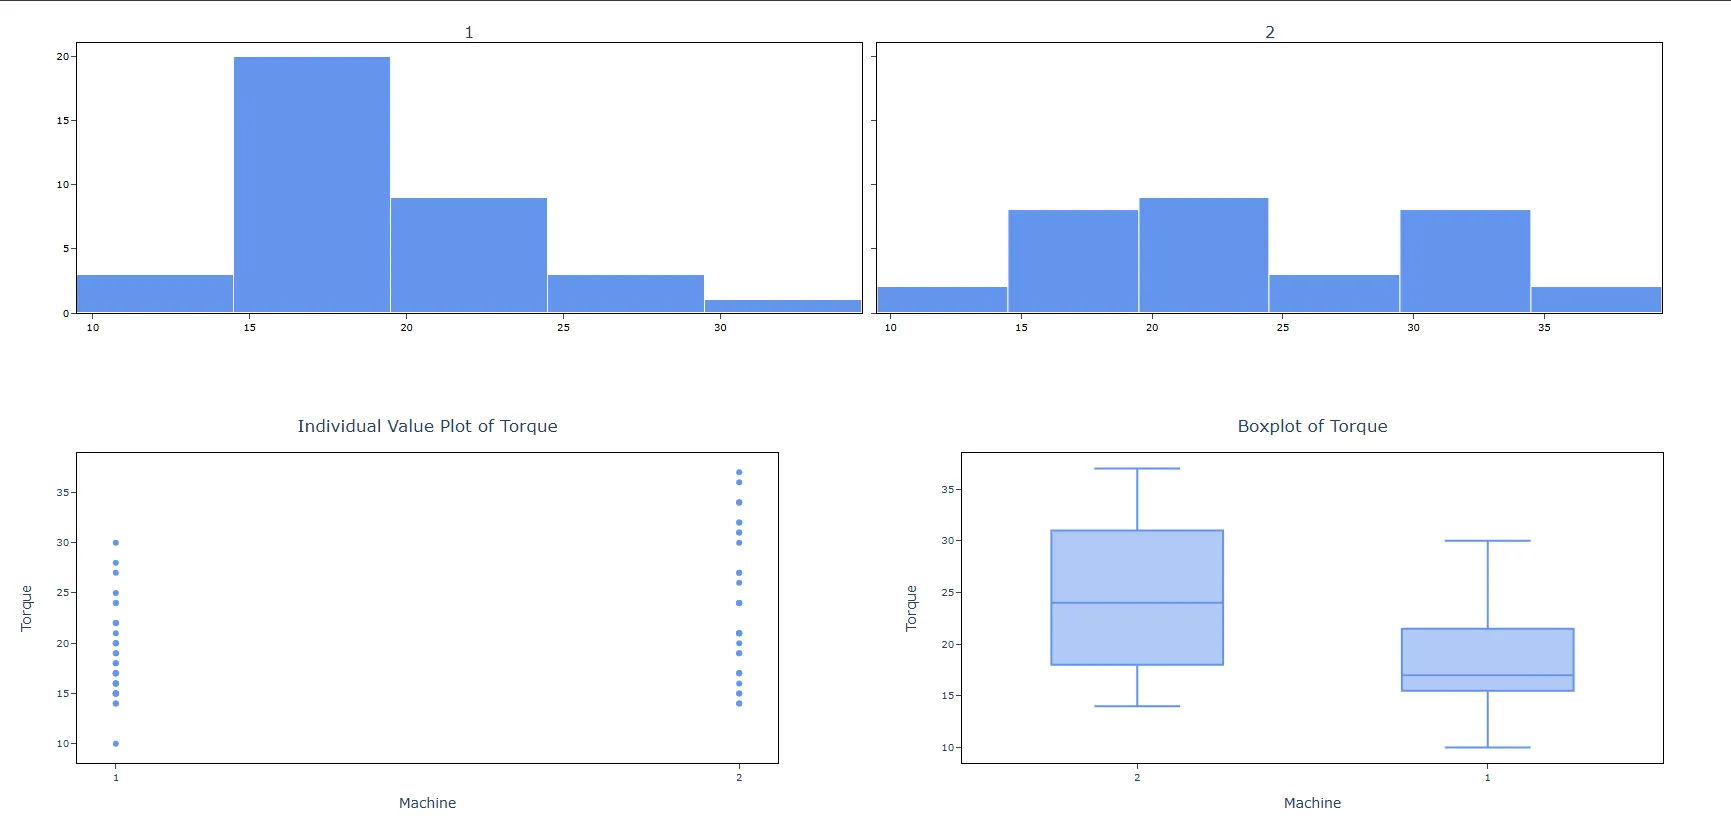
記述統計の実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホーム画面でStatistical Tool> Graphical analysis > Descriptive Statisticsを選択します。
- 次に、データを手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)して貼り付けます(Ctrl+V)。または、Load Exampleオプションを使うとサンプルデータが読み込まれます。
- 次に、必須のオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
Descriptive Statisticsのダッシュボードでは、画面が2つの部分に分かれています。
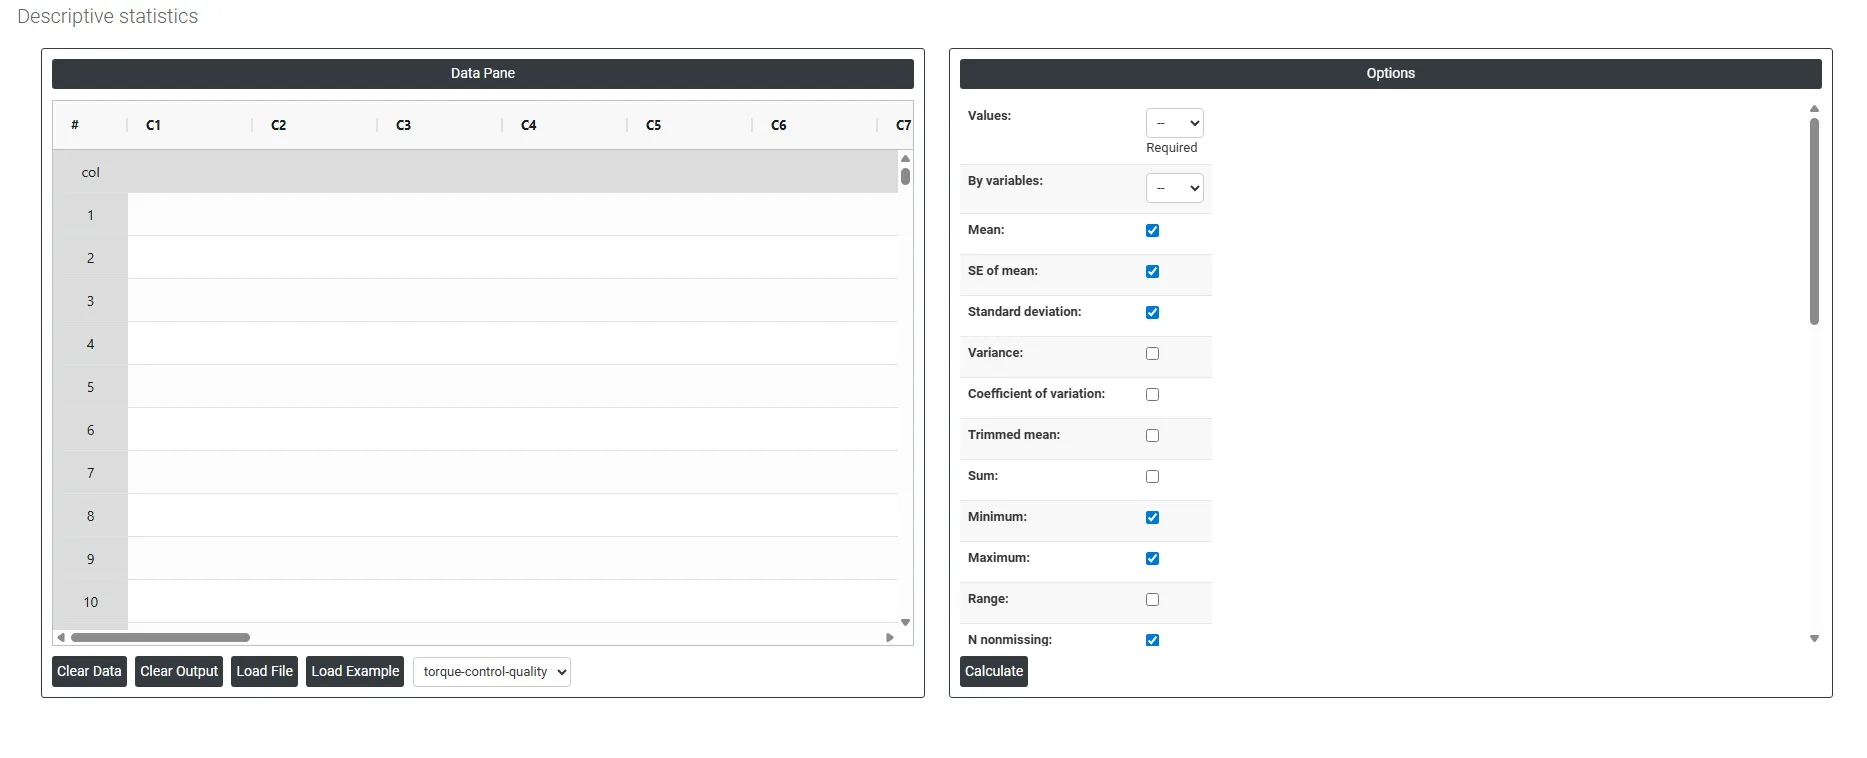
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手動で入力するか、Excelシートからデータ全体をコピー(Ctrl+C)して貼り付けます(Ctrl+V)。
Load example: サンプルデータが読み込まれます。
Load File: Excelのデータを直接読み込むためのものです。
右側では、次の項目を指定するだけです。
Values: 分析したい実際のデータを含む変数です。たとえば、トルクの測定値や機械などで、列を選択します。
By Variables: 任意のグループ化変数です。選択すると、統計量がグループごとに別々に計算されるため(たとえば機械の種類別)、グループを並べて比較できます。
Mean: 算術平均です。すべての値を足して、個数で割ります。データの位置を要約する最も一般的な方法です。
SE of mean (Standard Error of the Mean): 標本平均が真の母平均とどの程度異なりうるかを推定します。SEが小さいことは平均の推定値が信頼できることを、大きいことは不確かさが大きいことを意味します。
Trimmed mean: 最も小さい値と最も大きい値の一定の割合を除いて計算した平均です。極端な外れ値の影響が小さくなり、より安定した中心の推定値が得られます。
Median: すべてのデータ点を順に並べたときの中央の値です。値の半分がこれより上に、半分が下にあります。データが歪んでいる場合や外れ値を含む場合には、平均より信頼できます。
Mode: データセットで最も頻繁に現れる値です。最も一般的な測定値やカテゴリを特定するのに役立ちます。
Sum: すべての値を足し合わせた合計です。平均だけでなく、累積した量が重要な場合に役立ちます。
Standard deviation: 各データ点の平均からの平均的な距離を測ります。値が小さいことはデータが密に集まっていることを、大きいことは広く散らばっていることを意味します。
Variance: 標準偏差の2乗です。直接解釈するには直感的でありませんが、裏側で多くの統計計算や検定に使われます。
Coefficient of variation (CV): 標準偏差を平均に対する百分率として表します(SD ÷ Mean × 100)。これにより、単位が異なる、または平均の大きさが大きく異なるデータセット間で、ばらつきを比較できます。
Range: 最も単純なばらつきの指標で、最大値から最小値を引いたものです。理解しやすいですが、1つの極端な値に非常に敏感です。
Interquartile range (IQR): データの中央50%のばらつき(Q3からQ1を引いたもの)です。上位と下位の25%を無視するため、外れ値の影響を受けにくく、典型的なばらつきの信頼できる指標です。
MSSD (Mean of Successive Squared Differences): 収集された順序での連続するデータ点の間のばらつきを測ります。工程監視や時系列データで、工程が不安定であるか、時間とともにドリフトしているかを検出するのに特に役立ちます。
Sum of squares: 各値の2乗の合計です。それ自体は直接解釈できませんが、分散、回帰、ANOVAの計算の内部で使われる重要な構成要素です。
Minimum: データセット全体で最も小さい値です。
Maximum: データセット全体で最も大きい値です。
First quartile (Q1): 第25百分位数です。全体の4分の1の値が、この点以下にあります。
Third quartile (Q3): 第75百分位数です。全体の4分の3の値が、この点以下にあります。
N nonmissing: 有効な記録値を持ち、解析に含まれるデータ点の数です。
N missing: 値がない(空白またはnull)データ点の数です。欠測数が多い場合は、データ収集に問題がある可能性があります。
N total: 行の総数で、N nonmissing + N missingに等しくなります。
Cumulative N: 行またはグループを下に進むにつれての観測値の累計です。
Percent: 各グループの個数を、観測値の総数に対する百分率で表したものです。
Cumulative Percent: 百分率の累計です。最後の行は常に100%に達します。
Skewness: 平均のまわりで分布がどの程度非対称かを測ります。
- 0 = 完全に対称
- 正 = 裾が右に伸びている(いくつかの非常に高い値が平均を引き上げている)
- 負 = 裾が左に伸びている(いくつかの非常に低い値が平均を引き下げている)
Kurtosis: 分布の裾が、正規分布(釣鐘型の分布)と比べてどの程度重いか、または軽いかを測ります。
- 尖度が高い = 想定より極端な外れ値が多い
- 尖度が低い = 極端な値が少なく、より平坦な分布
Histogram of data: 値が定義された区間(ビン)内に入る頻度を示す棒グラフです。データが正規分布か、歪んでいるか、二峰性かなど、全体の形を見るのに最適です。
Individual value plot: すべてのデータ点を、数直線上の個別の点としてプロットします。何も隠されたり平均されたりしません。外れ値を見つけ、データの実際の生のばらつきを見るのに最適です。
Boxplot of data: 中央値、Q1、Q3、外れ値を1つのコンパクトな図にまとめた箱ひげ図です。複数のグループのばらつきと中心を並べて比較するのに優れています。
Show variables as columns: 結果の表を転置し、各変数が行ではなく列になるようにします。多くの変数を比較し、並べて見やすく配置したい場合に特に便利です。
Download as Excel: 結果をExcel形式で表示します。この形式は簡単に編集でき、load fileオプションを使って計算用に再読み込みできます。
よくある質問
記述統計とは何ですか?
記述統計は、データセットの主な特性を、中心傾向(データの中心がどこにあるか)、ばらつき(どの程度変動するか)、形状(どのように分布しているか)という3つの側面から表す数値要約です。推論を行うのではなく、データにすでにあるものを記述するもので、通常はあらゆる統計調査の最初のステップです。
平均と中央値のどちらを使うべきですか?
データが歪んでいる、または外れ値を含む場合は、極端な値の影響が平均より小さい中央値を、主な中心の指標として使用します。常に中心の指標とばらつきの指標を併せて報告してください。標準偏差なしで平均だけを報告すると、不完全な全体像になります。
歪度と尖度からは何がわかりますか?
歪度は非対称性を測ります。0は対称、正は裾が右に伸びていること、負は左に伸びていることを意味します。尖度は裾の重さを正規分布と比較します。尖度が高いと想定より極端な外れ値が多く、低いと少なくなります。パラメトリックな手法を使う前に、両方を確認して、正規性を仮定できるかどうかを評価してください。
記述統計には、どれくらいの観測値が必要ですか?
標準偏差や歪度などの統計量が安定して意味のあるものになるよう、少なくとも20〜30個の観測値を収集してください。Zometric Statistical Softwareでは、Values列を選択し、必要に応じてグループを並べて比較するBy変数を選び、ヒストグラム、個別値プロット、箱ひげ図など、必要な統計量とグラフにチェックを入れます。