
記述統計(表)(Descriptive Statistics Tables)
数値変数と、任意の行・列のグループ化変数を選び、N、平均、平均の標準誤差、標準偏差、最小値、第1四分位数、中央値、第3四分位数、最大値の9つの統計量から選択します。欠損値は除外されます。充填機とシフトごとの充填量など、サブグループの比較に使用します。データを記述するもので、差が本物かどうかを検定するものではありません。
最終レビュー
重要なポイント
記述統計(表)は、1つ以上の数値列を、最大2つのグループ化列で分けた1つの表にまとめます。詳しく調べる前に、多くのサブグループを並べて比較できます。
目的
記述統計(表)は、1つ以上の数値列を、最大2つのグループ化列(表の左側に並べる列と、上部に並べる列)で分けた1つの表にまとめます。変数ごとに、表示する統計量(個数、平均、平均の標準誤差、標準偏差、最小値、四分位数、中央値、最大値)を選択します。詳しく調べる場所を決める前に、多くのサブグループを並べるために使用します。例えば、充填機とシフトごとの充填量、ラインと製品ごとのサイクルタイム、サプライヤーとロットごとの試験結果などです。データを記述するもので、差が本物かどうかを検定するものではありません。
主な機能
- 複数の数値変数を1つの表にまとめ、それぞれに独自の統計量のブロックを表示します。
- 行変数、列変数、またはその両方による内訳:行変数のグループが表の縦方向に、列変数のグループが横方向に並びます。Minitabと同様です。
- 選択できる9つの統計量:N、Mean、Standard deviation、Minimum、Median、Maximumは既定でチェックが入っています。
- 変数の欠損値は、その変数の統計量から除外されます。
- Download からPDFにエクスポートできます。
統計的手法
データは、行変数と列変数(指定した場合)の水準で分割され、欠損値と非数値を除外した後、各グループと各変数ごとに別々に統計量が計算されます。グループは、グループ化の値を並べ替えた順に表示されます。グループ化変数がない場合、表には列全体に対する1行が表示されます。
Nは欠損のない値の個数です。平均 x̄ = Σx / N です。標準偏差 s は除数N − 1を使用します:s = √(Σ(x − x̄)² / (N − 1))。SE of mean = s / √N は、グループ平均の不確かさです。Minimum、Median、Maximumは、それぞれ最小値、中央の値、最大値です。第1四分位数と第3四分位数は、並べ替えた値の位置1 + (N − 1)·pでの線形補間によって求めた25パーセンタイルと75パーセンタイルであるため、(N + 1)·pの規則を使用するソフトウェアとはわずかに異なる場合があります。グループが小さい(値が約10個未満)場合、標準偏差と四分位数は大まかな値になるため、注意して読んでください。
入力項目とオプション
項目 | 説明 |
Variables | 必須。要約する1つ以上の数値列(複数選択するには Ctrl または Cmd を押します)。 |
For rows (optional) | グループ化の列。その各水準が、表の中でそれぞれ独自の行になります。 |
For columns (optional) | 2つ目のグループ化の列。その水準が表の列になり、水準ごとに1列ずつ並びます。各行には、1つの変数の1つの統計量が表示されます(行変数を指定した場合は、行変数の水準ごと)。 |
N / Mean / SE of mean / Standard deviation / Minimum / First quartile / Median / Third quartile / Maximum | 各変数について表示する統計量。既定でチェックが入っているのは、N、Mean、Standard deviation、Minimum、Median、Maximumです。少なくとも1つはチェックを入れる必要があります。 |
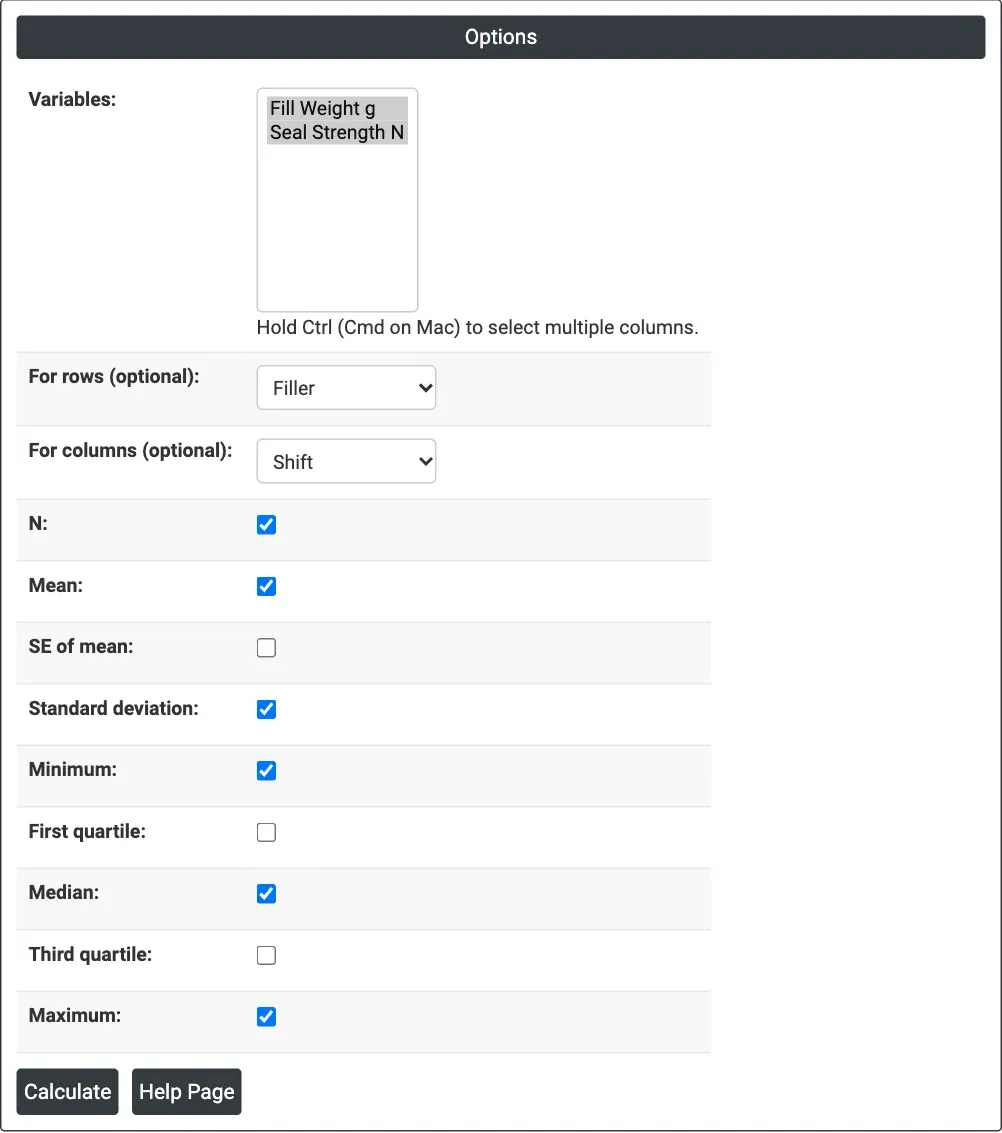
図1 — 既定の統計量による、Filler(行)とShift(列)別のFill Weight gとSeal Strength Nの要約。
出力の説明
- Statistics table — 列変数がある場合(見出しは「Rows: <row variable>; Columns: <column variable>」):最初に行変数の水準、Variable、Statisticが並び、その後に列変数の水準ごとに1列ずつ並びます。列変数がない場合:行変数のグループごとに1行(または全体で1行)で、その後に変数と統計量ごとに1列ずつ並び、Variable_Statisticという名前が付きます。例:Fill Weight g_Mean、Seal Strength N_StDev(任意の統計量にはQ1、Q3、SE Mean)。
- Download からPDFにエクスポートできます。
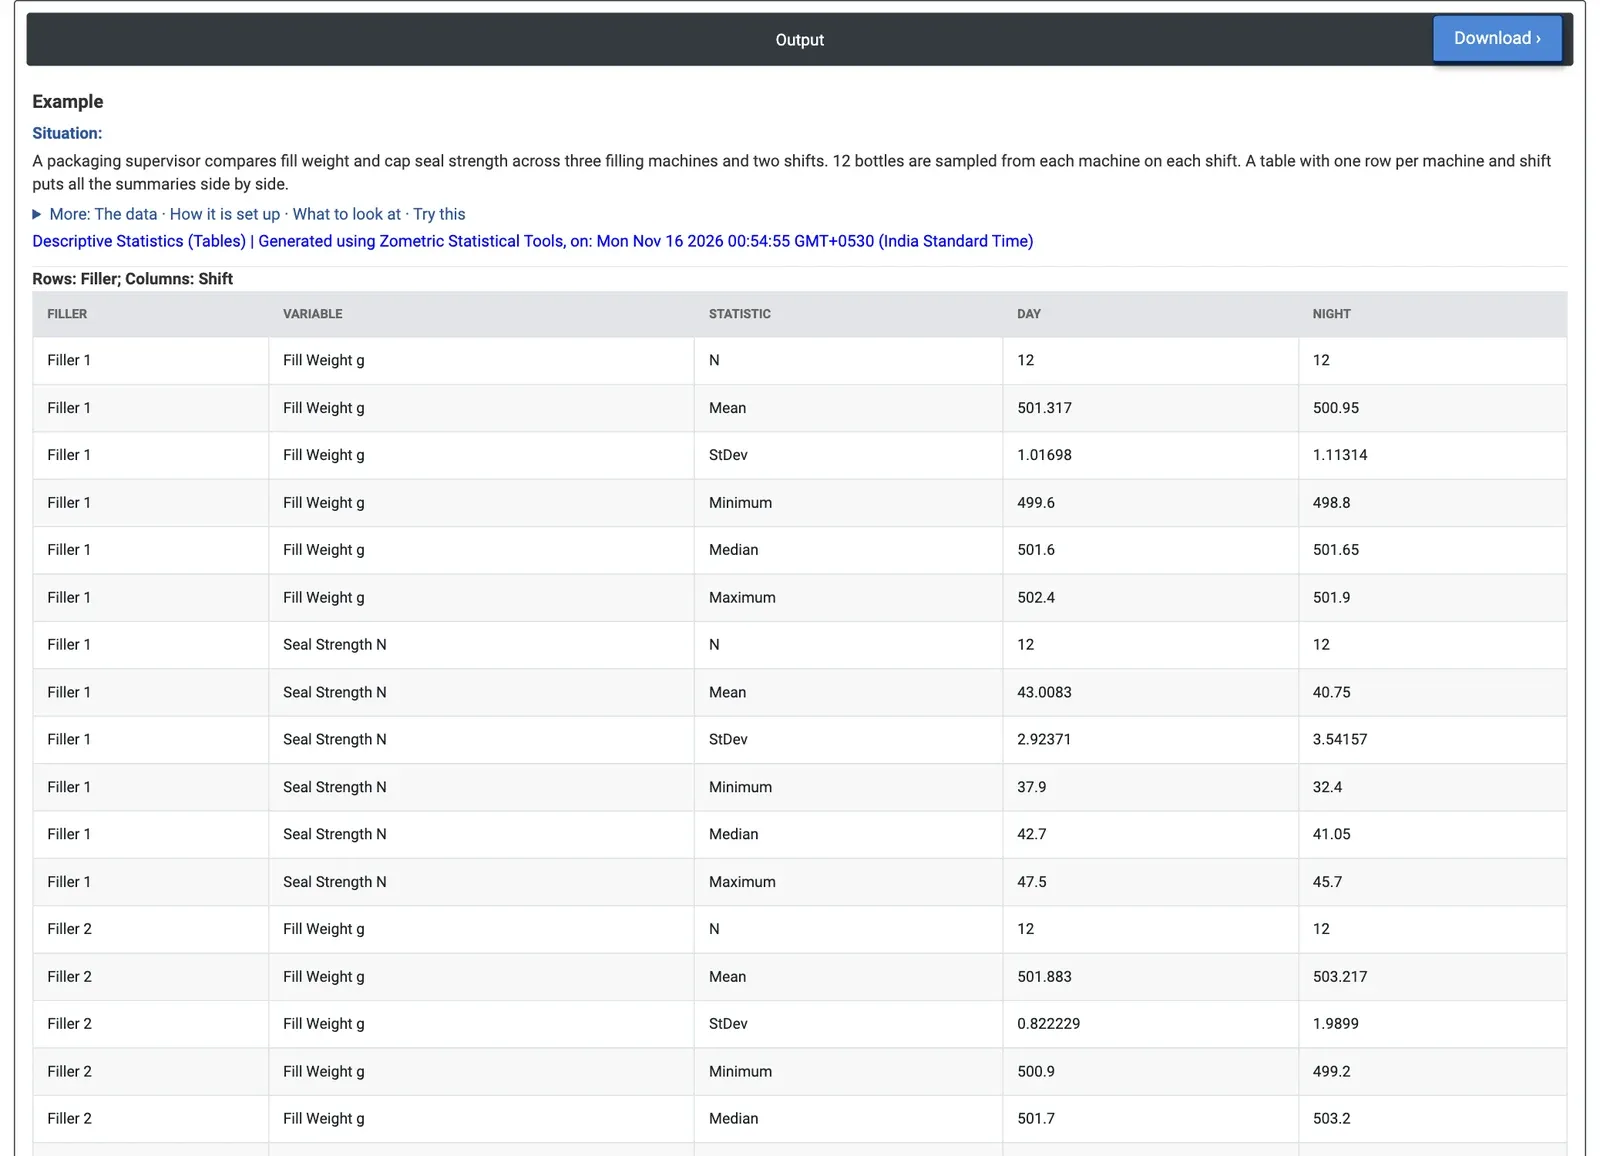
図2 — 左側に充填機、上部にシフトを配置:3台すべての充填機で夜間シフトのシール強度が低く、夜間シフトのFiller 2は充填量が最も重く、ばらつきも最大です。
計算例
包装工程の監督者が、3台の充填機を2つのシフトにわたって比較します。各シフトで各充填機から12本のボトルをサンプリングし(合計72本)、各ボトルの充填量(g)とキャップのシール強度(N)を測定します。監督者は、Variables = Fill Weight g と Seal Strength N、For rows = Filler、For columns = Shift を選択し、既定の統計量のままにします。
シール強度は、すべての充填機で夜間シフトのほうが低くなっています。夜間の平均は40.75、38.93、38.66 N、昼間は43.01、43.38、43.23 Nです。このパターンは3台すべてで同じであり、特定の1台ではなく、シフトに起因する何か(作業班、キャップのバッチ、トルク設定)を示唆しています。充填量は別の傾向を示します。夜間シフトのFiller 2が最も重く(平均503.22 g)、ばらつきも最大です(標準偏差1.99 g、範囲499.2〜506.2 g)。一方、Filler 3は両方のシフトで最も軽くなっています(499.67 gと499.61 g)。
シフトごとの見方では、For rows = Shift とし、列変数を指定せずに、First quartile と Third quartile にチェックを入れると、シール強度の平均は昼間が43.21 N、夜間が39.44 Nとなり、夜間のボトルの中央の半分は37.15〜41.18 Nの間にあります。表は、どこを調べるべきかを示します。シフトと充填機の差が偶然よりも大きいかどうかを確認するため、監督者は、Filler と Shift を因子として、Seal Strength N に対して二元配置分散分析を実行します。
よくある質問
記述統計(表)はどのような場合に使用しますか?
詳しく調べる場所を決める前に、多くのサブグループを並べるために使用します。例えば、充填機とシフトごとの充填量、ラインと製品ごとのサイクルタイム、サプライヤーとロットごとの試験結果などです。1つのグループ化変数を表の左側に縦方向に並べ、2つ目のグループ化変数を上部に横方向に並べることができます。
四分位数はどのように計算されますか?
第1四分位数と第3四分位数は、並べ替えた値の位置1 + (N − 1)·pでの線形補間によって求めた25パーセンタイルと75パーセンタイルであるため、(N + 1)·pの規則を使用するソフトウェアとはわずかに異なる場合があります。グループが約10個未満の値と小さい場合、標準偏差と四分位数は大まかな値になるため、注意して読んでください。
記述統計の表では、グループ間に差があるかどうかを検定できますか?
いいえ。データを記述するもので、差が本物かどうかを検定するものではありません。計算例では、表から3台すべての充填機で夜間シフトのシール強度が低いことがわかりました。シフトと充填機の差が偶然よりも大きいかどうかを確認するため、監督者は二元配置分散分析を実行しました。
Zometric Statistical Softwareでは、表をどのように設定しますか?
1つ以上の数値の Variables を選択し、必要に応じて For rows の列と For columns の列を選択して、表示する統計量にチェックを入れます。N、Mean、Standard deviation、Minimum、Median、Maximumは既定でチェックが入っており、少なくとも1つはチェックを入れる必要があります。標準偏差は除数N − 1を使用し、欠損値は除外されます。