
判別分析(Discriminant Analysis)
グループが既知の品目と、数値の予測変数を与えます。線形判別分析は、予測変数が共通の共分散行列をもつ多変量正規分布に従うことを仮定し、2次判別分析はグループごとの共分散行列を許容します。事前確率は、等確率、比例、ユーザー指定から選べます。出力には、混同行列、全体およびleave-one-out交差検証の正答率、新しい品目を採点する線形分類関数が含まれます。検査データからグレードを見分けられるかを確認するために使用します。
最終レビュー
重要なポイント
判別分析は、測定値から品目を既知のグループに割り当てるルールを作成します。グループを最もよく分離する測定値の組合せを求め、正しく分類された品目の数を報告します。
目的
判別分析は、測定値から品目を既知のグループに割り当てるルールを作成します。グループが既知の品目(たとえばStandardとPremiumのロット、良品と不良品、供給者)と、それらについて取得した測定値を与えると、グループを最もよく分離する測定値の組合せを求め、そのルールで正しく分類される品目の数を示します。検査データからグレードやタイプを見分けられるかを確認する場合や、新しい品目を仕分けるルールを作成する場合に使用します。
主な機能
- 2つ以上のグループに対する線形または2次の判別関数。
- 事前確率は、全グループで等しくする、グループの大きさに比例させる、またはユーザーが設定することができます。
- 実際のグループと予測されたグループの混同行列と、正しく分類された全体の割合。
- 新しい品目に対してルールがどの程度機能するかをより公平に推定するための、leave-one-out交差検証。
- 新しい品目を採点するための線形分類関数(グループごとの定数と、予測変数ごとの係数)。
統計的手法
グループが欠損している行、または予測変数が欠損または数値でない行は除外します。応答はテキストのラベルとして扱い、グループは英数字順または数値順に一覧表示されます。グループは少なくとも2つ必要で、行数は予測変数の数とグループの数の合計より多くなければなりません。
線形判別分析は、各グループで予測変数が同じ共分散行列をもつ多変量正規分布に従うことを仮定します。各グループの平均 x̄g とプールされたサブグループ内共分散行列 S を推定し、各グループにスコア Lg(x) = x̄gᵀ S⁻¹ x − ½ x̄gᵀ S⁻¹ x̄g + ln(pg) を与えます。ここで pg はそのグループの事前確率です。品目は、スコアが最も高いグループに割り当てられます。Linear Discriminant (Classification) Functions の表には、グループごとに定数(−½ x̄gᵀ S⁻¹ x̄g + ln pg)と係数 S⁻¹ x̄g が示されます。2次判別分析は、共分散が等しいという仮定を外し、グループごとに別々の共分散行列を推定するため、境界は曲線になります。グループあたりより多くのデータが必要で、単純な分類関数はありません。
事前確率は、既定では k 個のグループに対して 1/k です。比例事前確率は、データに占める各グループの割合を用いるため、大きなグループが有利になります。再代入正答率は、ルールの作成に使ったのと同じ品目を分類するため、楽観的な値になります。leave-one-out交差検証は、品目を1つずつ取り除き、残りからルールを作成して、取り除いた品目を分類するため、新しい品目に対する正答率のより良い目安になります。
入力項目とオプション
項目 | 説明 |
Response (grouping variable) | 必須です。各品目の既知のグループを保持するカテゴリーの列です。 |
Predictors | グループを分離するために用いる、1つ以上の数値の列です。 |
Discriminant function | Linear(既定、共通の共分散行列)または Quadratic(グループごとに1つの共分散行列)です。 |
Prior probabilities | All groups equal(既定)、データ中のグループの大きさに比例する Proportional to group sizes、または User-specified です。 |
Custom priors | Prior probabilities が User-specified の場合にのみ使用されます。グループごとに1つの値を、英数字順または数値順のグループ順に、カンマまたは空白で区切って指定します。すべて正の値で、合計が1になる必要があります。例:0.2, 0.5, 0.3。 |
Cross-validate (leave-one-out) | 既定でチェックされています。交差検証による正答率と混同行列が追加されます。 |
Title | 解析のタイトルです。既定値は Discriminant Analysis です。 |
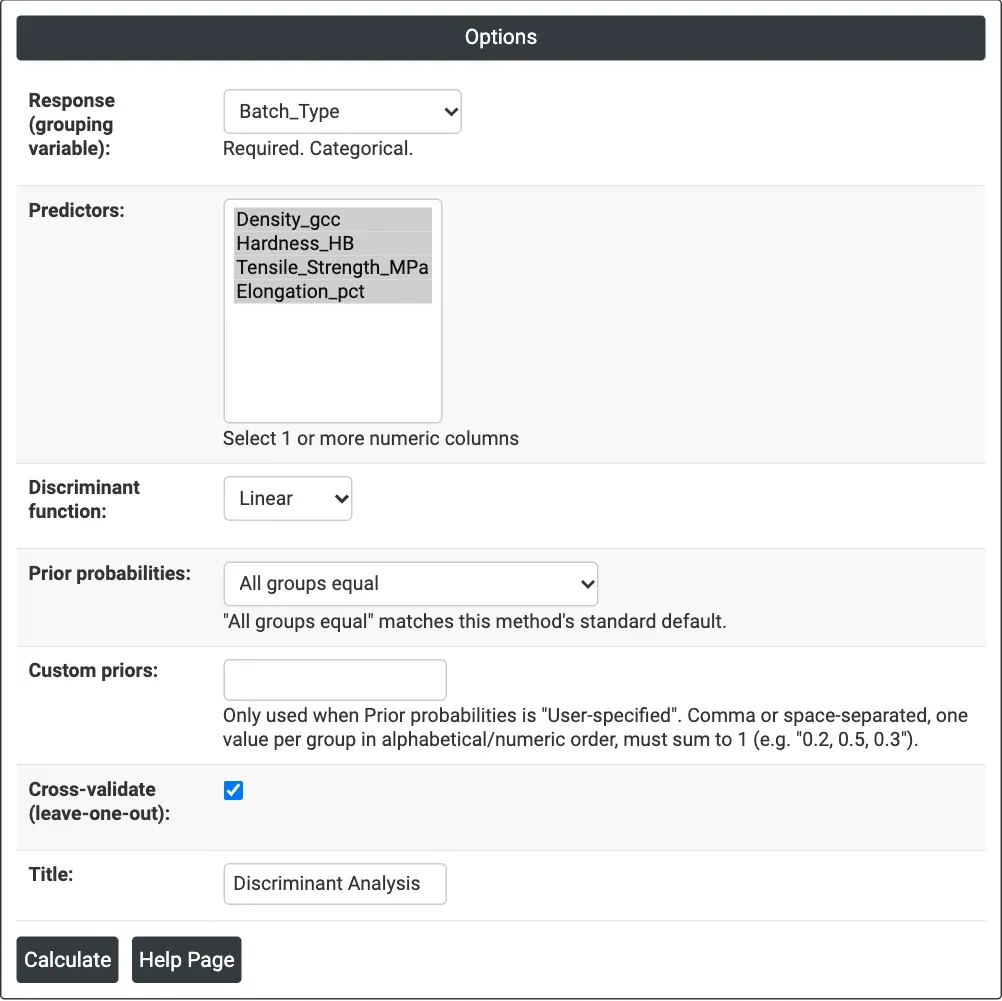
図1 — 例のオプション:応答としてBatch_Type、予測変数として4つの特性の列、線形関数、等しい事前確率、leave-one-out交差検証。
出力の説明
- Summary line — 使用した N、再代入正答率、およびチェックした場合は交差検証(leave-one-out)の正答率。
- Prior Probabilities — 各グループに用いた事前確率。
- Confusion Matrix (Resubstitution) — 行に実際のグループ、列に予測されたグループ。
- Confusion Matrix (Cross-Validated) — leave-one-outによる予測を用いた同様の表。
- Linear Discriminant (Classification) Functions — 線形関数の場合のみ:グループごとの定数と各予測変数の係数。新しい品目は、関数の値が最も高いグループに割り当てられます。
- Download によるPDF出力。
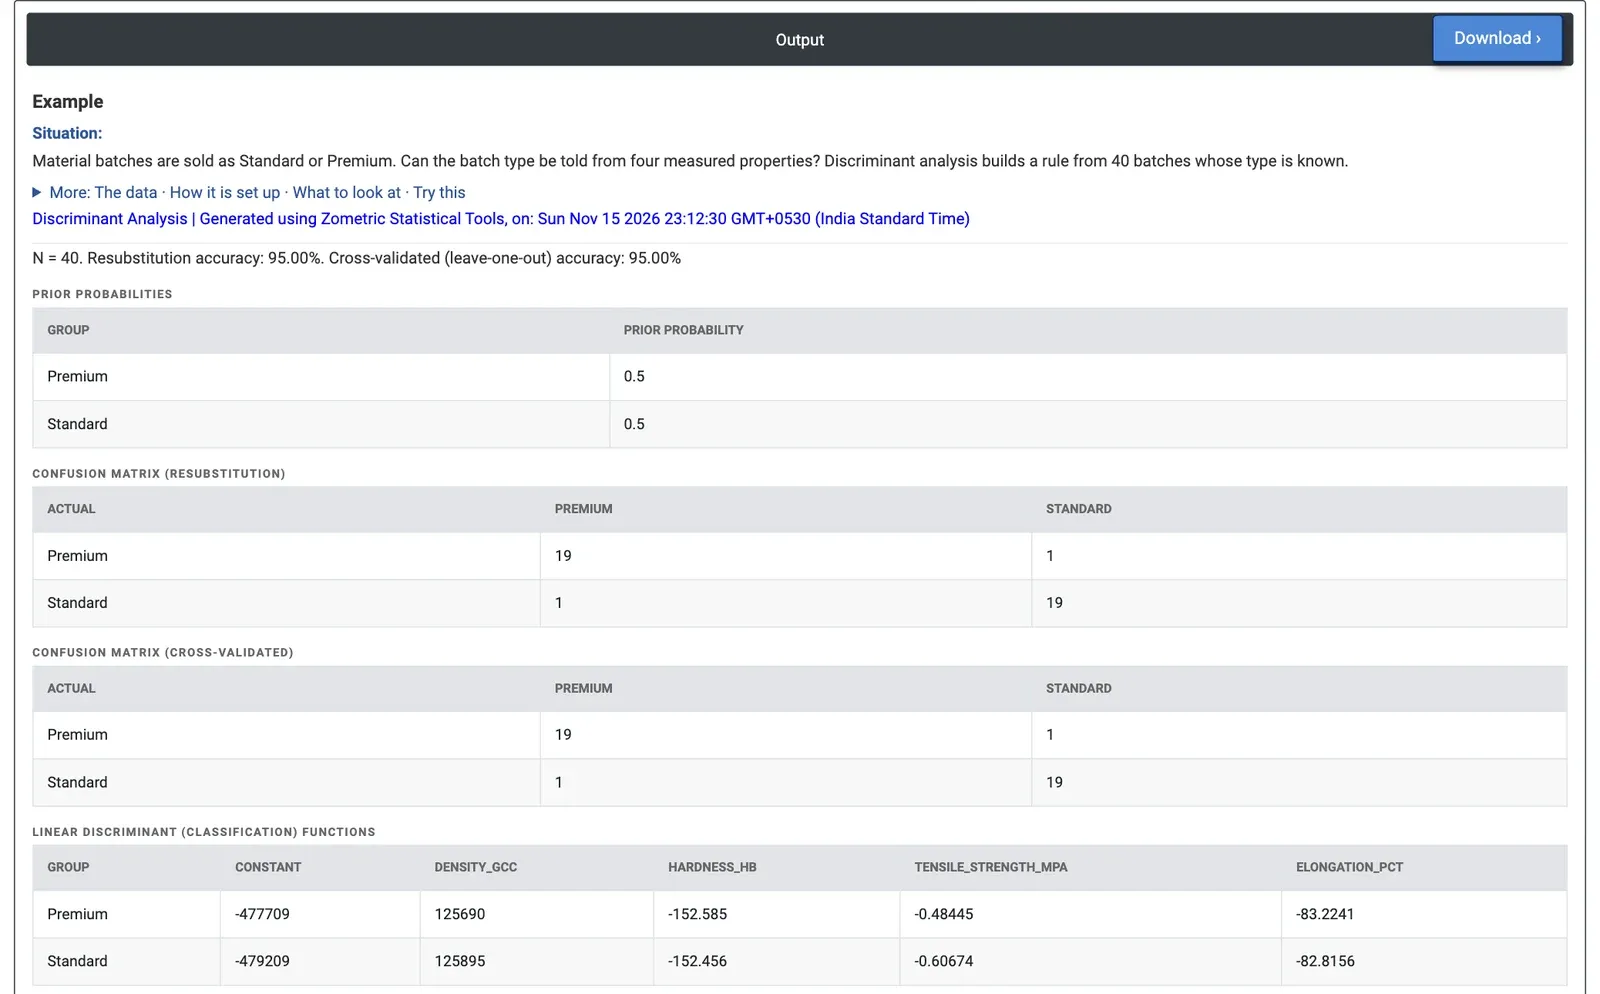
図2 — 40ロットの結果:データ上でもleave-one-out交差検証でも95%が正しく分類されました。各タイプで1ロットずつが誤分類されています。
計算例
材料工場では、ロットをStandardまたはPremiumとして販売しています。品質技術者は、密度(g/cc)、硬さ(HB)、引張強さ(MPa)、伸び(%)という4つの日常的な測定値から、ロットのタイプを見分けられるかを知りたいと考えています。技術者は、タイプが既知の40ロット(各20ロット)を使用し、Response (grouping variable) = Batch_Type、4つの特性を Predictors、Discriminant function = Linear、Prior probabilities = All groups equal とし、Cross-validate にチェックを入れます。
このルールは、40ロット中38ロットを正しく分類します。データ上で95.00%、leave-one-out交差検証でも95.00%であり、ルールの作成に使った40ロットに当てはめただけではありません。各タイプで20ロット中19ロットが正解です。誤分類された2ロットは、行3(Standard、197.4 HB、1,210.8 MPa)と行27(Premium、202.3 HB、1,209.7 MPa)で、グループ平均(Premiumは212.9 HBと1,253.6 MPa、Standardは180.1 HBと1,126.2 MPa)の中間に位置しており、確認する価値があります。分類関数は、4つの測定値から各新規ロットにPremiumスコアとStandardスコアを与え、そのロットはスコアの高いほうのタイプに割り当てられます。
密度は、そのばらつきの小ささから想像されるより重要です。Premiumの平均は7.878 g/cc、Standardは7.850であり、密度を予測変数から外すと正答率は82.5%(交差検証では75.0%)に低下します。2次関数は、グループあたり20ロットしかないのに推定するパラメータが多くなるため、ここではより悪い結果となり、データ上で92.5%、交差検証で85.0%でした。技術者にとって、4つの特性すべてを用いた線形ルールは、ラベルが測定値と一致しないロットを検出するのに十分な性能です。ラベルを使わずに同じデータをクラスタリングした場合(Cluster K-Meansがタイプと一致するのは40ロット中28ロット)と比べると、グループがわかっているほうがはるかに明確に分離できます。
よくある質問
線形判別分析と2次判別分析の違いは何ですか?
線形判別分析は、各グループで予測変数が同じ共分散行列をもつ多変量正規分布に従うことを仮定し、線形の分類関数を与えます。2次判別分析は、グループごとに別々の共分散行列を推定するため、境界は曲線になりますが、グループあたりより多くのデータが必要で、単純な分類関数はありません。例では、グループあたり20ロットしかなかったため、2次のほうが悪い結果になりました。
なぜleave-one-out交差検証を使用するのですか?
再代入正答率は、ルールの作成に使ったのと同じ品目を分類するため、楽観的な値になります。leave-one-out交差検証は、品目を1つずつ取り除き、残りからルールを作成して、取り除いた品目を分類するため、新しい品目に対する正答率のより良い目安になります。例ではどちらも95%であり、ルールは自身のデータに当てはまっているだけではありませんでした。
事前確率は判別分析にどのように影響しますか?
既定では、k 個のグループそれぞれに 1/k の事前確率が与えられます。比例事前確率は、データに占める各グループの割合を用いるため、大きなグループが有利になります。ユーザー指定の事前確率は、すべて正の値で、英数字順または数値順のグループ順にグループごとに1つ指定し、合計を1にする必要があります。事前確率は、その自然対数を通じて各グループのスコアに加わります。
判別分析で新しい品目をどのように分類しますか?
線形判別関数の場合、Zometric Statistical Softwareは、Linear Discriminant (Classification) Functions の表に、グループごとの定数と予測変数ごとの係数を一覧表示します。新しい品目を各グループの関数で採点し、関数の値が最も高いグループに割り当てます。