
ドットプロット(Dotplot)
ドットプロットは、データの範囲を等間隔のビンに分け、値1つにつき点を1つ積み重ねるため、積み重ねの高さが度数になります。要約したり正規性を仮定する検定を行ったりする前に、数百個までの値のサンプルに使用します。オプションには、グループ列または複数の列、ビンの数、対数スケール、1.5xIQRルールによる外れ値の除外があります。
最終レビュー
重要なポイント
ドットプロットは、小規模から中規模のデータセットのすべての値を数直線上の点として示し、似た値を積み重ねることで、山、隙間、別々のグループ、はずれた点といったデータの形を確認できます。
目的
ドットプロット(Dotplot)は、小規模から中規模のデータセットのすべての値を数直線上の点として示し、値が似た点を互いに積み重ねます。平均や標準偏差とは異なり、値がどこに集まっているか、隙間、別々のグループ、はずれた点といったデータの形がわかります。充填量、初物検査の寸法、試験の結果など、数百個までの値のサンプルに対し、それらを要約したり、正規分布を仮定する検定を行ったりする前に使用します。
主な機能
- 1つのデータ列、または複数の列(Multiple Ysモード)。それぞれが独自の行と色で表示されます。
- 任意のグループ列:Minitabの「With Groups」ドットプロットのように、グループごとに積み重ねた点の行を1行ずつ表示します。
- ビンの数は、指定するか、サンプルサイズから計算されます。
- 歪んだ正のデータに対する、対数スケールのX軸。
- 1.5×IQRルールによる外れ値の任意の除外。除外した数も注記されます。
- 行番号または条件によって、行を除外する、または行だけを残すData Options。
統計的手法
値は数値に変換され、欠測値や数値でない入力は除かれます。最小値から最大値までの範囲は等間隔のビンに分けられます。Number of binsが空白の場合、ビンの数は2 × √nを切り上げた値で、10〜60の間に収められます(25個の値では10ビン)。各値はビンの中心に置かれ、同じビンの値は上に積み重ねられるため、積み重ねの高さはそのビンの度数です。したがって、点は値を厳密にではなく、最も近いビンで示します。最大値は最後のビンに入ります。グループ列がある場合や複数のデータ列がある場合、各グループまたは各列にそれぞれの行が与えられ(最初のものが一番上)、すべての行が同じビンを共有するため、行どうしを直接比較できます。Log scale X-axisを使うと、ビンは対数スケール上で等間隔になります。その場合、すべての値が0より大きい必要があります。
Exclude outliersをオンにすると、Q1 − 1.5×IQRより小さい値、またはQ3 + 1.5×IQRより大きい値(IQR = Q3 − Q1。グループ列を設定した場合はグループごとに計算)がプロット前に除かれ、グラフの下に除外した数が注記されます。プロットの読み方:中央に1つの山があり、両側に均等に裾が広がっている場合は、正規分布と整合しています。隙間を挟んで2つ以上の山がある場合は、複数の要因(2つのノズル、2つのシフト、2つのサプライヤー)が混在していることを示唆しており、以後の分析の前に分けて考える価値があります。
入力項目とオプション
項目 | 説明 |
Data column(s) | 必須。数値列を1つ、またはMultiple Ysモード用に複数。複数選択するにはCtrlキーまたはCommandキーを押します。 |
Grouping column | 任意。グループごとに積み重ねた点の行を1行ずつ表示し、それぞれ独自の色で、縦軸にグループ名が表示されます(「With Groups」)。 |
Number of bins | 任意、5〜200。空のままにすると、値の個数から計算されます。 |
Log scale X-axis | 既定ではオフです。X軸を対数軸にし、そのスケール上で等間隔のビンを使います。 |
Title | グラフに表示されるタイトルです。既定値はDotplotです。 |
Discrete color sequence | グループまたは列に使うカラーパレットで、既定値はD3です。グループのない単一の列は紺色で描かれます。 |
Exclude outliers (1.5×IQR rule) | 既定ではオフです。プロットの前に、Q1 − 1.5×IQRとQ3 + 1.5×IQRを超える点(グループ列を設定した場合はグループごと)を除きます。 |
Data Options: Subset (optional) | Exclude matching rows(既定)またはInclude only matching rowsで、Row numbers(例:3,7,12-15。元のグリッドの行番号を使用)や、Condition(例:Fill_Volume_mL > 249)によって一致する行を指定します。Row numbersまたはConditionを入力しない限り、効果はありません。 |
Figure 1 — ボトル25本の充填量のドットプロット。ビンの数は自動で計算されています。
出力の説明
- Dotplot — X軸に沿って積み重ねた点で、値1つにつき点が1つ。グループまたは複数の列がある場合は、それぞれ1行で、縦軸に名前が表示されます。
- Outlier note — Exclude outliersで点が除かれた場合:除外した数。
- DownloadによるPDFエクスポート。
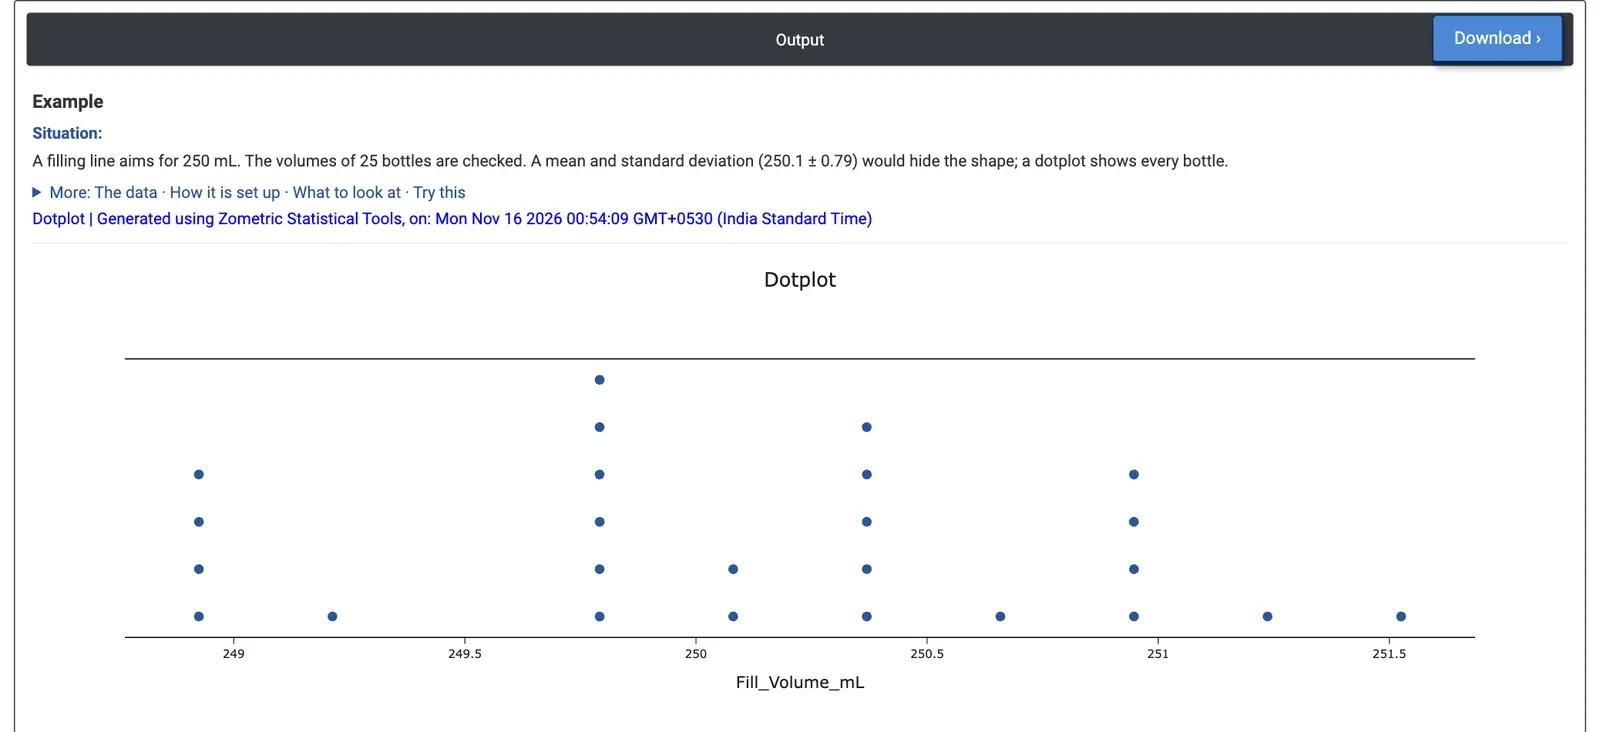
Figure 2 — ボトル25本の充填量:249.8、250.4、251.0 mL付近に山があり、248.9 mL付近に4本の別のグループがあります。
計算例
充填ラインは、ボトル1本当たり250 mLを目標としています。ラインの監督者が25本のボトルの容量を確認します。平均は250.10 mL、標準偏差は0.79 mLで、問題なさそうに見えますが、このような数値はデータの形を隠してしまいます。監督者はData column(s) = Fill_Volume_mLを選択し、Number of binsは空のままにするため、ツールは幅約0.29 mLの10個のビンを使用します。
充填量は248.78から251.67 mLにわたります。点は整った1つのベル形にはなりません。249.8 mL付近に6本、250.4 mL付近に5本、251.0 mL付近に4本の山があり、248.9 mL付近(248.78〜249.05 mL)に低い4本のボトルからなる別のグループがあります。249.21〜249.68 mLの間にはボトルがない隙間があり、離れています。Number of bins = 30にすると積み重ねは最大でも点3個の高さですが、低い4本のボトルは依然として残りから離れています。Exclude outliersではそれらは1つも除かれません。四分位数から1.5×IQR以内にあるためで、これらははずれた点ではなくグループです。
判断のためには、ライン設定全体を調整する前に、何がボトルを分けているのか、たとえば1つの充填ノズルだけ低くなっていないかを確認することになります。ボトルごとにノズル番号が記録されていれば、それをGrouping columnとして使うことで、低いボトルが1つのノズルに由来するかどうかが直接わかります。
よくある質問
ドットプロットはどのように読みますか?
中央に1つの山があり、両側に均等に裾が広がっている場合は、正規分布と整合しています。隙間を挟んで2つ以上の山がある場合は、2つのノズル、2つのシフト、2つのサプライヤーなど、複数の要因が混在していることを示唆しており、以後の分析の前に分けて考える価値があります。各積み重ねの高さは、そのビンにある値の個数です。
平均と標準偏差ではなく、ドットプロットを使用するのはどのような場合ですか?
データの形が重要な場合は、数百個までの値のサンプルにドットプロットを使用します。計算例では、25個の充填量の平均は250.10 mL、標準偏差は0.79 mLで、問題なさそうに見えましたが、ドットプロットによって、248.9 mL付近に4本の低いボトルからなる別のグループがあることがわかりました。
ドットプロットでは、いくつのビンが使われますか?
Number of binsを空白にした場合、ビンの数は2 x √nを切り上げた値で、10〜60の間に収められ、25個の値では10ビンになります。各値はビンの中心に置かれるため、点は値を厳密にではなく、最も近いビンで示します。5〜200のビンの数を自分で指定することもできます。
ドットプロットでグループを比較するにはどうすればよいですか?
Zometric Statistical Softwareでは、グループ列を選択するとグループごとに積み重ねた点の行が1行ずつ表示されます。複数のデータ列を選択することもできます。すべての行が同じビンを共有するため、直接比較できます。充填の例では、ノズル番号でグループ分けすると、低いボトルが1つのノズルに由来するかどうかが直接わかります。