
経験CDF(Empirical CDF)
経験CDFは、値を並べ替え、各値を (i − 0.5) / n の位置に割合(%)としてプロットし、階段状につなぎます。平均値だけでは見えないグループ間の比較、限界値を下回る部品の割合の読み取り、NormalやWeibullなどの当てはめた分布とのデータの照合に使用します。By列を指定するとグループごとに1本の曲線が描かれ、複数の変数を重ねて表示することもできます。
最終レビュー
重要なポイント
経験CDFは、測定値の各値について、それ以下の観測値の割合(%)を階段状の曲線としてプロットし、分布全体の中央値、ばらつき、裾、途切れを一度に示します。
目的
経験CDFは、測定値の各値について、それ以下の観測値の割合(%)をプロットします。結果は階段状の曲線となり、中央値、ばらつき、裾、途切れなど、分布全体を一度に示します。平均値だけでは見えない2つ以上のグループ(機械、供給者、構成)の比較、限界値を下回る部品の割合の読み取り、当てはめた分布とのデータの照合に使用します。
主な機能
- 変数ごとに1本の階段状の曲線。By列を選択した場合は、1つの変数のグループごとに1本の曲線。
- 直接比較するために、複数の変数を1つのプロットに重ねて表示。
- 任意で、当てはめた分布を破線として重ねて表示:Normal、Lognormal、Weibull、Exponential、2-Parameter Exponential、Smallest Extreme Value、Largest Extreme Value、Logistic、Loglogistic。
- 縦軸は0〜100のパーセント目盛りであるため、パーセンタイルを曲線から直接読み取れます。
- プロットの前に、行番号または条件によって行を除外または対象として残せます。
統計手法
各曲線について、空白でない数値を x₁ ≤ x₂ ≤ … ≤ xₙ の順に並べ替え、i番目の値を打点位置 pᵢ = (i − 0.5) / n に、割合(%)としてプロットします。点は階段状(水平方向、続いて垂直方向)につなぎます。そのため、曲線は観測値ごとに100/n %ずつ上昇します。曲線が50%と交わる値がそのグループの中央値で、90%と交わる値が90パーセンタイルです。
By列と1つの変数を指定した場合、行はBy列の水準によって分割され、各水準に固有の曲線が描かれます。複数の変数を指定した場合は、変数ごとに曲線が描かれ、By列は無視されます。
当てはめる分布を選択すると、Minitabと同様に、そのパラメーターは曲線ごと(グループごと、または変数ごと)に別々に推定され、当てはめたCDFは、それぞれのデータの範囲にわたって描かれます。Normalは標本平均と標準偏差を使い、ほかの分布は最尤法を使います(Lognormal、Weibull、Exponential、Loglogisticは閾値を0に固定するため、正の値が必要です)。凡例には各曲線の当てはめたパラメーターが表示されるため、各グループをそれぞれのモデルと照らして確認できます。
入力項目とオプション
項目 | 説明 |
Variables | 1つ以上の数値列。1つの変数を選択するか、複数を選択して曲線を重ねます。 |
By (grouping) column | 任意。この列の水準ごとに1本の曲線を描きます。1つの変数を選択した場合にのみ使用されます。 |
Overlay fitted distribution | 既定は「--- (empirical only)」:当てはめた線なし。または、Normal、Lognormal、Weibull、Exponential、2-Parameter Exponential、Smallest Extreme Value、Largest Extreme Value、Logistic、Loglogisticのいずれか。 |
Title | プロットのタイトル。既定値は「Empirical CDF」です。 |
Data Options: Subset (optional) | Exclude matching rows(既定)またはInclude only matching rows。Row numbers(例:3,7,12-15)や Condition(例:Weight_kg > 100)で行を選択します。両方とも空欄の場合は、何の効果もありません。 |
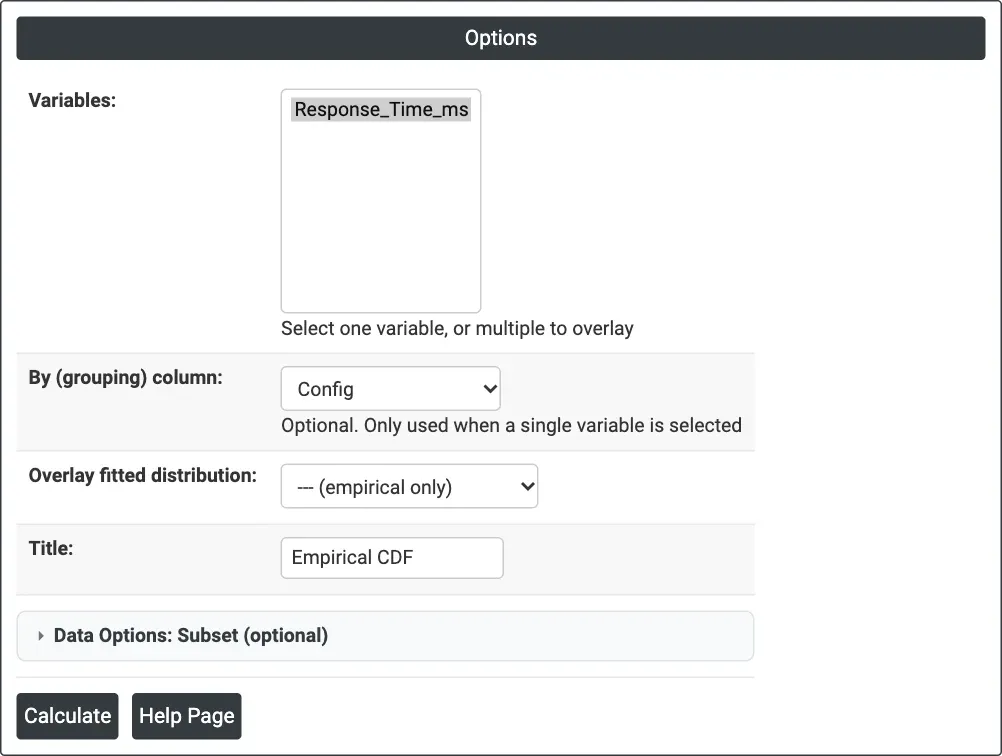
図1 — この例のオプション:Variables = Response_Time_ms、By (grouping) column = Config、当てはめた分布なし。
出力の説明
- Empirical CDF — グループごと、または変数ごとの、変数に対する割合(%)の階段状の曲線。各観測値にマーカーを付け、曲線を示す凡例を表示します。当てはめた分布を選択した場合は、曲線ごとにその曲線の色(曲線が1本の場合は黒)の破線で表示され、パラメーターが付記されます。
- DownloadによるPDF出力。
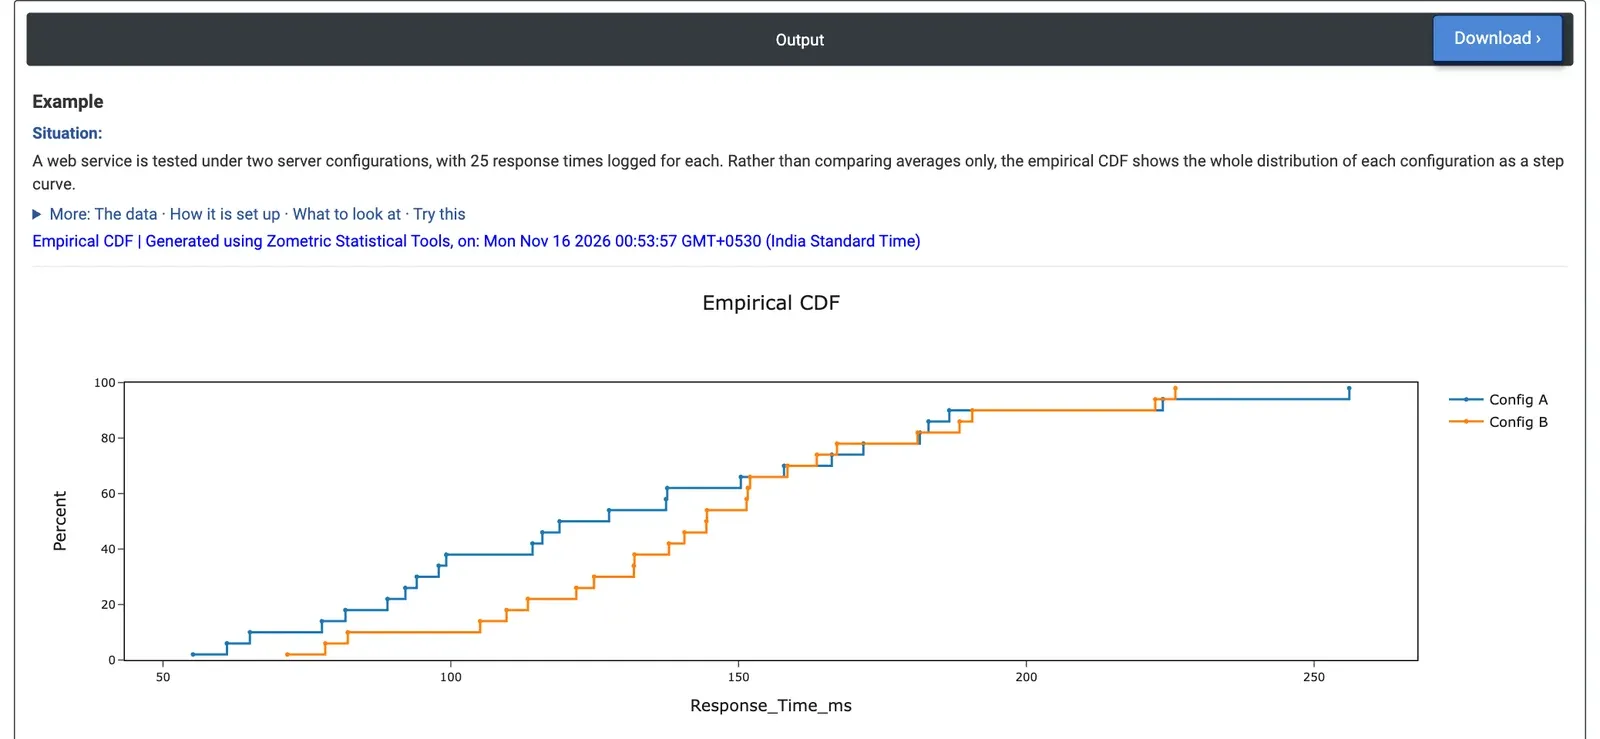
図2 — Config A(青)とConfig B(オレンジ)の応答時間の経験CDF。各25件のリクエスト。
計算例
ITチームが、2つのサーバー構成でWebサービスを試験し、それぞれ25件の応答時間(ms)を記録しました。平均値だけ見る(Aは129.7 ms、Bは143.6 ms)とAのほうが速そうですが、チームは、分布全体がどう比較されるか、特にユーザーが気づく遅いリクエストについて知りたいと考えています。変数としてResponse_Time_msを、By列としてConfigを選択し、当てはめる分布は指定しません。
50%の位置で横に読むと、中央値はConfig Aが118.9 ms、Config Bが144.4 msです。範囲の大部分でBの曲線は右側にあるため、典型的なリクエストはBのほうが遅くなります。150 msでは、Aのリクエストの64%が完了しているのに対し、Bは56%です。上端では曲線が交差します。Aの最も遅いリクエストは256.1 ms、Bの最も遅いリクエストは225.9 msで、Aのほうがばらつきが大きくなっています(標準偏差は51.8 ms対39.7 ms)。どちらの構成も、リクエストの92%が200 ms以内です。つまり、典型的なリクエストではBのほうが遅く、Aのほうが裾が長くなっています。どちらを選ぶかは、このサービスにとって中央値と最悪の場合のどちらが重要かによります。
オーバーレイにNormalを選択すると、各構成について、それぞれの25個の値に当てはめた破線の正規曲線が追加されます。Aは平均129.7 ms、標準偏差51.8 ms、Bは平均143.6 ms、標準偏差39.7 msです。階段状の曲線が破線の曲線から離れている部分では、その構成の応答時間は正規分布に従っていません。
よくある質問
経験CDFはどのように読みますか?
曲線は観測値ごとに100/n %ずつ上昇します。50%の位置で横に読むと各グループの中央値、90%の位置では90パーセンタイルがわかり、限界値から上に読むと、それを下回る値の割合がわかります。計算例では、応答時間の中央値はConfig Aが118.9 ms、Config Bが144.4 msでした。
グループを平均値ではなく経験CDFで比較するのはなぜですか?
平均値では、ばらつきや裾の違いが隠れてしまいます。計算例では、Config Aのほうが応答時間の平均値と中央値は小さい一方で、上端で曲線が交差しました。Aの最も遅いリクエストは256.1 ms、Bの最も遅いリクエストは225.9 msでした。CDFを見ると、典型的な場合と最悪の場合のどちらに違いがあるかがわかります。
データを当てはめた分布と照合するには、どうすればよいですか?
Normal、Lognormal、Weibull、Exponential、Logistic、極値分布など、重ねる分布を選択します。そのパラメーターは曲線ごとに別々に推定され、破線で描かれます。階段状の曲線が破線の曲線から離れている部分では、データはその分布に従っていません。Lognormal、Weibull、Exponential、Loglogisticには、正の値が必要です。
Zometric Statistical Softwareでグループを比較するには、どうすればよいですか?
1つの変数とBy (grouping) columnを選択すると、水準ごとに1本の階段状の曲線が得られます。複数の変数を選択すると曲線が重ねて表示されますが、その場合、By列は無視されます。プロットの前に、Data Optionsを使って、行番号または条件によって行を除外または対象として残せます。