
因子分析(Factor Analysis)
因子分析は、相関のある3つ以上の数値変数を、より少ない潜在因子で要約します。試験結果、工程の測定値、アンケート項目の背後にある特性を見つけるために使います。因子の数は変数の数より少なく、行数は変数の数より多くなければなりません。最尤法はおおよその多変量正規性を仮定します。出力には、因子負荷量、共通性、独自性、説明される分散、負荷量プロットが含まれます。
最終レビュー
重要なポイント
因子分析は、多数の測定変数間の相関を少数の潜在因子で説明します。多くの測定値やアンケート項目を、名前を付けやすい少数の因子で要約できます。
目的
Factor Analysisは、多数の測定変数間の相関を少数の潜在因子で説明します。一緒に動く変数は同じ因子に負荷がかかるため、長い測定値やアンケート項目のリストを、名前を付けて追跡しやすい少数の因子で要約できます。一連の試験結果、工程の測定値、アンケート項目の背後にある少数の潜在的な特性を見つけ、どの変数がほぼ単独の動きをするかを確認するために使います。
主な機能
- 3つ以上の数値変数から、指定した数の因子を抽出します。
- 2つの抽出法:Principal ComponentsとMaximum Likelihood。
- バリマックス回転により、各因子がより少数の変数に強く負荷されるようにして、名前を付けやすくします。
- 各変数の共通性と独自性を含むFactor Loadingsの表。
- 各因子で説明される分散の割合と、最初の2つの因子の負荷量プロット。
統計手法
選択した変数のいずれかに欠損値または非数値がある行は除外され、各変数は平均0、標準偏差1に標準化されるため、解析は相関行列に対して行われます。因子の数は変数の数より少なく、行数は変数の数より多くなければなりません。
Principal Components抽出では、相関行列を固有値と固有ベクトルに分解します。因子jの負荷量は、最大の固有値について、j番目の固有ベクトルにその固有値の平方根を掛けたものです。Maximum Likelihood抽出では、共通因子モデル(標準化した各変数 = 負荷量 × 因子 + 固有の誤差)を反復アルゴリズムによる最尤法で当てはめ、Maximum iterations(デフォルト1000)に達するか、変化がConvergence tolerance(デフォルト0.01)を下回った時点で停止します。最尤法は、変数がおおよそ多変量正規分布に従うことを仮定します。
バリマックス回転(Kaiserの方法)は、各因子内の負荷量の2乗の分散が最大になるように因子を回転させます。その結果、各変数は1つの因子に高く負荷され、他の因子にはほぼ0になります。回転によって、各変数がどれだけ説明されるかは変わりません。回転後、因子は説明する分散の順に並べられます。変数の共通性は、負荷量の2乗の合計で、因子によって説明される変数の分散の割合です。独自性は1 − 共通性です。因子によって説明される分散は、負荷量の2乗の合計で、変数の数に対する百分率として報告されます。因子の符号は任意です。すべての符号を反転させた因子も、同じ意味を持ちます。
入力フィールドとオプション
項目 | 説明 |
Variables | 3つ以上の数値列です。CtrlまたはCommandを押しながらクリックして、複数選択します。 |
Number of factors to extract | デフォルトは2です。変数の数より少なくする必要があります。 |
Method of extraction | Principal Components(デフォルト)またはMaximum Likelihoodです。 |
Type of rotation | Varimax(デフォルト)またはNoneです。回転は、因子が2つ以上の場合にのみ適用されます。 |
Maximum iterations | 任意で、Maximum Likelihood抽出でのみ使用されます。デフォルト(1000)を使う場合は空白のままにします。 |
Convergence tolerance | 任意で、Maximum Likelihood抽出でのみ使用されます。デフォルト(0.01)を使う場合は空白のままにします。 |
Title | 負荷量プロットに表示されるタイトルです。デフォルトはFactor Analysisです。 |
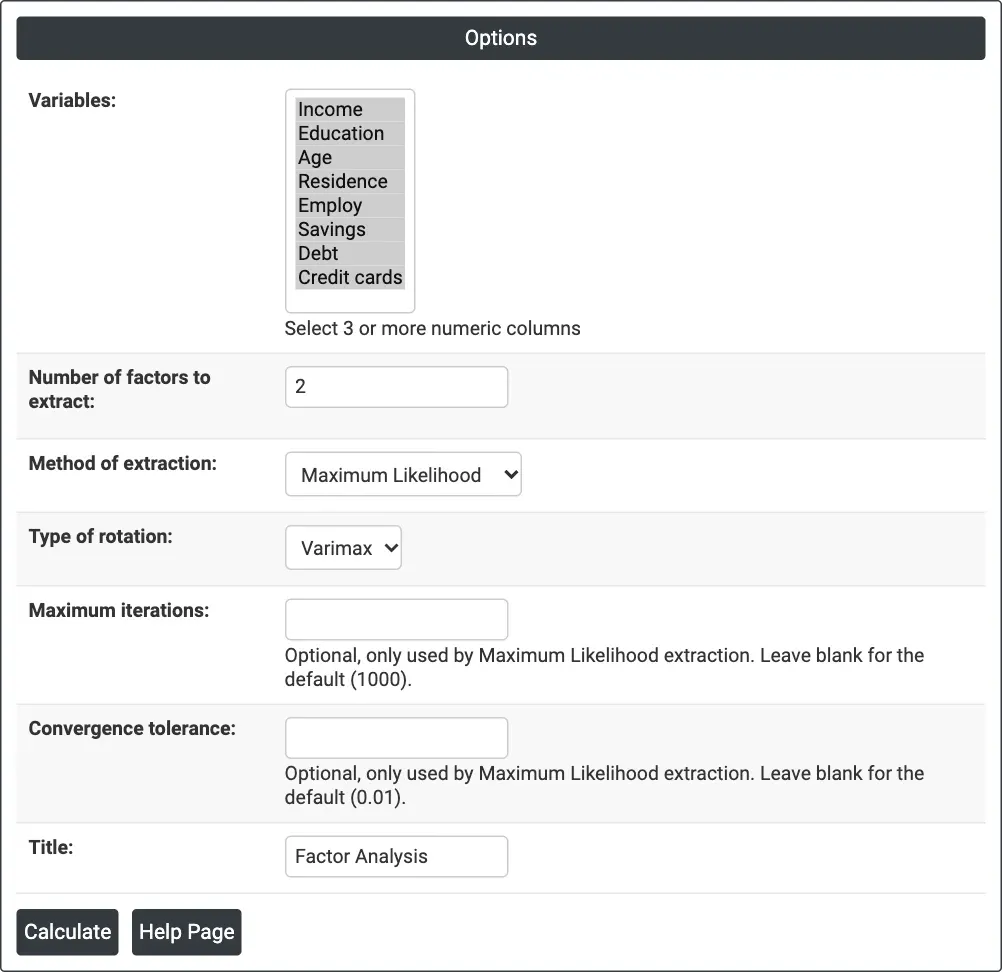
図1 — 例のオプション:融資申込者の8つの変数、2因子、Maximum Likelihood抽出、Varimax回転。
出力の説明
- Factor Loading Plot — 各変数を、原点からFactor1(x)とFactor2(y)への負荷量に向かう線として描きます。同じ方向を向く変数は、同じ因子に負荷されています。
- Method, rotation and variance explained — 手法と回転の名称(たとえばMaximum Likelihood、Varimax)、各因子で説明される全分散の割合と、その累積百分率。
- Factor Loadings — 各変数について、各因子への負荷量、Communality、Uniqueness。
- DownloadによるPDFエクスポート。
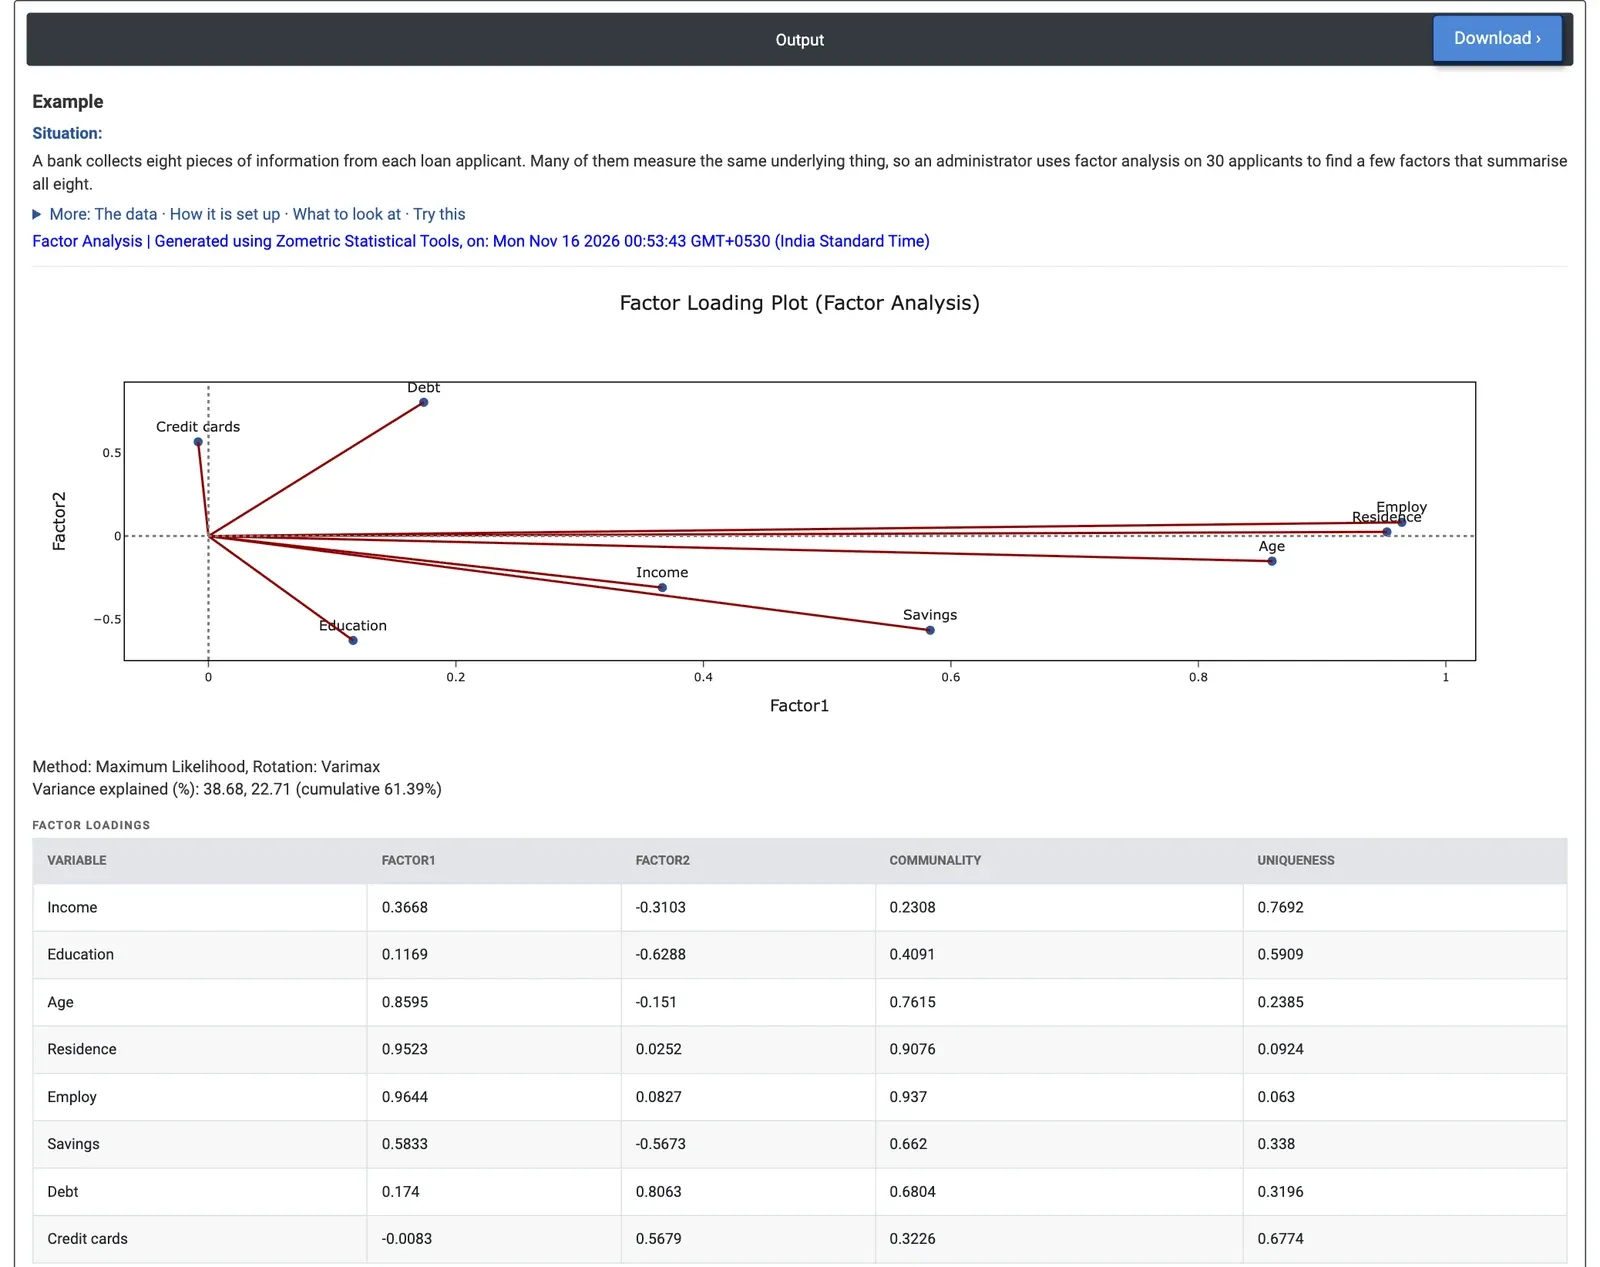
図2 — 融資申込者の8つの変数に対する回転後の2因子:安定性の因子(Employ、Residence、Age)と、借入の因子(Debt、Credit cardsが、Educationと対照的)で、分散の61.39%を説明しています。
計算例
ある銀行が、融資申込者ごとに8つの情報(収入、教育年数、年齢、現住所での居住年数(Residence)、現在の雇用主のもとでの勤続年数(Employ)、貯蓄、負債、クレジットカードの枚数)を収集しています。その多くは同じものを測定しているように見えます。与信管理者は、8つすべてを要約する少数の因子を求めています。30人の申込者を使い、エンジニアは8つの列をすべて選択し、Number of factors to extract = 2、Method of extraction = Maximum Likelihood、Type of rotation = Varimaxに設定します。
2つの因子は分散の38.68%と22.71%を説明し、合わせて61.39%になります。因子1は、Employ(0.9644)、Residence(0.9523)、Age(0.8595)に強く、Savings(0.5833)に中程度に負荷されており、安定性と経験の因子です。因子2は、Debt(0.8063)とCredit cards(0.5679)に負荷され、Education(−0.6288)とSavings(−0.5673)とは対照的で、借入の因子です。共通性は、2つの因子が各変数をどの程度よく説明するかを示しています。Employ(0.937)とResidence(0.9076)では高く、Income(0.2308)とCredit cards(0.3226)では低くなっています。
銀行にとって、2つの因子は申込者の安定性と借入をよく説明しますが、収入はほぼ単独の動きをします。3因子では、説明される分散は72.93%(36.67%、20.63%、15.63%)に上昇し、3番目の因子は主にIncome(−0.8835)とEducation(−0.5491)です。Incomeの共通性は0.8545に上昇します。これは、同じデータに対する変数のクラスター分析(Cluster Variables)の結果と一致しており、IncomeはEducationと、安定性の変数は互いに、DebtはCredit cardsと、それぞれグループ化されます。回転なしでは、ここでは負荷量はわずかしか変わりません(因子1:Employ 0.9666、Residence 0.9526)。回転前の解がすでにかなり単純であるためです。
よくある質問
因子分析は何に使いますか?
因子分析は、多数の測定変数間の相関を少数の潜在因子で説明します。一緒に動く変数は同じ因子に負荷がかかるため、長い試験結果、工程の測定値、アンケート項目のリストを少数の因子で要約でき、どの変数がほぼ単独の動きをするかも確認できます。
Principal ComponentsとMaximum Likelihoodの抽出の違いは何ですか?
Principal Components抽出では、相関行列を固有値と固有ベクトルに分解し、各因子の負荷量は、固有ベクトルにその固有値の平方根を掛けたものです。Maximum Likelihood抽出は、反復アルゴリズムで共通因子モデルを当てはめ、変数がおおよそ多変量正規分布に従うことを仮定します。
因子分析のバリマックス回転は何をしますか?
バリマックス回転は、各変数が1つの因子に高く負荷され、他の因子にはほぼ0になるように因子を回転させるため、因子に名前を付けやすくなります。回転によって、各変数がどれだけ説明されるかは変わりません。回転後、因子は説明する分散の順に並べられます。回転は、因子が2つ以上の場合にのみ適用されます。
因子分析の共通性と独自性はどのように解釈しますか?
変数の共通性は、負荷量の2乗の合計で、因子によって説明される変数の分散の割合です。独自性は1から共通性を引いたものです。融資申込者の例では、Employの共通性は0.937だったのに対し、Incomeは0.2308にとどまり、2因子では収入がほぼ単独の動きをしていることを示しました。