
混合効果モデルの当てはめ(Fit Mixed Effects Model)
Fit Mixed Effects Modelは、固定のカテゴリー因子と共変量を検定しつつ、ロット、作業者、日などのランダム因子の分散成分を推定します。ランダム因子を無視すると固定因子の検定が楽観的になりすぎる場合に使用します。ランダム因子には少なくとも3水準が必要です。出力には、分散成分、Satterthwaite自由度によるF検定、係数、AICcとBICを含むモデルの要約が含まれます。
最終レビュー
重要なポイント
混合効果モデルは、水準を比較する固定因子と、母集団から抽出されたランダム因子に依存する応答を分析し、固定因子を検定するとともにランダム因子の分散を推定します。
目的
Fit Mixed Effects Modelは、2種類の因子に依存する応答を分析します。1つは、特定の水準を比較したい固定因子(2台の機械、3社のサプライヤー、新旧の方法)、もう1つは、水準がより大きな母集団から抽出された標本であるランダム因子(ロット、サンプル、作業者、日)です。固定因子を検定し、各ランダム因子が加える分散がどれだけあるかを推定します。ランダム因子を無視すると固定因子の検定が楽観的になりすぎる場合、たとえばすべての条件で同じロットや部品を測定する場合に使用します。
主な機能
- 1つ以上の固定のカテゴリー因子と連続の共変量、および1つ以上のランダム因子。
- 各ランダム因子と誤差の分散成分。全体に占める割合(%)、標準誤差、Z検定、信頼区間を含みます。
- Satterthwaite法による分母の自由度を用いた、固定効果のF検定。
- Satterthwaite自由度による係数、t検定、信頼区間。
- S、R-sq、R-sq(adj)、AICc、BIC、−2対数尤度を含むモデルの要約。
- 制限付き最尤法(REML)または最尤法(ML)による推定。
- Data Options:分析の前に行を絞り込みます。
統計的手法
モデルは y = Xβ + Σ Zᵢuᵢ + ε で、Xβは固定因子(総和ゼロの −1/0/+1 のコーディング)と共変量を表し、各ランダム因子iは分散σᵢ²を持つ独立な効果uᵢを加え、誤差εは分散σ²を持ちます。ランダム因子は独立な分散成分です(交互作用は当てはめません)。分散は、固定効果が使う自由度を考慮し、ほぼ不偏な分散成分を与えるREML(既定)で推定するか、固定効果の異なるモデルをAICcまたはBICで比較するために必要なMLで推定します。欠測値のある行は除かれます。すべてのランダム因子には少なくとも3水準が必要です。
分散の推定値が与えられると、固定係数は一般化最小二乗推定値になります。各固定項は、分母の自由度がSatterthwaite近似から得られるF統計量で検定され、各係数はSatterthwaite自由度のt検定で検定されます。分散成分には、Fisher情報量から求めた標準誤差、その成分がゼロであるという片側検定 Z = Var / SE Var、対数スケールで計算される信頼区間(そのため負にはなりません)が与えられます。ランダム因子の水準が少ない場合、このZ検定の検出力は低く、区間は広くなります。
R-sqは、条件付きの当てはめ(固定効果と予測されたランダム効果)を全体の変動と比較します。Sは誤差分散の平方根です。AICcとBICは、よいモデルほど小さくなります。REMLでは、固定効果が同じモデルどうしのみを比較します。
入力項目とオプション
項目 | 説明 |
Response (Y) | 数値の応答列。必須。 |
Fixed factors (categorical) | 特定の水準そのものに関心がある列を1つ以上。必須。 |
Random factors (categorical) | 水準がより大きな母集団からの無作為標本である列を1つ以上(例:Field、Batch、Operator)。独立な分散成分としてモデル化されます。必須。 |
Covariates (continuous) | 任意の数値列。固定の主効果としてのみ入力されます。 |
Confidence level | 既定値は95。 |
Estimation method | Restricted maximum likelihood (REML)(既定)、またはMaximum likelihood (ML)。 |
Data Options: Subset (optional) | Exclude matching rows(既定)またはInclude only matching rows。行番号や条件で指定します。 |
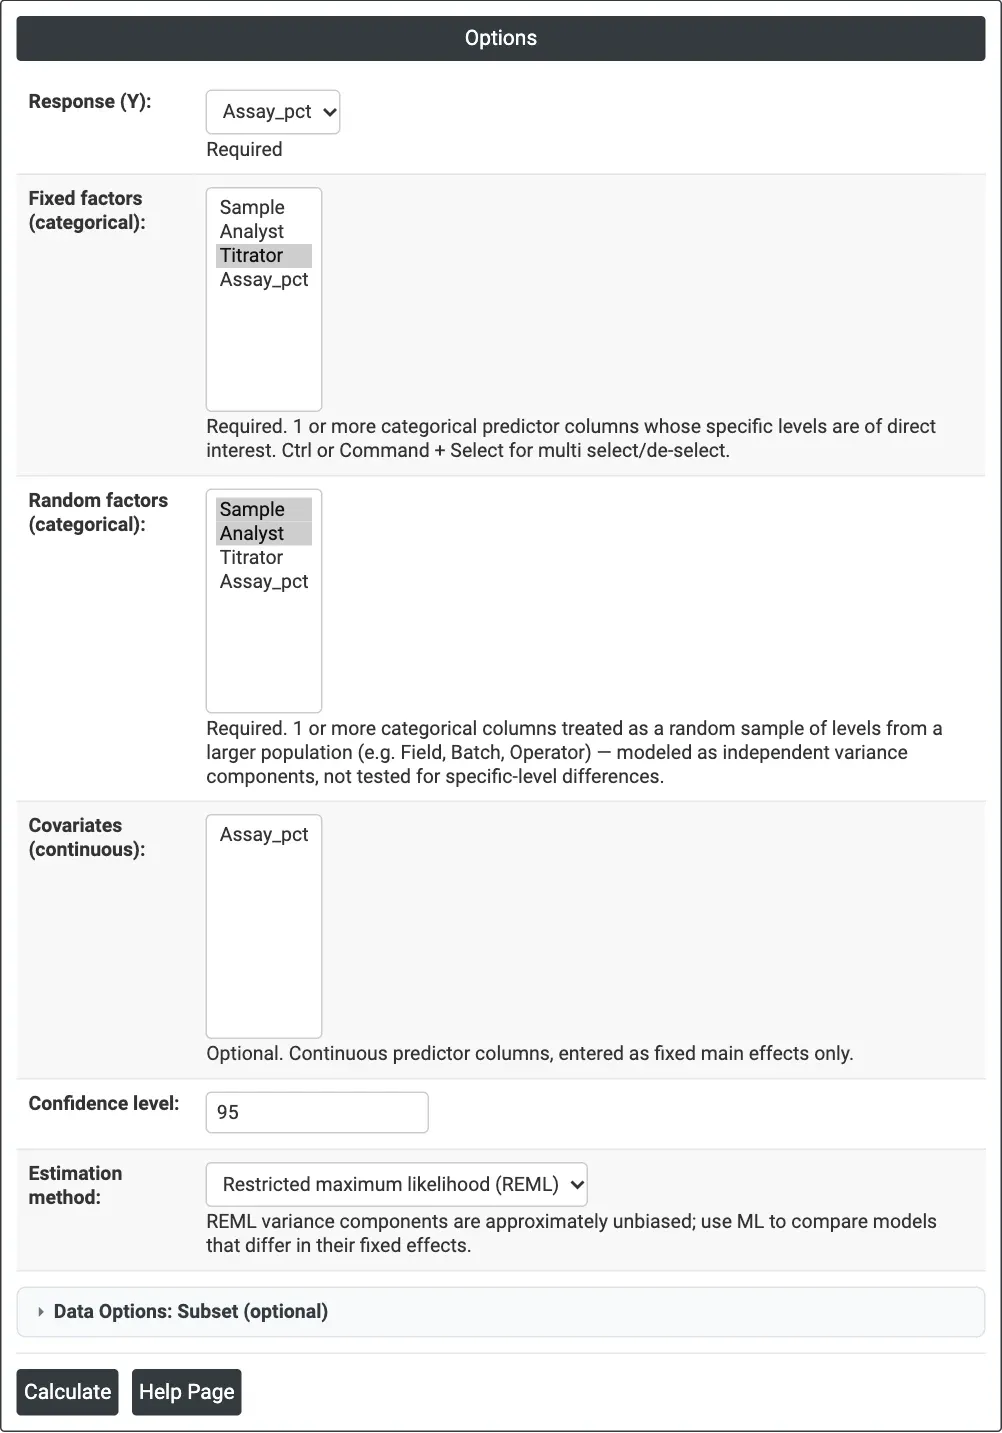
Figure 1 — 滴定装置の例のオプション:応答にAssay_pct、固定因子にTitrator、ランダム因子にSampleとAnalyst、REML。
出力の説明
- Method — 分散の推定方法と、固定効果の自由度の方法。
- Variance Components — 各ランダム因子、誤差、合計のVar、% of Total、SE Var、Z-Value、P-Value、信頼区間。
- Tests of Fixed Effects — 各固定因子と共変量のDF Num、DF Den、F-Value、P-Value。
- Model Summary — S、R-sq、R-sq(adj)、AICc、BIC、−2対数尤度。
- Coefficients — Coef、SE Coef、DF、T-Value、P-Value、信頼区間。
- 最適化が完全には収束しなかった場合は、警告が表示されます。
- DownloadによるPDFエクスポート。
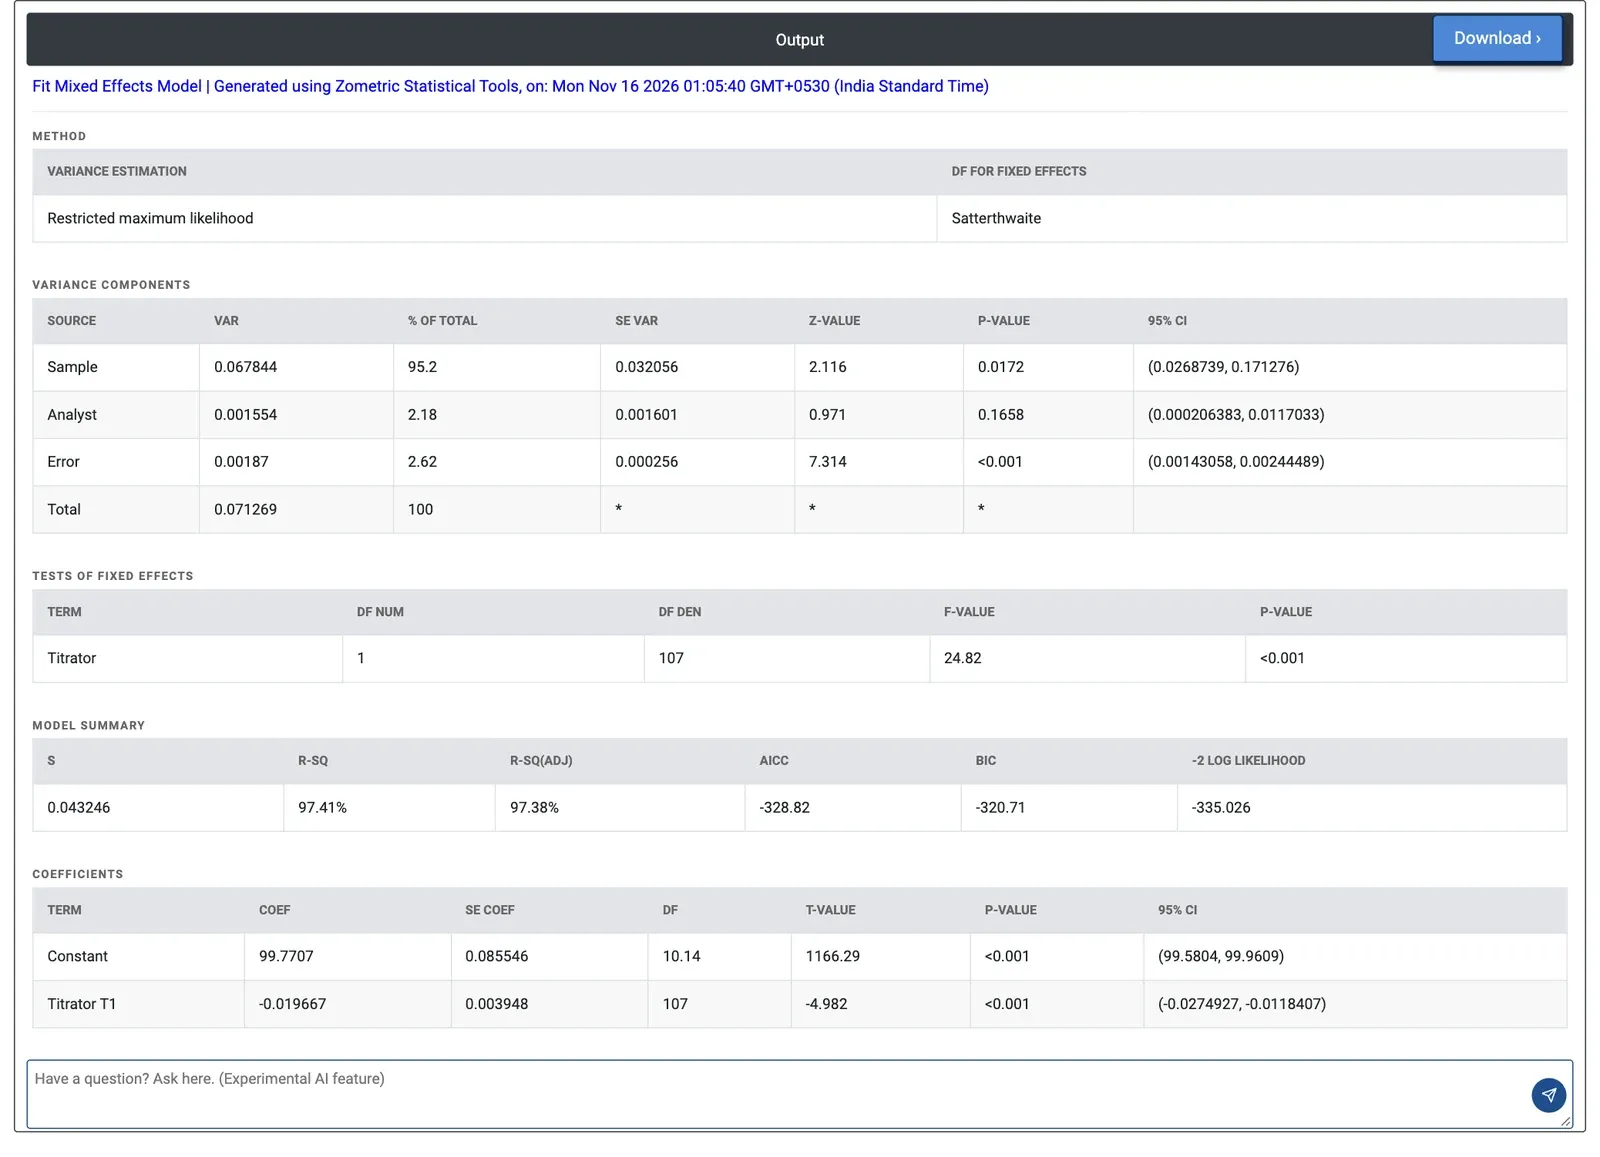
Figure 2 — 分析結果の混合モデル:サンプルが分散の95.2%を占め、2台の滴定装置には差があります(F = 24.82、p < 0.001)。
計算例
ソーダ灰の試験所が、2台の自動滴定装置T1とT2で製品の純度(Assay_pct)を測定します。3人の分析者が、10個のサンプルをそれぞれ両方の滴定装置で2回ずつ測定し、結果は120個です。知りたいのは、2台の滴定装置が同じ結果を与えるかどうかです。滴定装置は試験所が所有する2台の機器なので、Titratorは固定因子です。サンプルと分析者は、多数ありうるサンプルと分析者を代表しているため、ランダム因子です。試験所は、応答にAssay_pct、固定因子にTitrator、ランダム因子にSampleとAnalystを入力し、REMLを使用します。Load Exampleを使うと、これらのデータ(soda-ash-assay-expanded-grr。Gage R&R試験(拡張)の例と同じ試験)とこれらの設定が入力されます。
分散成分から、サンプルそのものの違いが最も大きいことがわかります:0.0678(全体の95.2%、標準偏差は約0.26パーセントポイント)。分析者の成分は小さく0.00155(2.18%)で、ゼロとの有意な差はありません(p = 0.1658)。誤差、つまり1回の結果の繰返し性は0.00187(標準偏差0.043)です。
Titratorは有意です:自由度1と107でF = 24.82、p < 0.001。総和ゼロのコーディングでのT1の係数は −0.0197であり、T2はT1より約0.039パーセントポイント高く読み取られます。これは繰返し性の標準偏差のほぼ1つ分です。各サンプルを両方の滴定装置で測定しているため、サンプル間のばらつきがこの差を隠すことはありません。試験所は、両方の滴定装置の校正を基準標準に照らして確認することにします。
よくある質問
固定因子とランダム因子の違いは何ですか?
固定因子は、2台の機械、3社のサプライヤー、新旧の方法のように、比較したい特定の水準を持ちます。ランダム因子は、ロット、サンプル、作業者、日のように、水準がより大きな母集団から抽出された標本です。混合効果モデルは、固定因子を検定し、各ランダム因子が加える分散がどれだけあるかを推定します。
混合効果モデルはどのような場合に使用しますか?
ランダム因子を無視すると固定因子の検定が楽観的になりすぎる場合、たとえばすべての条件で同じロットや部品を測定する場合に、混合効果モデルを使用します。滴定装置の例では、10個のサンプルを両方の滴定装置で測定したため、サンプル間のばらつきが滴定装置間の差を隠すことはありませんでした。
混合モデルの推定にはREMLとMLのどちらを使用すべきですか?
既定のREMLは、固定効果が使う自由度を考慮し、ほぼ不偏な分散成分を与えます。固定効果の異なるモデルをAICcまたはBICで比較するには、MLが必要です。REMLでは、AICcとBICは固定効果が同じモデルどうしのみを比較します。
分散成分の表はどのように解釈しますか?
各ランダム因子と誤差には、分散、全体に占める割合、標準誤差、その成分がゼロであるという片側Z検定、対数スケールで計算される信頼区間(そのため負にはなりません)があります。ランダム因子の水準が少ない場合、Z検定の検出力は低く、区間は広くなります。