
回帰モデルの当てはめ(Fit Regression Model)
回帰モデルの当てはめは、複数の連続およびカテゴリカルの予測変数を用いて、連続の応答に対する回帰式を当てはめます。予測、関係の分析、予報に使用します。応答がカテゴリカルの場合は、代わりにロジスティック回帰を使用します。代表性があり正確なデータを収集し、VIFで多重共線性を確認し、残差プロットで検証してください。検定にはAdjusted(Type III、既定)またはSequential(Type I)の平方和を使用し、信頼区間は既定で95%です。
最終レビュー
重要なポイント
回帰モデルの当てはめは、1つ以上の連続またはカテゴリカルの予測変数が連続の応答にどう影響するかを定量化する式を作成し、有意な変数の特定と結果の予測を可能にします。
このページの内容
回帰モデルの当てはめとは
回帰モデルの当てはめは、1つ以上の予測変数と連続の応答変数との関係を調べて定量化する統計ツールです。単一の予測変数しか扱えない直線モデルの当てはめ(Fit Line Model)とは異なり、連続とカテゴリカルの両方の複数の予測変数に対応しているため、実際のデータ分析により幅広く使用できます。
データを通る数式を作成し、予測変数が全体として応答にどう影響するかを最もよく表します。この式は、パターンの理解、有意な変数の特定、将来の結果の予測に利用できます。
かんたんな定義:複数の入力変数と1つの出力変数との間の最適な数理的関係を見つけ、傾向を理解して正確な予測を行えるようにするツールです。
回帰モデルの当てはめを使用する場面
当てはめた回帰モデルは通常、1つ以上の独立変数と従属変数との関係を分析する必要がある場合に使用します。独立変数の値に基づいて従属変数の挙動を予測し、理解するのに役立つツールです。
当てはめた回帰モデルが役立つ一般的な場面は次のとおりです。
- 予測モデリング:1つ以上の独立変数の値に基づいて従属変数の値を予測したい場合に、当てはめた回帰モデルが役立ちます。たとえば、価格、広告、顧客の属性などの要因から、製品の売上を予測する場合です。
- 関係の分析:従属変数と1つ以上の独立変数との関係を理解したい場合に、当てはめた回帰モデルが役立ちます。たとえば、収入と学歴の関係、運動習慣と健康状態の関係を理解する場合です。
- 予報:過去のデータに基づいて従属変数の将来の値を予報したい場合に、当てはめた回帰モデルが役立ちます。たとえば、過去の売上データや、経済指標、季節的な傾向などの他の変数から、将来の売上を予報する場合です。
- 予測変数は 連続、カテゴリカル、またはその両方の組み合わせにできます。
- 離散変数は、水準の数と分析の目的に応じて、連続またはカテゴリカルとして扱えます。
- 応答変数は 連続でなければなりません。
- カテゴリカルの応答は、モデルの仮定を満たさず、正確な予測を得られない可能性が高くなります。
一般に、当てはめた回帰モデルは、1つ以上の独立変数に基づいて従属変数の挙動を理解または予測する必要があるときは、いつでも役立ちます。
回帰モデルの当てはめを正しく使用するためのガイドライン
- 分析には、連続の応答変数 と、1つ以上の連続またはカテゴリカルの予測変数を使用します。応答がカテゴリカルまたは計数の場合は、代わりに適切なロジスティックモデルまたはポアソンモデルを適用してください。
- データが 対象母集団を正確に代表していることを確認してください。偏りのある、または不完全なサンプルは、信頼できない結果につながります。
- 必要な統計的精度を確保し、安定した回帰モデルを得るため、十分な数のデータ点 を収集します。
- すべての変数を できるだけ正確かつ精密に測定してください。測定誤差は、当てはめたモデルの品質に直接影響します。
- 残差の時間的な傾向やパターンを検出しやすくするため、データは 収集した順に 記録します。
- 予測変数間の 多重共線性 を確認してください。深刻な場合、どの予測変数が本当に有意かを特定することが難しくなります。深刻さを評価するには、Coefficientsの表の 分散拡大係数(VIF)を使用します。
- 当てはめた後は、残差プロット、診断統計量、モデルの要約統計量を用いてモデルを検証してください。当てはまりの悪いモデルは、誤解を招く結論を導くことがあります。
代替手法:回帰モデルの当てはめを使用すべきでない場合
- 連続の予測変数と連続の応答との関係を可視化するには、近似直線プロットを使用します。
- 2つのカテゴリを持つ応答変数には、二項ロジスティックモデルの当てはめ(Fit Binary Logistic Model)を使用します。
- 「まったく同意しない」から「強く同意する」のように、自然な順序を持つ3つ以上のカテゴリの応答変数には、順序ロジスティック回帰を使用します。
- 傷、へこみ、裂けのように、自然な順序を持たない3つ以上のカテゴリの応答変数には、名義ロジスティック回帰を使用します。
回帰モデルの当てはめの例
ある医学研究者が、さまざまな要因が脈拍数に与える影響を調べたいと考えています。研究者は、大学生91人の身長、体重、性別、喫煙の有無、活動水準、安静時の脈拍数を記録しました。次に、学生を無作為に2つのグループに分けます。最初のグループは1分間その場で走り、もう一方のグループは静止して立ちます。その後、研究者は学生の脈拍数を再び記録します。手順は次のとおりです。
- 必要なデータを収集します。
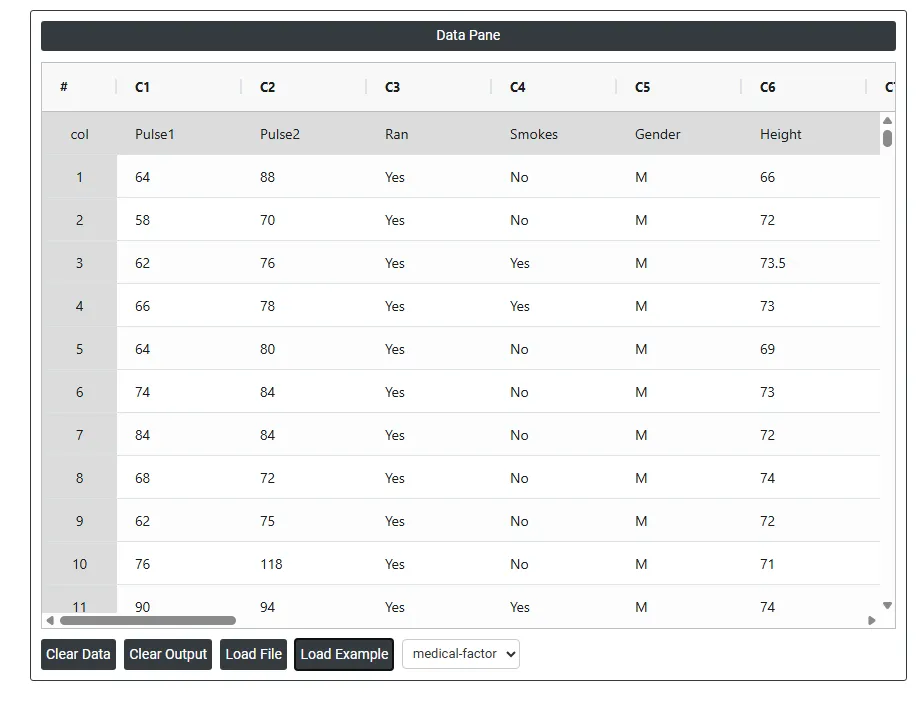
- 次に、Zometric Statistical Softwareでデータを分析します(https://statsai.zometric.com/)。
- 回帰モデルの当てはめを見つけるには、Statistical module> Regression>Fit Regression Modelを選択します。
- ツール内で、他の入力とともにデータを次のように入力します。
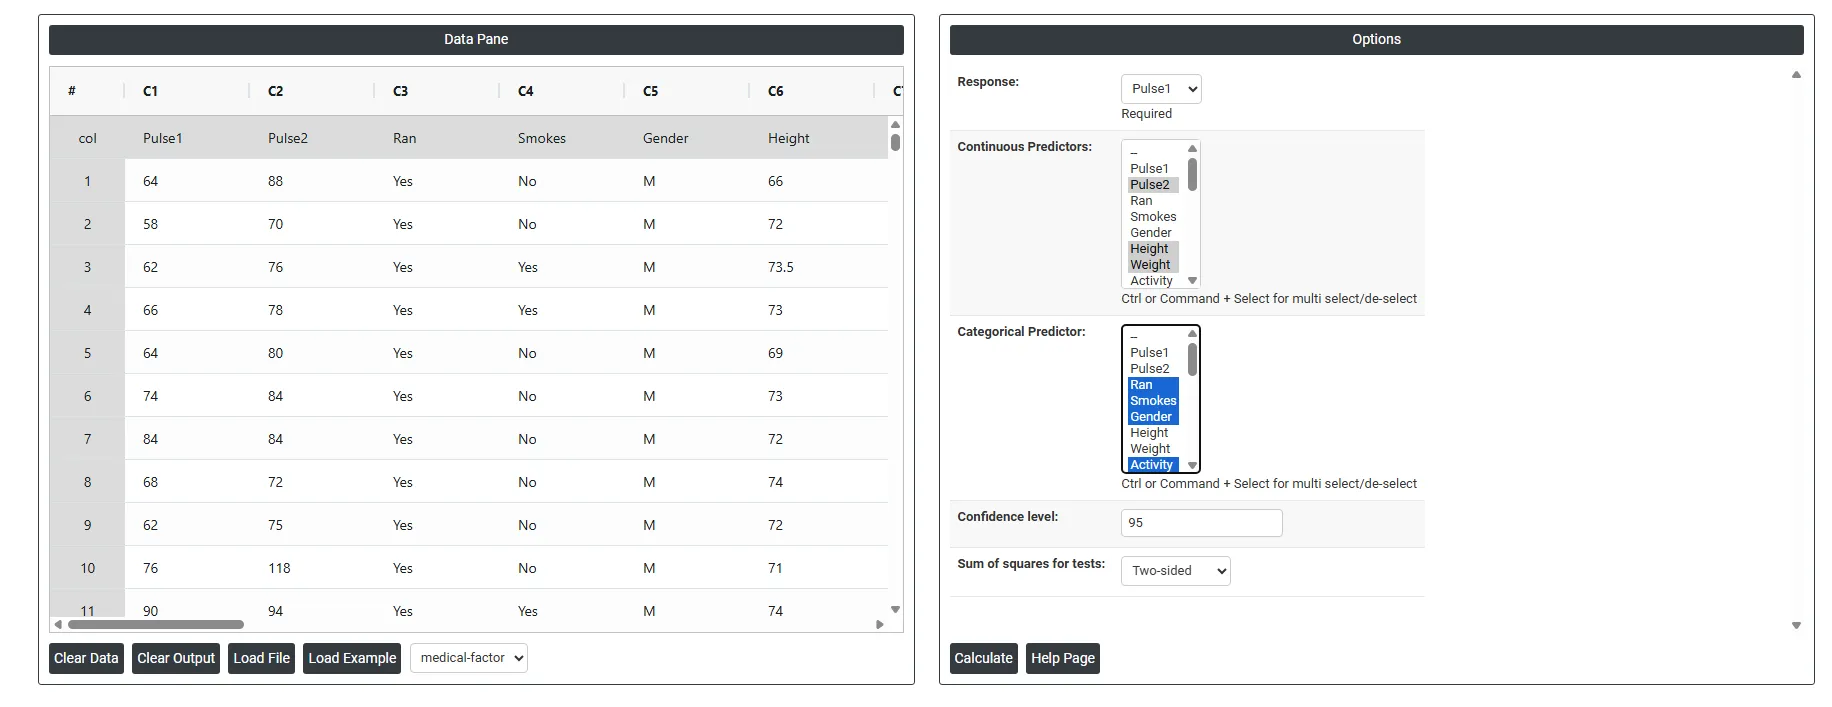
- 上記のツールを使用すると、次のような出力が得られます。
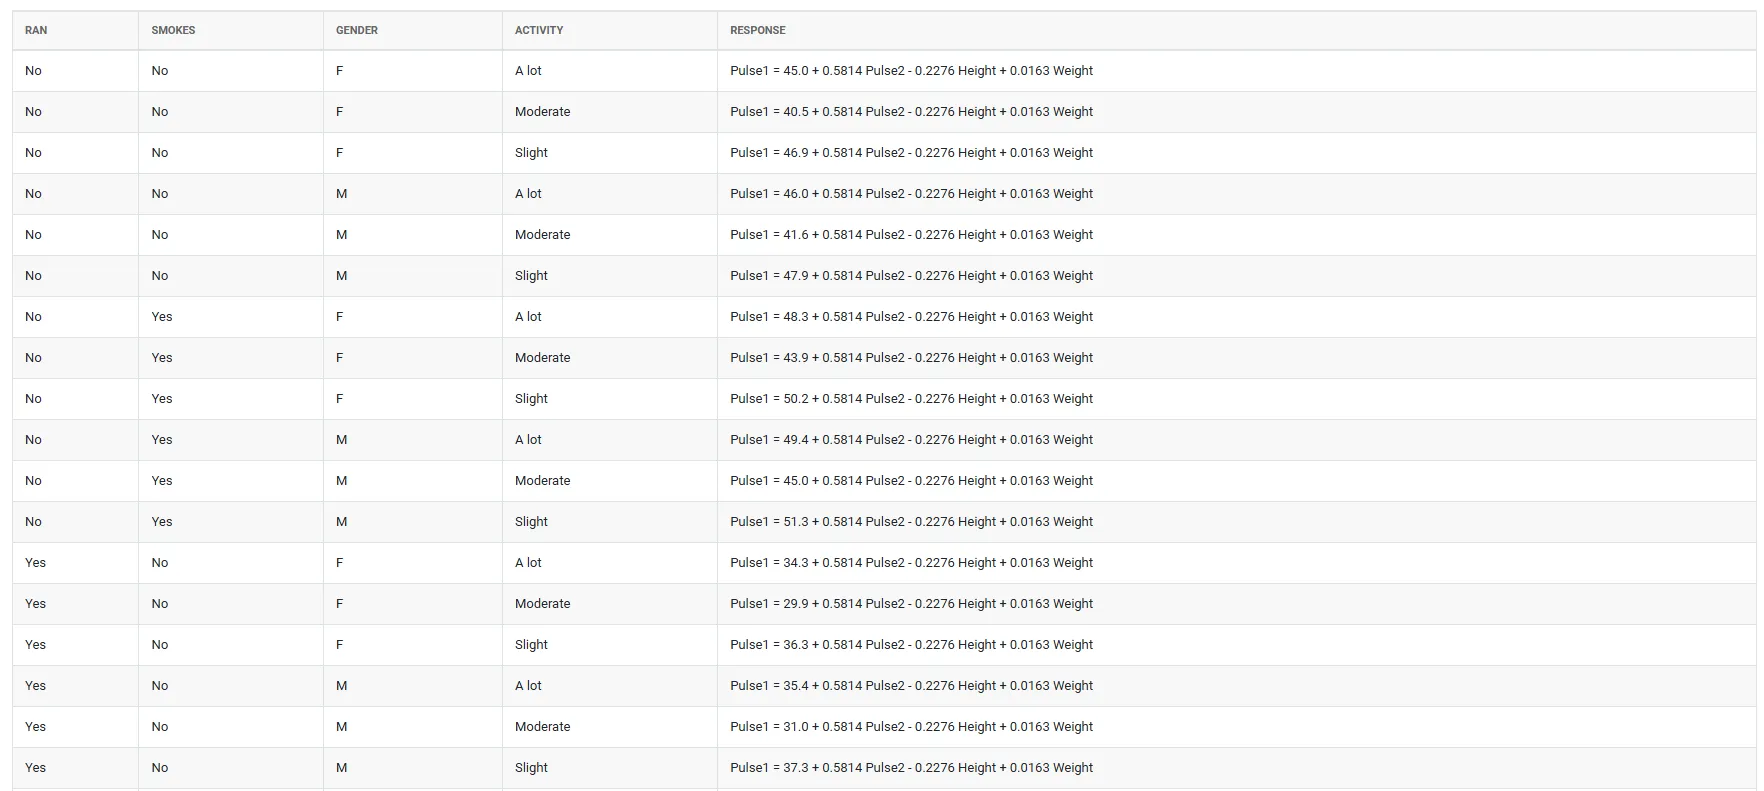
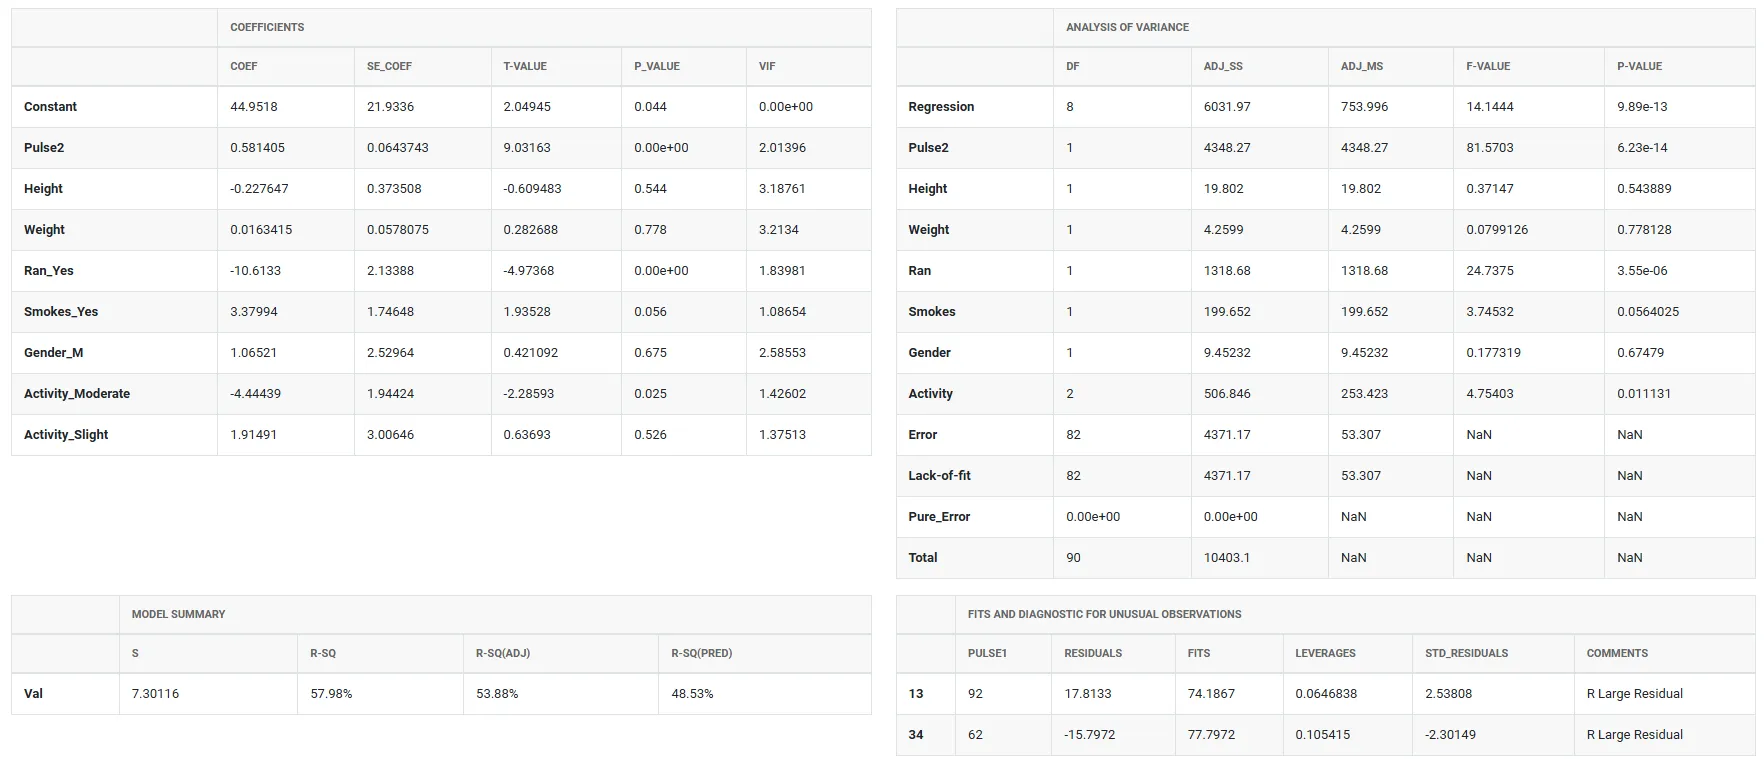
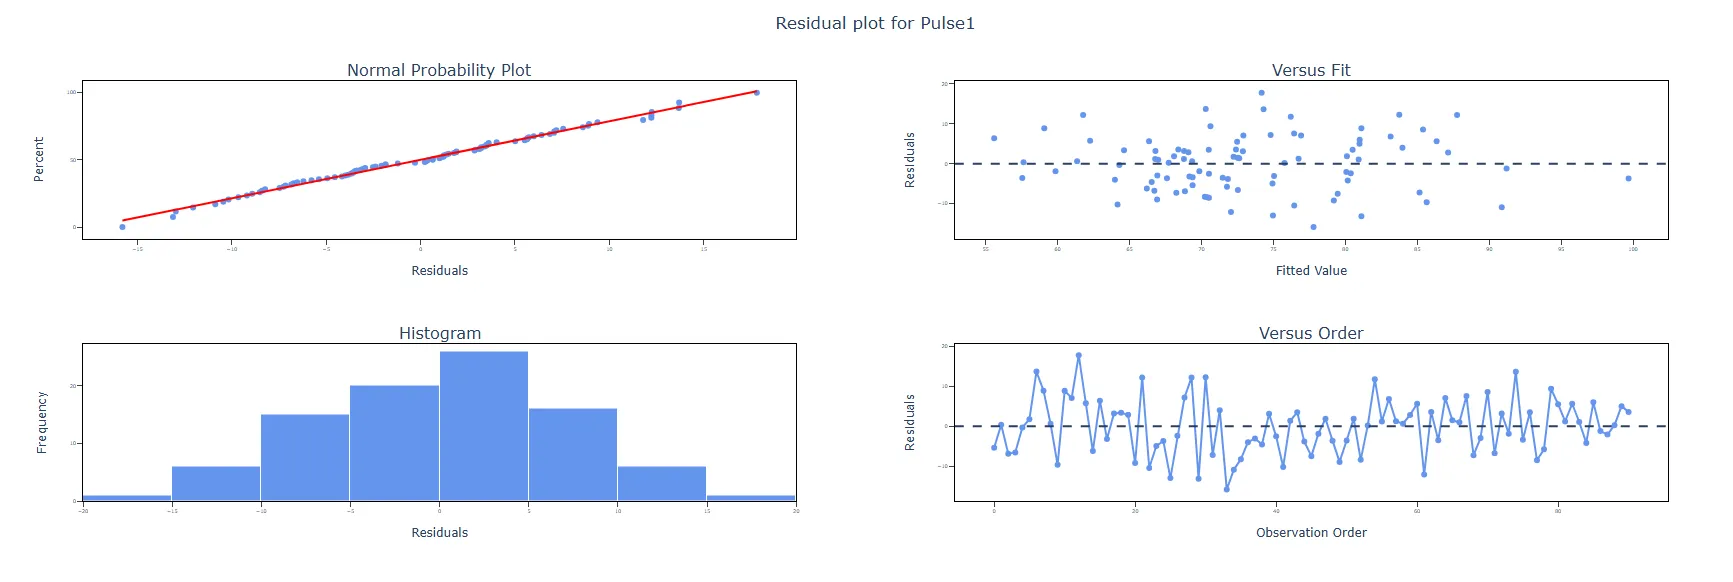
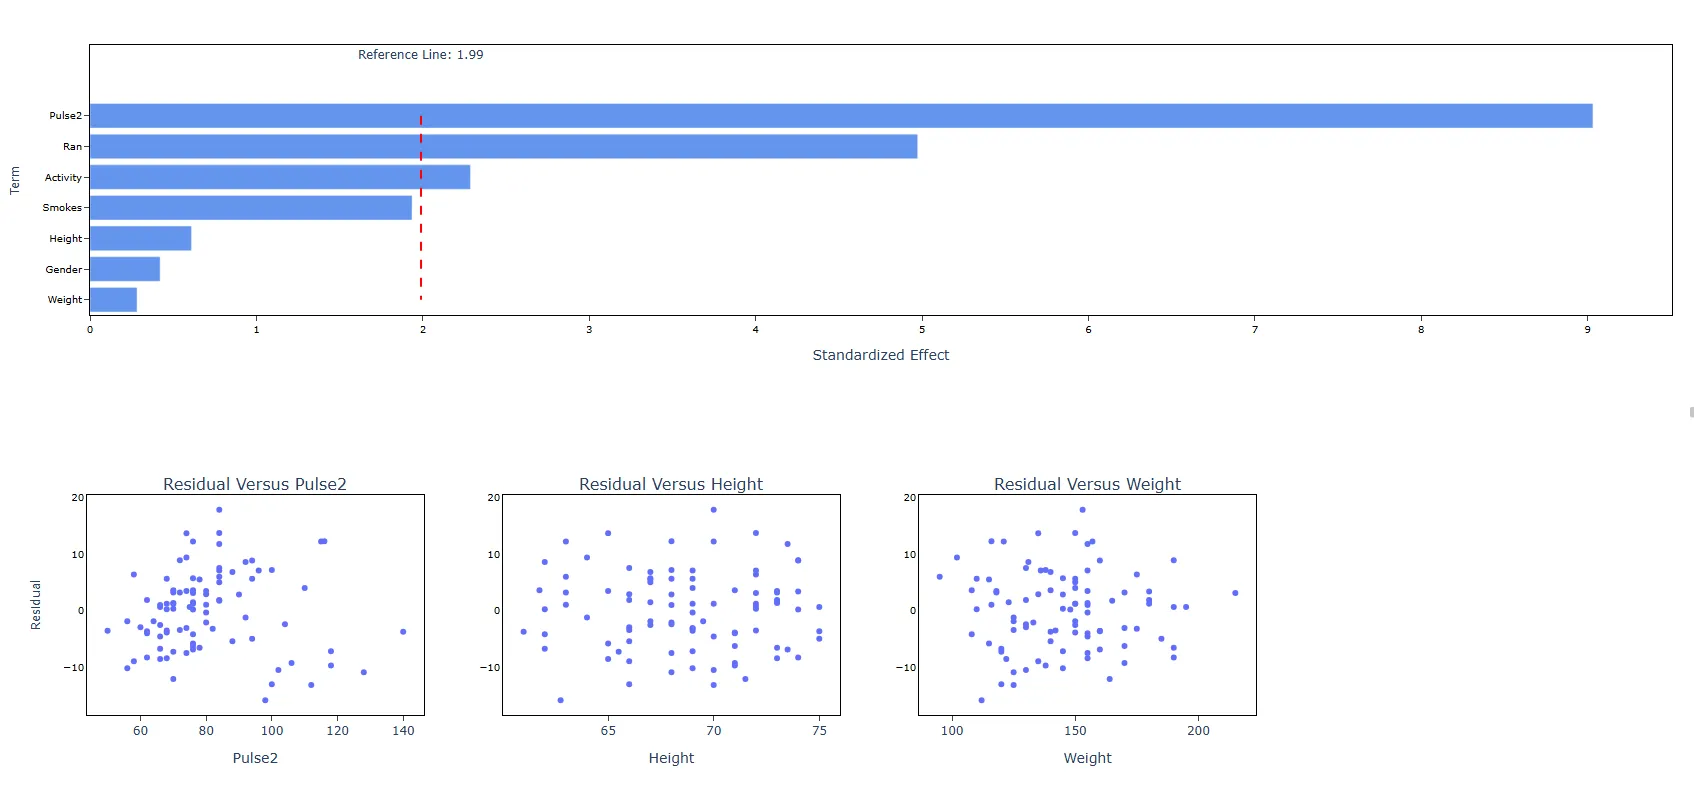
回帰モデルの当てはめの実行方法
手順は次のとおりです。
- 次のURLでZometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Regression > Fit Regression Modelを選択します。
- 次に、データを手入力するか、Excelシートからデータをコピー(Ctrl+C)して貼り付け(Ctrl+V)ます。または、Load Exampleオプションを使用すると、サンプルデータが読み込まれます。
- 次に、必須のオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
回帰モデルの当てはめのダッシュボードでは、ウィンドウが2つの部分に分かれています。
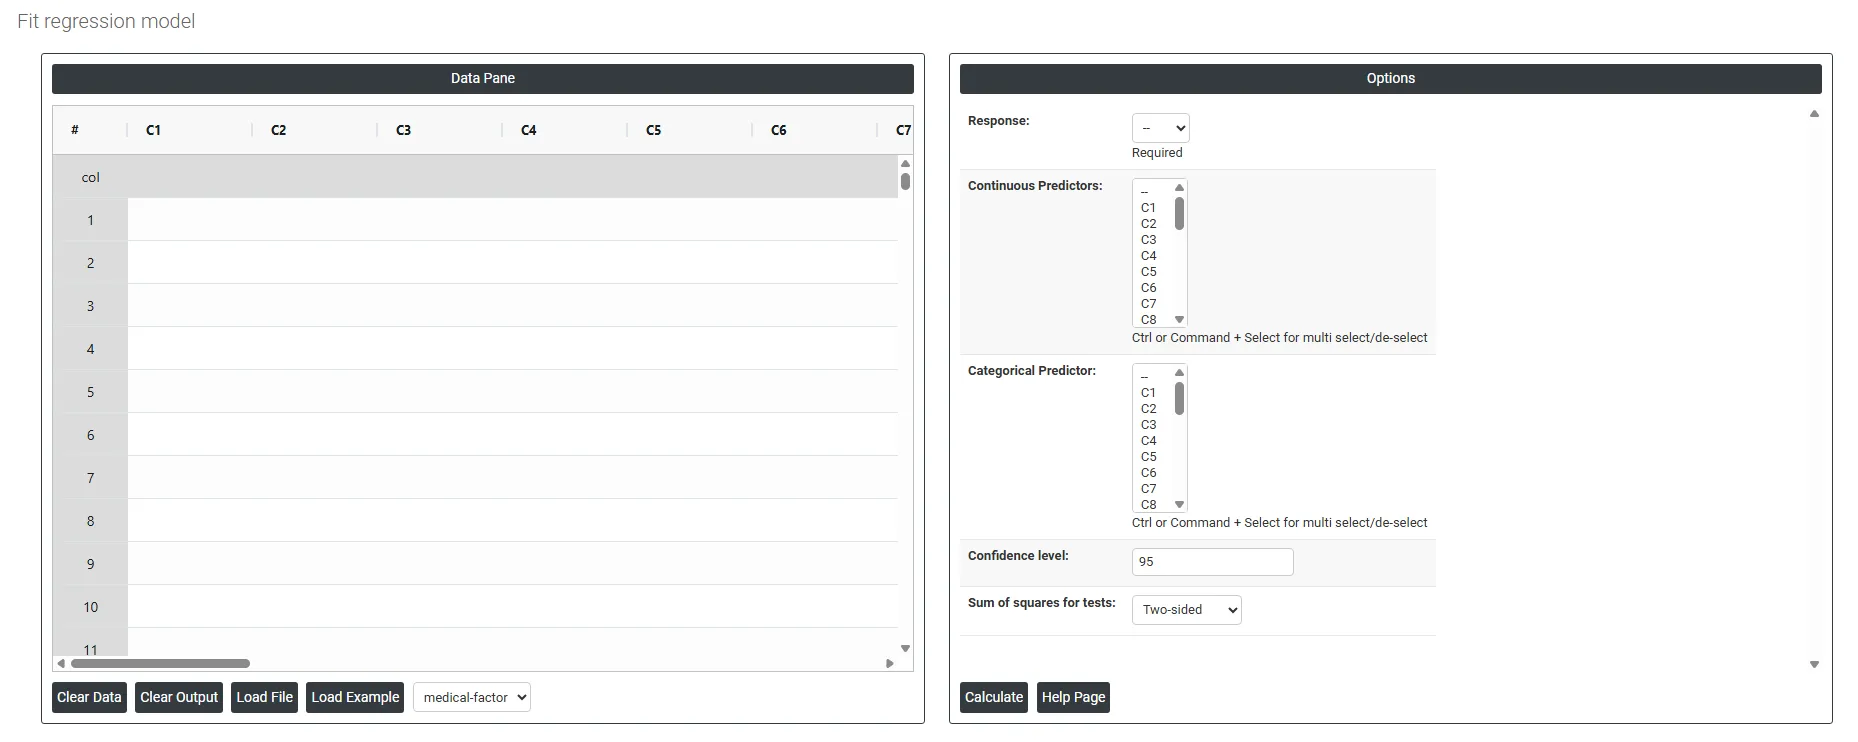
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループを構成します。データは手入力するか、Excelシートからすべてコピー(Ctrl+C)してここに貼り付け(Ctrl+V)ます。
Load example:サンプルデータが読み込まれます。
Load File:Excelデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Response: 回帰モデルにおける応答変数とは、独立変数、つまり予測変数によって予測または説明される変数です。従属変数、または目的変数とも呼ばれます。応答変数は、独立変数の値に基づいて、回帰モデルが推定または予測しようとする変数です。
- Continuous Predictors: 回帰モデルにおける連続の予測変数とは、連続的な値または数値をとる変数で、応答変数の変動を予測または説明するために使用されます。連続の予測変数は、一定の範囲または区間内の任意の値をとることができ、小数や分数を持つことができます。
- Categorical Predictors: 回帰分析におけるカテゴリカルの予測変数とは、限られた数の離散的な値(カテゴリーまたは水準と呼ばれることが多い)をとる変数です。これらの変数は、量的変数や数値変数に対して、質的変数または名義変数とも呼ばれます。
- Confidence level: 回帰分析における信頼水準とは、回帰モデルの推定係数の精度と確かさの尺度です。具体的には、信頼水準とは、繰り返し得られる標本から同じ方法で計算した信頼区間のうち、係数の真の母集団の値を含む区間の長期的な割合です。信頼水準は通常パーセントで表され、一般的な値は95%です。これは、異なるデータ標本を用いて同じ回帰モデルを繰り返し推定した場合、得られる信頼区間のおよそ95%が、その係数の真の値を含むことを意味します。
- Sum of squares for tests:
- Adjusted (Type III): 各項の平方和は、他のすべての項をすでに含むモデルにその項を追加したときの誤差平方和の減少量であり、その検定は項を入力する順序に依存しません。これが既定で、通常は推奨されます。Sequential (Type I): 各項の平方和は、入力した順序でモデルにその項を追加したときの誤差平方和の減少量であり、ある項の検定は、それより前に入力された項に依存します。
よくある質問
回帰モデルの当てはめとは何ですか?
回帰モデルの当てはめは、1つ以上の予測変数と連続の応答変数との関係を調べて定量化します。予測変数が全体として応答にどう影響するかを最もよく表す式を作成し、パターンの理解、有意な変数の特定、将来の結果の予測に利用できます。予測変数は、連続、カテゴリカル、またはその両方の組み合わせにできます。
回帰モデルの当てはめと直線モデルの当てはめ(Fit Line Model)の違いは何ですか?
直線モデルの当てはめは単一の予測変数しか扱えませんが、回帰モデルの当てはめは、連続とカテゴリカルの両方の複数の予測変数に対応しています。1つの連続の予測変数と連続の応答との関係を可視化するだけなら、近似直線プロットのほうが簡単です。複数の予測変数がある場合は、回帰モデルの当てはめを使用します。
回帰モデルの当てはめを使用すべきでないのはどのような場合ですか?
応答は連続でなければなりません。2つのカテゴリを持つ応答には、二項ロジスティックモデルの当てはめを使用します。「まったく同意しない」から「強く同意する」のように、自然な順序を持つ3つ以上のカテゴリには、順序ロジスティック回帰を使用します。傷、へこみ、裂けのように、自然な順序を持たない3つ以上のカテゴリには、名義ロジスティック回帰を使用します。
回帰モデルの多重共線性はどのように確認しますか?
Coefficientsの表の分散拡大係数(VIF)を使用して、予測変数間の多重共線性の深刻さを評価します。深刻な場合、どの予測変数が本当に有意かを特定することが難しくなります。当てはめた後は、残差プロット、診断統計量、モデルの要約統計量でもモデルを検証してください。当てはまりの悪いモデルは、誤解を招く結論を導くことがあるためです。