
完全ネスト型分散分析(Fully Nested ANOVA)
完全ネスト型分散分析は、2〜4つのネストされた変量因子と、誤差としての反復読み取りを用いて、階層の各水準からどれだけの変動が生じているかを推定します。下位水準の各単位は、1つの上位水準の単位にのみ属する必要があります。出力には、分散分析表(FとPは釣り合い型の計画のみ)、全体に占める割合(%)付きの分散成分、期待平均平方、モデルの要約、セルごとの平均が含まれます。
最終レビュー
重要なポイント
完全ネスト型分散分析は、測定値の変動を、バッチ、バッチ内のサンプル、反復読み取りなどの階層の各水準に分解し、変動の大部分がどこから生じているかを示します。
目的
完全ネスト型分散分析は、測定値の変動を、バッチ、各バッチ内のサンプル、各サンプル内の反復読み取りなどの階層の各水準に分解します。下位水準の各単位が1つの上位水準の単位にのみ属し(バッチ1のサンプル1は、バッチ2のサンプル1と同じ材料ではありません)、変動の大部分がどこから生じているかを知りたいときに使用します。それによって、工程、サンプリング、測定のどこに対処すべきかがわかります。
主な機能
- 最も外側(例:Batch)から最も内側(例:Sample)までの、2〜4つのネストされた因子。最も内側の因子内の反復読み取りが誤差を構成します。
- 複数の応答を選択した場合は、応答ごとに1回の分析を行います。
- 逐次平方和と、各水準をその下位の水準に対して行うF検定を含む分散分析表。
- 全体に占める割合(%)と標準偏差を含む分散成分。
- 期待平均平方、モデルの要約、およびすべてのセルの平均と標準偏差の表。
- 分散成分については不釣り合いなデータも扱えます。Data Optionsで行を絞り込めます。
統計手法
すべての因子は変量として扱われ、それぞれが直前の因子にネストされます。各因子の平方和は、上位水準の平均の周りでの、その因子のセル平均のばらつきです。誤差平方和は、最も内側のセル平均の周りでの、読み取り値のばらつきです。各因子の自由度は(その因子のセル数 − 上位のセル数)で、誤差の自由度は N − 最も内側のセル数です。
各因子は、その内側の次の因子に対して検定され、最も内側の因子は誤差に対して検定されます。F = MS(因子) / MS(次の内側の項) です。FとPは、釣り合い型の計画(すべてのセルで読み取り数が等しく、すべての単位で下位単位の数が等しい)に対してのみ示されます。不釣り合いなデータの場合は、ページにその旨が表示され、これらは省かれます。
分散成分は期待平均平方から求めます(分散分析法)。各因子の E(MS) は、σ²(誤差) に、その因子とその内側の因子の成分の倍数を加えたものです。これはExpected Mean Squaresの表に示され、(1)、(2)、… は入れ子の順に因子の番号を表し、最後の番号が誤差です。これらの式を最も内側の項から外側へ向かって解くと、各成分が得られます。負の推定値は、全体の0%として表示されます。% of Totalは、各成分が分散の合計に占める割合で、StDevはその平方根です。応答または因子の値が欠損している行は除外されます。
入力項目とオプション
項目 | 説明 |
Responses | 1つ以上の数値列。必須。応答ごとに1回の分析を行います。 |
Factor 1 (outermost) | 階層の最上位の水準(例:Batch)。必須。 |
Factor 2 (nested in Factor 1) | 必須。例:バッチ内のSample。 |
Factor 3 (nested in Factor 2) / Factor 4 (nested in Factor 3) | 任意の、より深い水準。Factor 4にはFactor 3が必要です。 |
Data Options: Subset (optional) | 行番号や条件によって、一致する行を除外(既定)するか、一致する行のみを含めます。 |
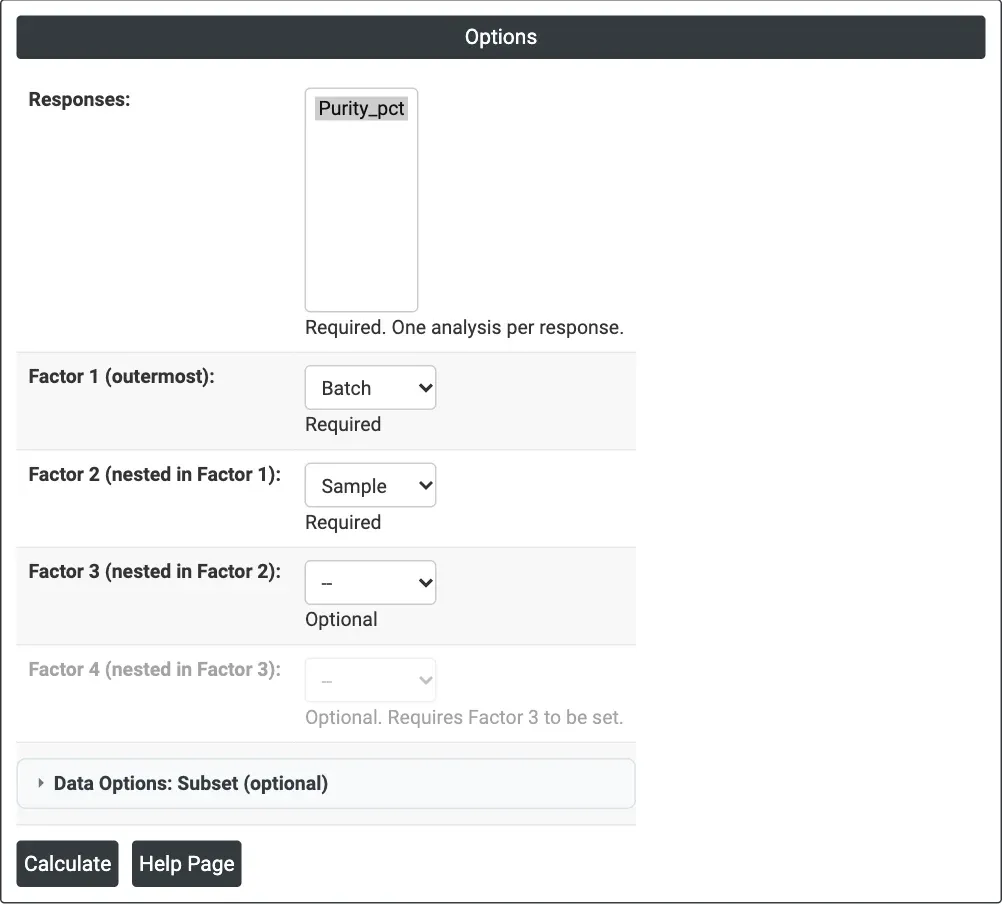
図1 — 純度の例のオプション:応答にPurity_pct、Factor 1にBatch、Factor 2にSample(Batchにネスト)を指定。
出力の説明
- Analysis of Variance — 各因子、誤差、全体のDF、SS、MS、F、P。
- Variance Components — 各因子、誤差、全体のVar Comp、% of Total、StDev。
- Expected Mean Squares — 各平均平方の、分散成分による構成。
- Model Summary — 要約統計量のS、R-sq、R-sq(adj)。
- Means — 最も内側の各セルのN、平均、標準偏差。
- DownloadによるPDFエクスポート。
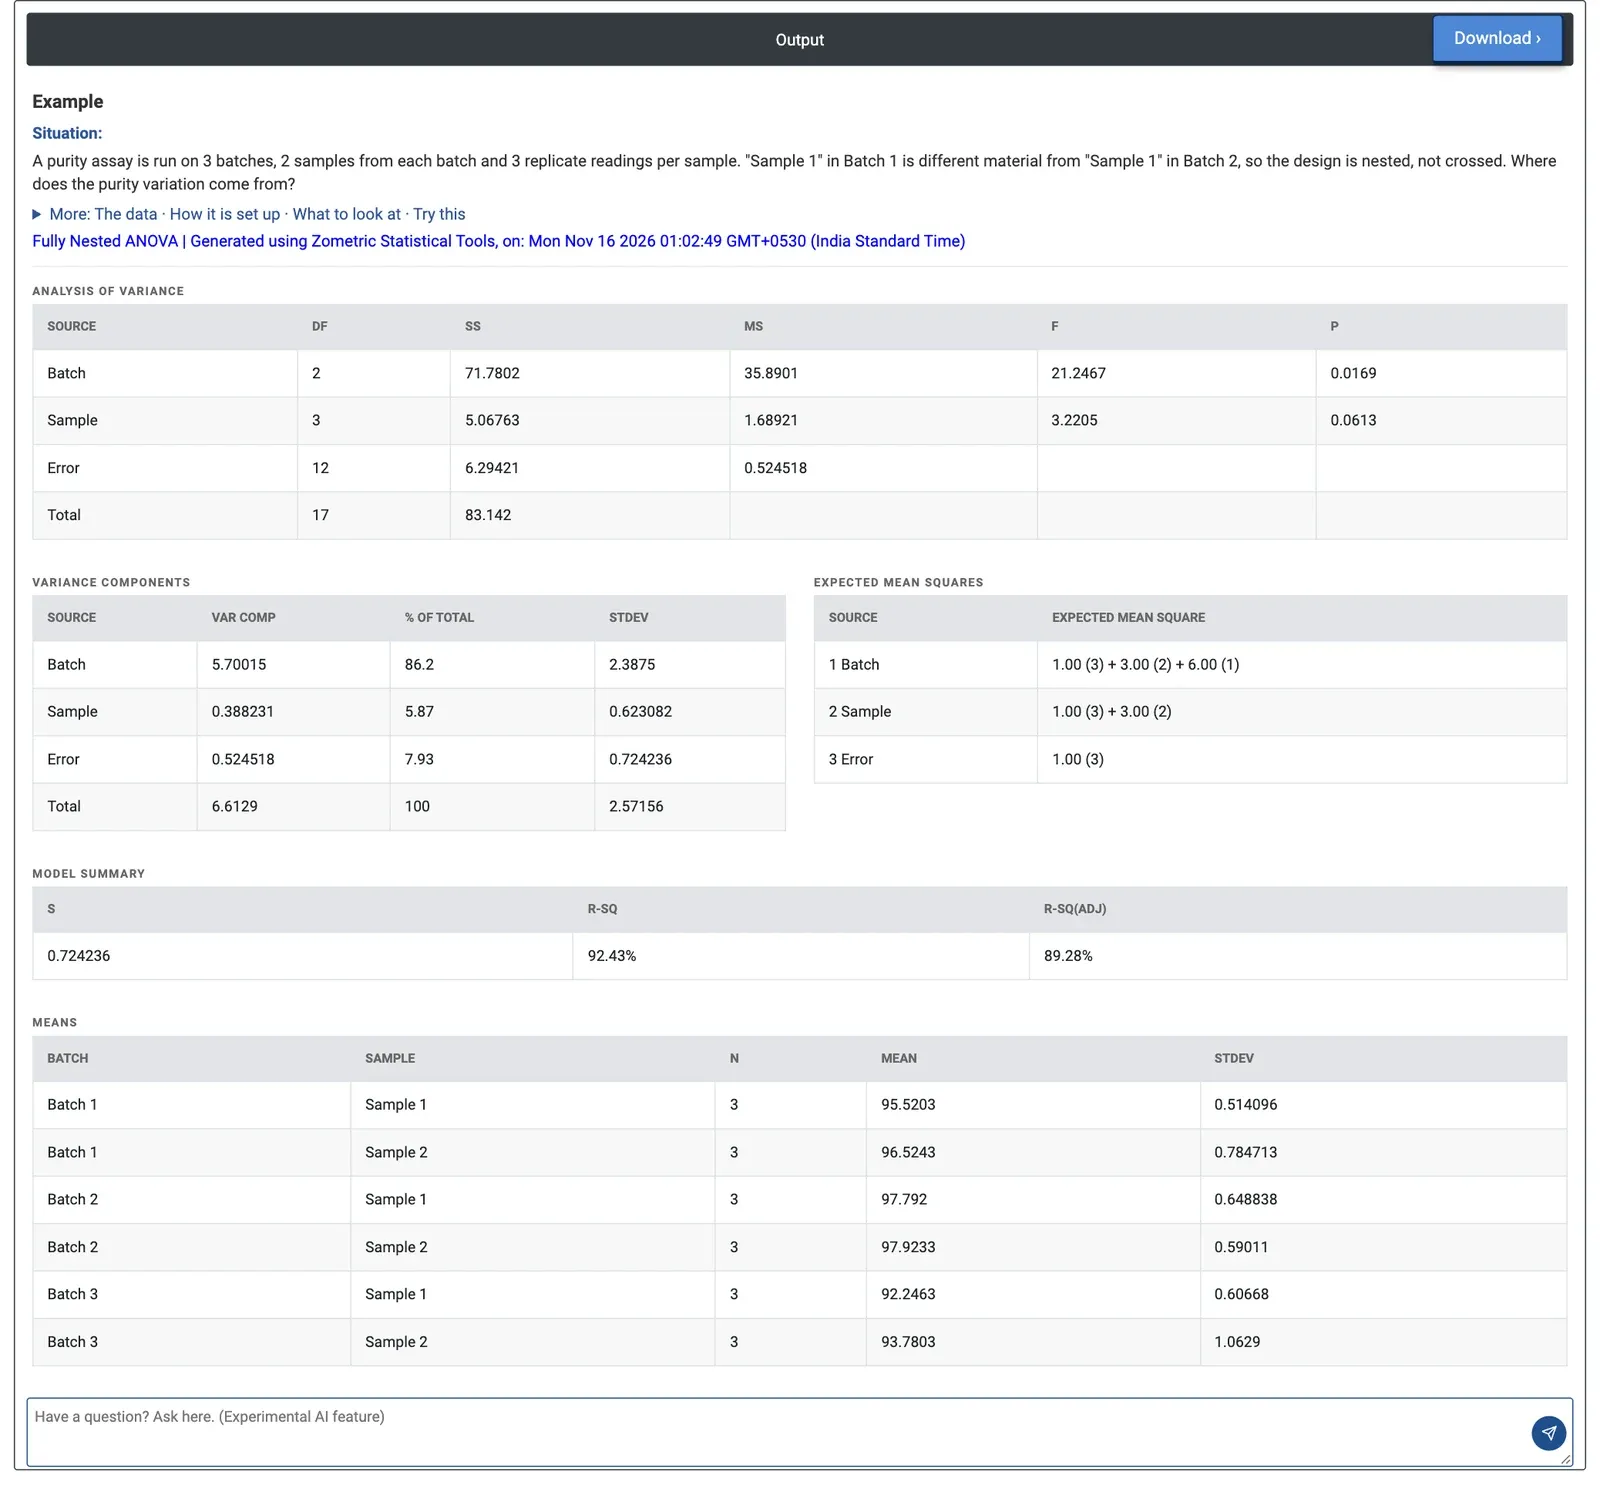
図2 — 純度の完全ネスト型分散分析:バッチ間の変動は全体の86.2%で、バッチ内のサンプルが5.87%、反復読み取りが7.93%を占めます。
計算例
純度の分析を3つのバッチで行い、各バッチから2つのサンプルを採取し、各サンプルで3回の反復読み取りを行います。結果は合計18件です。品質チームは、純度のばらつきが、バッチの工程、サンプリング、測定のどこから生じているのかを知りたいと考えています。応答にPurity_pct、Factor 1にBatch、Factor 2にSampleを選択します。反復読み取りが誤差を構成します。
バッチ間には差があります。自由度2と3でF = 21.25、p = 0.0169(Batchは、バッチ内のSampleに対して検定されます)。バッチ内のサンプルには、5%水準で有意な差はありません(F = 3.22、p = 0.0613)。Batch 3が最も低く(セル平均92.25%と93.78%)、Batch 2が最も高くなっています(97.79%と97.92%)。
分散成分から全体像が明確になります。バッチ間分散は5.70(全体の86.2%、標準偏差2.39パーセントポイント)、サンプル間は0.388(5.87%)、反復読み取りは0.525(7.93%、標準偏差0.72)です。サンプリングの改善や、より精密な分析法を使っても、ほとんど変わりません。チームは、バッチ間で何が異なるのかを調べるべきです。
よくある質問
完全ネスト型分散分析はどのような場合に使用しますか?
下位水準の各単位が1つの上位水準の単位にのみ属し、たとえばバッチ1のサンプル1がバッチ2のサンプル1と同じ材料ではなく、変動の大部分がどこから生じているかを知りたい場合に使用します。これにより、工程、サンプリング、測定のどこに対処すべきかがわかります。
完全ネスト型分散分析では、因子はどのように検定されますか?
すべての因子は変量として扱われ、それぞれが直前の因子にネストされます。各因子は、その内側の次の因子に対して検定され、最も内側の因子は誤差に対して検定されるため、F = MS(因子) / MS(次の内側の項) となります。FとPは釣り合い型の計画に対してのみ示されます。不釣り合いなデータでは省かれますが、分散成分は引き続き推定されます。
ネスト型分散分析の分散成分はどのように解釈しますか?
各成分の% of Totalは分散の合計に占める割合で、StDevはその平方根です。純度の例では、バッチ間分散が全体の86.2%、バッチ内のサンプルが5.87%、反復読み取りが7.93%でした。そのため、サンプリングの改善やより精密な分析法ではほとんど変わらず、チームはバッチ間の違いを調べるべきです。
完全ネスト型分散分析には、いくつのネストされた因子を含められますか?
最も外側のBatchなどから最も内側のSampleなどまでの、2〜4つのネストされた因子です。Factor 1とFactor 2は必須で、Factor 3とFactor 4は任意ですが、Factor 4にはFactor 3が必要です。最も内側の因子内の反復読み取りが誤差を構成し、選択した応答ごとに1回の分析を行います。