
一般線形モデル(General Linear Model)
General Linear Modelは、固定効果のカテゴリー因子、任意の2因子交互作用、連続共変量を、調整済み(タイプIII)または逐次の平方和による最小二乗法で当てはめます。一元配置分散分析では不十分な場合や、データが不釣り合いな場合に使用します。誤差は独立、正規分布、等分散であると仮定します。出力には、分散分析表、最小二乗平均、VIF付きの係数、多重比較、残差プロットが含まれます。
最終レビュー
重要なポイント
一般線形モデル(GLM)は、1つ以上のカテゴリー因子、その2因子交互作用、連続共変量を1つのモデルで扱う分散分析を実行します。不釣り合いなデータや二元配置分散分析にも対応します。
目的
General Linear Model(GLM)は、1つ以上のカテゴリー因子、その2因子交互作用、連続共変量を1つのモデルで扱う分散分析を実行します。一元配置分散分析では不十分な場合に使用します。たとえば、収率が機械、作業者、その2つの組み合わせに加えて、温度のような測定された条件にも依存する可能性がある場合や、データが不釣り合いな場合です。従来の二元配置分散分析にも対応します。
主な機能
- 任意の数の固定効果のカテゴリー因子に対応し、必要に応じてすべての2因子交互作用を含められます。
- 連続共変量を主効果として入力できます(共分散分析)。
- 調整済み(タイプIII)または逐次(タイプI)の平方和に対応し、不釣り合いなデータでも正しい検定を行います。
- 他の項で調整した、各因子の最小二乗平均。
- 1つの因子の最小二乗平均について、Tukey、Fisher、Bonferroni、Sidak、またはDunnett(対照との比較)による多重比較を行い、グループ分けの文字と差の区間プロットを出力します。
- VIF付きの係数、R-sq(pred)を含むモデルの要約、異常な観測値、4つの残差プロット。
- Data Options:解析の前に行を絞り込みます。
統計的手法
モデルは通常の最小二乗法で当てはめます。因子は和がゼロとなる(−1、0、+1)コーディングを用いるため、各係数は水準の全体平均からの偏差となり、主効果のタイプIII検定は他の因子の水準にわたって平均されます。選択した列のいずれかに欠測値がある行は除外されます。各項は F = Adj MS(項) / MS(Error) と、その項自身および誤差の自由度で検定されます。逐次平方和では、各項はそれより上の項の後で検定されます。Totalの行は平均まわりの全平方和であり、不釣り合いなデータでは調整済み平方和の合計がこれと一致するとは限りません。
S = √MS(Error) です。R-sq(pred) = 1 − PRESS / SS Total で、PRESSは1つ抜き予測誤差の2乗和です。最小二乗平均は、他の因子をその水準で平均し、共変量を平均値としたときの、ある因子水準に対するモデルの予測値です。生の平均とは異なり、グループの大きさの不揃いや共変量の差による偏りがありません。
比較では、最小二乗平均の差と、係数の共分散行列から求めたその標準誤差を使用します。Tukeyはすべての対についてスチューデント化された範囲の分布を使用し、Fisherは個別のt検定を使用し、BonferroniとSidakは対の数に応じてtの棄却値を調整し、Dunnettは多変量t分布を用いてすべての水準を対照と比較します。区間がゼロを含まない場合、または平均がグループ分けの文字を共有しない場合は、有意な差があることを示します。±2を超える標準化残差にはR、てこ比が3p/nを超えるものにはXの印が付きます。モデルは、誤差が独立で、正規分布に従い、分散が一定であると仮定しています。残差プロットで確認してください。
入力項目とオプション
項目 | 説明 |
Response (Y) | 数値の応答の列です。必須。 |
Factors (categorical) | 1つ以上のカテゴリーの説明変数の列です。必須。 |
Covariates (continuous) | 任意の数値の列で、主効果としてのみ入力されます(因子との交互作用はありません)。 |
Include all 2-way factor interactions | デフォルトでオンです。すべての2因子交互作用を追加します。 |
Confidence level | デフォルトは95です。比較に使用されます。 |
Comparison procedure | None(デフォルト)、Tukey、Fisher、Bonferroni、Sidak、またはDunnett (vs. a control level)です。 |
Comparison factor | 最小二乗平均を比較する因子です。手法を選択した場合は必須です。 |
Control group level (Dunnett) | Dunnettの対照水準です。空欄の場合は最初の水準を使用します。 |
Grouping information / Interval plot for differences of means | デフォルトでオンです。グループ分けの文字の表と、比較区間のプロットを出力します。 |
Sum of squares for tests | Adjusted (Type III、デフォルト)またはSequential (Type I)です。 |
Residual versus fit graph / Residual versus order graph / Histogram / Probability plot | 残差プロットです。デフォルトではすべてオンです。 |
Data Options: Subset (optional) | 行番号(例:3,7,12-15)や条件(例:Temperature_C > 185)で、一致する行を除外(Exclude matching rows、デフォルト)するか、一致する行のみを含める(Include only matching rows)かを指定します。 |
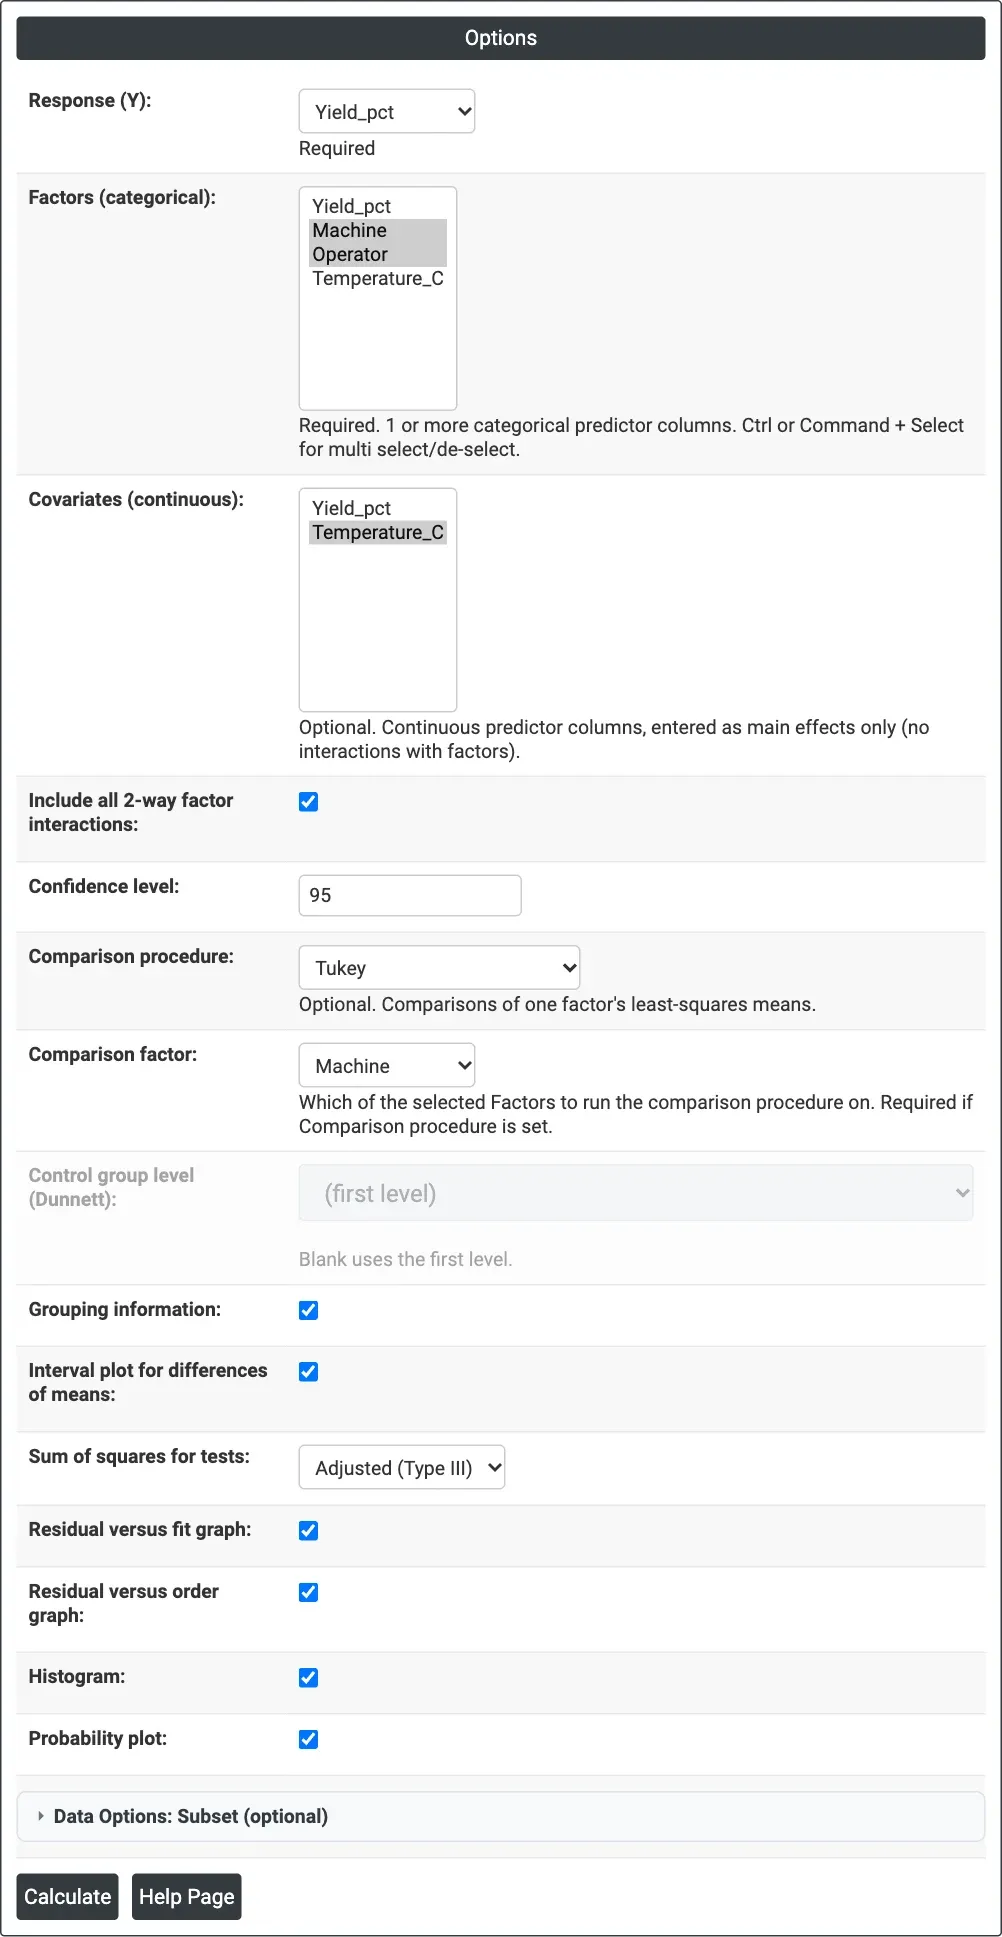
図1 — 収率の例のオプション:応答Yield_pct、因子MachineとOperator、その交互作用、共変量Temperature_C、機械のTukey比較。
出力の説明
- Method:因子のコーディングと平方和のタイプを表示します。
- Factor Information:各因子のタイプ、水準数、水準の値を表示します。
- Analysis of Variance:各項、誤差、全体について、DF、Adj SS(またはSeq SS)、Adj MS、F-Value、P-Valueを表示します。
- Model Summary:S、R-sq、R-sq(adj)、R-sq(pred)を表示します。
- Least-Squares Means:各因子の各水準のNとLS meanを表示します。
- Coefficients:Coef、SE Coef、T-Value、P-Value、VIFを表示します。
- Fits and Diagnostics for Unusual Observations:該当がある場合のみ表示されます。
- Grouping Information、Simultaneous (or Individual) Tests for Differences of Means、および区間プロット:比較手法を選択した場合に表示されます。
- Versus Fit、Versus Order、Residuals Histogram、Probability Plotを表示します。
- DownloadによるPDF出力。
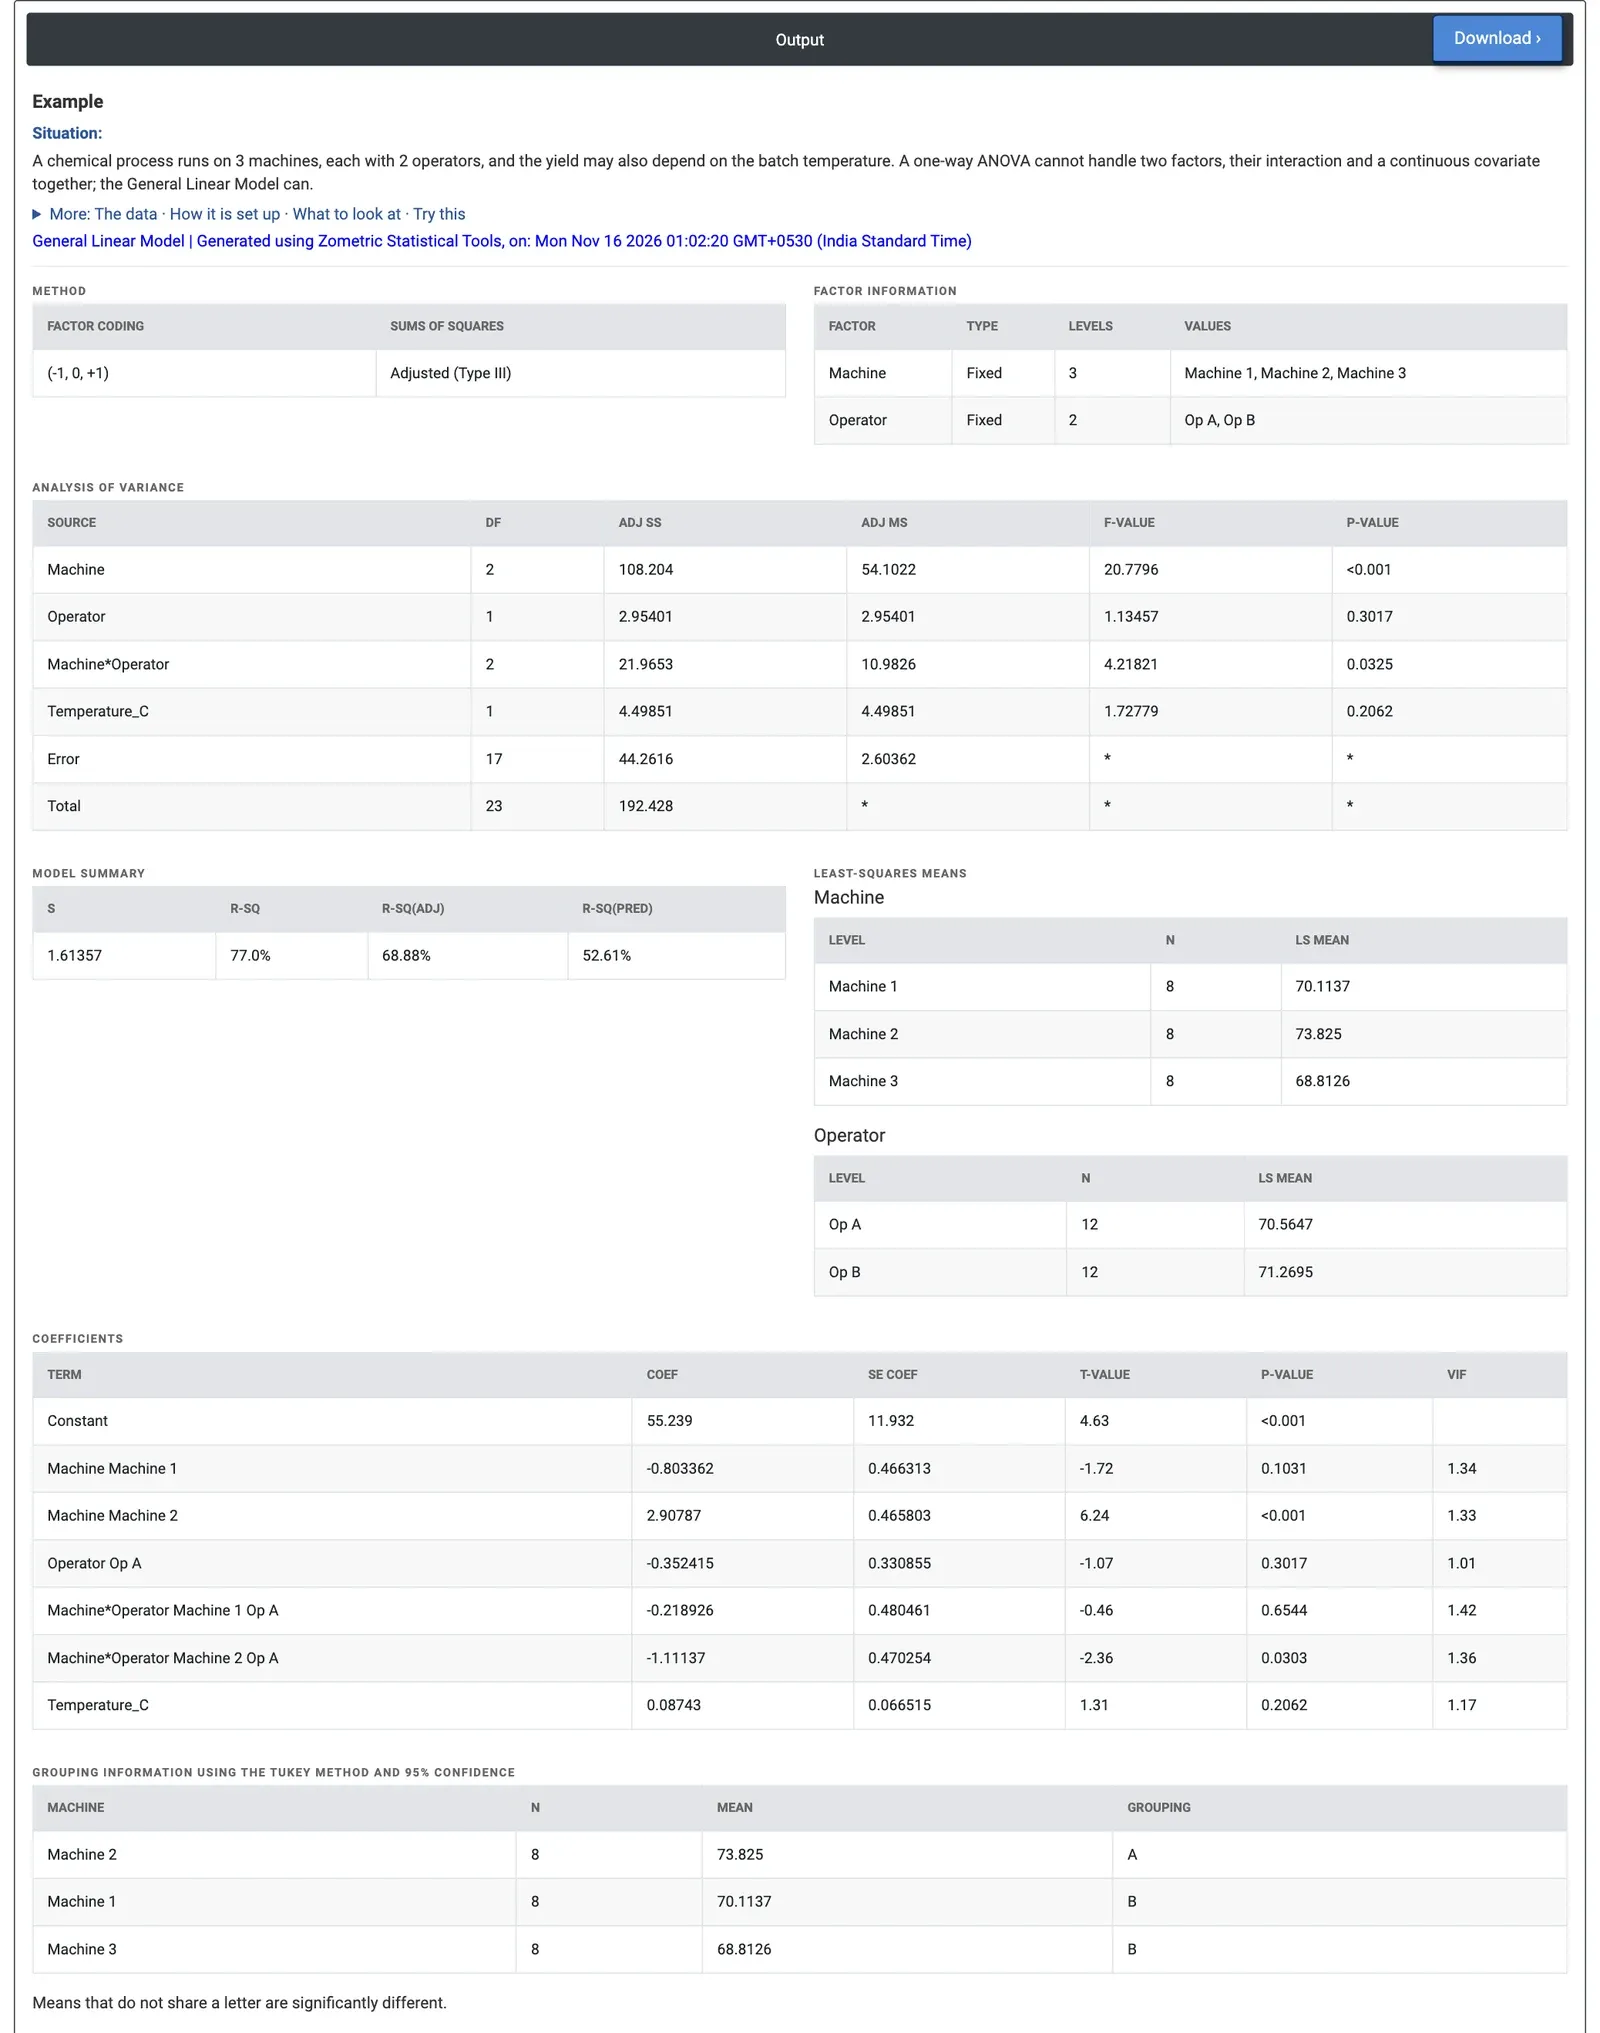
図2 — 収率のGLMの結果:Machineは有意(p < 0.001)で、Machine*Operatorの交互作用も有意(p = 0.0325)。Machine 2のLS meanが最も高く、73.83%。
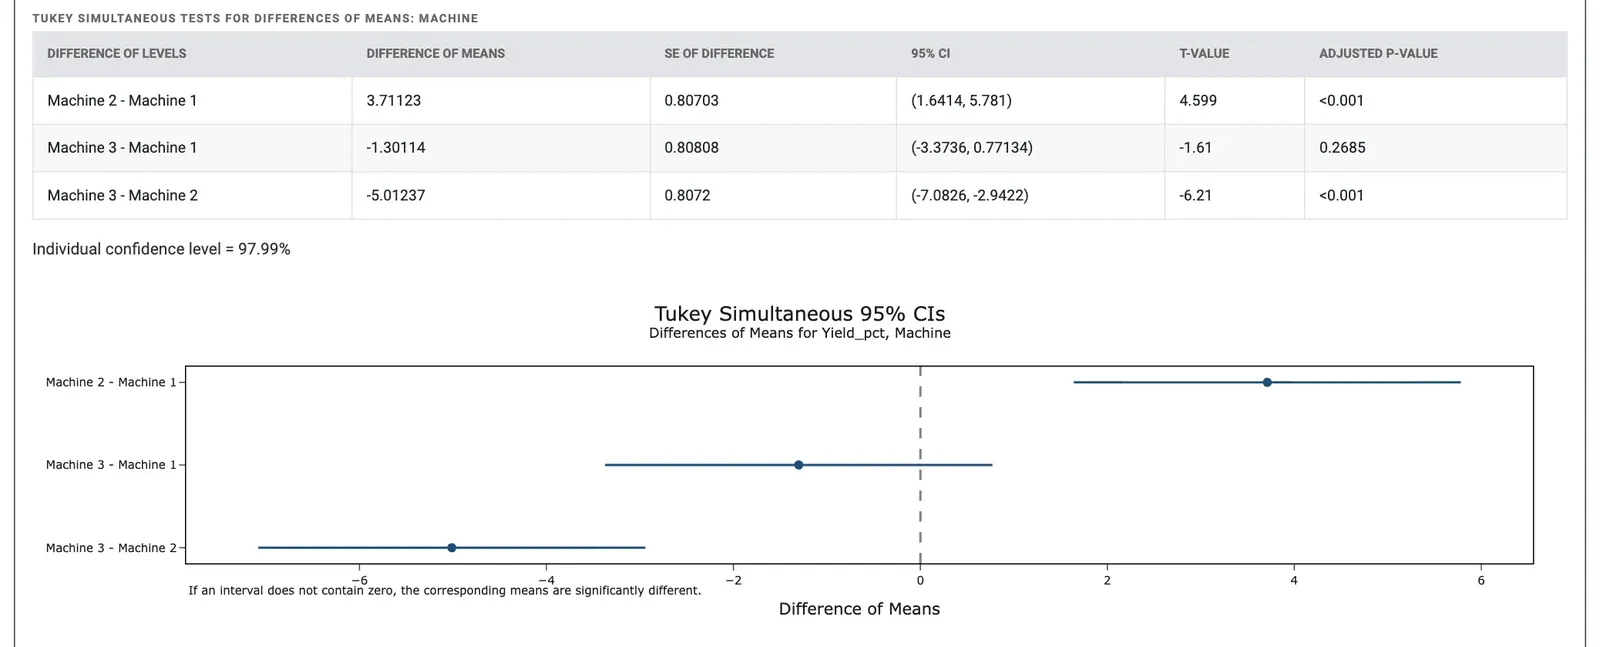
図3 — 機械のTukey比較:Machine 2は他の2台と差があり、Machine 3 − Machine 1の区間はゼロを含む。
計算例
化学プロセスが3台の機械で稼働しており、それぞれに2人の作業者(Op AとOp B)がいます。バッチの収率は、バッチ温度(170〜190 °C)にも依存する可能性があります。バッチは24個で、機械と作業者の組み合わせごとに4個ずつです。技術者は、応答にYield_pct、因子にMachineとOperatorおよびその交互作用、共変量にTemperature_Cを選択し、機械のTukey比較を指定します。
機械間には明確な差があります(F = 20.78、p < 0.001)。Machine*Operatorの交互作用も有意です(F = 4.22、p = 0.0325)。Op BはMachine 1と2ではより多くの収率を得ますが、Machine 3では少なくなります。作業者単独(p = 0.3017)と温度(p = 0.2062)は、調べた範囲では有意な効果がありません。モデルは変動の77.0%を説明し(R-sq(adj) 68.88%)、S = 1.61パーセントポイントです。R-sq(pred)は52.61%とそれより低いため、新しいバッチに対する予測は、当てはめが示すよりも精度が低くなります。
最小二乗平均は、Machine 2が73.83%、Machine 1が70.11%、Machine 3が68.81%です。TukeyはMachine 2をグループAに単独で分類します。Machine 2はMachine 1より3.71ポイント高く(95%信頼区間 1.64〜5.78)、Machine 3より5.01ポイント高く、どちらも調整済みp < 0.001です。一方、Machine 1と3の間には差がありません(調整済みp = 0.2685)。技術者はMachine 2の何が違うのかを調べ、交互作用があるため、方法を標準化する前にMachine 3の作業者の組み合わせも確認します。
よくある質問
一元配置分散分析ではなく一般線形モデルを使用すべきなのは、どのような場合ですか?
一元配置分散分析では不十分な場合に、一般線形モデルを使用します。たとえば、収率が機械、作業者、その2つの組み合わせに加えて、温度のような測定された条件にも依存する可能性がある場合や、データが不釣り合いな場合です。複数のカテゴリー因子、2因子交互作用、連続共変量を1つのモデルで扱え、従来の二元配置分散分析にも対応します。
GLMにおける最小二乗平均とは何ですか?
最小二乗平均は、他の因子をその水準で平均し、共変量を平均値に固定したときの、ある因子水準に対するモデルの予測値です。生の平均とは異なり、グループの大きさの不揃いや共変量の差による偏りがありません。GLMの多重比較では、1つの因子の水準間でこれらの最小二乗平均を比較します。
GLMでは、どの多重比較の手法を使用すべきですか?
Tukeyはスチューデント化された範囲の分布を使ってすべての対を比較し、Fisherは個別のt検定を使用し、BonferroniとSidakは対の数に応じてtの棄却値を調整し、Dunnettはすべての水準を対照と比較します。区間がゼロを含まない場合、または平均がグループ分けの文字を共有しない場合は、有意な差があることを示します。
一般線形モデルの仮定は何ですか?
モデルは、誤差が独立で、正規分布に従い、分散が一定であると仮定しており、残差プロット(残差対当てはめ値、残差対順序、ヒストグラム、確率プロット)で確認します。±2を超える標準化残差にはR、てこ比が3p/nを超える観測値にはXの印が付き、異常な観測値として示されます。