
個別分布の同定(Individual Distribution Identification)
個別分布の同定は、データに複数の確率分布を同時に当てはめ、どの分布が統計的に最もよく適合するかを評価します。このツールは正規性を仮定せず、ワイブル、対数正規、指数、ロジスティック、ガンマなど幅広い分布を検定し、データの形状と挙動をどれだけうまく表すかによって順位付けします。
最終レビュー
重要なポイント
個別分布の同定は、データに複数の確率分布を同時に当てはめ、どの分布が統計的に最もよく適合するかを評価します。
個別分布の同定とは
個別分布の同定は、データに複数の確率分布を同時に当てはめ、どの分布が統計的に最もよく適合するかを評価します。このツールは正規性を仮定せず、ワイブル、対数正規、指数、ロジスティック、ガンマなど幅広い分布を検定し、データの形状と挙動をどれだけうまく表すかによって順位付けします。
これは非正規データの工程能力分析に不可欠です。誤った分布を使用すると、Pp、Ppk、Cp、Cpkの推定値が不正確になり、不良率の予測も誤解を招くものになります。
かんたんな定義:データを多くの異なる統計分布に対して検定し、どれが最もよく適合するかを示すツールです。データが正規分布に従わない場合でも、正確な工程能力分析を実行できます。
個別分布の同定を使用する場面
- データが 正規性の検定に不合格 で、工程能力分析を行う前に適切な分布を特定する必要がある場合に使用します。
- サイクルタイム、故障時間、化学物質の濃度、粒子径のように、本質的に歪んだ工程データ を扱う場合に使用します。
- 選択した分布が工程の挙動を正確に表していることを確認するため、非正規の工程能力分析 を適用する前に使用します。
- データにゼロや負の値が含まれる場合など、Box-Cox変換が適切でない 場合に使用します。
個別分布の同定を正しく使用するためのガイドライン
- 分布の当てはめを信頼できるものにするため、少なくとも 50〜100個のデータ点 を収集します。サンプルが小さいと、分布を区別するのに十分な情報が得られません。
- 最適な分布を選ぶ際は、適合度統計量(Anderson-Darling)と確率プロットを併用します。p値だけに頼らないでください。
- 選択する分布は、工程にとって物理的に意味がある ものにします。AD統計量が最も小さくても、物理的な根拠がない分布は、最適な選択ではない可能性があります。
- 分布を当てはめる前に、データが 安定した管理状態の工程から 得られたものであることを確認します。不安定な工程のデータに分布を当てはめても、意味のない結果になります。
- 標準的な分布がどれもよく適合しない場合は、代替として JohnsonまたはBox-Cox変換 の使用を検討します。
代替手法:個別分布の同定を使用すべきでない場合
- データが すでに正規性を確認済みの場合は、そのまま標準の 工程能力(正規分布)に進んでください。分布の同定は不要です。
- 他の分布を調べずに 正規性を確認するだけの場合に適した手法:正規性の検定
- データに 明確な物理的限界や既知の分布の種類がある場合は、すべての選択肢を検定するのではなく、工程能力分析でその分布を直接指定します。
個別分布の同定の例
ある技術者が、カプセルを無作為に抽出し、そのカルシウム含有量を記録します。データに最もよく適合する分布を判定するため、個別分布の同定を実行します。検定の手順は次のとおりです。
- 必要なデータを収集します。
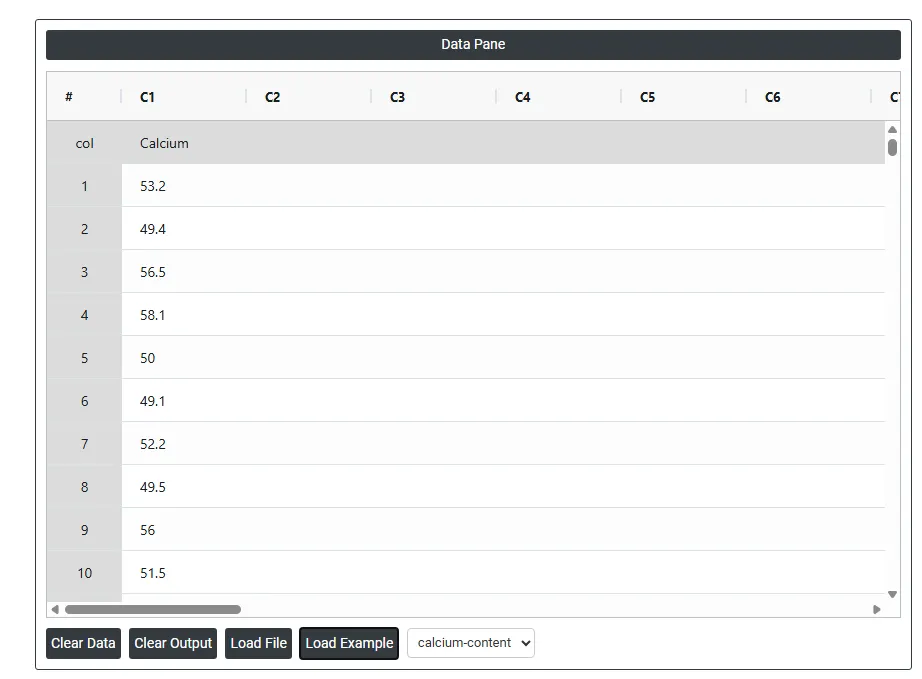
- 次に、Zometric Statistical Softwareでデータを分析します(https://statsai.zometric.com/)。
- 個別分布の同定を見つけるには、Statistical module> Hypothesis Test> Individual Distribution Identificationを選択します。
- ツール内で、他の入力とともにデータを次のように入力します。
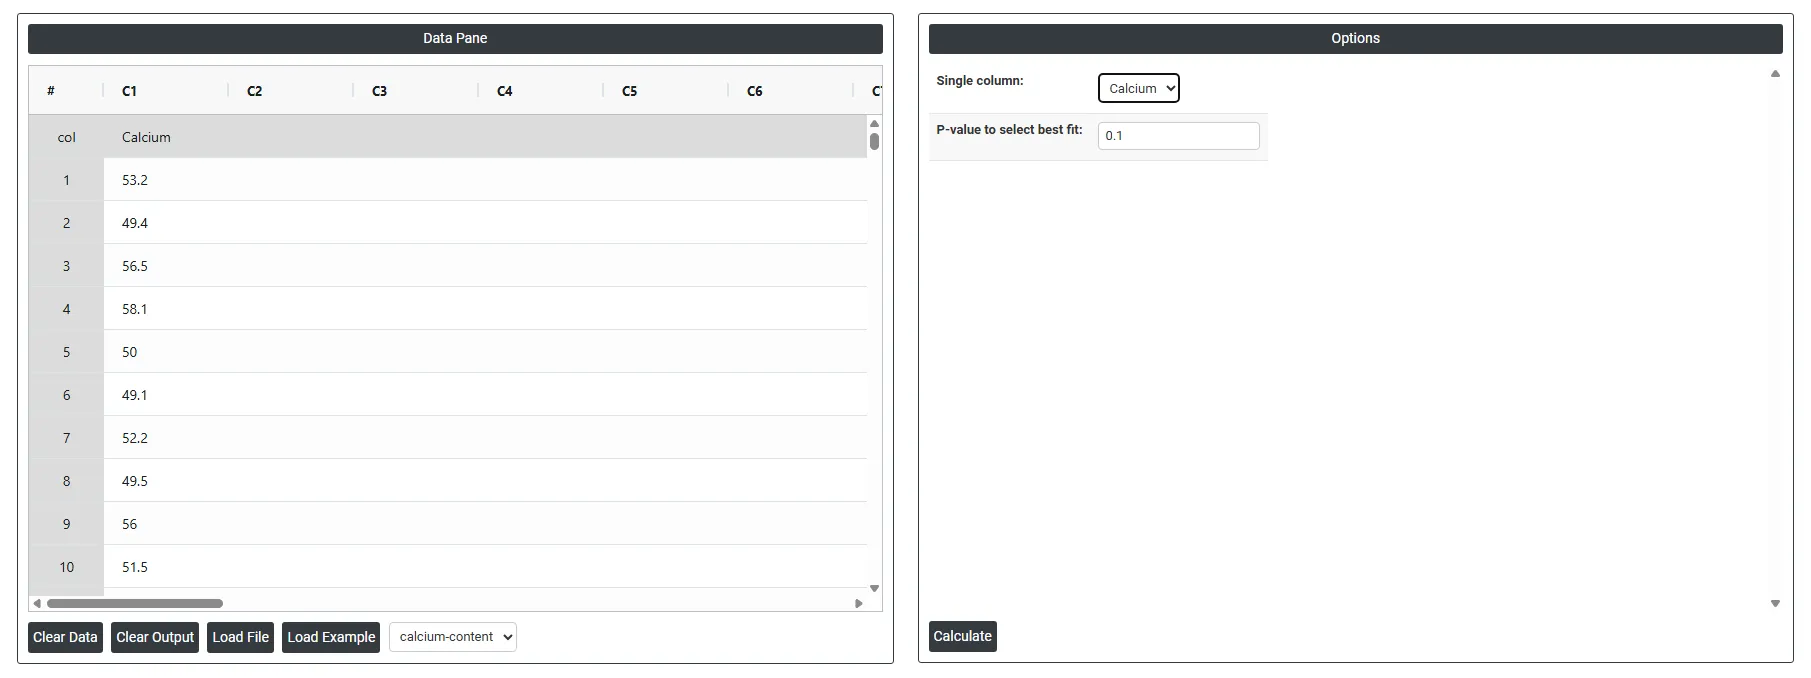
5. 上記のツールを使用すると、次のような出力が得られます。
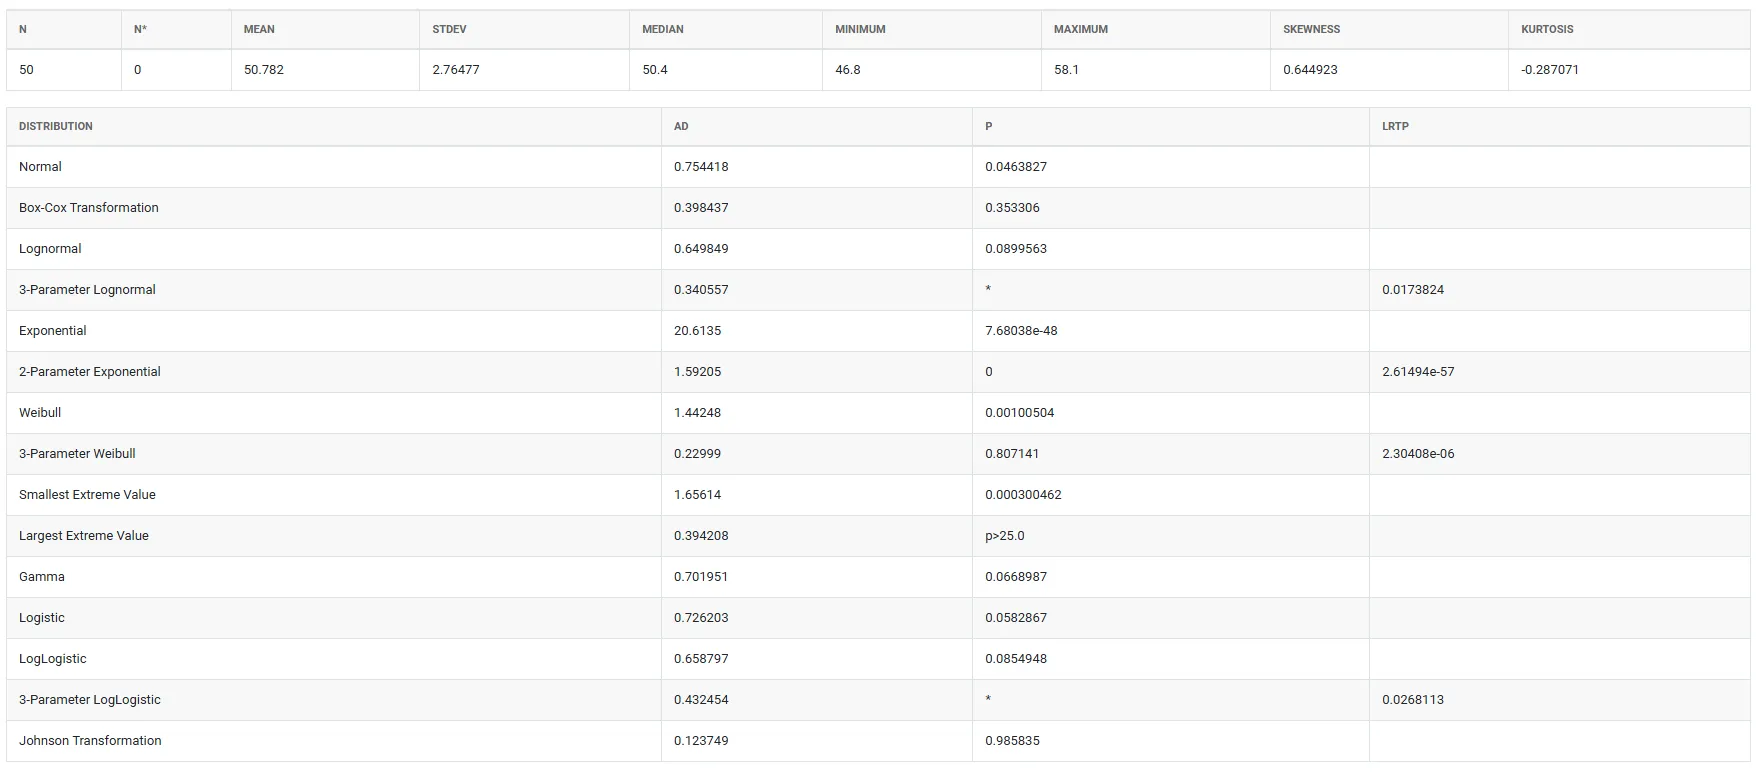
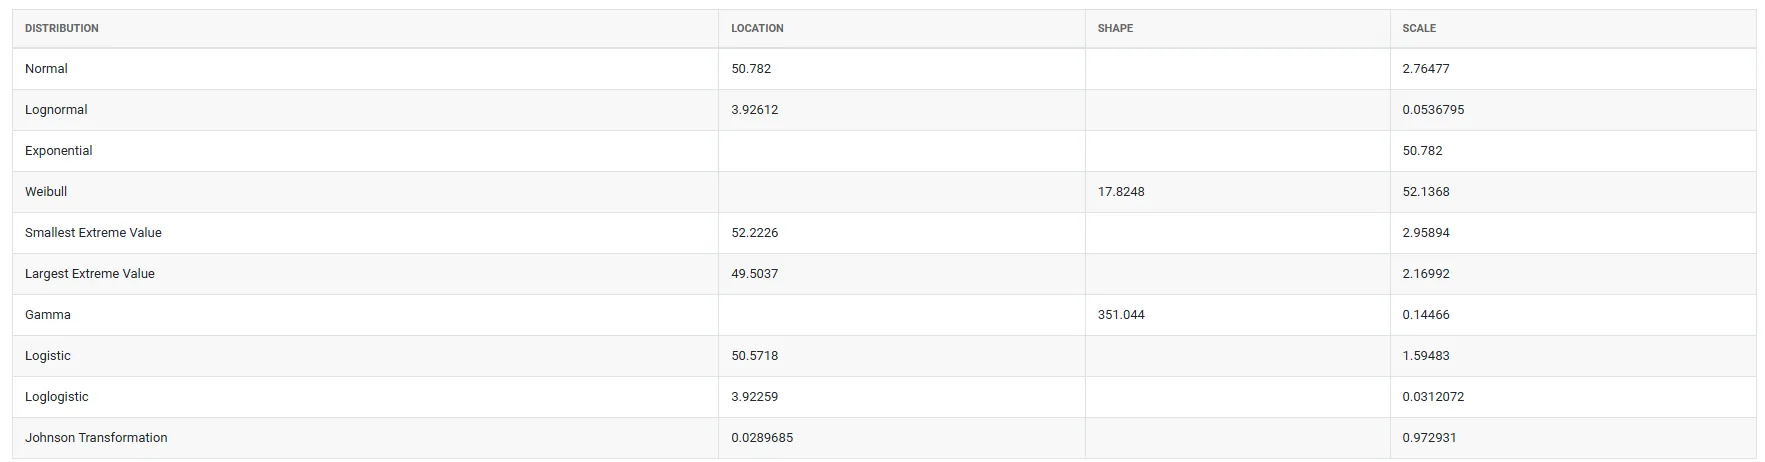
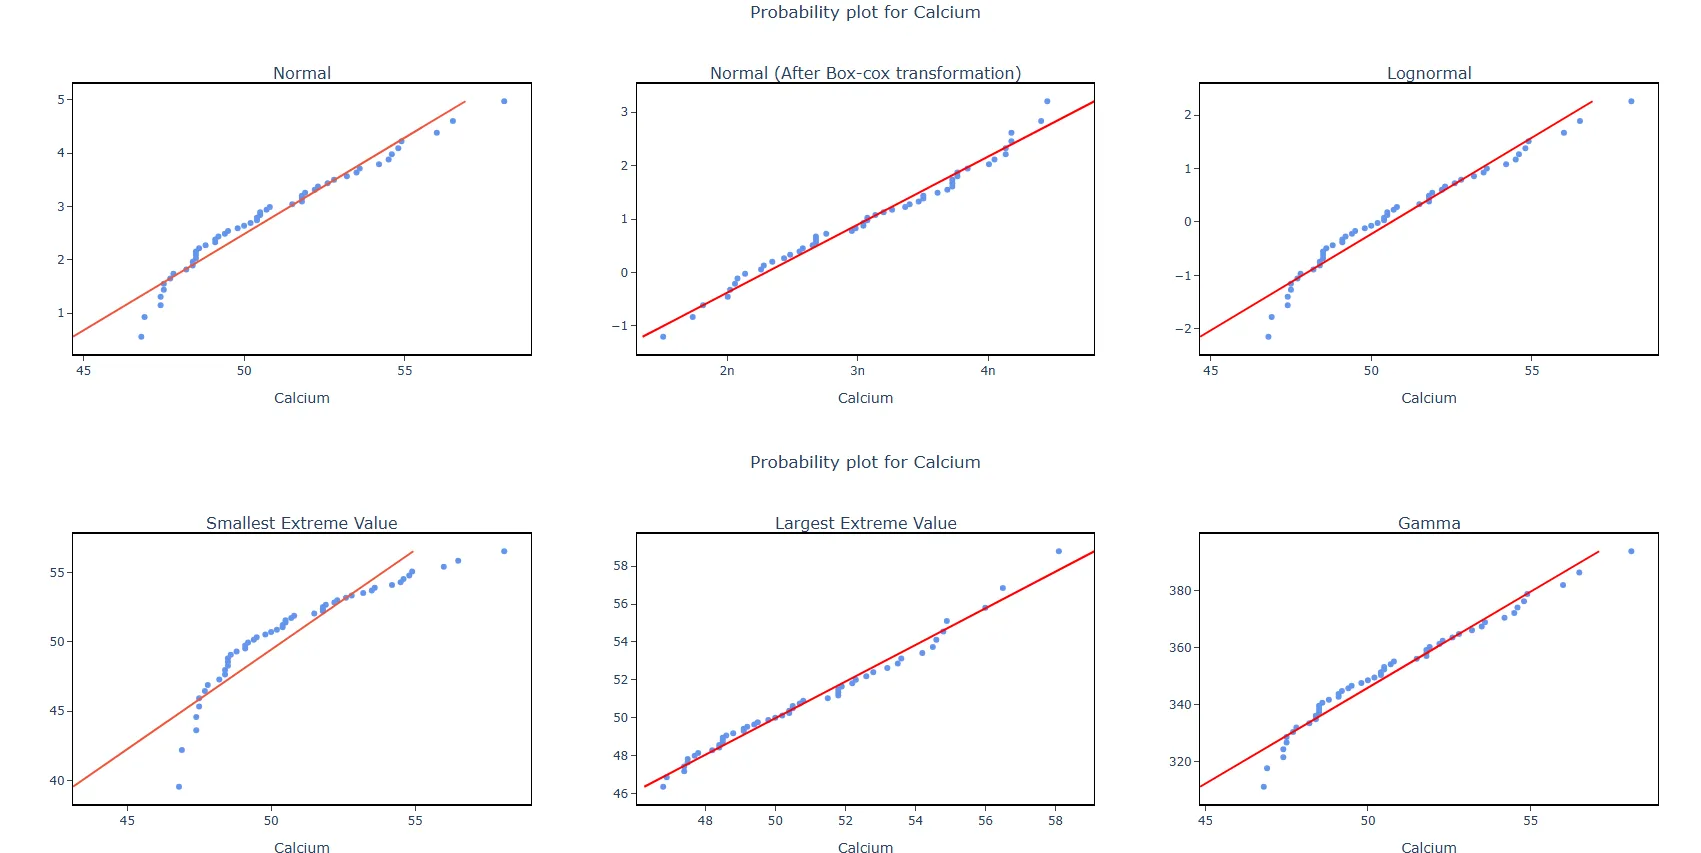
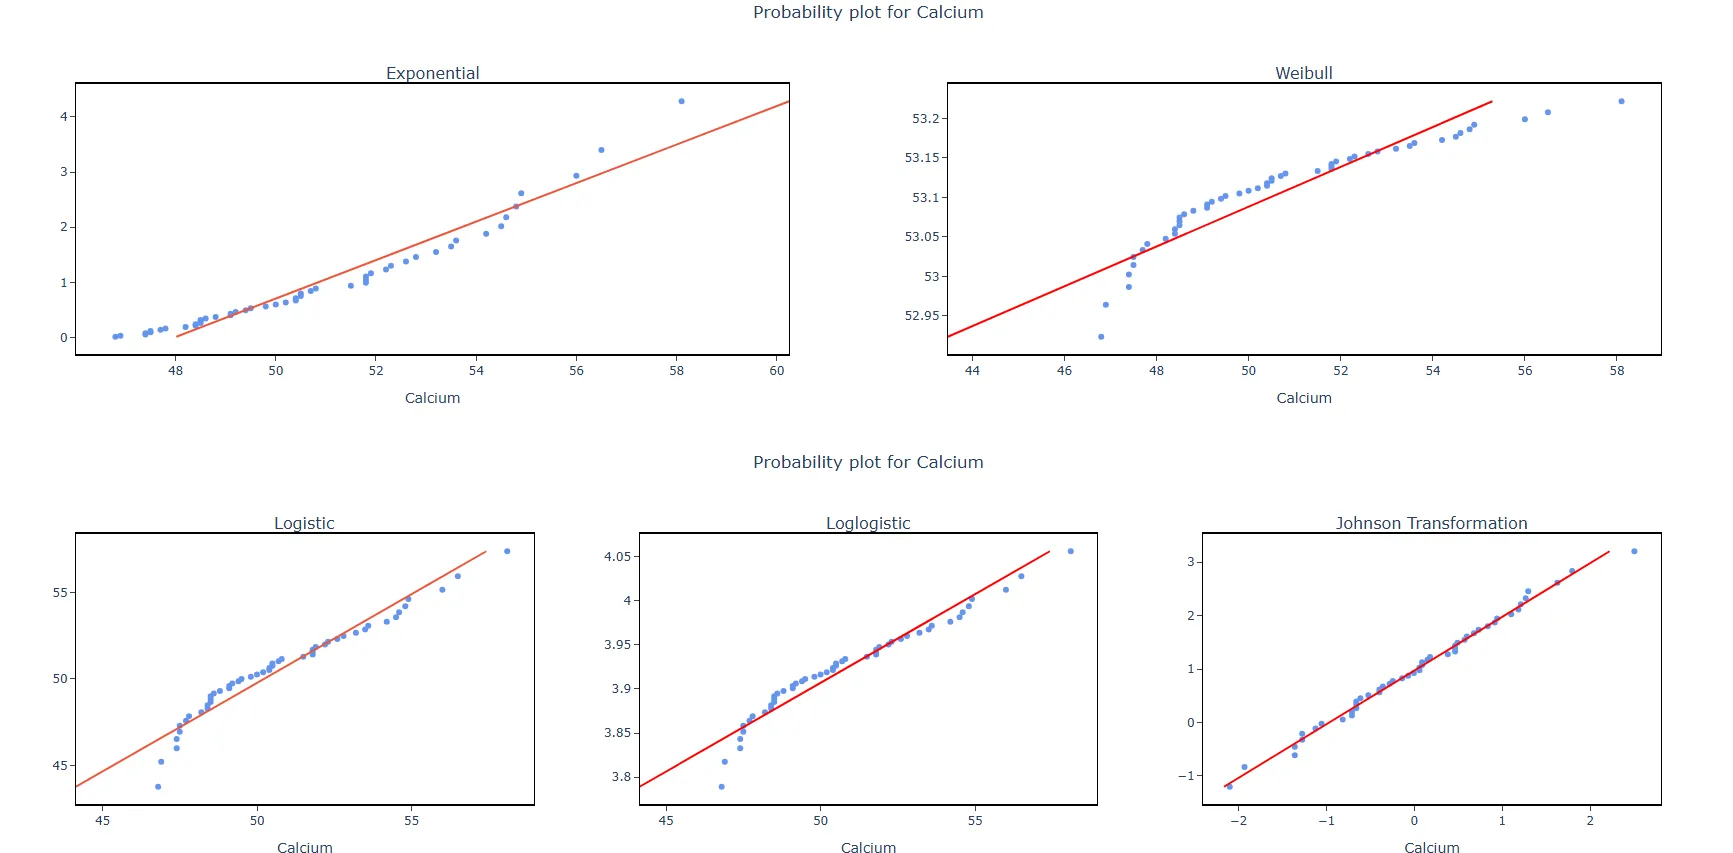
個別分布の同定の実行方法
手順は次のとおりです。
- 次のURLでZometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Hypothesis Test >Individual Distribution Identification を選択します。
- 次に、データを手入力するか、Excelシートからデータをコピー(Ctrl+C)し、ここに貼り付け(Ctrl+V)ます。
- 必須のオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
個別分布の同定のダッシュボードでは、ウィンドウが2つの部分に分かれています。
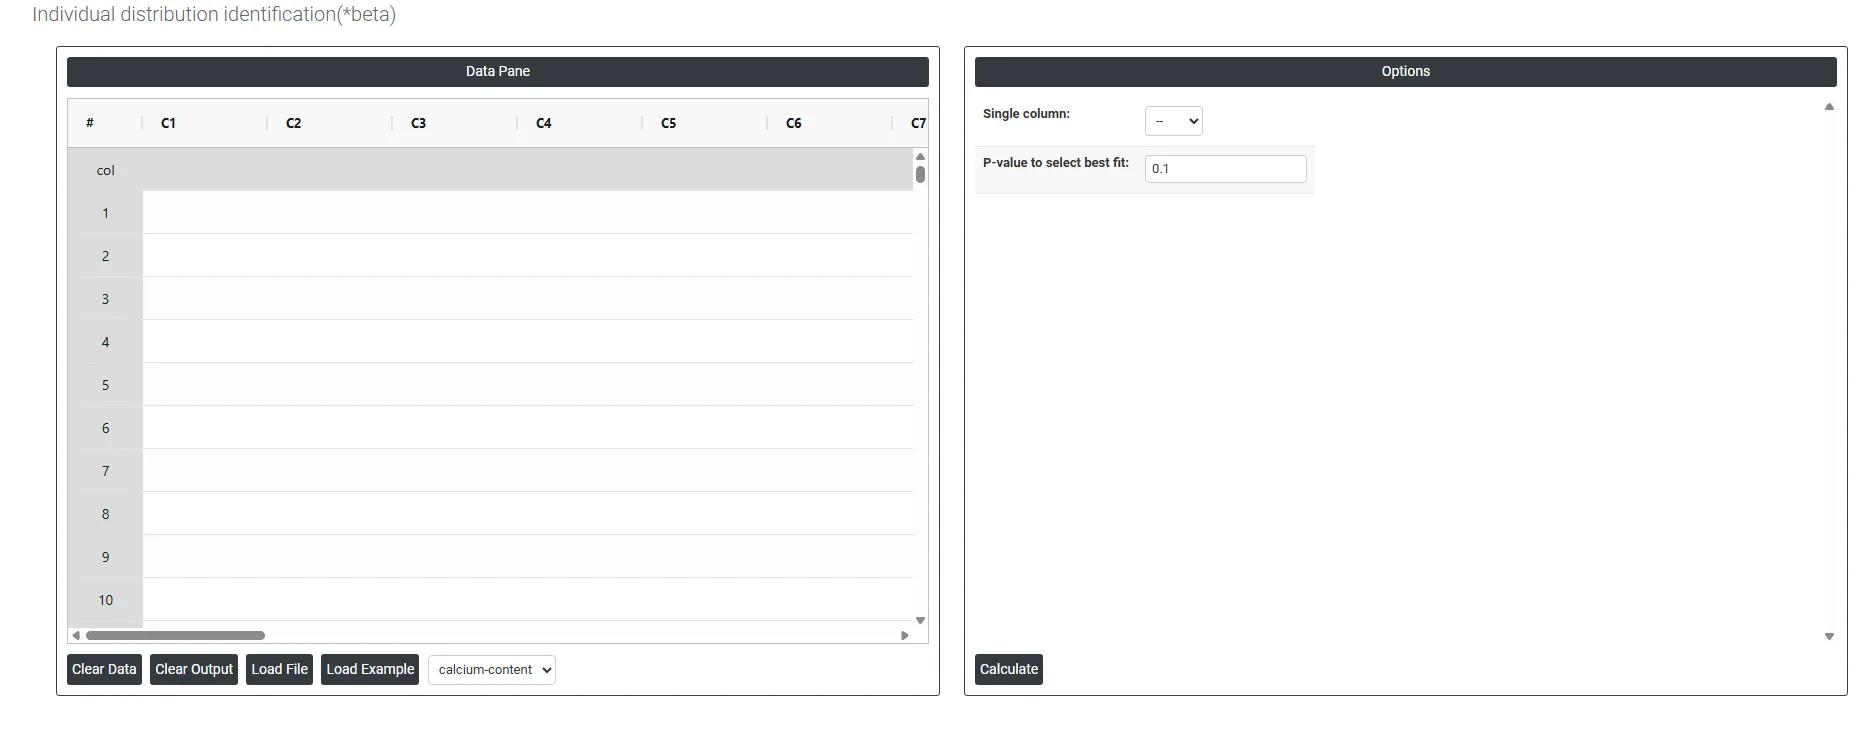
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループを構成します。データは手入力するか、Excelシートからすべてコピー(Ctrl+C)してここに貼り付け(Ctrl+V)ます。
Load example: サンプルデータが読み込まれます。
Load File: Excelデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Single Column: 分布を当てはめたい 連続データ を含む列を選択します。たとえば、カルシウム量、サイクルタイム、引張強さ、粒子径などの測定値です。ツールは、この列のすべての値を複数の確率分布に対して同時に検定し、どの分布がデータの形状と挙動を最もよく表すかを判定します。各変数は独立に評価されるため、一度に選択できる列は1つだけです。
- P-Value to Select Best Fit: どの分布がデータに対して 許容できる適合 を示すかを判定するために使用する有意性のしきい値を設定します。標準の既定値は 0.05で、Anderson-Darling適合度のp値が0.05を超える分布は、統計的に許容できる適合と見なされます。その分布をデータのモデルとして棄却するのに十分な証拠がないということです。この文脈でのp値の解釈は次のとおりです。
- p値 > 0.05 — その分布はデータに許容できる程度に適合しています。p値が高いほど、その分布がよく一致している証拠が強くなります。
- p値 ≤ 0.05 — その分布はデータにあまりよく適合しておらず、工程能力分析やそれ以降のモデリングに使用すべきではありません。
- 許容できるp値を示す分布が複数ある場合は、p値が最も高い ものを第一候補として選びます。ただし、必ず確率プロットの目視確認と組み合わせ、選択した分布が工程にとって物理的に意味があるかどうかも検討してください。統計的には適合していても、そのデータの種類に論理的な根拠がない分布は、使用前に疑う必要があります。
よくある質問
個別分布の同定とは何ですか?
個別分布の同定は、ワイブル、対数正規、指数、ロジスティック、ガンマなど、複数の確率分布をデータに一度に当てはめ、データをどれだけうまく表すかによって順位付けします。誤った分布を使用すると、Pp、Ppk、Cp、Cpkの推定値が不正確になり、不良率の予測も誤解を招くものになるため、非正規データの工程能力分析に不可欠です。
個別分布の同定はどのような場合に使用しますか?
データが正規性の検定に不合格で、工程能力分析の前に適切な分布が必要な場合、サイクルタイム、故障時間、化学物質の濃度、粒子径のように工程データが本質的に歪んでいる場合、データにゼロや負の値が含まれるなどの理由でBox-Cox変換が適切でない場合に使用します。
最もよく適合する分布はどのように選びますか?
Anderson-Darlingのp値がしきい値(既定は0.05)を超える分布は、許容できる適合です。しきい値以下の場合、その分布は使用すべきではありません。複数の分布が適合する場合は、p値が最も高いものを第一候補としますが、確率プロットも確認し、その分布が工程にとって物理的に意味があるかを確かめてください。
分布の同定には、いくつのデータ点が必要ですか?
サンプルが小さいと分布を区別するのに十分な情報が得られないため、少なくとも50〜100個のデータ点を収集してください。また、データは安定した管理状態の工程から得られたものである必要があります。不安定な工程のデータに分布を当てはめても、意味のない結果になるためです。