
移動平均(Moving Average)
移動平均は、時系列の各値を直近のL期間の平均で置き換え、基礎となる水準やトレンドを明らかにします。Lを季節周期の1周期分(月次データなら12)に設定すると、季節変動が打ち消されます。系列には、欠測がなく、Lより多くの値が必要です。出力には、平滑化したプロット、MAPE、MAD、MSD付きの当てはめ値、予測限界付きの横ばいの予測値が含まれます。
最終レビュー
重要なポイント
移動平均は、各値を直近の数期間の平均で置き換えて時系列を平滑化するため、短期的なノイズや繰り返す季節変動が薄れ、基礎となる水準やトレンドが見えてきます。
目的
移動平均は、各値を直近の数期間の平均で置き換えて時系列を平滑化するため、短期的なノイズや繰り返す季節変動が薄れ、基礎となる水準やトレンドが見えてきます。予測モデルを選ぶ前に、月次の売上、週次のスクラップ、日次の生産量などの系列がどこへ向かっているかを見るために使用します。長さを季節周期の1周期分(年周期の月次データなら12)に設定すると、季節変動が打ち消されます。精度指標付きの1期先の当てはめ値や、単純な横ばいの予測値も得られますが、トレンドや季節性のある系列の予測には、二重指数平滑法、Winters法、分解のほうが適しています。
主な機能
- 2期間以上の任意の長さの移動平均。
- 中心化した移動平均。各平均を窓の中央に配置してデータと位置を合わせます。長さが偶数の場合は、2×Lの平均を使用します。
- 当てはめ値(直前のL期間の平均)と、MAPE、MAD、MSDの精度指標。
- 選んだ信頼水準(既定は95%)での予測限界付きの予測値。系列の末尾から、または既知のデータで方法を検証するために、より前の行から予測できます。
- データ、当てはめ値、移動平均、予測値のプロット。任意で表示できる結果の表と、4つをまとめた残差プロット。
統計手法
長さ L の場合、期 t の移動平均は MAₜ = (yₜ + yₜ₋₁ + … + yₜ₋L₊₁) / L であり、t で終わる L 個の値の平均です。最初の L − 1 期には移動平均がありません。Center the moving averagesにチェックを入れると、各平均は窓の中央に移されます。L が奇数の場合は、t の両側にある (L − 1)/2 個の値の平均になります。L が偶数の場合は中央の期がないため、ツールは2×Lの移動平均を使い、両端の2つの値に重み 1/(2L)、その間の L − 1 個の値に重み 1/L を割り当てます。その場合、最初と最後の L/2 期(小数点以下切り捨て)には中心化した平均がありません。中心化によって変わるのは、移動平均の列とプロットの点線のみです。
期 t の当てはめ値は、常に期 t − 1 で終わる中心化していない移動平均で、1期前に行っていたはずの予測です。誤差は yₜ からその当てはめ値を引いたものです。精度は、当てはめ値のある期について計算します。MAPE = 平均 |誤差 / データ| × 100、MAD = 平均 |誤差|、MSD = 平均 誤差²。すべての予測値は、予測の起点までの中心化していない最後の移動平均に等しく、予測値は横ばいになります。予測限界は 予測値 ± z × √MSD で、z は信頼水準に対応する標準正規分布の分位点(95%では1.96)であり、先の期によらず同じ幅になります。系列には、欠測がなく、L より多くの値が必要です。
入力項目とオプション
項目 | 説明 |
Variable (Y) | 必須。時間順に並んだ数値の系列です。 |
MA length | 平均する期間の数。既定は3で、2以上。季節変動を取り除くには、季節の長さ(例:月次データなら12)を使用します。 |
Center the moving averages | 既定ではチェックなし。各平均を、窓の末尾ではなく、その中央の時間の期に配置します。 |
Number of forecasts | 既定は0(なし)で、最大1000。 |
Confidence level (%) for forecast interval | 既定は95で、1〜99.99。予測を要求した場合に有効です。予測限界の水準です。 |
Forecast origin (row) | 任意。予測を要求した場合に有効です。予測は、この行までのデータを使って、この行の次から始まります。空欄の場合は系列の末尾です。MA length以上である必要があります。 |
Results to display | Summary table(既定)またはSummary table and results table。 |
Residual plots (four in one) | 既定ではチェックなし。正規確率プロット、残差と当てはめ値の関係、ヒストグラム、残差と順序の関係。 |
Title | 出力のタイトル。既定値はMoving Averageです。 |
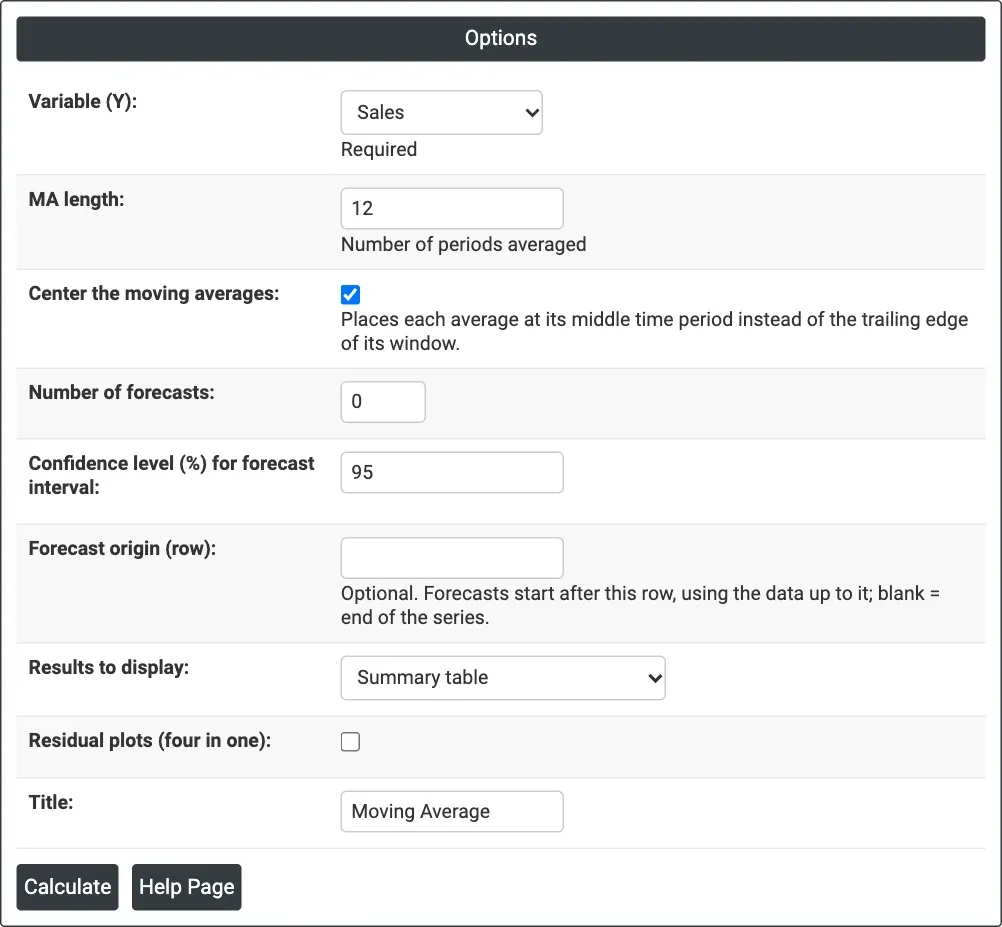
図1 — 12か月の中心化した移動平均を付けた月次のSales(予測なし)。
出力の説明
- Moving Average (graph) — 実測データ、当てはめ値、移動平均(点線)、および予測値とその限界。タイトルの下にMAPE、MAD、MSDを表示します。
- Method — データ列、系列の長さ、移動平均の長さ、および該当する場合はCentered = Yesまたは予測の起点。
- Accuracy Measures — 当てはめ値のMAPE、MAD、MSD。
- Forecasts — 予測を要求した場合の、期、予測値、下側限界と上側限界。
- Results — 選択した場合:各期のPeriod、データ、MA、Predict、Error(値がない箇所は*)。
- Residual Plots — チェックを入れた場合。
- DownloadによるPDF出力。
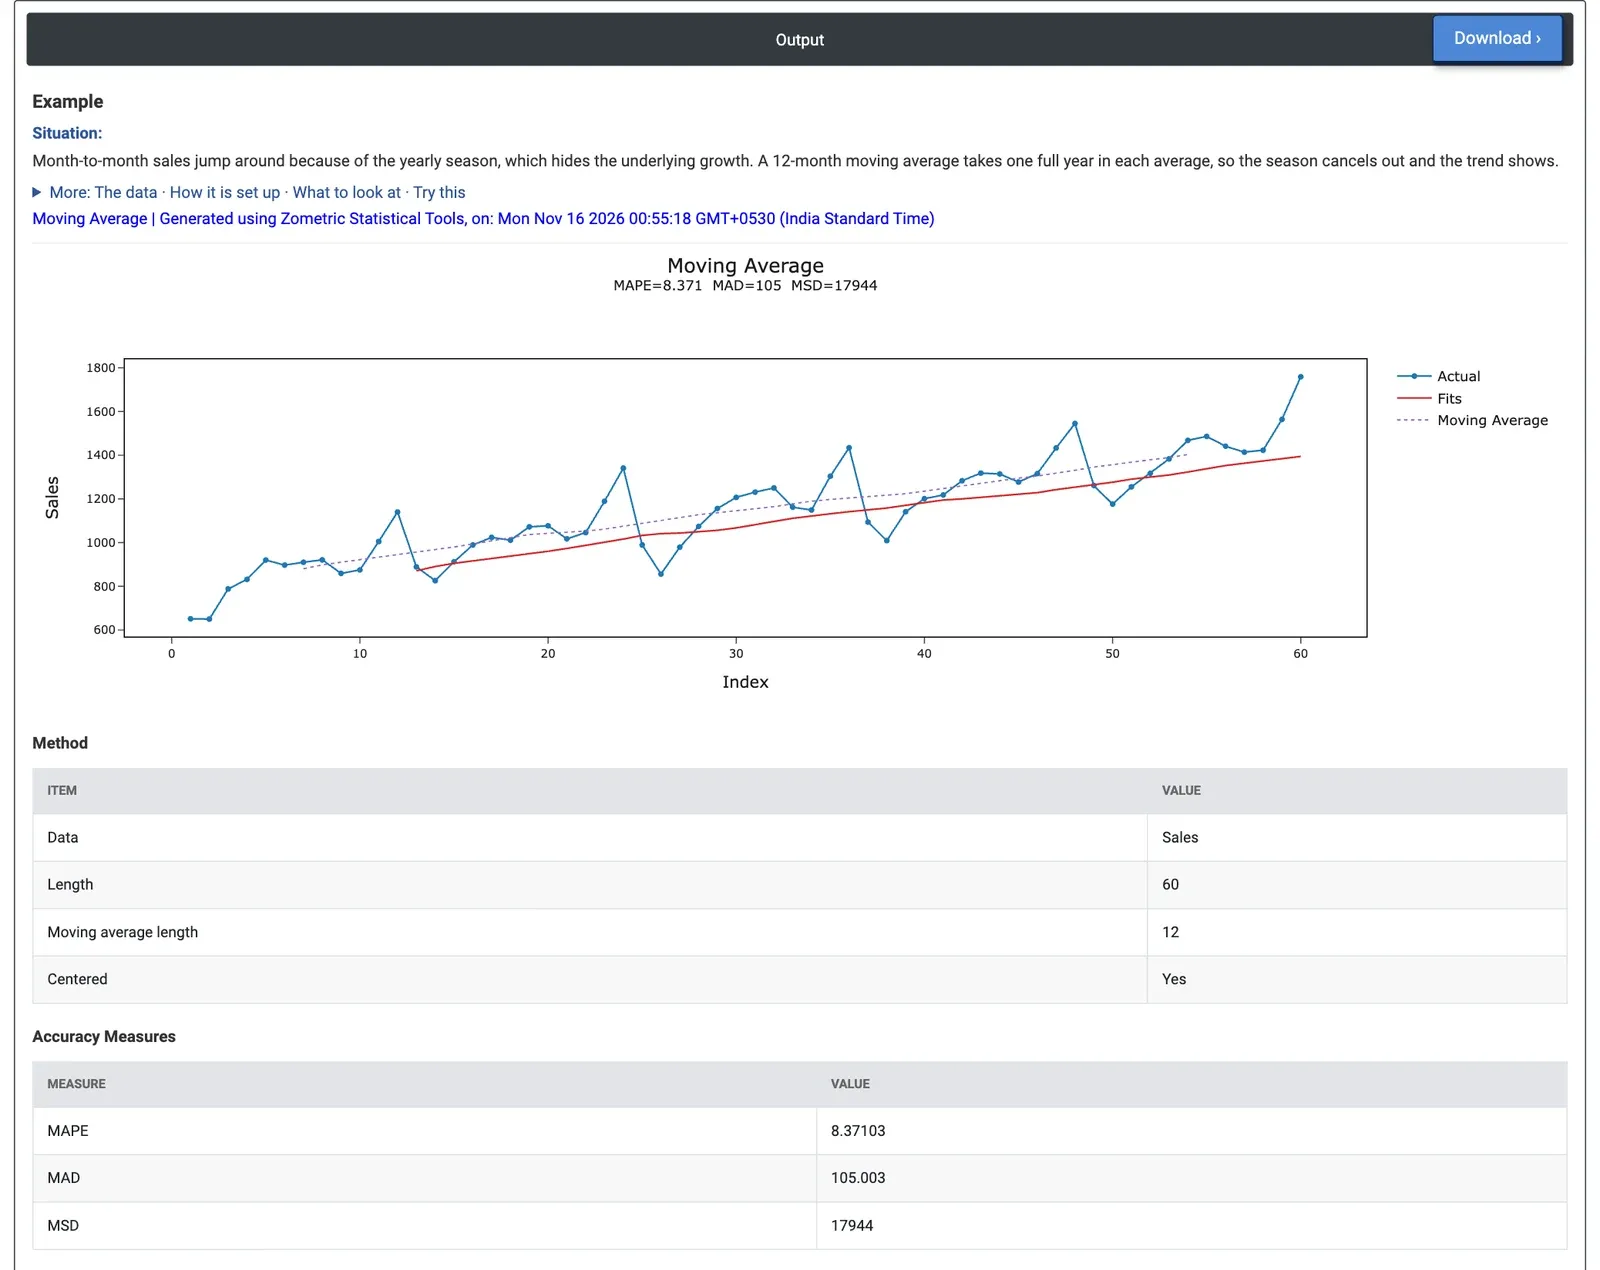
図2 — 中心化した12か月の平均は881から1,403まで着実に上昇し、季節のピークは残っていません。MAPE 8.37%、MAD 105。
計算例
ある家電製品の販売会社には、2020年1月から2024年12月までの60か月分の販売数量があります。売上は毎年12月にピークとなり、2月に落ち込むため、事業がどれだけの速さで成長しているかがわかりません。販売アナリストは、Variable (Y) = Salesを選択し、各平均がちょうど1年をカバーするようMA length = 12に設定し、各平均がその年の中央に位置するようCenter the moving averagesにチェックを入れます。
移動平均の点線には、12月のピークも2月の落ち込みも残っておらず、881個(2020年7月、前後に1年分のデータがそろう最初の月)から1,403個(2024年6月、最後の月)まで着実に上昇しており、月当たり約11個です。最初と最後の6か月には中心化した平均がありません。これは、アナリストが見たかった、季節変動のない成長です。翌月の予測としては、12か月の平均は適していません。当てはめ値は成長に遅れ、すべてのピークを外すため、MAPEは8.37%、MADは105個、MSDは17,944になります。MA length = 3にすると、線は再び季節変動に追従し、MAPEは9.85%に上昇します。
Center the moving averagesのチェックを外し、Number of forecasts = 12を設定すると、2025年のどの月も1,412.25個(2024年の売上の平均)となり、95%の限界は1,149.7〜1,674.8です。これらの予測値には、成長も季節変動も反映されていません。そのため、アナリストは、経営陣にトレンドを示すには移動平均を、2025年の計画にはWinters法や分解などの季節性を扱う手法を使用します。
よくある質問
時系列分析における移動平均とは何ですか?
移動平均は、各値を、その期で終わる L 個の値の平均で置き換えるため、短期的なノイズや繰り返す季節変動が薄れ、基礎となる水準やトレンドが見えてきます。予測モデルを選ぶ前に、月次の売上、週次のスクラップ、日次の生産量などの系列がどこへ向かっているかを見るために使用します。
移動平均の長さは、どのくらいにすればよいですか?
長さ L は平均する期間の数で、最小は2、既定は3です。季節パターンを取り除くには、長さを季節周期の1周期分(例:年周期の月次データなら12)に設定すると、季節変動が打ち消されます。長さが短いほど、データと、その中の季節変動に、より密接に追従します。
中心化した移動平均とは何ですか?
中心化した移動平均は、窓の中央に配置され、データと位置が合います。長さが奇数の場合は、その期の両側にある (L - 1)/2 個の値を平均します。長さが偶数の場合は、中央の期がないため、2×Lの移動平均を使用します。その場合、最初と最後の L/2 期には中心化した平均がありません。
移動平均は予測に適していますか?
移動平均の予測値は横ばいです。すべての予測値は、中心化していない最後の移動平均に等しく、予測限界は、予測値に z と MSD の平方根の積を加減した値です。トレンドも季節変動も反映されないため、トレンドや季節性のある系列には、二重指数平滑法、Winters法、分解のほうが適しています。