
多重コレスポンデンス分析(Multiple Correspondence Analysis)
多重コレスポンデンス分析は、アンケートの回答や不具合記録など、3つ以上のカテゴリー変数のすべてのカテゴリーをマップ上に示し、関連するカテゴリーが近くに現れるようにします。ちょうど2つの変数の場合は、Simple Correspondence Analysisを使用します。欠損値のある行は除外されます。出力には、次元ごとの慣性の表、質量、座標、質、寄与を含むカテゴリーの表、最初の2つの次元のマップが含まれます。
最終レビュー
重要なポイント
多重コレスポンデンス分析(MCA)は、3つ以上のカテゴリー変数のすべてのカテゴリーを1つのマップ上に配置し、顧客タイプ、チャネル、プランなど、よく一緒に現れるカテゴリーを近くに表示します。
目的
多重コレスポンデンス分析(MCA)は、3つ以上のカテゴリー変数のすべてのカテゴリーを1つのマップ上に配置します。同じ回答者によってよく選ばれる、または同じ品目に見られるカテゴリーは、近くに配置されます。複数のカテゴリーの項目を持つアンケートの回答、不具合記録、監査所見を探索する場合に使用します。たとえば、どの顧客タイプがどのチャネルやサービスプランと結び付くか、どのシフト、ライン、不具合タイプが一緒に発生しやすいかを調べます。ちょうど2つの変数の場合は、Simple Correspondence Analysisを使用します。
主な機能
- 3つ以上のカテゴリーの列を同時に分析します。各カテゴリーがマップ上の1つの点になります。
- すべての次元についての慣性の表。パーセントと累積パーセント付き。
- 選択した次元数について、質量、慣性、座標、質、2乗相関、寄与を示すカテゴリーの表。
- 最初の2つの次元上のすべてのカテゴリーの列プロット。変数ごとに色分けされます。
- 結果のPDF出力。
統計的手法
選択した変数のいずれかに欠損値がある行は除外し、すべての値をカテゴリーのラベルとして扱います。データは、各変数のカテゴリーごとに0/1の列を1つ持つ指示行列 Z に変換されます(J 個の変数で、合計 K 列)。MCAは、この行列に対するコレスポンデンス分析です。Z をその総和で割って比率 P を求め、行の質量 r と列(カテゴリー)の質量 c を用いて、標準化残差 S = Dr^−½ (P − r cᵀ) Dc^−½ を特異値分解で分割します。各特異値 d が、慣性 d² を持つ1つの次元を与えます。次元は K − J 個あり、全慣性は常に (K − J) / J であるため、データではなくカテゴリーの数だけに依存します。
カテゴリーの座標は主座標 Dc^−½ V D です。Mass は、指示行列の総和に対するカテゴリーの割合で、その相対度数を J で割ったものです。Inert は、全慣性に対するそのカテゴリーの割合です。Quality は、報告された次元で示される、カテゴリーの中心からの距離の2乗の割合です(0〜1)。Corr は1つの次元についてのその割合、Contr は、そのカテゴリーが占める次元の慣性の割合です。指示行列によるコーディングは慣性を多くの次元に分散させるため、MCAの最初の2つの次元が説明する割合は、通常、単純なコレスポンデンス分析よりはるかに小さくなります。それでもマップは有用ですが、質の低いカテゴリーは十分に示されていません。
入力項目とオプション
項目 | 説明 |
Categorical variables | 3つ以上のカテゴリーの列です。Ctrl または Command を押して複数選択します。ちょうど2つの変数の場合は、代わりにSimple Correspondence Analysisを使用します。 |
Number of components | カテゴリーの表で、Quality、Corr、Contr を報告する次元の数です。既定値は2で、1〜20を指定でき、利用可能な数が上限です。プロットには常に最初の2つが表示されます。 |
Title | プロットに表示されるタイトルです。既定値は Multiple Correspondence Analysis です。 |
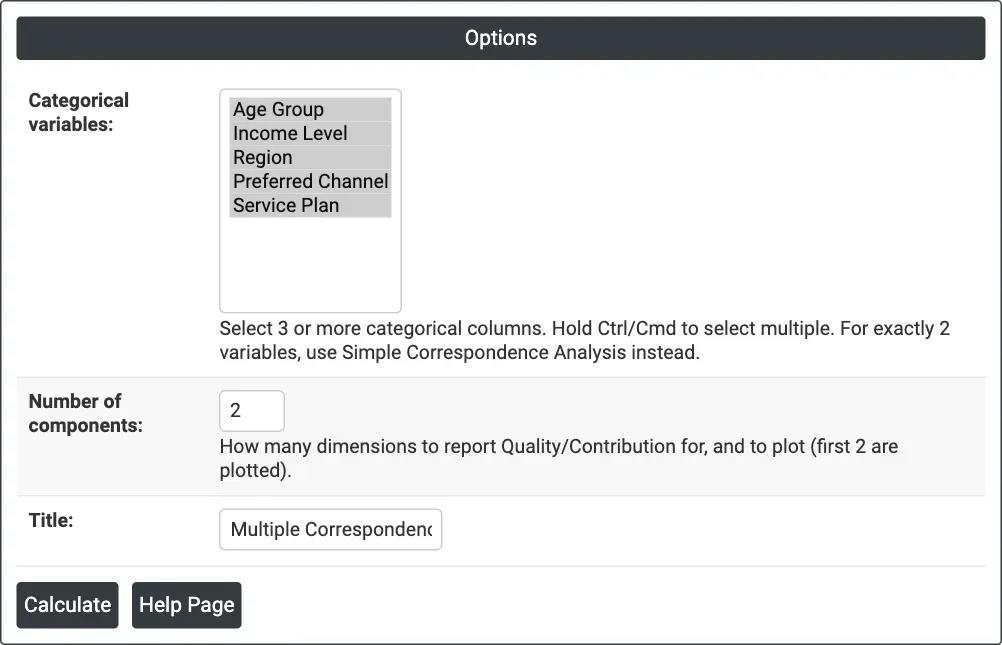
図1 — 例のオプション:カテゴリー変数として5つのアンケート質問、2成分。
出力の説明
- Multiple Correspondence Analysis plot — Dimension 1 に対する Dimension 2 上のすべてのカテゴリー(軸タイトルに慣性のパーセントを表示)。変数ごとに色分けされます。各点にはカテゴリーのラベルが付き、色と凡例が変数を示し、ホバーすると両方が表示されます。ラベルは重ならないように配置されます。
- Total inertia — 全慣性と次元の数。
- Analysis of Indicator Matrix — すべての次元の Component (Dim1, Dim2, ...)、Inertia、Percent、Cumulative Percent。
- Column Contributions — Category、Variable、Mass、Inert、報告された各次元の座標、Quality、報告された各次元の Corr と Contr。
- Download によるPDF出力。
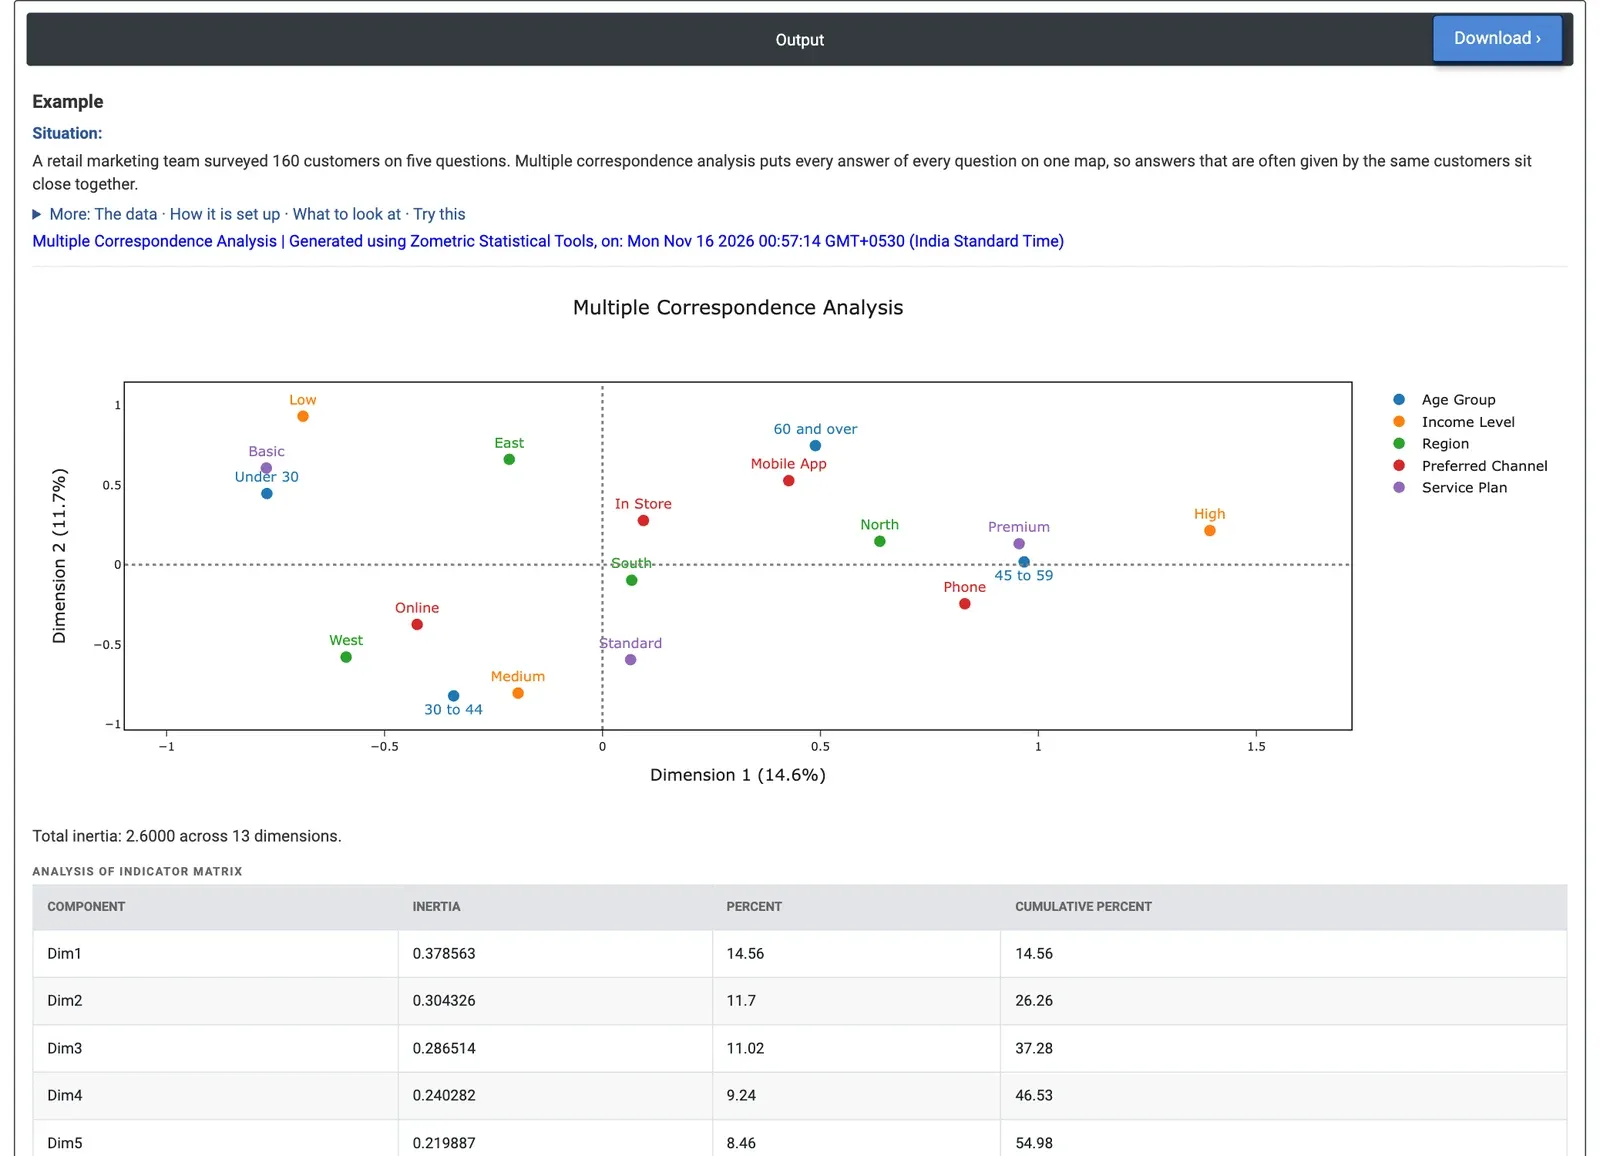
図2 — 160人の顧客への5つのアンケート質問のカテゴリーマップ:Dimension 1(14.6%)は、低所得、Basicプラン、30歳未満から、高所得、Premiumプラン、45〜59歳へと広がります。
計算例
小売業のマーケティングチームが、160人の顧客に5つの質問(年齢層(4グループ)、所得水準(Low、Medium、High)、地域(North、South、East、West)、希望チャネル(Online、In Store、Mobile App、Phone)、サービスプラン(Basic、Standard、Premium))についてアンケートを実施しました。ターゲットを絞ったオファーを計画するために、どの回答が一緒になるかを知りたいと考えています。5つの列すべてを Categorical variables として選択し、Number of components = 2 のままにします。
18のカテゴリーから13次元が得られ、全慣性は2.6です。Dimension 1は14.56%、Dimension 2は11.7%を説明し、合わせて26.26%です。これはこの数のカテゴリーを持つMCAでは普通ですが、マップは大まかな要約として読む必要があります。Dimension 1は、左側の Income Level: Low(−0.687)、Service Plan: Basic(−0.771)、Age Group: Under 30(−0.770)から、右側の Income Level: High(1.393)、Service Plan: Premium(0.956)、Age Group: 45 to 59(0.967)へと広がります。Income Level: High は、Dimension 1の慣性の23.1%を占め、どのカテゴリーよりも大きな寄与です。Dimension 2では、Income Level: Medium(−0.804)、Age Group: 30 to 44(−0.821)、Service Plan: Standard(−0.595)が下部にまとまっています。
Region: South(質0.0054)と Preferred Channel: In Store(0.0475)は、質が非常に低く、中心付近に位置しています。これらはこのマップでは十分に示されておらず、どのグループにも属しません。チームにとっては、所得水準とサービスプランが主なパターンを形成し、年齢がそれに続く一方、地域とチャネルはほとんど寄与しないことを意味します。元のデータでは、低所得の顧客の60.4%がBasicを、高所得の顧客の52.8%がPremiumを選んでいます。分析からRegionを除くと、最初の2つの次元の割合は32.57%に上昇します。
よくある質問
多重コレスポンデンス分析とは何ですか?
多重コレスポンデンス分析(MCA)は、3つ以上のカテゴリー変数のすべてのカテゴリーを1つのマップ上に配置します。同じ回答者によってよく選ばれる、または同じ品目に見られるカテゴリーは近くに配置されます。アンケートの回答、不具合記録、監査所見の探索に使用され、たとえば、どのシフト、ライン、不具合タイプが一緒に発生しやすいかを調べます。
MCAと単純コレスポンデンス分析の違いは何ですか?
Simple Correspondence Analysisはちょうど2つのカテゴリー変数用で、MCAは3つ以上を扱います。MCAは、カテゴリーごとに0/1の列を1つ持つ指示行列を分析します。このコーディングは慣性を多くの次元に分散させるため、MCAの最初の2つの次元が説明する割合は、通常、単純なコレスポンデンス分析よりはるかに小さくなります。
MCAのプロットはどのように解釈しますか?
マップ上で近くにあるカテゴリーは、一緒に現れる傾向があります。軸のパーセントは、各次元が説明する慣性の割合として読みます。各カテゴリーの Quality(0〜1)を確認してください。質の低いカテゴリー(多くは中心付近にあります)はマップ上で十分に示されておらず、どのグループにも属するものとして解釈してはいけません。Contr は、どのカテゴリーが各次元を定義しているかを示します。
MCAで説明される慣性が低いのはなぜですか?
MCAの全慣性は常に (K - J) / J です。ここで K はカテゴリーの数、J は変数の数であり、カテゴリーの数だけに依存します。指示行列によるコーディングはこの慣性を多くの次元に分散させるため、最初の2つの次元の割合が低いのは普通です。マップは大まかな要約として読む必要があります。