
複数変数の工程能力(非正規)
このツールは、粒子径、平面度、不純物など、データが歪んでいる場合に、2つ以上の列の工程能力を1つの規格に対して比較します。Weibull、Lognormal、Box-Cox、Johnsonを含む15のモデルから選んだ1つを各列に当てはめ、Z-ScoreまたはISOの方法を使用します。各列には少なくとも4個の値が必要です。出力は、Pp、PPL、PPU、Ppk、PPMの表と、ヒストグラムです。
最終レビュー
重要なポイント
複数変数の工程能力(非正規)は、データが正規分布に従わない場合に、複数の工程を1つの規格に対して比較し、各列に同じ分布を当てはめて、Pp、Ppk、PPMを並べて示します。
目的
Multiple Variables Process Capability (Nonnormal)は、データが正規分布に従わない場合に、複数の工程、ライン、機械、キャビティの工程能力を1つの規格に対して比較します。各列に同じ分布を個別に当てはめ、Pp、PPL、PPU、Ppk、および規格外の期待値と観測値の100万個あたりの個数を、列ごとのヒストグラムとともに1つの表に並べて示します。粒子径、平面度、振れ、不純物など、正規分布に基づくPpkでは裾を誤って評価してしまう歪んだ特性に使用し、工程の順位付けをしたい場合に役立ちます。
主な機能
- 2つ以上の列。それぞれを独立した工程として扱い、個別に当てはめます。
- 15のモデル:Weibull、Exponential、Logistic、Loglogistic、Largest and Smallest Extreme Value、2-Parameter Exponential、3-Parameter Weibull、Gamma、Lognormal、3-Parameter Lognormal、3-Parameter LogLogistic、Box-CoxおよびJohnson変換、Mixed Distribution (ISO 22514-2)。
- 指数の算出にZ-ScoreまたはISOのパーセンタイル法。
- すべての列に適用される片側または両側の規格。
- Pp、PPL、PPU、Ppk、PPM Expected、PPM Observedを含む比較表と、規格限界とあてはめ曲線を示した各列のヒストグラム。
統計的手法
各列について、選択した分布を最尤法で当てはめます(Weibull、Gamma、Exponentialは閾値を0に固定し、3-parameterモデルは閾値を推定します)。Lognormalは対数データの平均と標準偏差を使用します。Box-CoxとJohnsonはデータを正規分布に変換し、変換後の尺度で処理します。Mixed Distributionは正規分布の混合を当てはめ、成分数は固定しない限りBICで選択されます。各列には少なくとも4個の値が必要です。
Z-Score法(既定):各限界を超える側のあてはめ確率を正規スコアに変換します。Z_USL = Φ⁻¹(F(USL))、Z_LSL = Φ⁻¹(F(LSL))で、Fはあてはめた累積分布です。その上で、PPU = Z_USL / 3、PPL = −Z_LSL / 3、Pp = (Z_USL − Z_LSL) / 6、Ppk = min(PPL, PPU)です。ISO法:指数にはあてはめたパーセンタイル X₀.₁₃₅、X₅₀、X₉₉.₈₆₅(正規分布の±3σと同じ割合を含む点)を使用します。Pp = (USL − LSL) / (X₉₉.₈₆₅ − X₀.₁₃₅)、PPL = (X₅₀ − LSL) / (X₅₀ − X₀.₁₃₅)、PPU = (USL − X₅₀) / (X₉₉.₈₆₅ − X₅₀)です。片側の限界のみの場合、Ppは示されず、Ppkは片側の指数になります。
PPM Expectedは、あてはめた母集団のうち限界を超える割合に1,000,000を掛けたものです。PPM Observedは、標本の値のうち限界を超えるものの割合です。これらは、すべてのデータから求めた全体(長期)の指数です。精度は分布の適切さに左右されます。すべての列に同じモデルを適用するため、列を比較する前に、それぞれの当てはまりを(例えばIndividual Distribution Identificationで)確認してください。
入力項目とオプション
項目 | 説明 |
Process variables | 必須。比較する2つ以上の数値列。それぞれが個別に当てはめられます。 |
Fit distribution | 必須。上に挙げた15のモデルのうちの1つ(既定はWeibull)で、すべての列に適用されます。 |
Mixture components | Mixed Distribution (ISO 22514-2)の場合のみ:Auto(BICで選択、既定)、または2〜6個の成分。 |
Method of analysis | Z-Score(既定)またはISO。 |
LSL / USL | すべての列に適用される規格限界。少なくとも一方が必要で、LSLはUSLより小さくなければなりません。 |
Company name / Report title | 報告書の任意のテキスト。既定のタイトルはMultiple Variables Process Capability (Nonnormal)。 |
Data Options: Subset (optional) | Exclude matching rows(既定)またはInclude only matching rows。行番号(例:3,7,12-15)や条件で指定します。 |
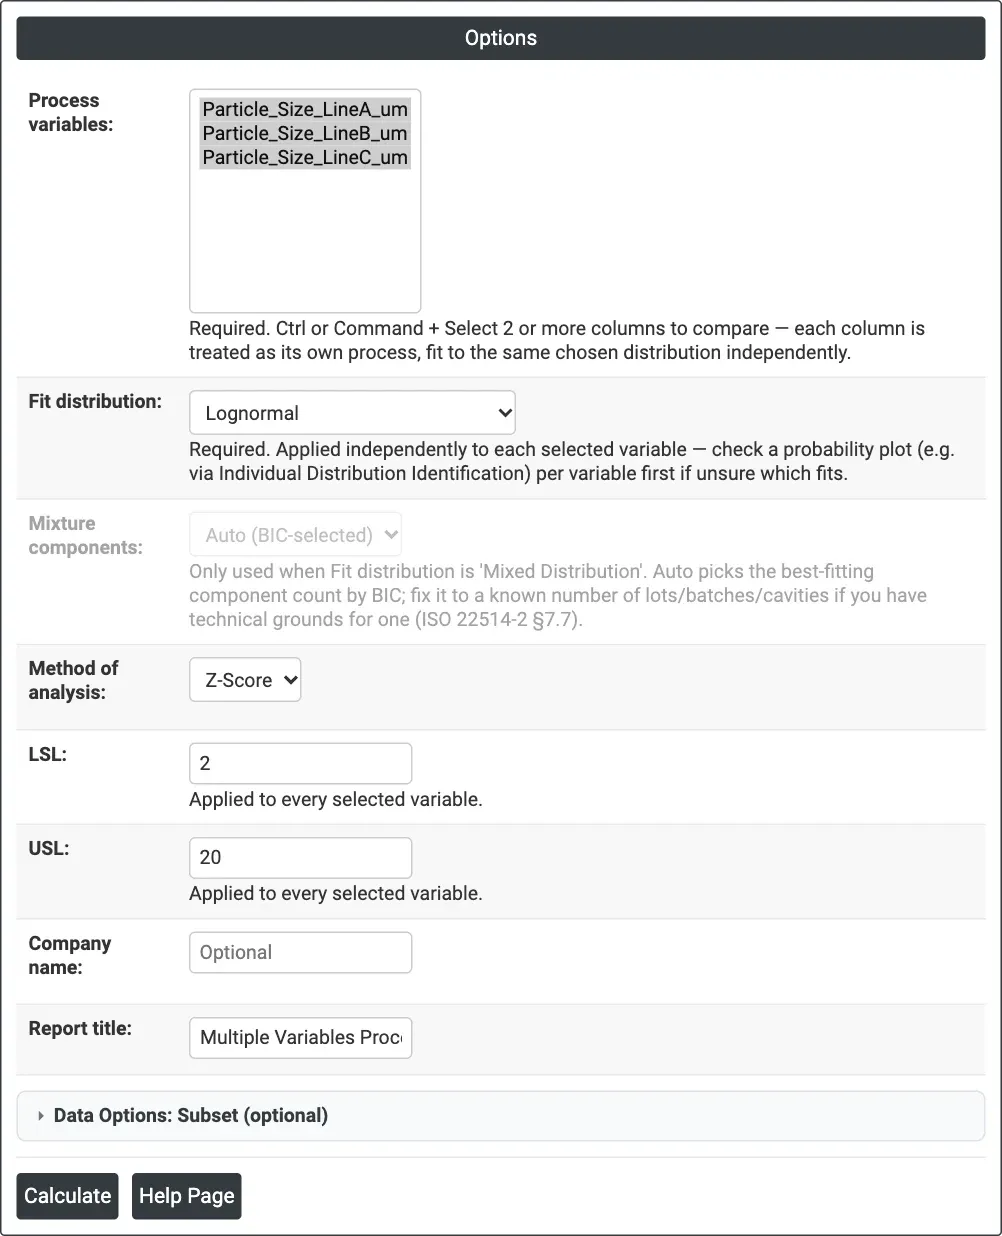
図1 — この例のオプション:3つのラインの粒子径、Lognormal、Z-Score法、LSL 2 µm、USL 20 µm。
出力の説明
- Multiple Variables Process Capability (Nonnormal) — 列ごとに1行:Variable、N、Distribution、Pp、PPL、PPU、Ppk、PPM Expected、PPM Observed。
- Histogram of <distribution> Distribution — 列ごとに1つ、列名の下に、LSLとUSL、およびあてはめた密度曲線とともに表示されます。
- DownloadによるPDFエクスポート。
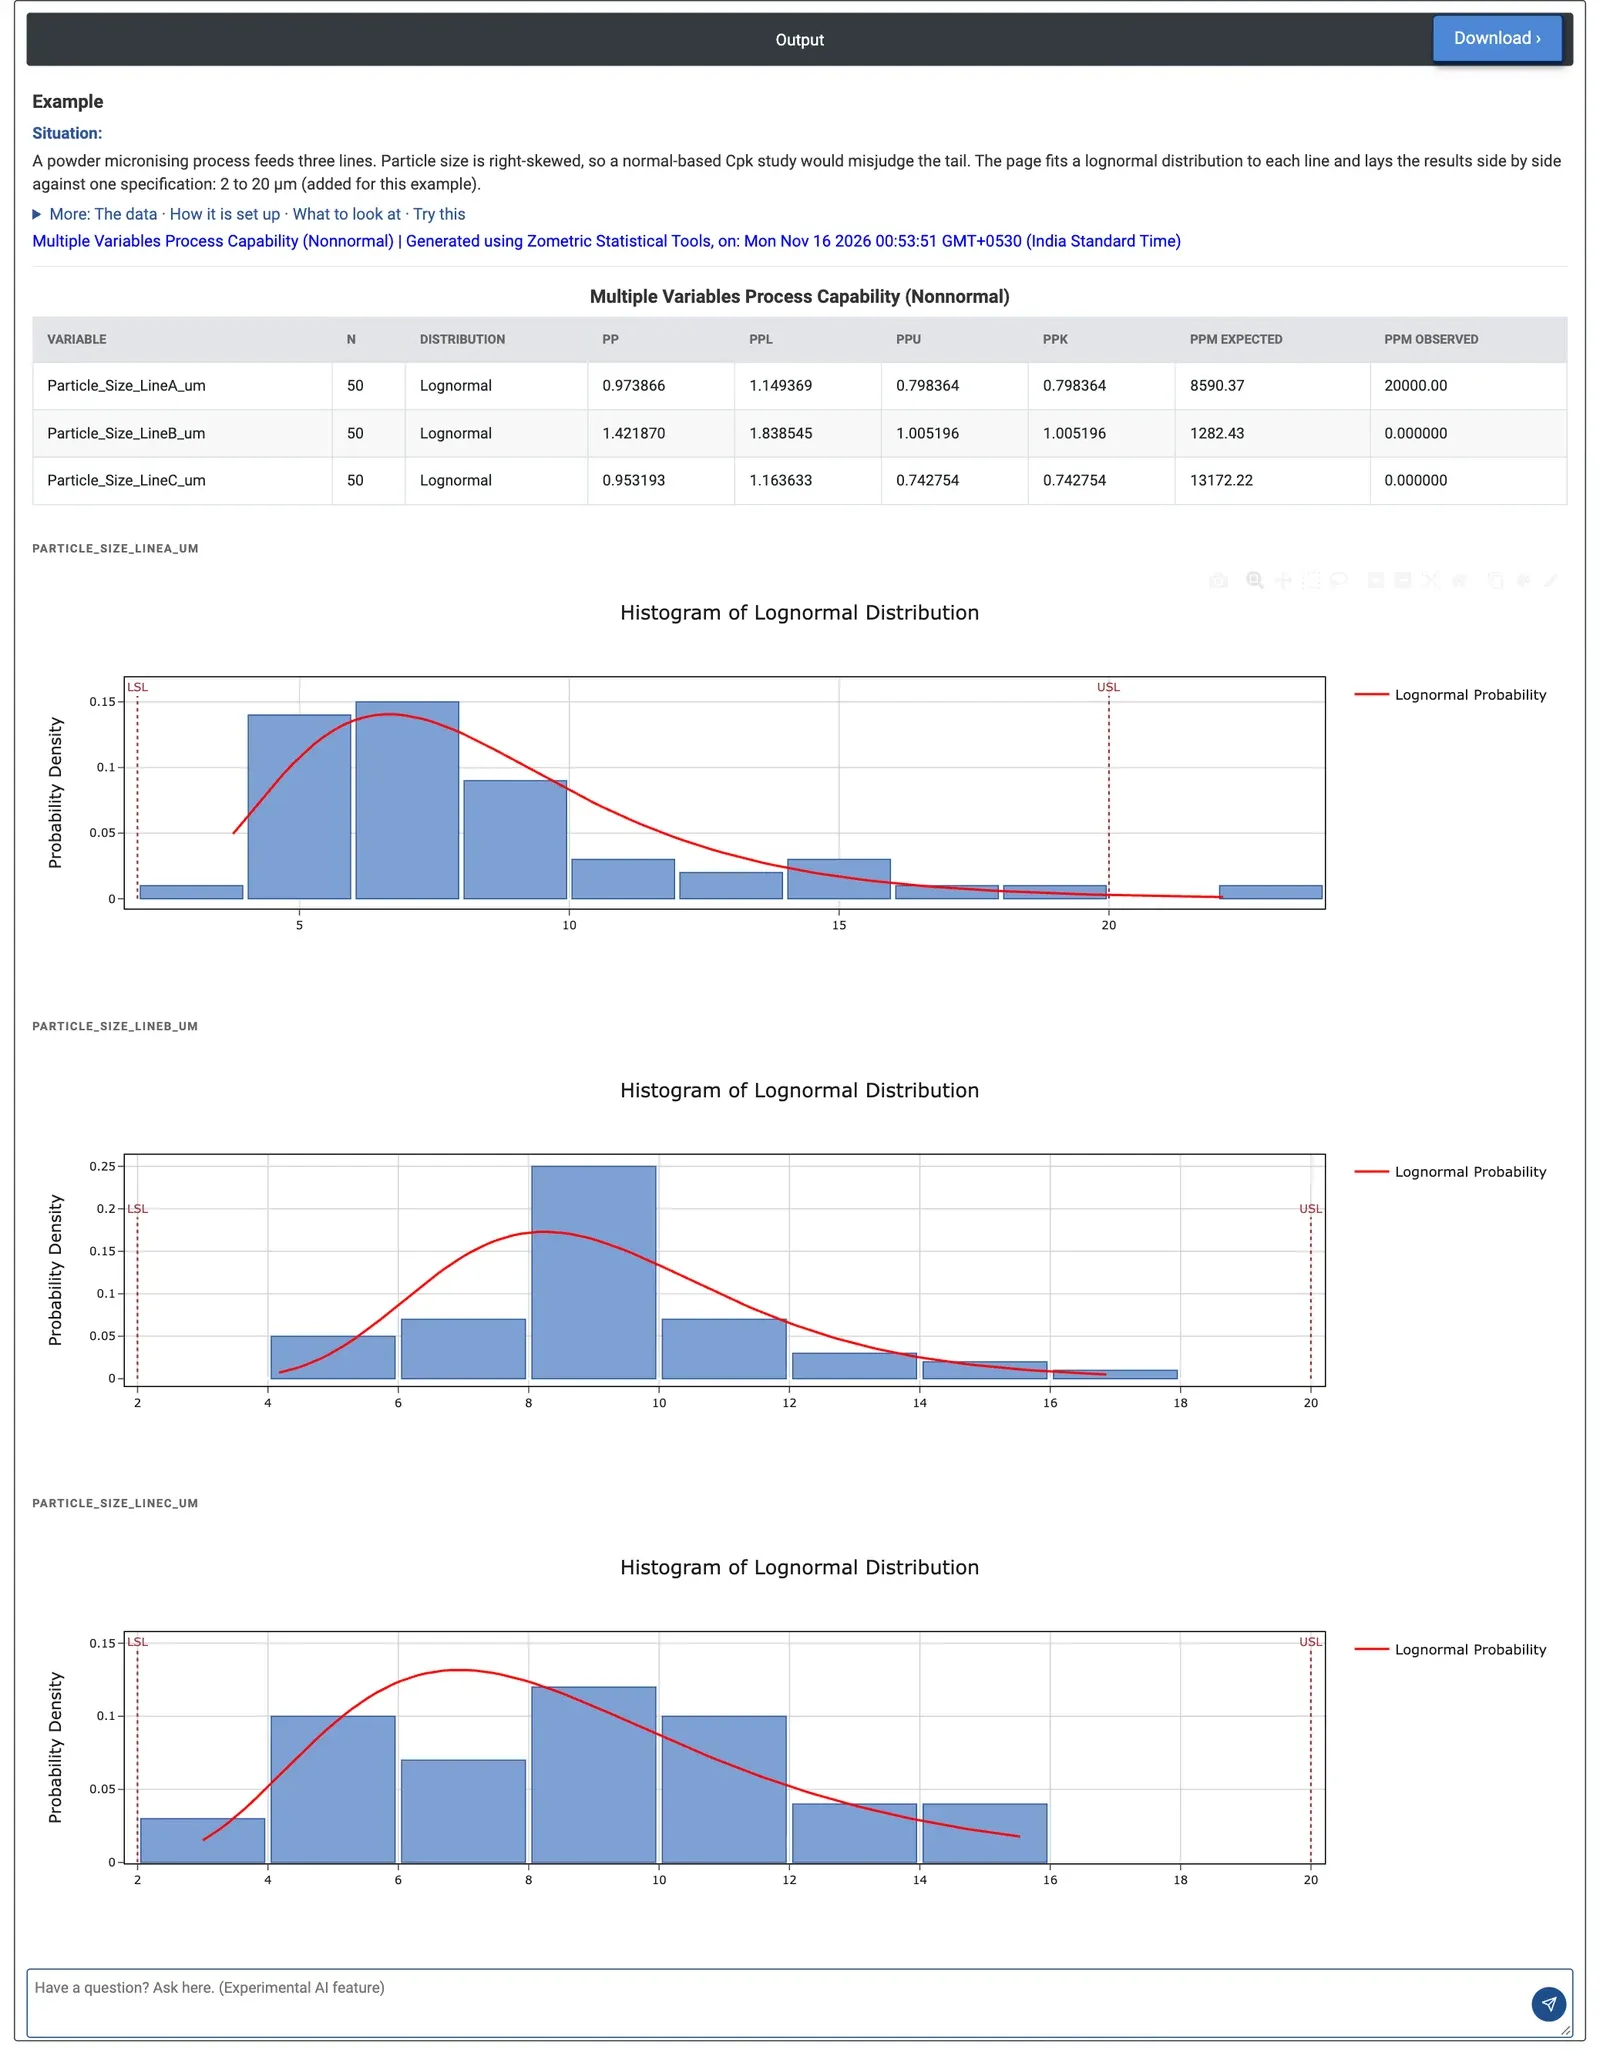
図2 — 3つのラインの比較表と対数正規分布のヒストグラム:PpkはラインAが0.798、ラインBが1.005、ラインCが0.743で、すべてのラインでPPUがPPLより小さく、USLを超える標本があるのはラインAのみです。
計算例
粉体の微粉砕工程が3つのラインに供給しており、粒子径は右に歪んでいます(中央値は約7〜9 µmで、粗い粒子側に長い裾があります)。工程エンジニアは、各ラインから50個の試料を使用し、2〜20 µmの規格に対してラインを比較したいと考えています。Process variables = Particle_Size_LineA_um、Particle_Size_LineB_um、Particle_Size_LineC_um、Fit distribution = Lognormal、Method of analysis = Z-Score、LSL = 2、USL = 20です。
ラインAはPpkが0.798で、規格外のPPM期待値は8,590です。すでに1個の試料(22.11 µm)が20 µmを超えており、PPM観測値は20,000です。ラインBは最も良く、Ppkは1.005、PPM期待値は1,282ですが、それでも通常の目標値1.33を下回っています。ラインCは最もリスクが高く、Ppkは0.743、PPM期待値は13,172です。すべてのラインでPPUがPPLより低くなっています。リスクは2 µmを下回る微粒子ではなく、20 µmを超える粗い粒子にあるため、改善活動は、ラインCから始めて、粗い粒子の裾を対象とすべきです。ヒストグラムも同じ状況を示しています。各あてはめ曲線はUSL側に長い裾を持ち、ラインAでは1本の棒がそれを超えて位置しています。
モデルの選択は重要です。ISO法ではPpkの値は0.694、1.008、0.619に下がりますが、順位は同じです。Weibullを当てはめると、すべてのラインでPPLのほうが低い指数になり、順位が変わります(Ppkは0.641、0.948、0.798で、ラインAが最も悪くなります)。このページとは別に計算したAnderson-Darling統計量は、ラインAとBではLognormalを支持し(0.79対2.17、0.63対1.34)、ラインCではWeibullを支持する(0.20対0.55)ため、順位を意思決定に使う前に、ラインごとに確認する必要があります。
よくある質問
複数変数の非正規工程能力分析は、どのような場合に使用しますか?
データが正規分布に従わない場合に、複数の工程、ライン、機械、キャビティの工程能力を1つの規格に対して比較し、順位付けするために使用します。典型的な例は、粒子径、平面度、振れ、不純物のような歪んだ特性で、正規分布に基づくPpkでは分布の裾を誤って評価してしまいます。
Z-Score法とISO法の違いは何ですか?
Z-Score法は、各限界を超える側のあてはめ確率を正規スコアに変換し、3で割ってPPUとPPLを求めます。ISO法は、正規分布の±3シグマの広がりの代わりに、あてはめた0.135、50、99.865パーセンタイルを使用します。計算例が示すように、両者でPpkの値は異なることがありますが、順位は変わらない場合があります。
非正規の工程能力で、分布の選択が重要なのはなぜですか?
指数の精度は、あてはめた分布の適切さに左右され、すべての列に同じモデルが適用されます。計算例では、LognormalからWeibullに切り替えると、どちらの指数が低くなるかが変わり、ラインの順位も変わりました。列を比較する前に、例えばIndividual Distribution Identificationで、それぞれの当てはまりを確認してください。
PPM ExpectedとPPM Observedの違いは何ですか?
PPM Expectedは、あてはめた分布の母集団のうち規格限界を超える割合に1,000,000を掛けたものです。PPM Observedは、実際の標本の値のうち限界を超えるものの割合です。どちらも、各列のすべてのデータから計算される、全体の長期的な指標です。