
名義ロジスティック回帰(Nominal Logistic Regression)
名義ロジスティック回帰は、1つ以上の予測変数と、キズ、へこみ、裂けなど、順序のない3つ以上のカテゴリをもつカテゴリ応答変数との関係を解析するための統計ツールです。予測変数の値に基づいて、各カテゴリが生じる確率を予測します。
最終レビュー
重要なポイント
名義ロジスティック回帰は、1つ以上の予測変数と、順序のない3つ以上のカテゴリをもつカテゴリ応答変数との関係を解析するための統計ツールです。
このページの内容
名義ロジスティック回帰とは
名義ロジスティック回帰は、1つ以上の予測変数と、キズ、へこみ、裂けなど、順序のない3つ以上のカテゴリをもつカテゴリ応答変数 との関係を解析するための統計ツールです。予測変数の値に基づいて、各カテゴリが生じる確率を予測します。
名義ロジスティック回帰を使用する場面
予測変数
- 予測変数は、連続、カテゴリ、またはその両方の混在
- 離散変数は、水準の数と解析の目的に応じて、連続またはカテゴリとして扱えます
- 連続の予測変数が1つだけで、応答が連続の場合 → 使用:Fit Line Model
- 複数の予測変数があり、応答が連続の場合 → 使用:Fit Regression Model
応答変数
- 応答には、自然な順序のない3つ以上のカテゴリ が必要です(例:色、材料の種類、欠点の種類)
- 応答が 連続 の場合 → 使用:Fit Regression Model
- 応答が 2つのカテゴリ(合格/不合格)の場合 → 使用:Fit Binary Logistic Model
- 応答が 順序のあるカテゴリ(低/中/高)の場合 → 使用:Ordinal Logistic Regression
名義ロジスティック回帰を正しく使用するためのガイドライン
- 応答変数には、順序のない3つ以上のカテゴリが必要です。カテゴリに自然な順序がある場合は、代わりに順序ロジスティック回帰を使用します。
- 予測変数は 連続でもカテゴリでも構いません。解析を実行する前に、各変数が正しく分類されていることを確認してください。
- データが 対象とする母集団を正確に表していることを確認してください。偏りのあるデータや不完全なデータでは、信頼できない予測になります。
- カテゴリごとに 十分なデータ点 を収集します。いずれかのカテゴリの観測値が少なすぎると、モデルが不安定になり、予測が信頼できなくなります。
- すべての変数を できるだけ正確に測定してください。入力データの誤差は、予測確率の精度を直接低下させます。
- 時間に基づくパターンが結果に影響していないかを特定しやすくするため、データを 収集した順序で 記録します。
- 当てはめの後、適合度統計量と残差診断を使用してモデルを検証します。当てはまりの悪いモデルは、誤解を招くカテゴリ予測を生成します。
- 次のことを確認します:観測値が少なすぎるカテゴリがない こと。まれなカテゴリはモデルの信頼性を下げ、推定上の問題を引き起こすことがあります。
代替手法:名義ロジスティック回帰を使用すべきでない場合
- 応答変数が 連続の場合は、代わりに Fit Regression Model を使用します。
- 応答が連続で、連続の予測変数が1つだけ の場合は、代わりに Fit Line Model を使用します。
- 応答が 2つのカテゴリ(例:合格/不合格)の場合は、代わりに Fit Binary Logistic Model を使用します。
- 応答のカテゴリに 自然な順序(例:低/中/高)がある場合は、代わりに Ordinal Logistic Regression を使用します。
- 応答が連続で、カテゴリの予測変数が1つ の場合は、代わりに 一元配置分散分析 を使用します。
名義ロジスティック回帰の例
さまざまな教え方の有効性を評価するため、学校の管理者が30人の生徒からデータを収集し、各生徒の好きな教科と、その教室で用いられた教え方を記録します。応答変数である教科の好み(数学、理科、国語)は、固有の順序をもたないカテゴリ変数であるため、管理者は名義ロジスティック回帰を適用します。この解析は、生徒の年齢(10〜13歳)と教え方の種類(実演または説明)が、教科の好みとどのように関連しているかを探るのに役立ちます。手順は次のとおりです。
- 必要なデータを収集しました。
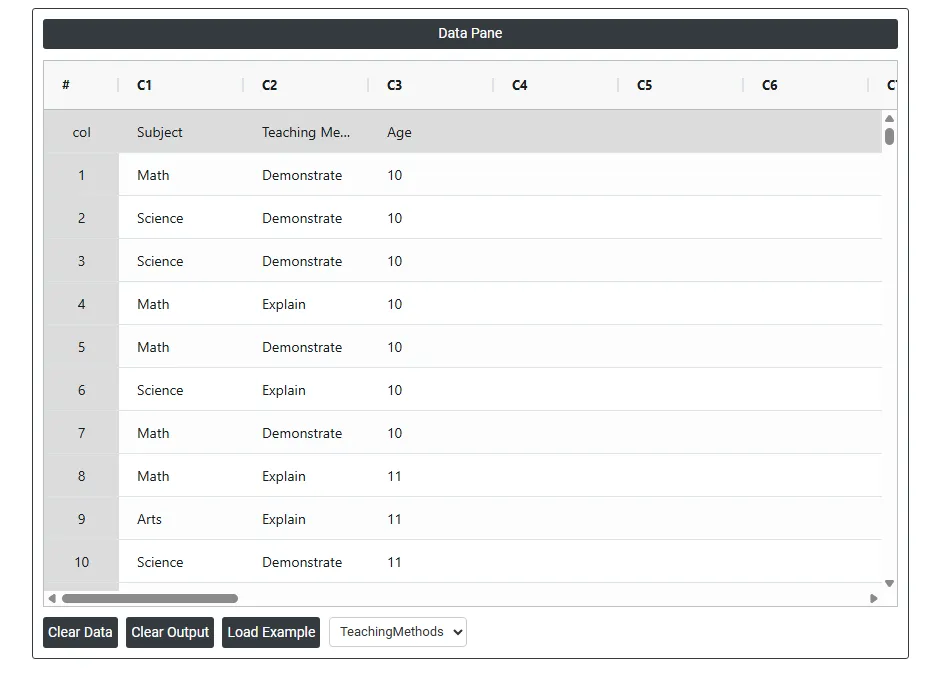
- 次に、Zometric Statistical Software(https://statsai.zometric.com/)でデータを分析します。
- 名義ロジスティック回帰を見つけるには、Statistical module> Regression>Nominal Logistic Regressionを選択します。
- ツール内で、データとその他の入力を次のように入力します。
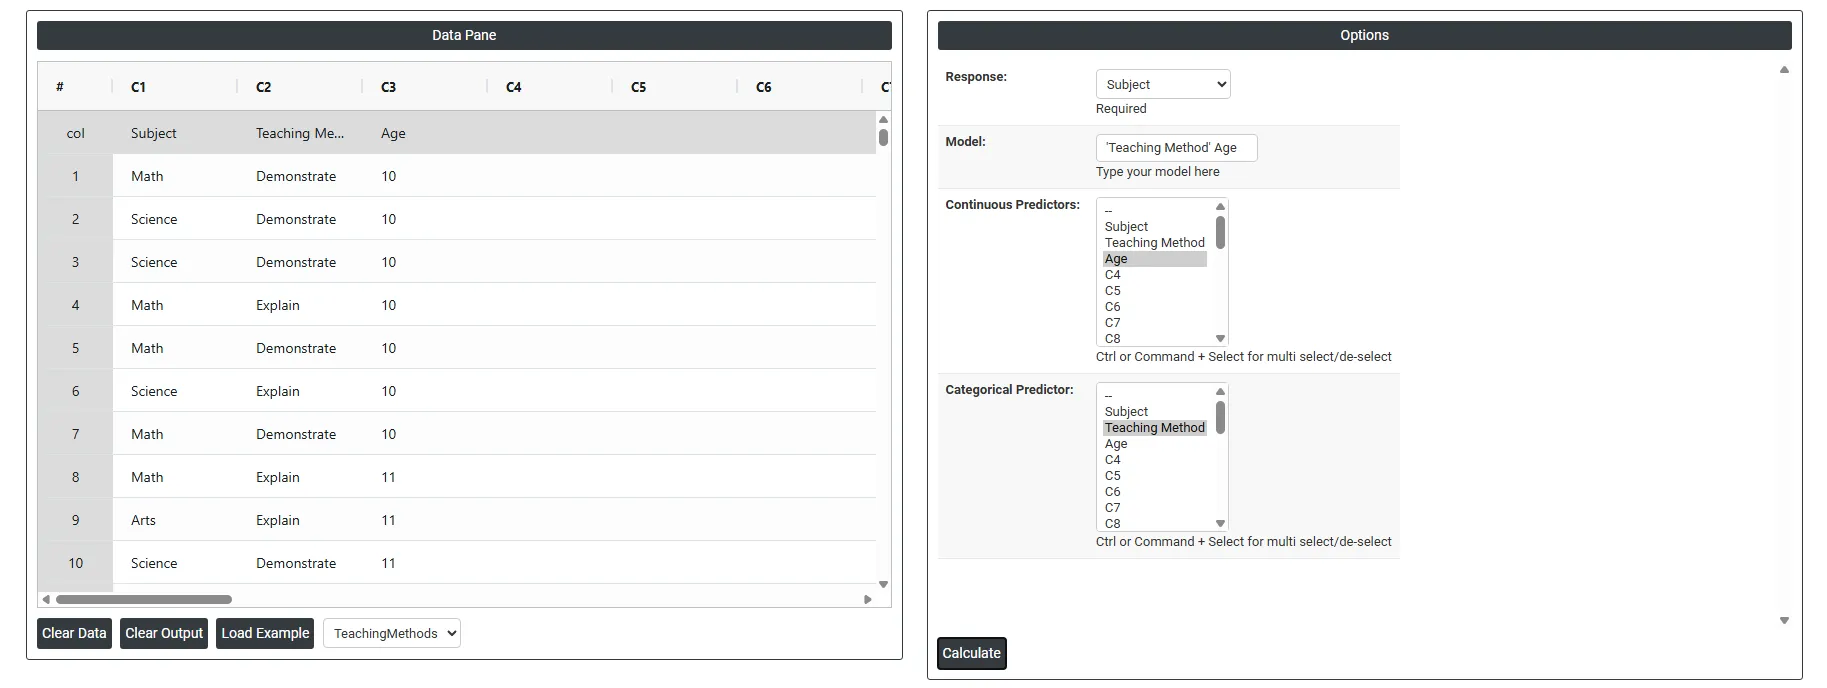
5. 上記のツールを使用した後、次のように出力が得られます。
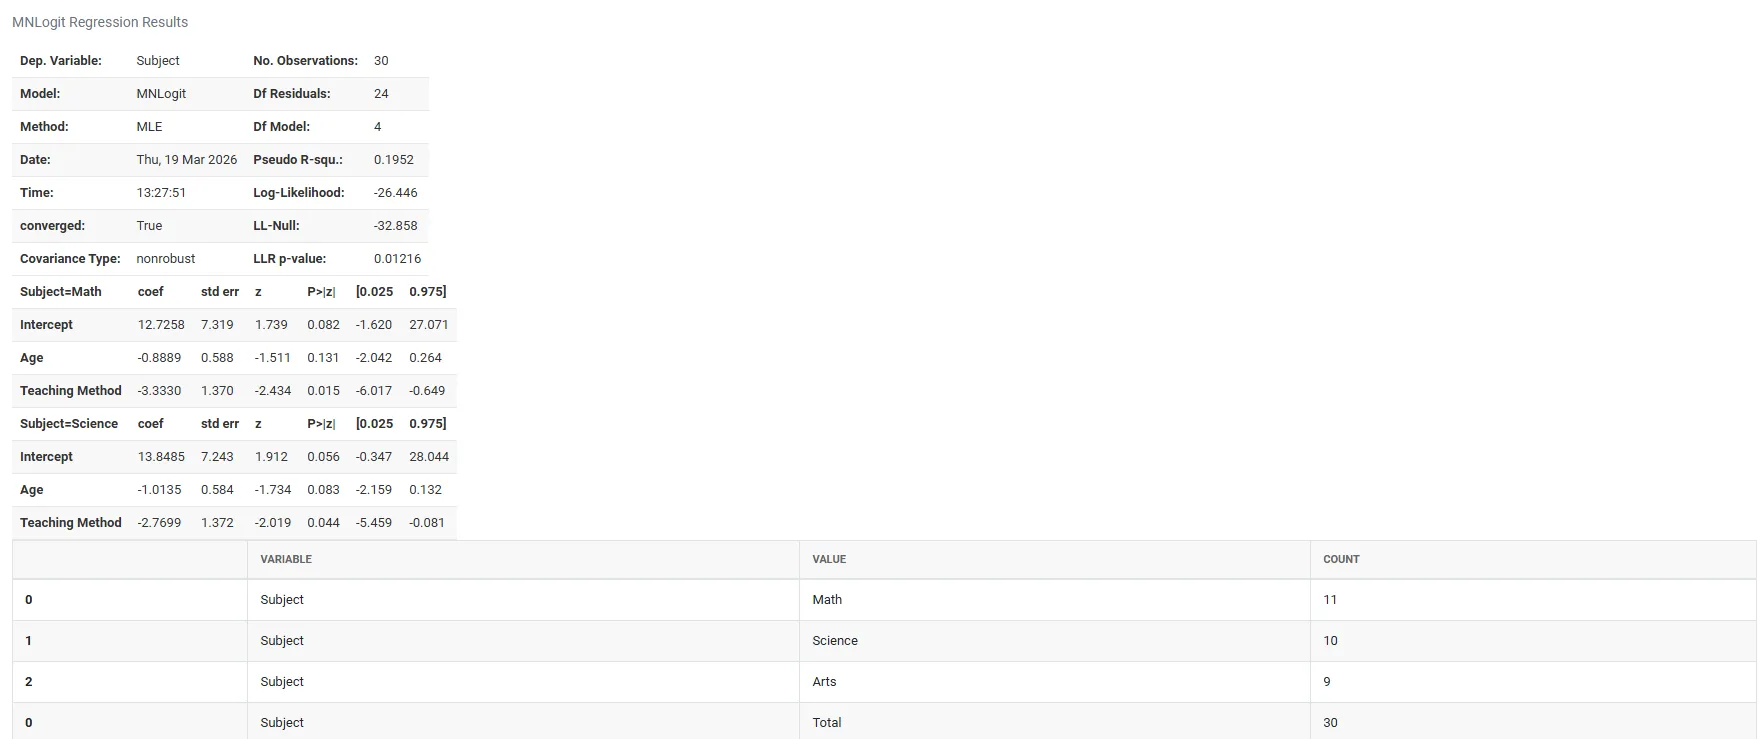
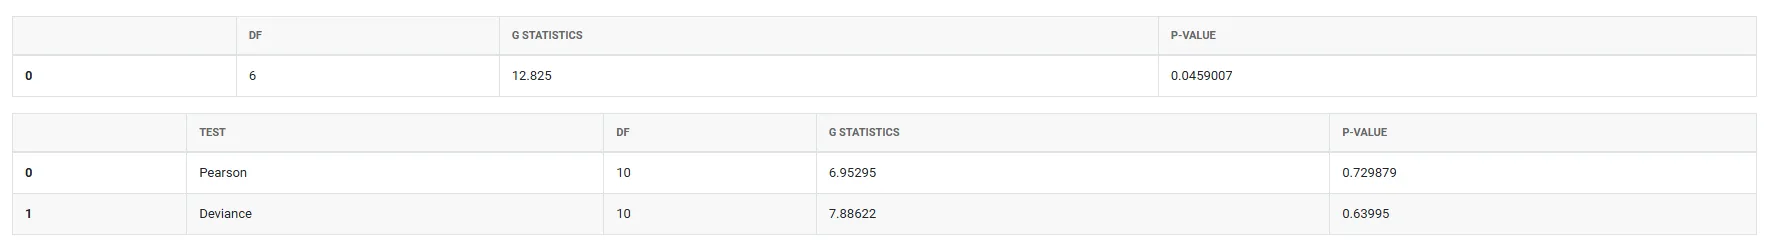
名義ロジスティック回帰の実行方法
手順は次のとおりです。
- Zometric Statistical Softwareにログインします:https://statsai.zometric.com/
- ホームページで、Statistical Tool> Regression > Nominal Logistic Regressionを選択します。
- 次に、データを手入力するか、Excelシートのデータをすべてコピー(Ctrl+C)して貼り付けます(Ctrl+V)。または、Load Exampleオプションでサンプルデータを読み込むこともできます。
- 次に、必要なオプションを入力します。
- 最後に、ページ下部のcalculateをクリックすると、目的の結果が得られます。
名義ロジスティック回帰のダッシュボードでは、ウィンドウが2つの部分に分かれています。
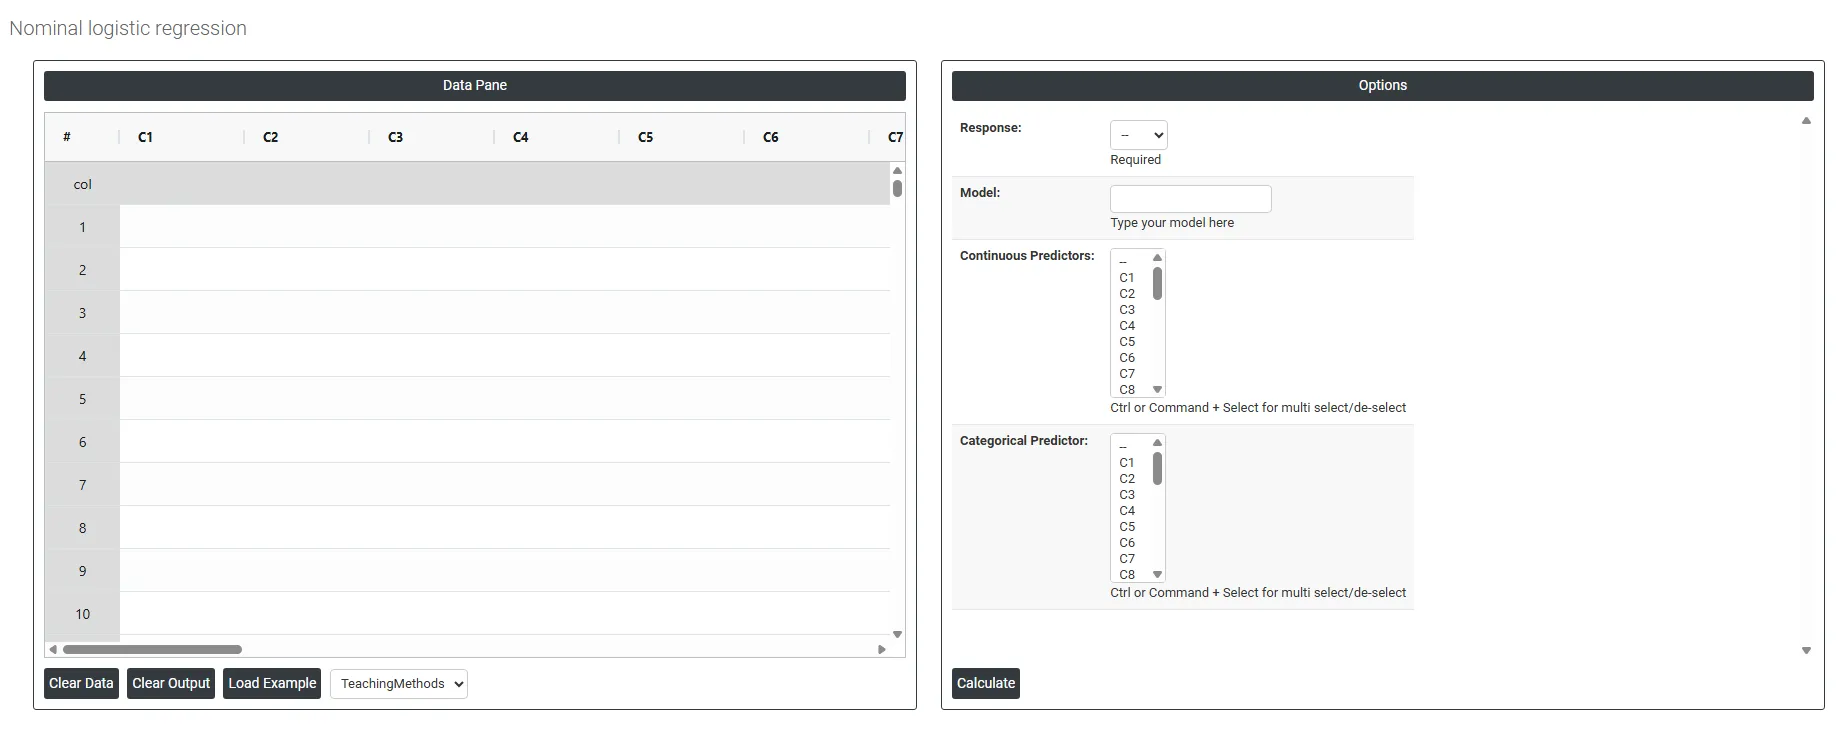
左側にはデータペイン(Data Pane)があります。Data Paneでは、各行が1つのサブグループになります。データは手入力するか、Excelシートのデータをすべてコピー(Ctrl+C)してここに貼り付けます(Ctrl+V)。
Load example:サンプルデータが読み込まれます。
Load File:Excelデータを直接読み込むために使用します。
右側には、次のような多くのオプションがあります。
- Response: 予測または分類しようとしている結果の変数です。欠点の種類(キズ、へこみ、裂け)や支払方法(現金、カード、オンライン)のように、自然な順序のない3つ以上のカテゴリを含んでいる必要があります。モデルは、与えられた予測変数の値に基づいて、各カテゴリが生じる確率を推定します。
- Categorical Predictor: 機械の種類、シフト、材料など、決まった一連の個別のグループやラベルを含む予測変数です。これらのグループ間には、測定可能な距離がありません。各カテゴリは別々の水準として扱われ、モデルは各グループが応答の各カテゴリの確率にどのように影響するかを推定します。
- Continuous Predictor: 温度、圧力、時間など、ある範囲内の任意の測定可能な数値をとり得る予測変数です。モデルはこれらの値を使って、予測変数が1単位増加したときに、応答が各カテゴリに入る確率がどのように変化するかを推定します。
- Model: 解析に含める予測変数と交互作用項を定義します。デフォルトでは、選択したすべての予測変数を使って 主効果モデル を構築します。2つの予測変数が応答に共同で影響すると考える場合は、交互作用項(例:A*B)を含めるようにカスタマイズできます。適切なモデル構造の選択は重要です。不要な項を含めるとノイズが増え、重要な項が欠けると予測が不正確になります。
よくある質問
名義ロジスティック回帰とは何ですか?
名義ロジスティック回帰は、1つ以上の予測変数と、キズ、へこみ、裂けなど、順序のない3つ以上のカテゴリをもつカテゴリ応答との関係を解析します。予測変数の値に基づいて、応答の各カテゴリが生じる確率を予測します。予測変数は、連続、カテゴリ、またはその両方の混在のいずれでも構いません。
名義ロジスティック回帰と順序ロジスティック回帰の違いは何ですか?
名義ロジスティック回帰は、色、材料の種類、欠点の種類など、自然な順序のない3つ以上のカテゴリをもつ応答に使用します。低、中、高のようにカテゴリに自然な順序がある場合は、代わりに順序ロジスティック回帰を使用します。合格/不合格のような2つのカテゴリの応答には、二項ロジスティック回帰を使用します。
名義ロジスティック回帰の要件は何ですか?
応答には順序のない3つ以上のカテゴリが必要で、各カテゴリに十分な観測値が必要です。まれなカテゴリはモデルを不安定にし、推定上の問題を引き起こすことがあるためです。データは対象とする母集団を表し、正確に測定され、収集した順序で記録される必要があります。当てはめの後は、適合度統計量と残差診断でモデルを検証します。
Zometric Statistical Softwareで名義ロジスティック回帰を実行するにはどうすればよいですか?
Statistical Tool > Regression > Nominal Logistic Regression を選択し、データを入力または貼り付けます。Response、Categorical PredictorとContinuous Predictorを選択し、Modelを定義します。Modelはデフォルトで主効果モデルであり、A*Bのような交互作用項を含めることもできます。その後、Calculateをクリックすると結果が得られます。